Tanyakan bagaimana voiceover AI dibuat dan sebenarnya Anda sedang bertanya bagaimana naskah tertulis menjadi ucapan tanpa ada yang perlu masuk ke bilik rekaman. Jawaban singkatnya: model text-to-speech neural mengubah naskah Anda menjadi audio sintetis, suara kloning opsional membuat audio itu terdengar seperti orang tertentu, dan lapisan dubbing menyelaraskan semuanya dengan video Anda di berbagai bahasa. Di DubSmart AI, kami menjalankan seluruh rangkaian itu dalam satu ruang kerja, sehingga Anda dapat beralih dari satu paragraf teks menjadi voiceover multibahasa yang selesai tanpa berganti alat atau memesan waktu studio.
Seperti apa proses itu bagi Anda bergantung pada satu keputusan, dan sisa panduan ini menjelaskan mekanismenya, opsi-opsinya, dan cara memilih.
Daftar isi
Keputusan di balik bagaimana voiceover AI dibuat
Sebelum audio apa pun dihasilkan, Anda membuat dua pilihan yang membentuk segala sesuatu setelahnya. Yang pertama adalah apakah Anda menginginkan suara siap pakai dari pustaka atau kloning suara Anda sendiri. Yang kedua adalah apakah Anda membutuhkan voiceover dalam satu bahasa atau versi yang sepenuhnya dilokalkan ke berbagai bahasa.
Bagi kreator YouTube atau bisnis kecil, itu biasanya cepat teratasi: pilih suara stok untuk kecepatan, klon suara ketika konsistensi merek penting, dan gunakan dubbing hanya saat Anda beralih ke multibahasa. Bagi pengembang dan agensi, percabangan yang sama menjadi pertanyaan arsitektur — apakah Anda memanggil endpoint text-to-speech untuk audio sekali pakai, atau menghubungkan kloning suara dan dubbing menjadi satu pipeline yang berjalan sendiri?
Kami membangun DubSmart tepat di sekitar percabangan ini. Text to Speech, Voice Cloning, Speech to Text, Speech Separator, Text to Image, Image to Video, dan AI Dubbing semuanya berada dalam satu platform, sehingga Anda dapat menaikkan atau menurunkan tingkat otomatisasi dan personalisasi tanpa harus menggabungkan vendor yang terpisah.
Mekanismenya: bagaimana voiceover AI sebenarnya dibuat
Text to speech: mengubah naskah menjadi suara
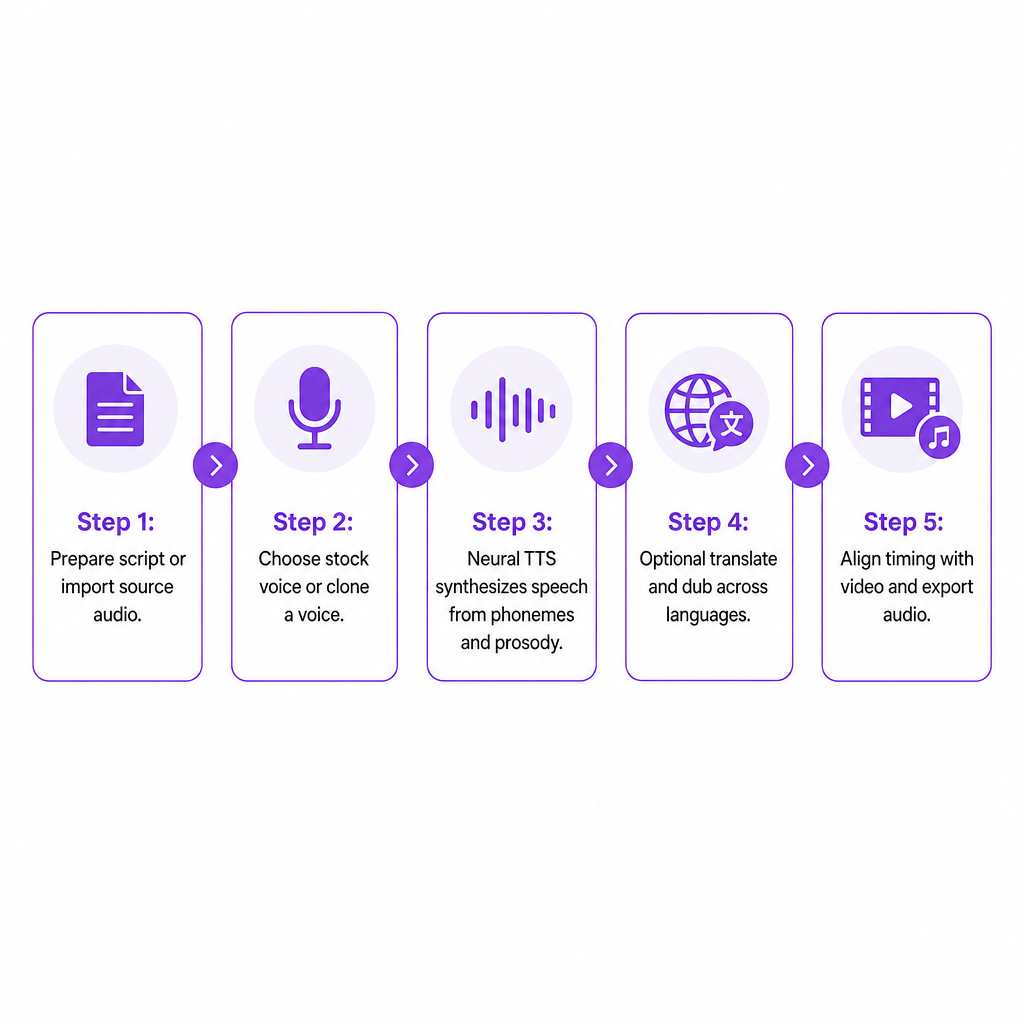
Text-to-speech (TTS) berada di pusat setiap voiceover AI. Mesin pertama-tama menganalisis naskah Anda — memecah teks menjadi fonem, membaca tanda baca dan struktur, serta menyimpulkan prosodi, yaitu ritme, penekanan, dan intonasi yang menjaga ucapan agar tidak terdengar datar. Model neural kemudian mensintesis fonem-fonem itu menjadi audio dan menerapkan pola prosodi yang membuat penyampaian terdengar lancar alih-alih robotik.
Mesin Text to Speech kami memungkinkan Anda menempelkan teks dalam bahasa apa pun, memilih suara dari pustaka yang berisi lebih dari 300 suara, dan menghasilkan ucapan realistis dalam hitungan detik. Suaranya terdengar alami dan menyerupai manusia, serta dikategorikan berdasarkan bahasa, gender, dan gaya sehingga Anda dapat menyesuaikan nada dengan apa yang Anda produksi. Bagi pengembang, mesin yang sama tersedia melalui Text to Speech API RESTful: kirim permintaan POST dengan teks dan parameter suara Anda, terima file audio siap pakai. Teks terstruktur masuk, audio seperti nyata keluar, tanpa perekaman manual.
Model suara dan pustaka suara
Voiceover AI mengandalkan model suara terlatih — jaringan neural yang mempelajari bagaimana suara tertentu seharusnya terdengar di berbagai kata, bahasa, dan emosi. Pustaka suara hanyalah katalog dari model-model tersebut. Kami memelihara pustaka berisi lebih dari 300 suara alami yang mencakup beragam gender, aksen, dan gaya bicara di banyak bahasa, dan tersedia baik di aplikasi web maupun melalui API sehingga alat internal dapat menghasilkan ucapan sesuai permintaan.
Kloning suara: membuat AI terdengar seperti Anda
Kloning adalah mekanisme yang membuat voiceover terdengar seperti orang tertentu alih-alih narator generik. Sistem menganalisis rekaman sampel, mempelajari timbre, rentang nada, dan pola pengucapan pembicara, lalu menerapkan karakteristik tersebut pada ucapan sintetis baru.
Dalam praktiknya, Anda mengunggah file audio berdurasi minimal 20 detik ke Voice Cloning — idealnya bersih dan bebas dari kebisingan latar belakang. Kami memproses sampel itu menjadi profil suara khusus yang dapat Anda beri nama dan gunakan kembali, dengan kloning biasanya hanya memakan waktu beberapa detik. Setelah dibuat, suara kloning tersedia di dalam Text to Speech dan AI Dubbing, sehingga Anda dapat menghasilkan naskah atau versi yang di-dubbing dengan suara Anda sendiri. Secara programatis, Voice Cloning API mencerminkan hal ini: dapatkan URL unggahan, kirim audio Anda dalam format yang didukung, buat suara khusus dari kunci file yang dihasilkan, lalu gunakan dalam proyek TTS atau dubbing.
Dubbing dan voiceover multibahasa
Beralih dari voiceover satu bahasa ke konten multibahasa menambahkan pelokalan di atas TTS dasar. Pola umumnya konsisten:
- Rekam atau impor ucapan asli.
- Transkripsikan menjadi teks.
- Terjemahkan teks tersebut.
- Hasilkan ucapan baru dalam bahasa target.
- Selaraskan waktu dengan video atau audio asli.
Alur kerja AI Dubbing kami mengikuti pola ini persis, menggabungkan speech-to-text, terjemahan mesin, dan text-to-speech, secara opsional menggunakan kembali suara kloning sehingga trek yang di-dubbing sesuai dengan pembicara asli. Ini mengubah konten lisan dari lebih dari 60 bahasa sumber menjadi versi yang di-dubbing di 33 bahasa target. Dubbing speech-to-speech bertujuan menjaga nada dan waktu agar tetap dekat dengan penampilan asli, yang paling penting untuk konten e-learning, pelatihan, dan film di mana sinkronisasi bibir dan tempo menentukan pengalaman.
API dan alur kerja otomatis
Bagi tim yang memproduksi voiceover dalam skala besar, API adalah yang menggabungkan pembuatan suara ke dalam sistem yang ada. TTS API menangani teks masuk, audio keluar; Voice Cloning API menambahkan pembuatan dan pengelolaan suara khusus secara programatis; dan AI Dubbing API memperluas keduanya ke terjemahan dan dubbing otomatis di 33+ bahasa dengan akses ke suara kloning. Bersama-sama, mereka memungkinkan Anda membangun pipeline di mana naskah, subtitle, atau transkrip yang diambil dari sistem konten menjadi voiceover atau trek yang di-dubbing secara otomatis, tanpa penanganan file manual.
Tiga cara Anda membuat voiceover AI di DubSmart
Di dalam platform kami, pertanyaannya mengerucut menjadi tiga titik awal praktis.
Mulai dari naskah dengan Text to Speech. Tempelkan teks Anda, pilih suara stok atau kloning, atur bahasa dan kontrol dasar, dan hasilkan ucapan yang dapat Anda unduh dalam format standar. Ini cocok untuk video pelatihan, konten penjelasan, iklan pemasaran, dan intro podcast di mana Anda memiliki naskah sejak awal.
Mulai dari media yang sudah ada dengan AI Dubbing. Unggah file video atau audio sumber, biarkan sistem mentranskripsikan dan menerjemahkan, lalu hasilkan trek yang di-dubbing dalam bahasa pilihan Anda — menggunakan kembali suara kloning untuk menjaga konsistensi suara. Ini adalah jalur untuk kanal yang memperluas ke audiens multibahasa dan untuk bisnis yang mengubah tujuan webinar atau demo produk.
Mulai dari sistem Anda sendiri dengan pembuatan berbasis API. Aplikasi Anda mengirim teks dan parameter suara ke TTS API, secara opsional mengaitkan konten dengan suara tertentu melalui Voice Cloning API, dan mengambil audio yang siap dilampirkan ke video atau voiceover e-learning untuk modul pelatihan. Ini cocok untuk pengembang, agensi, dan penyedia LMS yang membutuhkan output programatis yang konsisten.
Kriteria keputusan: memilih pengaturan voiceover AI Anda
Kealamian dan kualitas audio
Kealamian tidak bisa ditawar. Mesin yang kuat memodelkan prosodi dan artikulasi sehingga ucapan mengalir dengan jeda dan penekanan yang sesuai. Karena pembuatannya cepat, Anda dapat mengiterasi naskah dan menghasilkan ulang audio hingga penyampaiannya terasa pas alih-alih puas dengan hasil pertama.
Cakupan bahasa dan kedalaman pelokalan
Jika kanal multibahasa atau pelatihan internasional ada dalam rencana Anda, cakupan menentukan seberapa jauh jangkauan Anda. Mengubah konten dari 60+ bahasa sumber menjadi 33 bahasa target dari satu alur kerja menentukan pasar yang dapat Anda layani, dan dubbing speech-to-speech membantu menjaga nada dan waktu tetap konsisten di setiap versi.
Branding suara dan kemampuan kloning
Suara yang mudah dikenali penting bagi perusahaan, kreator, dan podcast. Kloning memungkinkan Anda membawa suara yang sama di berbagai bahasa dan kanal. Kemampuan mengklon dari sekitar 20 detik audio bersih dan menggunakan kembali profil itu di dalam Text to Speech dan AI Dubbing membuat suara khas praktis untuk dibangun dan dipertahankan.
Kesederhanaan alur kerja versus integrasi teknis
Kreator sering menginginkan unggahan, pengeditan, dan pengunduhan ditangani dalam satu tempat. Tim teknis sering membutuhkan API. Kami menawarkan keduanya: alat yang berhadapan dengan pengguna dalam aplikasi terpadu dan API pengembang yang mengekspos mesin yang sama. Pilihannya bergantung pada apakah tim Anda kebanyakan bekerja di browser atau membangun di sistem internal.
Kecepatan, skalabilitas, dan konsistensi
Alat voiceover seharusnya memperpendek produksi dan berskala tanpa penurunan kualitas. Pembuatan TTS yang hampir instan dan kloning yang selesai dalam hitungan detik memungkinkan iterasi cepat dan output massal, sementara API memungkinkan ribuan naskah atau segmen diproses secara otomatis dengan suara dan pengaturan yang konsisten.
Struktur anggaran dan kontrol
Alih-alih biaya studio per sesi, alat voiceover AI umumnya menggunakan penetapan harga berbasis penggunaan. Model berbasis kredit kami memberi Anda akses ke AI Dubbing, Text to Speech, Voice Cloning, Speech to Text, Speech Separator, Text to Image, dan Image to Video dalam satu akun, dengan tingkat gratis dan paket enterprise. Kredit memberikan batas penggunaan yang dapat diprediksi sementara rollover dan penskalaan tetap tersedia saat volume meningkat. Jika Anda ingin menyesuaikan kredit dengan durasi, rincian kami tentang biaya AI dubbing per menit menjelaskan perhitungannya.
Kepatuhan, persetujuan, dan penanganan data
Kloning dan ucapan sintetis membawa bobot etis dan hukum. Kami mengharuskan Anda mengunggah audio yang haknya Anda miliki dan merekomendasikan rekaman bersih untuk hasil terbaik, yang menjaga persetujuan dan kontrol tetap menjadi pusat perhatian. Dokumentasi API kami menggunakan URL unggahan yang aman dan presigned serta format audio standar, memberi pengembang pola yang jelas untuk penggunaan yang patuh di dalam aplikasi.
Risiko yang perlu diantisipasi
Bahkan dengan alat yang mumpuni, beberapa mode kegagalan patut diantisipasi.
Audio yang tidak alami atau robotik biasanya bersumber dari naskah dengan tanda baca yang buruk atau suara yang tidak cocok dengan kontennya. Memilih dari pustaka suara alami dan menghasilkan ulang hingga penyampaiannya pas adalah solusi praktisnya, dan pembuatan yang cepat membuat eksperimen tersebut murah.
Kesalahan pengucapan cenderung muncul dengan nama, istilah teknis, dan konten yang dilokalkan. Pipeline yang menjalankan transkripsi, terjemahan, dan peninjauan — alih-alih konversi audio-ke-audio secara buta — menangkap lebih banyak kesalahan ini sebelum dirilis.
Ketidaksesuaian waktu antara ucapan sintetis dan visual di layar merusak pengalaman penonton. Dubbing speech-to-speech yang tetap dekat dengan nada dan waktu asli, dipadukan dengan pengeditan di dalam lingkungan proyek, memberi Anda kontrol yang lebih baik atas penyelarasan.
Secara etis, mengklon suara tanpa hak yang tepat mengundang masalah serius. Mengharuskan sampel bersih di bawah kendali Anda, dan menempatkan kloning sebagai alat untuk kreator dan bisnis alih-alih peniruan anonim, adalah yang menjaga praktik ini tetap bertanggung jawab. Ketika Anda melokalkan rekaman yang sudah ada, panduan kami tentang cara mengubah bahasa suara dalam video menunjukkan jalur yang ramah peninjauan.
Bagaimana berbagai kreator menerapkan ini
Kreator YouTube yang berekspansi ke luar negeri dapat mengubah satu video berbahasa Inggris menjadi versi Spanyol, Portugis, dan Jerman dengan AI Dubbing dan suara kloning, sehingga pembawa acara tetap dikenali di setiap pasar — semuanya di dalam pipeline 60+ bahasa sumber dan 33 bahasa target.
Bisnis kecil atau tim pemasaran dapat menyusun naskah penjelasan produk atau iklan dalam sebuah dokumen, mengubahnya menjadi audio dengan Text to Speech, dan memilih suara yang sesuai dengan nada merek — energik, formal, atau santai. Naskah yang sama dapat dilokalkan kemudian melalui AI Dubbing menggunakan suara merek yang dikloning.
Produser e-learning atau pelatihan korporat dapat mengotomatiskan narasi untuk slide dan paket SCORM dengan mengirim teks pelajaran melalui TTS API dan melampirkan audio yang dikembalikan ke setiap modul, dengan kloning menjaga suara instruktur tetap konsisten bahkan di berbagai versi regional.
Pembuat film independen atau kreator podcast dapat memproduksi trailer, promo, atau dialog terjemahan tanpa memesan studio di setiap bahasa, menggabungkan Speech to Text, AI Dubbing, dan suara kloning untuk menjaga identitas karakter tetap stabil.
Pengembang dan agensi dapat menyematkan API TTS, Voice Cloning, dan AI Dubbing ke dalam alat internal atau platform klien, mengotomatiskan segala hal mulai dari voiceover sosial berdurasi pendek hingga agen suara interaktif.
Pertanyaan yang sering diajukan
Apa perbedaan voiceover AI dengan voiceover rekaman tradisional?
Voiceover tradisional membutuhkan pengisi suara manusia, waktu studio, dan beberapa sesi. Voiceover AI dihasilkan oleh mesin text-to-speech dan kloning suara yang mengubah naskah langsung menjadi audio menggunakan model neural terlatih alih-alih penampilan langsung.
Bisakah voiceover AI terdengar seperti orang tertentu?
Ya. Kloning suara menganalisis sampel singkat suara seseorang dan membangun model khusus yang dapat mengucapkan naskah apa pun dengan suara tersebut, tersedia di alat dan API Voice Cloning kami.
Berapa banyak audio yang dibutuhkan untuk mengklon suara?
Kami meminta minimal 20 detik audio bersih, bebas dari kebisingan latar belakang, untuk membuat profil suara kloning yang andal, dengan kloning biasanya selesai dalam hitungan detik.
Bisakah saya membuat voiceover dalam berbagai bahasa dari satu video sumber?
Ya. Kami menggabungkan speech-to-text, terjemahan, dan text-to-speech untuk mengubah konten dari 60+ bahasa sumber menjadi output yang di-dubbing di 33 bahasa target, sehingga satu video asli dapat menghasilkan banyak voiceover yang dilokalkan.
Adakah cara mengotomatiskan pembuatan voiceover alih-alih menggunakan antarmuka?
TTS API dan Voice Cloning API kami memungkinkan aplikasi dan alat internal mengirim teks dan sampel audio, membuat suara khusus, dan menerima ucapan sintetis secara programatis, sehingga voiceover dapat dihasilkan secara otomatis dalam skala besar.