Pemisahan suara AI adalah proses pembelajaran mendalam yang menarik suara manusia keluar dari campuran yang bising dan mengembalikan trek suara yang bersih, siap untuk transkripsi, dubbing, atau kloning suara. Kemampuan tunggal itu menjawab pertanyaan yang sebenarnya dimiliki kebanyakan kreator: bisakah saya menyelamatkan rekaman ini tanpa merekam ulang? Memahami cara kerja pemisahan suara AI membantu Anda memutuskan kapan harus mengandalkannya, kapan harus merekam lebih bersih sejak awal, dan bagaimana trek suara yang bersih diam-diam meningkatkan segala sesuatu di hilir. Panduan ini membahas mekanismenya, perbedaan antara meningkatkan satu pembicara dan memisahkan banyak, di mana proses ini cocok dalam pipeline lokalisasi, dan apa yang masih tidak bisa diperbaikinya.
Daftar isi
Keputusan di balik pemisahan suara
Setiap rekaman nyata menangkap jauh lebih banyak daripada sekadar pembicara. Vlog, webinar, video pelatihan, dan podcast menangkap suara jalanan, ambien ruangan, alunan musik, klik keyboard, dan obrolan yang tumpang tindih yang dapat mengubur kata-kata penting. Pemisah suara ada untuk mengurai campuran itu: ia mengambil satu file campuran dan mengembalikan trek yang sebagian besar berisi suara manusia, ditambah trek opsional yang menyimpan audio latar belakang yang tersisa.
Trek suara yang bersih itu menjadi fondasi untuk apa pun yang datang berikutnya: konversi suara ke teks yang akurat, dubbing multibahasa, kloning suara berkualitas tinggi, atau sekadar rekaman asli yang terdengar lebih baik. Jadi keputusan sebenarnya bukanlah teknis, melainkan praktis. Apakah Anda cukup mempercayai audio Anda saat ini untuk membangun konten multibahasa di atasnya, atau Anda ingin AI membersihkan dan memisahkan suara terlebih dahulu? Dan apakah Anda menginginkan utilitas pembersihan mandiri, atau pemisah yang tertanam dalam platform pembuatan dan lokalisasi yang lebih luas sehingga Anda tidak perlu berpindah-pindah antara beberapa aplikasi?
Kami merancang Speech Separator kami untuk bertindak sebagai gerbang AI pertama dalam alur kerja terpadu. Ia berada sebelum konversi suara ke teks, teks ke suara, kloning suara, dan dubbing, sehingga setiap sistem hilir melihat sinyal suara sejelas mungkin alih-alih mewarisi kebisingan apa pun yang ada di dalam ruangan.
Mekanisme: dari bentuk gelombang ke suara bersih
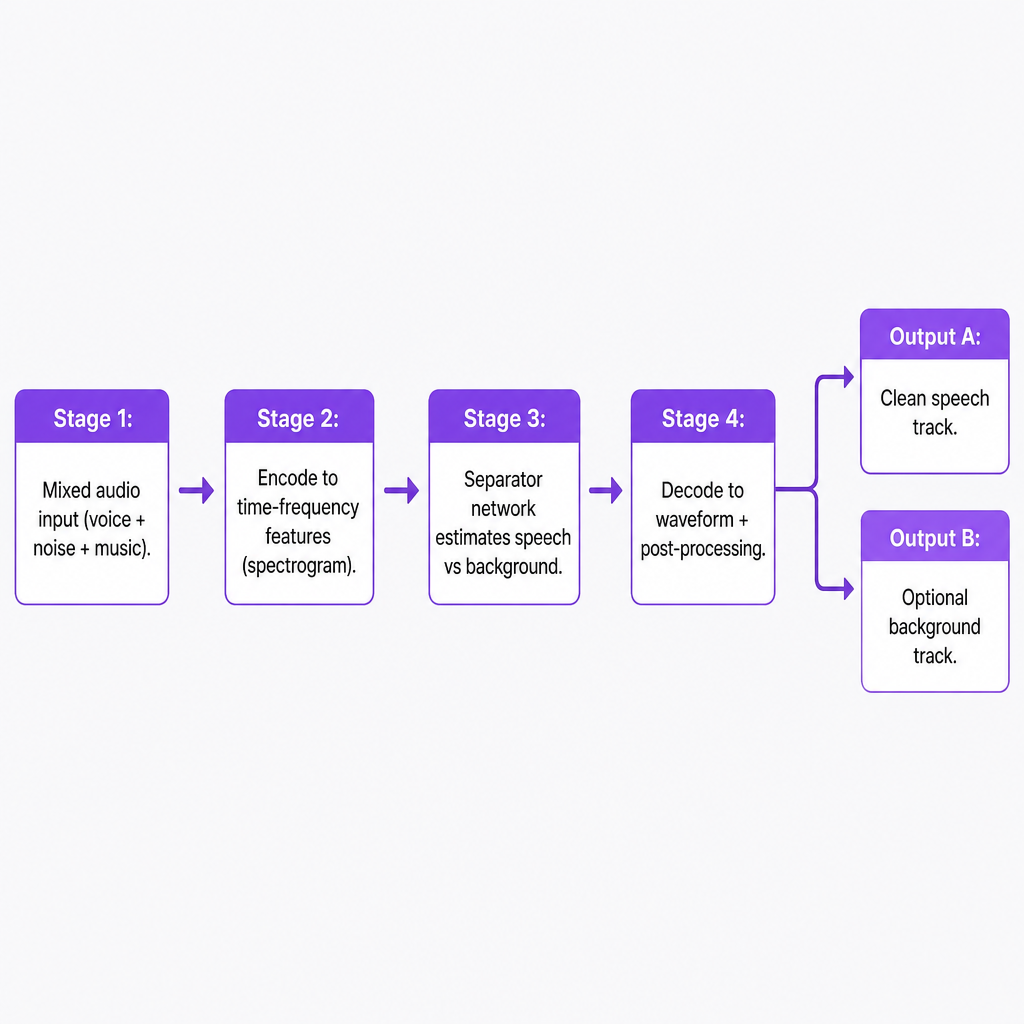
Pemisahan suara AI modern mengikuti pipeline empat tahap: mengkodekan sinyal, memisahkan sumber dalam ruang fitur yang dipelajari, memperkirakan suara yang bersih, dan mendekodekannya kembali menjadi audio.
Dari bentuk gelombang ke fitur
Sebagian besar sistem pertama-tama mengonversi bentuk gelombang mentah dari mikrofon Anda menjadi representasi waktu-frekuensi seperti spektrogram, yang menunjukkan bagaimana energi dalam pita frekuensi yang berbeda berubah dari waktu ke waktu. Tampilan itu memudahkan jaringan saraf untuk melihat pola yang sesuai dengan suara manusia versus kebisingan atau musik. Jaringan encoder kemudian memetakan input ke dalam ruang fitur berdimensi tinggi di mana sumber suara yang berbeda menjadi lebih dapat dibedakan, menekankan sifat suara seperti forman, harmonik, dan struktur temporal sambil menekan konten latar belakang yang tidak relevan.
Jaringan pemisah dan mask
Inti dari proses ini adalah jaringan pemisah, model mendalam yang dilatih untuk menilai apa yang termasuk suara dan apa yang tidak di setiap titik waktu-frekuensi. Dua strategi mendominasi. Pemisahan berbasis mask memprediksi mask untuk spektrogram yang mempertahankan energi suara dan meredam segala sesuatu yang lain; saat diterapkan pada spektrogram asli, kebisingan latar belakang dan musik turun tajam sementara suara tetap ada. Estimasi sumber langsung sebaliknya memprediksi spektrogram suara bersih itu sendiri, dan terkadang latar belakang residual, yang kemudian didekodekan kembali menjadi audio.
Pendekatan yang lebih khusus ada untuk kasus yang lebih sulit. Deep clustering mempelajari embedding untuk setiap bin waktu-frekuensi sehingga bin dari sumber yang sama berkumpul bersama, setelah itu clustering standar memisahkan suara dari sumber lain. Model lain menggunakan pelatihan invarian-permutasi sehingga mereka dapat memisahkan beberapa pembicara tanpa berasumsi pembicara mana yang menjadi output satu versus output dua.
Pelatihan dengan contoh yang diawasi
Model-model ini belajar dari contoh campuran yang dipasangkan dengan suara bersih kebenaran-dasar, menyesuaikan diri untuk meminimalkan kesenjangan antara output mereka dan referensi. Target pelatihan dapat berupa mask, spektrogram bersih, atau bentuk gelombang yang direkonstruksi, dan fungsi kerugian sering kali terkait dengan ukuran kualitas persepsi seperti rasio sinyal terhadap distorsi. Diberi banyak sampel beragam di seluruh aksen, mikrofon, dan lingkungan, jaringan menginternalisasi isyarat yang kuat yang memisahkan suara manusia dari konten latar belakang dan menggeneralisasi ke rekaman yang belum pernah dilihatnya.
Mendekode kembali menjadi audio
Akhirnya sistem memetakan representasi suara yang dipisahkan kembali menjadi bentuk gelombang domain-waktu melalui transformasi terbalik, diikuti oleh pasca-pemrosesan seperti penghilangan kebisingan dan normalisasi kenyaringan. Hasilnya adalah trek yang didominasi suara yang dapat berdiri sendiri atau digabungkan kembali dengan jumlah latar belakang yang terkontrol untuk kealamian. Speech Separator kami mengikuti pola persis ini: ia mengambil audio atau video yang Anda unggah, menjalankan pipeline pemisahan, dan mengembalikan trek yang berfokus pada suara ditambah latar belakang opsional sehingga Anda memutuskan seberapa kering atau ambien campuran akhir seharusnya.
Peningkatan satu pembicara vs pemisahan banyak pembicara
Ada batas penting antara meningkatkan satu pembicara dominan dan benar-benar memisahkan beberapa suara yang tumpang tindih, dan hal itu membentuk apa yang secara realistis dapat Anda harapkan.
Peningkatan satu pembicara mengisolasi satu suara utama dari kebisingan latar belakang, gema, dan suara non-ucapan sehingga kejelasan melonjak. Ini bekerja sangat baik untuk vlog, webinar, kuliah, dan konten talking-head, di mana masalahnya adalah kebisingan ambien atau alunan musik alih-alih obrolan silang. Speech Separator kami dioptimalkan untuk kasus ini: ia memperlakukan suara manusia sebagai sumber utama dan segala sesuatu yang lain sebagai latar belakang, memberikan trek suara yang dibersihkan dan trek latar belakang opsional.
Pemisahan banyak pembicara adalah tugas yang berbeda: memisahkan campuran beberapa orang yang berbicara sekaligus menjadi aliran individu, satu per suara. Model penelitian telah memisahkan hingga lima suara dari satu mikrofon dengan melatih jaringan yang berbeda untuk jumlah pembicara yang berbeda dan memilih yang paling cocok untuk setiap sampel. Teknik seperti deep clustering dan neural beamforming multi-mikrofon mendorong kinerja lebih jauh dalam pengaturan far-field dan multi-saluran, tetapi mereka lebih kompleks dan berat secara komputasi. Dalam praktiknya sistem-sistem ini masih menargetkan skenario khusus seperti transkripsi rapat, pusat panggilan, dan perangkat pintar alih-alih alur kerja kreator sehari-hari. Untuk sebagian besar pengguna kami, yang menjalankan saluran YouTube, tim pemasaran, atau perpustakaan kursus, kemenangan praktis terbesar berasal dari peningkatan satu pembicara yang kuat dan pemisahan suara-versus-latar belakang, bukan pemisahan multi-suara penuh.
Di mana pemisahan berada dalam alur kerja lokalisasi
Pemisahan adalah jembatan antara rekaman dunia nyata yang bising dan karya suara AI berkualitas tinggi. Jalur yang khas berjalan dengan bersih melalui beberapa alat.
Seorang kreator mengunggah file audio atau video, dan pemisah mengisolasi trek suara dan opsional latar belakang. Suara bersih itu masuk ke konversi suara ke teks, sehingga transkripsi dan penerjemahan beroperasi pada sinyal yang jelas, yang meningkatkan akurasi dan mengurangi kata-kata halusinasi yang disebabkan oleh musik atau kebisingan yang berat. Teks dan terjemahan yang dihasilkan kemudian beralih ke teks-ke-suara dan AI dubbing, yang menghasilkan versi bahasa baru menggunakan suara yang dikloning atau sintetis; karena suara sumber bersih, penyelarasan temporal lebih tepat dan artefak pencampuran seperti pumping berkurang.
Kloning suara bergantung pada input bersih yang sama. Model membutuhkan contoh yang relatif bebas kebisingan untuk mempelajari timbre, prosodi, dan artikulasi pembicara dengan andal, dan pemisahan mengurangi kontaminasi latar belakang yang dapat mendistorsi suara yang dikloning. Panduan pemisahan berbahasa Spanyol kami menangkap pengalaman sehari-hari dengan baik: unggah file, biarkan AI memisahkan suara dari latar belakang, lalu unduh baik trek suara yang bersih atau latar belakang yang terisolasi untuk pengeditan, dubbing, atau narasi lebih lanjut, semuanya dalam satu alur kerja. Konsolidasi itulah yang menjadi inti bagi tim kecil, yang jika tidak akan berpindah-pindah antara plugin penghilangan kebisingan terpisah, alat transkripsi, layanan dubbing, dan platform kloning.
Memilih dan menggunakan pemisahan suara AI
Ketika Anda memutuskan bagaimana mengadopsi pemisahan, segelintir kriteria praktis melakukan sebagian besar pekerjaan.
Kondisi audio dan jenis konten. Dengan satu pembicara utama dan kebisingan latar belakang atau musik yang moderat, pemisahan sangat efektif dan berisiko rendah. Dengan tumpang tindih yang berat, mikrofon far-field, atau input berkualitas sangat rendah, harapkan hasil yang menurun dan pasangkan AI dengan perekaman yang lebih baik alih-alih mengandalkannya untuk menyelamatkan segalanya.
Integrasi dengan alat hilir. Pemisah yang mengalir langsung ke transkripsi, teks-ke-suara, dan dubbing mengurangi gesekan dan artefak kumulatif dibandingkan dengan mengekspor dan mengimpor ulang antar aplikasi. Kami menghubungkan Speech Separator ke sisa alat lokalisasi kami persis karena alasan ini, yang lebih penting ketika tujuan Anda adalah penerbitan multibahasa alih-alih penghilangan kebisingan sekali pakai.
Kontrol atas audio latar belakang. Untuk penceritaan merek Anda sering kali ingin mempertahankan beberapa ambien atau musik untuk dampak emosional. Sistem yang menghasilkan baik trek suara yang bersih maupun latar belakang yang terisolasi memberikan lebih banyak ruang bagi editor daripada alat yang hanya menghasilkan satu campuran yang dihilangkan kebisingannya. Pemisah kami mendukung paradigma suara-plus-latar belakang opsional ini sehingga Anda dapat me-remix dengan sengaja.
Kecepatan, kesederhanaan, dan skala. Untuk kreator dan tim kecil, kegunaan menyaingi kinerja mentah. Pemisahan satu klik melalui browser atau API, dengan penanganan otomatis format umum, mengalahkan rantai plugin yang kompleks yang mengasumsikan keahlian rekayasa audio. Begitu Anda mengelola ratusan video atau modul kursus, pemrosesan batch dan otomasi berhenti menjadi kemewahan.
Keandalan dan artefak. Model yang kuat meningkatkan kejelasan tanpa menambahkan distorsi yang jelas, dering metalik, atau artefak pernapasan. Demo dapat menyanjung sistem, jadi ujilah dengan rekaman representatif Anda sendiri sebelum Anda menjadikan pemisah apa pun sebagai bagian tetap dari pipeline Anda.
Privasi dan kepatuhan. Pemisahan beroperasi langsung pada data suara yang mungkin mencakup informasi sensitif. Tim perusahaan harus mengonfirmasi bagaimana audio disimpan, apakah digunakan untuk pelatihan model, dan kontrol apa yang ada untuk penyimpanan dan akses, terutama untuk industri yang diatur dan konten pelatihan internal.
Menimbang kriteria ini terhadap kasus penggunaan Anda yang sebenarnya, baik ekspansi saluran, pelatihan, pemasaran, karya naratif, atau produk API, memberi tahu Anda apakah pemisah terintegrasi dengan alat suara hilir cocok dengan cara Anda beroperasi.
Risiko, batasan, dan apa yang tidak bisa diperbaikinya
Bahkan model yang kuat memiliki batasan keras yang perlu diketahui sebelum Anda berkomitmen.
- Kebisingan ekstrem atau rasio sinyal terhadap kebisingan yang sangat rendah. Ketika suara terkubur di bawah kebisingan atau musik yang keras, model mungkin gagal memulihkan setiap kata, menghasilkan putusan atau output yang teredam.
- Tumpang tindih pembicara yang berat. Orang-orang yang berbicara pada saat yang sama persis menantang bahkan sistem multi-pembicara yang canggih dan dapat menyebabkan suara meluber antar aliran yang dipisahkan.
- Artefak over-separation. Masking yang agresif dapat memperkenalkan kebisingan musikal atau timbre robotik, paling terlihat pada suara yang berkelanjutan dan sibilan.
- Ketidakcocokan pelatihan-dengan-realitas. Model yang disetel pada mikrofon, bahasa, atau lingkungan tertentu dapat berkinerja buruk pada rekaman yang sangat berbeda, yang kemudian menurunkan akurasi transkripsi dan dubbing.
- Etika dan hak. Suara yang dipisahkan dengan bersih lebih mudah untuk ditranskripsikan, dianalisis, dan di-remix, jadi tim harus menghormati persetujuan dan hak saat menggunakan kembali suara dalam bahasa atau konteks baru.
Kesimpulan yang jujur adalah bahwa pemisahan adalah peningkatan yang kuat, bukan pengganti kebiasaan perekaman yang masuk akal. Mikrofon yang bagus, level yang wajar, dan pilihan lokasi yang cermat masih membuahkan hasil, dan AI kemudian melipatgandakan pilihan-pilihan itu dengan membuat konten jauh lebih fleksibel untuk lokalisasi dan penggunaan kembali. Jika Anda sedang menjelajahi bagaimana menyesuaikan ini ke dalam pengaturan penerbitan yang lebih besar, penjelasan kami tentang apa itu pemisah suara mencakup dasar-dasarnya secara lebih mendalam.
Pertanyaan yang sering diajukan
Apa itu pemisahan suara AI dalam istilah sederhana?
Ini adalah proses AI yang mengambil rekaman campuran dan mengisolasi suara manusia, memberi Anda trek suara yang bersih dan, opsional, trek latar belakang terpisah yang dapat Anda simpan atau buang.
Bagaimana Speech Separator kami berbeda dari penghilangan kebisingan dasar?
Penghilangan kebisingan tradisional terutama meredam kebisingan keadaan-tunak. Pemisah kami menggunakan pembelajaran mendalam untuk mengenali pola suara dan menariknya dari berbagai suara latar belakang dan musik, yang biasanya menghasilkan dialog yang lebih bersih dan lebih alami.
Bisakah menangani beberapa pembicara?
Speech Separator kami dioptimalkan untuk mengisolasi suara manusia dari latar belakang non-ucapan, yang bekerja paling baik dengan pembicara utama dalam campuran. Memisahkan beberapa suara yang tumpang tindih adalah area penelitian aktif, dan model khusus ada, tetapi mereka biasanya menargetkan rapat atau pusat panggilan alih-alih alur kerja kreator umum.
Mengapa pemisahan suara penting untuk dubbing multibahasa?
Lokalisasi bergantung pada transkripsi dan pengaturan waktu yang akurat. Trek suara yang bersih mengurangi kesalahan pengenalan dan membantu voiceover yang diterjemahkan selaras dengan video asli, memotong artefak yang terdengar saat suara baru dicampur dengan musik dan efek yang dipertahankan.
Berapa banyak pengetahuan teknis yang saya butuhkan untuk menggunakannya?
Sangat sedikit. Anda mengunggah file audio atau video, biarkan AI memprosesnya, dan mengunduh trek suara dan latar belakang yang dipisahkan untuk pengeditan, dubbing, atau otomasi, tanpa penyetelan parameter manual yang diperlukan.