La traduction voix à voix convertit les mots prononcés dans une langue en parole audible dans une autre, afin que votre audience entende la traduction au lieu de la lire. Imaginez un formateur qui a enregistré une leçon en anglais et qui a maintenant besoin d'une version espagnole sans rien réenregistrer : le système transcrit l'anglais, traduit le sens et génère un audio espagnol à sa place. Ce passage de la lecture à l'écoute est l'objectif même, et il change la façon dont vous planifiez, révisez et publiez du contenu multilingue.
La véritable question n'est que rarement de savoir si la technologie fonctionne. Elle est de savoir quelle version vous est nécessaire : traduction enregistrée pour les vidéos, les cours et les podcasts ; traduction en quasi-temps réel pour les réunions et les événements ; sortie préservant la voix qui conserve l'identité du locuteur d'origine ; ou une API que vous pouvez intégrer à votre propre application. Chacune de ces voies comporte des compromis différents en matière de qualité, de latence et d'effort de révision, et ce guide les cartographie pour que vous puissiez choisir en toute connaissance de cause.
Table des matières
Comment fonctionne la traduction voix à voix
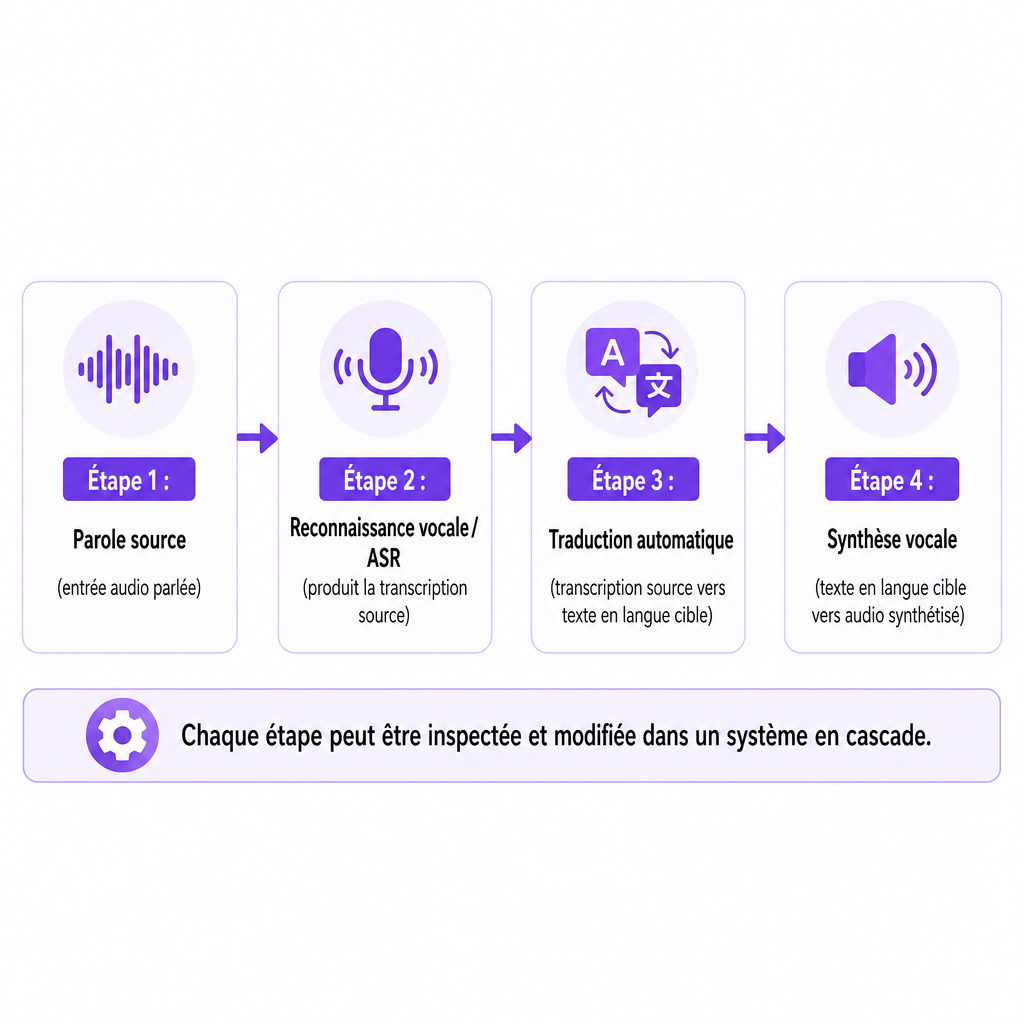
La plupart des systèmes exécutent un pipeline connecté de trois technologies. D'abord, la reconnaissance automatique de la parole (ASR) analyse l'audio source et produit une transcription. Ensuite, la traduction automatique convertit ce texte de la langue source vers la langue cible. Enfin, la synthèse vocale transforme le texte traduit en audio parlé. Le flux se lit clairement comme parole source, puis reconnaissance, puis texte traduit, puis parole synthétisée.
Parole source → reconnaissance vocale → texte traduit → parole synthétisée
Cette conception en couches est appelée traduction voix à voix en cascade, et la publication du NIST sur l'évaluation de la traduction vocale décrit la même structure : l'ASR construit la transcription source, la traduction automatique produit le texte en langue cible, et la synthèse vocale génère la sortie parlée. L'avantage d'une cascade est que chaque étape est inspectable, de sorte que vous pouvez corriger une transcription ou une traduction avant même que l'audio ne soit généré.
Une approche plus récente entraîne un modèle de bout en bout pour mapper l'audio source directement vers l'audio en langue cible sans exposer de phases de transcription et de synthèse distinctes. La recherche partagée via le rapport technique du DTIC sur la traduction vocale directe présente cela comme un moyen de réduire le délai et de préserver davantage la voix du locuteur d'origine, tout en notant qu'elle fait toujours un compromis sur la vitesse, le contexte, la couverture linguistique et la qualité de sortie. En pratique, la cascade vous donne davantage de contrôle éditorial ; l'approche de bout en bout vise une latence plus faible et une continuité vocale.
La traduction voix à voix face aux tâches connexes
On confond souvent la traduction voix à voix avec la transcription, la traduction de texte et le doublage, mais chacune se termine par un livrable différent. La traduction de texte s'arrête à une sortie écrite. La traduction voix à voix se termine par une sortie parlée, même si un système en cascade utilise toujours du texte en interne comme représentation intermédiaire. Démêler les entrées et les sorties vous évite de choisir le mauvais outil pour la tâche.
| Technologie | Entrée | Sortie | Usage typique |
|---|---|---|---|
| Voix vers texte | Audio parlé | Transcription écrite | Sous-titres, notes, contenu consultable |
| Traduction de texte | Texte écrit | Texte traduit | Documents, sous-titres, pages web |
| Synthèse vocale | Texte écrit | Parole synthétique | Narration, accessibilité, interfaces vocales |
| Traduction voix à voix | Audio parlé | Parole traduite | Conversations, doublage, médias multilingues |
Le doublage mérite sa propre distinction. La traduction voix à voix se concentre étroitement sur le changement de la langue parlée. Le doublage est le flux de travail de localisation de médias plus large qui l'englobe : traduire les dialogues, attribuer les locuteurs, générer de nouvelles voix, ajuster la synchronisation, mixer les voix traduites avec la musique et l'audio de fond, et exporter un projet finalisé. Pour une vidéo YouTube enregistrée, un cours en ligne, un podcast ou un film, le doublage est généralement le format le plus pratique car il ajoute ces contrôles éditoriaux par-dessus la traduction. Si vous hésitez entre l'audio et le texte à l'écran, notre explication sur le doublage face aux sous-titres pour la vidéo détaille ce choix précis, et les mécanismes plus larges se trouvent dans notre guide sur ce qu'est le doublage par IA et comment il fonctionne.
Les trois composants qui déterminent la qualité
La qualité de sortie n'est pas un chiffre unique. Elle est le produit de trois étapes, chacune avec ses propres modes de défaillance, il est donc utile de les évaluer séparément plutôt que de se fier à une impression globale.
La reconnaissance automatique de la parole identifie les mots dans l'enregistrement source, et sa précision chute avec la musique de fond, les locuteurs qui se chevauchent, les accents prononcés, la parole rapide ou incomplète, les termes spécifiques à un domaine, les microphones de mauvaise qualité et l'alternance de codes entre langues. Une métrique courante ici est le taux d'erreur de mots (WER), qui compare une transcription automatique à une référence humaine en comptant les substitutions, les suppressions et les insertions. La même publication du NIST utilise le WER comme référence de reconnaissance, bien qu'un WER faible ne confirme pas que la traduction ultérieure a préservé le sens ou le ton. Si votre audio source est bruyant, isoler d'abord la parole propre avec un outil comme notre séparateur de parole peut améliorer la précision de reconnaissance avant même que la traduction ne commence.
La traduction automatique doit interpréter plus que des mots individuels. Elle gère la structure des phrases, le contexte, les pronoms et le genre, les expressions idiomatiques, l'humour, la formalité, les références culturelles, la terminologie technique et les différences d'ordre des mots. Une traduction littérale peut être grammaticalement correcte mais sonner de façon peu naturelle ou modifier discrètement le sens voulu, ce qui est particulièrement risqué pour les allégations publicitaires, les instructions juridiques, les informations médicales, le contenu financier et le matériel éducatif.
La synthèse vocale génère la voix finale en langue cible, contrôlant la prononciation, les pauses, le débit de parole, l'intonation, l'emphase, le ton émotionnel, l'identité vocale et l'accent ou la variante linguistique. Notre produit Synthèse vocale propose plus de 300 voix IA, une génération multilingue et le clonage vocal dans 33 langues, avec des contrôles pour le débit de parole, l'emphase, la lecture des nombres et le rendu émotionnel. Une traduction techniquement exacte peut tout de même mal passer si le rendu ne convient pas à la marque, au cours ou au documentaire auquel elle appartient.
Le clonage vocal dans la parole traduite
Le clonage vocal est optionnel, mais c'est ce qui fait que le contenu traduit semble provenir du même créateur plutôt que d'un inconnu lisant un script. Au lieu d'attribuer une voix stock sans rapport à chaque langue, un système peut construire une performance en langue cible modélisée sur l'identité vocale du locuteur d'origine. Cette continuité compte pour une chaîne qui veut une voix reconnaissable à travers les langues, une entreprise avec un présentateur connu, un long cours animé par un formateur, un cinéaste ayant besoin de cohérence entre les versions doublées, ou un animateur de podcast conservant un son familier dans les épisodes traduits.
Ce n'est pas une garantie. Le clonage préserve l'identité vocale, mais l'émotion, l'humour, le rythme, la prononciation et le contexte culturel nécessitent toujours une relecture humaine avant la publication. Tout aussi important est l'autorisation : un flux de travail responsable confirme que la personne ayant fourni l'enregistrement a consenti au clonage et que la voix obtenue peut être utilisée pour la distribution commerciale, publique ou géographique prévue. Si les mécanismes derrière cela vous intéressent, notre aperçu sur comment fonctionne le clonage vocal va plus en profondeur, et l'outil de clonage vocal montre le côté production.
Traduction enregistrée face à traduction en temps réel
C'est la décision à laquelle la plupart des équipes sont réellement confrontées, et les deux modes ne devraient pas être jugés à la même aune.
La traduction enregistrée est généralement la meilleure option pour la production de médias car elle vous donne du temps pour travailler. Vous pouvez corriger la transcription, modifier la terminologie, réviser la traduction, identifier les locuteurs, ajuster la synchronisation, régénérer les voix, mixer l'audio de fond et exécuter une assurance qualité humaine avant toute diffusion. Cela la rend bien adaptée aux chaînes YouTube, à l'apprentissage en ligne, à la formation en entreprise, aux podcasts, aux vidéos produit et aux films indépendants.
La traduction en temps réel fonctionne sous une contrainte plus difficile : elle doit commencer à produire une sortie avant que le locuteur ne termine une phrase. Davantage de contexte améliore la qualité de traduction mais ajoute du délai, tandis que des délais plus courts forcent des prédictions ou des traductions partielles, et les erreurs sont difficiles à retirer une fois que l'audio a déjà été joué. Le rapport du DTIC note que les systèmes en cascade antérieurs fonctionnaient souvent avec des délais de quatre à cinq secondes, accumulaient des erreurs à travers les étapes et offraient une personnalisation limitée, et qu'augmenter l'anticipation d'un modèle peut améliorer la qualité tout en rendant l'interaction moins immédiate. Une fonctionnalité de conférence en direct et un doublage multilingue soigné résolvent des problèmes différents, alors tenez-les à des normes différentes.
Comment évaluer un flux de travail voix à voix
Testez avec un échantillon représentatif, pas avec une phrase de démonstration bien nette. La liste de contrôle ci-dessous reflète les conditions réelles que votre contenu rencontrera, et elle garde l'évaluation honnête.
- Couverture des langues et dialectes : « Prend en charge l'espagnol » peut ne pas correspondre à l'accent, au vocabulaire ou aux préférences régionales que votre audience attend. Confirmez les variantes source et cible, y compris l'anglais américain face aux autres anglais, l'espagnol latino-américain face à l'espagnol européen, et le français canadien face au français européen.
- Précision de la transcription : Une traduction ne peut pas corriger de façon fiable une transcription qui massacre les noms, les nombres ou les termes produit. Vérifiez si vous pouvez inspecter et modifier la transcription avant de générer l'audio.
- Sens et contexte : Testez délibérément les expressions idiomatiques, les blagues, les appels à l'action, les allégations produit et la terminologie sectorielle. La fluidité n'est pas la précision.
- Gestion des locuteurs : Pour les entretiens, les tables rondes et les films, vérifiez que l'outil peut identifier plusieurs locuteurs et maintenir leurs voix cohérentes, y compris lorsque les personnes s'interrompent.
- Synchronisation et calage : Les phrases traduites correspondent rarement à la durée d'origine. Recherchez des contrôles de synchronisation ou de débit de parole, ainsi que l'édition des dialogues, la préservation de l'audio de fond, l'ajustement du volume, la régénération de segments et l'alignement visuel si nécessaire.
- Naturel de la voix : Écoutez la prononciation, les pauses, l'emphase, la gamme émotionnelle et un rythme non naturel.
- Latence : Pour une utilisation en direct, mesurez le délai entre le locuteur et l'audio. Pour une utilisation enregistrée, privilégiez la flexibilité d'édition plutôt que la vitesse brute de traitement.
- Contrôles de révision et d'export : Un outil prêt pour la production vous permet de corriger le texte, de régénérer des segments individuels, d'ajuster la synchronisation et d'exporter dans un format que votre flux de publication accepte.
Passez ces échantillons dans votre liste restreinte et comparez la précision de transcription, le sens de la traduction, la prononciation, le naturel de la voix, la cohérence des locuteurs, la synchronisation, la qualité de l'audio de fond, l'effort de révision et le coût total à votre volume attendu. Le système le plus performant n'est pas celui qui possède le plus de voix ou de langues. C'est celui qui produit des résultats acceptables pour votre contenu spécifique avec une charge de révision que votre équipe peut réellement soutenir.
Risques et limites à anticiper
Chaque étape introduit son propre type d'erreur, et une voix au son naturel peut toutes les masquer. L'IA peut mal traduire des expressions ambiguës, des noms, des idiomes et des termes spécialisés, de sorte que la révision humaine reste essentielle partout où la précision comporte un enjeu juridique, de sécurité, financier ou de réputation. Les erreurs de reconnaissance aggravent le problème : le bruit, les conversations croisées, les accents et les mauvais enregistrements peuvent amener le système à mal entendre la source, raison pour laquelle réviser la transcription avant d'approuver la traduction est non négociable.
Le sens culturel est facile à perdre. Une traduction directe peut faire disparaître l'humour, la politesse ou des références qui ne survivent qu'à une réécriture plutôt qu'à un passage mot à mot. Le clonage vocal ajoute un risque de consentement et d'usurpation d'identité, alors documentez qui a autorisé la voix, l'étendue d'utilisation, le territoire, la durée et si elle peut apparaître dans de la publicité ou des déclarations publiques synthétiques. Il y a aussi une dimension de confiance de l'audience : le rapport du DTIC décrit comment une expérience de traduction informe les utilisateurs que l'audio traduit est généré de façon synthétique, une attente raisonnable à prévoir dans vos propres divulgations.
Deux risques plus discrets complètent la liste. La confidentialité compte dès lors que l'audio contient des informations personnelles, des discussions confidentielles, des données clients ou du contenu non publié, alors examinez les conditions d'un fournisseur en matière de traitement des données, de conservation, d'accès et de suppression avant de téléverser. Et la fausse confiance est la défaillance la plus insidieuse de toutes : une voix soignée fait paraître une traduction incorrecte comme faisant autorité, alors ne traitez jamais la fluidité comme une preuve d'exactitude factuelle.
La place de DubSmart
Nous sommes le plus directement pertinents pour la traduction voix à voix enregistrée via le doublage par IA, plutôt que pour toute prétention de traduction conversationnelle universelle en direct. Notre flux de travail de doublage accepte les téléversements audio et vidéo ainsi que les liens YouTube, prend en charge plus de 60 langues source et 33 langues cible, clone la voix de chaque locuteur pour la version traduite, et vous permet de modifier le texte, les locuteurs et les synchronisations, de régénérer des segments, d'ajuster le volume du son de fond et de télécharger le projet finalisé. Cette couche éditoriale est exactement ce dont la production de médias enregistrés a besoin.
Pour les équipes qui construisent leurs propres pipelines, nous proposons également des API de doublage par IA, de synthèse vocale et de clonage vocal, qui conviennent aux agences, aux flux de travail de médias et aux applications qui ont besoin d'automatiser la production vocale multilingue. Le bon choix se résume à savoir si votre projet souhaite un éditeur de médias finalisé, un pipeline piloté par API, ou les deux. Pour un message court à fort enjeu, la traduction et l'enregistrement humains professionnels peuvent encore l'emporter ; pour une bibliothèque de contenu vaste et fréquemment mise à jour, un flux de travail par IA passe mieux à l'échelle avec une révision humaine concentrée sur le matériel le plus à risque.
Questions fréquentes
La traduction voix à voix est-elle la même chose que l'interprétation ?
Non. L'interprétation humaine repose sur une personne formée qui écoute, comprend et transmet le sens sur le moment. La traduction voix à voix est automatisée : rapide et évolutive, mais elle peut nécessiter une révision et peut avoir du mal avec les nuances qu'un interprète professionnel gère naturellement.
Fonctionne-t-elle toujours en temps réel ?
Non. Certains systèmes traitent de l'audio enregistré avec un contrôle d'édition complet, tandis que d'autres fournissent une sortie en direct ou en quasi-temps réel. Les systèmes en direct équilibrent constamment le contexte de traduction, la latence et la précision.
Peut-elle préserver la voix du locuteur d'origine ?
Parfois. Les systèmes qui utilisent le clonage vocal ou la synthèse préservant la voix peuvent modéliser l'identité du locuteur d'origine, mais le résultat dépend de la technologie, de la paire de langues, de la qualité audio et de l'autorisation d'utiliser cette voix.
Le doublage par IA est-il une forme de traduction voix à voix ?
Oui. Le doublage par IA est une application de la traduction voix à voix aux médias enregistrés qui ajoute des fonctionnalités d'édition, de gestion des locuteurs, de synchronisation, de mixage et d'export par-dessus la traduction de base.
Quelle est sa précision ?
La précision varie selon la langue, la qualité d'enregistrement, la terminologie, le locuteur et le système. Évaluez la transcription, la traduction et l'audio généré séparément plutôt que de vous fier à un seul pourcentage de précision.