Un séparateur de voix sert à extraire une voix parlée d'un enregistrement désordonné—en l'éloignant du trafic, de la musique, de l'écho de la pièce ou d'une seconde personne qui parle—pour obtenir au final une piste vocale plus propre que vous pouvez transcrire, éditer, doubler ou réutiliser. Cette simple tâche sous-tend un nombre surprenant de travaux de production du quotidien. Un YouTubeur élimine le bruit de la rue d'une interview. Un producteur de podcast récupère un dialogue enregistré dans un café bondé. Une équipe marketing prépare un échantillon propre avant de cloner une voix. L'outil fait une seule chose bien, et comprendre exactement ce qu'est cette chose vous évite de lui demander d'accomplir des tâches pour lesquelles il n'a jamais été conçu.
Voyez-le comme une couche de nettoyage plutôt qu'une couche de création. Il ne traduit pas, il ne génère pas de nouvelle narration, et il ne déguise pas un locuteur. Il prend un audio contenant déjà de la parole et vous rend cette parole avec moins d'interférences autour. Tout ce qui suit explore où cela aide réellement, comment le modèle sous-jacent aborde le problème, et quand vous devriez plutôt recourir à un autre outil.
Table des matières
Comment fonctionne réellement un séparateur de voix
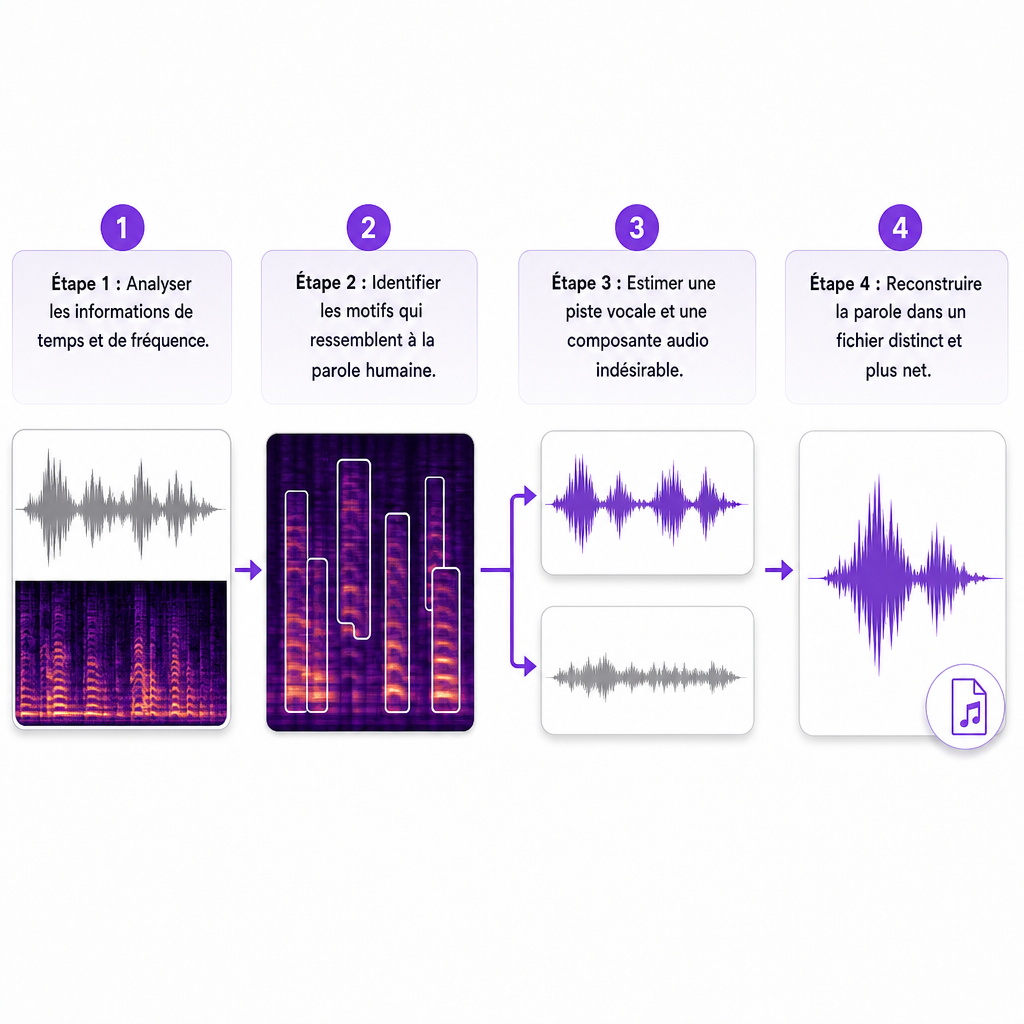
Sous le bouton se trouve un modèle d'IA entraîné à reconnaître les motifs qui caractérisent la parole humaine et à les distinguer de tout le reste du mélange. Il lit les informations temporelles et fréquentielles de l'enregistrement, estime quelles parties du signal sont de la voix et lesquelles sont des sons indésirables, puis reconstruit la parole sous forme d'un fichier séparé et plus propre. De nombreux systèmes utilisent une approche basée sur des masques : les parties du signal liées à la parole sont autorisées à passer tandis que les autres éléments sont réduits. Les pipelines plus avancés empilent la suppression du bruit, la séparation des locuteurs et la déréverbération. Une recherche de Microsoft décrit des systèmes monocanaux en temps réel qui combinent ces étapes pour extraire plusieurs locuteurs du bruit et de la réverbération.
La réserve importante réside dans le mot reconstruire. Le résultat n'est pas l'enregistrement propre d'origine que vous auriez souhaité capturer. C'est une estimation par l'IA de ce à quoi la parole devrait ressembler une fois les interférences disparues, de sorte que des mélanges complexes peuvent produire des artefacts—tonalités métalliques, consonnes perdues, chevrotements ou transitions non naturelles. Les performances chutent également dans des conditions réalistes de champ lointain et de réverbération, comme le documente la recherche sur la séparation de la parole portant sur des enregistrements réels. Plus le microphone était éloigné du locuteur et plus la pièce résonnait, plus la tâche du modèle devient difficile.
Séparation contre suppression du bruit : pourquoi l'étiquette compte
Ces termes sont utilisés de façon interchangeable, mais la tâche dont vous avez réellement besoin change l'outil qui convient. La suppression du bruit réduit les sons de fond indésirables. L'amélioration de la parole rend une voix existante plus facile à comprendre. La séparation de la parole extrait la voix d'un signal réellement mélangé. La séparation des locuteurs va un cran plus loin et tente de produire des pistes distinctes lorsque deux personnes parlent en même temps. Et la séparation vocale divise les pistes musicales, ce qui est une discipline différente visant les chansons plutôt que les dialogues.
| Tâche | Objectif principal | Exemple |
|---|---|---|
| Suppression du bruit | Réduire les sons de fond indésirables | Atténuer le trafic ou le bourdonnement d'un climatiseur |
| Amélioration de la parole | Améliorer l'intelligibilité de la parole | Rendre une interview discrète plus facile à entendre |
| Séparation de la parole | Extraire la parole d'un signal mélangé | Isoler un dialogue de la musique ou de l'ambiance |
| Séparation des locuteurs | Donner à chaque locuteur une piste distincte | Séparer deux personnes qui parlent en même temps |
| Séparation vocale | Diviser les éléments musicaux en pistes | Extraire les voix d'une piste instrumentale |
Notre Séparateur de voix se situe du côté de l'isolation de la parole et de la suppression du bruit de fond de ce tableau. Son rôle est de vous remettre une piste vocale plus propre, et la page produit cite le cinéma, les podcasts, les interviews, les voix off et la préparation au clonage de voix comme les flux pour lesquels il est conçu. Il accepte les formats audio courants tels que MP3, WAV et AAC, ainsi que les fichiers vidéo. Savoir dans quelle colonne vous vous trouvez vous évite d'attendre des pistes par locuteur d'un outil réglé pour le nettoyage de la voix par rapport au bruit.
Les huit tâches pour lesquelles on emploie un séparateur de voix
Les cas d'usage se recoupent, mais chacun résout un problème légèrement différent. Les lire comme des tâches distinctes vous aide à décider si la séparation est la bonne première étape ou si un autre outil doit intervenir plus tôt dans la chaîne.
Nettoyer les enregistrements d'interviews. Les interviews ont rarement lieu dans des pièces traitées acoustiquement. Bureaux, rues, événements et domiciles laissent tous passer du son dans la prise. La séparation réduit cette distraction et rend le sujet plus facile à entendre avant de monter, sous-titrer ou doubler. Ce qu'elle ne peut pas faire, c'est inventer une parole qui n'a jamais été captée—si le micro était trop loin ou qu'un groupe bruyant a enterré la voix, il se peut qu'il n'y ait rien de propre à récupérer.
Améliorer l'audio de podcast. Le cliquetis du clavier, les ventilateurs, le souffle et l'écho de la pièce encombrent tous une conversation. Une piste plus propre facilite le travail ultérieur : couper les pauses, équilibrer les intervenants, extraire des clips et rédiger des notes d'émission. Lorsque plusieurs personnes parlent simultanément, les résultats dépendent fortement du degré de chevauchement, et les modèles réglés pour les locuteurs qui se chevauchent peuvent introduire leurs propres artefacts de traitement.
Préparer l'audio pour la reconnaissance vocale. Les moteurs de transcription font leur meilleur travail lorsque les mots sont clairs et les interférences faibles. Exécuter d'abord la séparation améliore souvent une passe de transcription, de sous-titres ou de légendes. Notre outil Speech to Text transcrit l'audio et la vidéo et génère des sous-titres dans plusieurs langues, et sa précision varie toujours selon la qualité audio, les accents et les conditions d'enregistrement. Considérez la séparation comme une étape de préparation, pas comme une garantie : dans certains cas, les artefacts d'amélioration peuvent en réalité réduire la précision de la reconnaissance, donc comparer les pistes nettoyée et originale en vaut la peine pour tout ce qui est important.
Nettoyer les dialogues pour la post-production vidéo. Les monteurs combattent régulièrement le vent, le trafic, le bourdonnement, la manipulation du micro et les débordements de musique de fond. Une piste de dialogue utilisable peut ensuite être remixée avec des effets ou une voix off de remplacement, et le résultat vous indique souvent si une scène est récupérable en post-production ou nécessite un nouvel enregistrement. Un traitement agressif peut supprimer la tonalité naturelle de la pièce, donc les sorties professionnelles méritent toujours l'oreille d'un monteur.
Améliorer l'entrée du clonage de voix. Un modèle de clonage apprend les caractéristiques d'un locuteur à partir d'un échantillon, et le bruit, la musique et l'écho rendent cela plus difficile. Une entrée plus propre tend à produire un meilleur résultat, c'est pourquoi nous présentons la séparation comme une étape de préparation au clonage sur la page du Séparateur de voix. Cela compte le plus lorsque votre seul échantillon provient d'une vidéo avec musique, d'un enregistrement téléphonique ou d'un direct. L'échantillon doit être utilisable légalement et éthiquement : ne téléversez que des audios que vous possédez ou que vous avez l'autorisation de traiter, et obtenez le consentement du locuteur avant de créer ou de déployer un clone.
Créer des voix off plus claires. Lorsqu'un réenregistrement est peu pratique mais qu'une prise de narration comporte un bruit modéré, la séparation peut la nettoyer suffisamment pour l'ajouter à une vidéo, l'associer à de la musique ou la monter en format court. Elle ne générera pas de nouvelle narration—si la prise est vraiment inutilisable, une voie de synthèse vocale ou de clonage de voix convient mieux.
Soutenir la localisation et le doublage. Avant de traduire une vidéo, vous souhaitez souvent une piste de dialogue propre pour pouvoir transcrire, sous-titrer et doubler tout en préservant ou en remixant l'arrière-plan. Nous proposons également le Doublage par IA pour localiser du contenu, mais la séparation et le doublage font des tâches différentes : la séparation nettoie l'audio source, tandis que le doublage génère de la parole dans une autre langue.
Récupérer la parole d'archives bruyantes. De vieilles séquences, des webinaires, des réunions enregistrées et des clips générés par les utilisateurs deviennent parfois suffisamment intelligibles pour la compréhension ou une transcription approximative. Pour les documents juridiques, médicaux, financiers ou sensibles en matière de conformité, vérifiez le résultat par rapport à l'original, car le traitement par IA peut altérer ou supprimer des mots.
Quand en utiliser un et quand réenregistrer
La séparation mérite sa place lorsque la voix est présente mais masquée par des interférences modérées, lorsque vous avez besoin d'une piste de dialogue plus propre à monter, lorsque vous améliorez l'entrée avant la transcription ou le clonage, ou lorsque réenregistrer n'est tout simplement pas pratique. Le point commun est qu'une parole récupérable existe dans le fichier.
Elle peine lorsque la voix est extrêmement faible ou inintelligible, lorsque plusieurs personnes parlent les unes sur les autres en continu, lorsque la musique masque complètement la voix, ou lorsque l'enregistrement comporte un écho ou une distorsion sévère. C'est aussi le mauvais outil lorsque vous avez besoin d'une restauration de qualité médico-légale ou broadcast, ou lorsque l'exactitude mot pour mot est essentielle et que personne ne relira le résultat. Plus les interférences sont sévères, plus le risque d'artefacts audibles est grand—et des facteurs réels comme la distance du micro, la réverbération et les locuteurs multiples réduisent tous les performances de séparation. Si la prise originale est déformée ou enfouie, un nouvel enregistrement sonne généralement plus naturel que tout ce que vous pouvez sauver.
Comment évaluer un séparateur de voix avant de vous engager
Choisissez l'outil en fonction de l'enregistrement précis que vous devez corriger, pas d'un clip de démonstration propre. Quelques critères distinguent un bon choix d'un choix frustrant.
- Type de séparation. Décidez si vous avez besoin d'extraire la parole du bruit, le dialogue de la musique, un locuteur d'un autre, ou les voix d'un instrumental. Un outil conçu pour l'isolation de la parole peut ne pas produire une piste distincte pour chaque voix d'une conversation.
- Formats d'entrée et limites. Confirmez que l'outil accepte votre fichier source. Notre Séparateur de voix prend en charge les fichiers MP3, WAV, AAC et vidéo ; vérifiez tout de même la taille maximale de fichier et les formats d'export avant un grand projet.
- Qualité audio en conditions réelles. Testez un échantillon qui inclut le pire bruit de fond de votre projet, afin de juger l'outil sur votre cas le plus difficile plutôt que sur le plus facile.
- Artefacts de sortie. Écoutez les tonalités métalliques, les consonnes manquantes, les syllabes saccadées, les débordements de musique et les chevrotements pendant la parole qui se chevauche. Pour un contenu important, comparez la sortie traitée avec l'original et relisez la transcription à la main.
- Compatibilité avec le flux de travail. Vérifiez ce dont l'étape suivante a besoin. Si une transcription suit, assurez-vous que la sortie se télécharge dans un format utilisable ; si un clonage ou un doublage suit, confirmez que les fichiers passent sans conversion inutile.
- Confidentialité et consentement. L'audio peut contenir des données personnelles ou des voix identifiables. Confirmez que vous avez l'autorisation de le téléverser et de le traiter, et traitez les échantillons de clonage avec un soin particulier, puisqu'un échantillon nettoyé facilite la reproduction d'une voix.
Comment la séparation s'intègre à un flux de localisation DubSmart
La séparation fonctionne rarement seule. C'est la couche de nettoyage en tête d'une chaîne plus longue, et les outils qui l'entourent déterminent la valeur qu'elle ajoute. Pour un créateur qui localise une interview, une séquence sensée ressemble à ceci :
- Exécutez le Séparateur de voix pour isoler et nettoyer le dialogue.
- Envoyez l'audio nettoyé à la reconnaissance vocale pour obtenir une transcription modifiable.
- Vérifiez les noms, les termes techniques, les chiffres et toute section peu claire.
- Traduisez ou adaptez le texte approuvé.
- Générez l'audio doublé ou narré via le bon flux de travail vocal.
- Comparez l'audio final avec l'original pour le sens, le ton et le timing.
Ce schéma convient aussi bien aux chaînes YouTube, aux podcasts, aux cours en ligne, aux vidéos marketing qu'aux films indépendants. Le séparateur s'occupe de la seule tâche dans laquelle il est bon ; il ne remplace pas la transcription, la traduction, le montage ou la gestion du consentement. Lorsque vous gardez ces rôles distincts, chaque outil reçoit une entrée correcte et le résultat final tient la route.
Foire aux questions
Un séparateur de voix peut-il supprimer la musique de fond ?
Il peut réduire ou isoler la parole de la musique de fond, mais le résultat dépend du volume, de la complexité et du caractère vocal de la musique. Écoutez toujours les débordements de musique et les artefacts de parole avant de vous fier au résultat.
La séparation de la parole peut-elle améliorer la transcription ?
Généralement oui—nettoyer les interférences rend la parole plus facile à lire pour un moteur de transcription. Mais l'amélioration peut occasionnellement introduire des artefacts qui nuisent à la précision, donc les transcriptions importantes nécessitent toujours une passe de relecture humaine.
Puis-je utiliser un séparateur de voix avant le clonage de voix ?
Oui. Un échantillon plus propre donne une meilleure entrée à un modèle de clonage. N'utilisez que des audios que vous possédez ou que vous avez l'autorisation de traiter, et obtenez le consentement du locuteur avant de créer ou de déployer un clone.
Sépare-t-il deux personnes qui parlent en même temps ?
Certains systèmes de séparation de la parole tentent de le faire, mais les locuteurs qui se chevauchent sont bien plus difficiles que la suppression ordinaire du bruit. Les résultats varient selon la qualité du microphone, la similitude des locuteurs, l'écho de la pièce et le degré de chevauchement des voix.
Un séparateur de voix est-il la même chose qu'un modificateur de voix ?
Non. Un séparateur nettoie ou isole une parole qui existe déjà. Un modificateur de voix transforme l'identité vocale d'un locuteur. La séparation diffère aussi de la reconnaissance vocale, de la synthèse vocale, du clonage de voix et du doublage par IA—des outils connexes qui résolvent des problèmes différents.