Si votre micro capte la circulation, le brouhaha d'un café ou un fond musical posé juste par-dessus les dialogues, la question n'est pas de savoir si l'enregistrement est utilisable, mais comment en extraire proprement la voix. C'est exactement ce que fait un séparateur de parole. En termes simples, un séparateur de parole est un outil audio propulsé par l'IA qui isole la parole humaine de tout le reste dans un enregistrement — bruit de fond, musique et autres sons — afin qu'il ne vous reste qu'une piste vocale propre que vous pouvez transcrire, doubler, cloner ou remixer. Pour quiconque produit du contenu multilingue, cette piste propre fait toute la différence entre un doublage qui sonne professionnel et un doublage qui sonne « assez bien ».
Ce guide explique ce qu'est réellement un séparateur de parole, comment il fonctionne en coulisses, quand vous en avez véritablement besoin et ce qu'il faut évaluer avant de vous engager avec un outil. Nous intégrons le Séparateur de parole au flux de travail de DubSmart AI précisément parce que la parole propre est le fondement sur lequel tout le reste repose.
Table des matières
Ce qu'est vraiment un séparateur de parole
Dans la recherche audio, la séparation de parole est définie comme la tâche consistant à séparer la parole cible des interférences de fond dans un enregistrement mixte. Les systèmes plus avancés vont plus loin et séparent plusieurs locuteurs les uns des autres, produisant une piste isolée pour chaque voix.
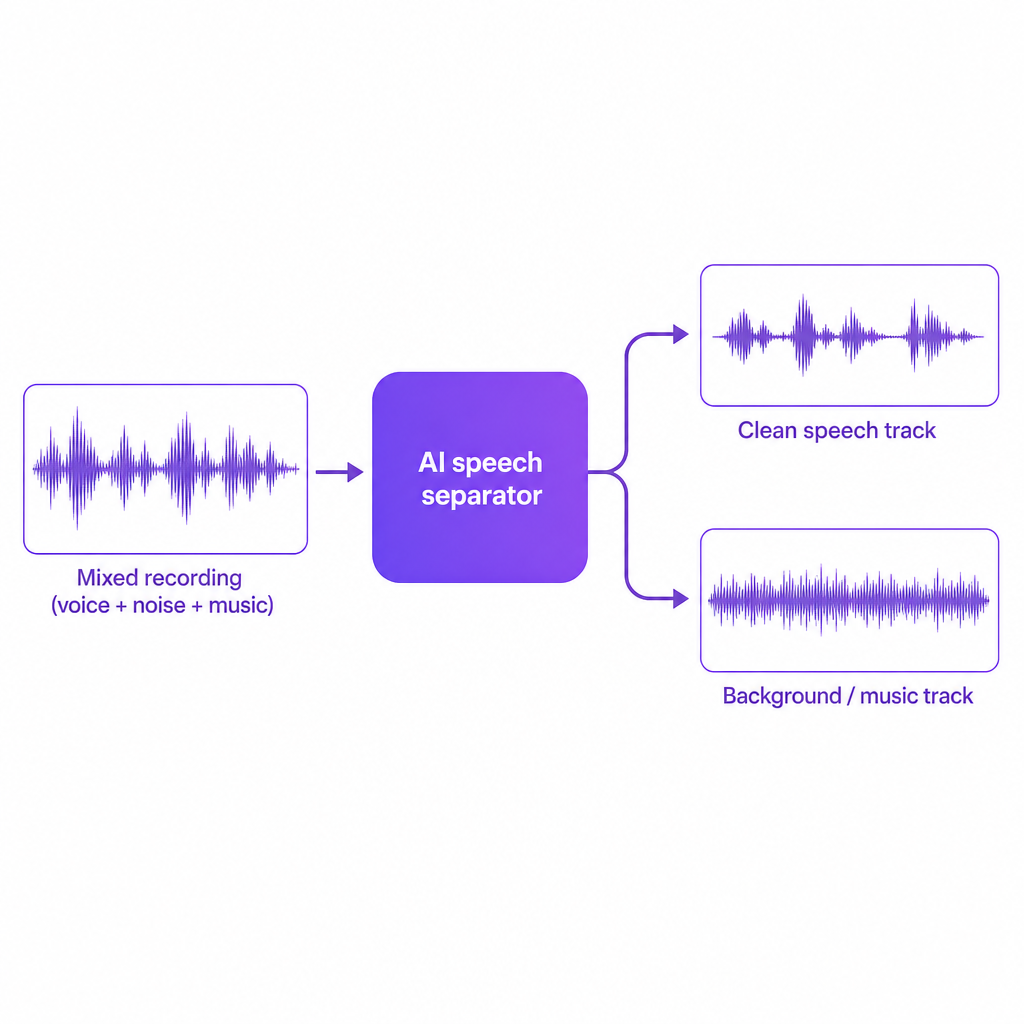
Transposé dans le travail de production quotidien, un séparateur de parole prend un fichier audio mixte — dialogue additionné de bruit ou de musique — et produit une ou plusieurs pistes contenant uniquement la parole, plus une piste optionnelle contenant l'audio de fond restant. Notre Séparateur de parole est conçu pour supprimer le bruit de fond et isoler la parole de n'importe quel enregistrement, ce qui le rend particulièrement adapté à la post-production de films, de podcasts et d'interviews. Il fonctionne aussi bien sur les fichiers audio que vidéo : il peut débruiter des enregistrements provenant d'environnements bruyants et séparer les voix d'une piste d'accompagnement, de sorte que vous obtenez des stems distincts de voix et de fond.
C'est là qu'une idée fausse courante induit les gens en erreur. Un séparateur de parole n'est pas la même chose que la réduction de bruit traditionnelle. La réduction de bruit abaisse le volume des sons indésirables. Un séparateur de parole identifie activement où la parole est présente dans le signal et la reconstruit sous la forme d'un flux distinct et plus propre. Cette distinction explique pourquoi un séparateur peut sauver une voix enfouie sous la musique, tandis qu'un noise gate ne fait généralement que rendre l'ensemble de l'enregistrement plus silencieux.
En avez-vous réellement besoin ?
La véritable question est de savoir si votre travail dépend d'un audio vocal fiable et propre plutôt que de ce que le micro a bien voulu capter. Si c'est le cas, un séparateur dédié cesse d'être un simple plus pour devenir une étape fondamentale.
Plusieurs situations rendent cet investissement évident. Les créateurs YouTube et les petites entreprises réutilisent souvent d'anciennes séquences enregistrées dans des salles à écho, des cafés ou dans la rue, où le bruit rend la parole difficile à comprendre et à transcrire. Les équipes de e-learning et de formation construisent des cours multilingues à partir de webinaires et de conférences en direct, où chaque transcription et chaque doublage en aval hérite de la qualité de la parole d'origine. Les cinéastes et les producteurs de podcasts ont fréquemment besoin de sauver une belle performance captée dans des conditions imparfaites avant de la remixer avec la musique et le sound design. Et les développeurs ou agences qui injectent de l'audio utilisateur dans des pipelines de transcription, de clonage vocal ou de doublage savent que des entrées bruyantes dégradent directement la précision des modèles.
Quelques déclencheurs concrets indiquent qu'un séparateur vaut la peine d'être adopté :
- Vous localisez dans plusieurs langues et souhaitez un doublage et des sous-titres cohérents et clairs. Une parole propre alimente nos moteurs de Doublage IA et de Reconnaissance vocale bien plus fiablement qu'un mix bruyant.
- Vous vous appuyez sur le clonage vocal pour une voix de marque ou de personnage et souhaitez obtenir les meilleurs résultats possibles en vous entraînant sur des échantillons débruités et sans artefacts.
- Vous recevez régulièrement des enregistrements générés par les utilisateurs ou pris sur le terrain, que vous ne contrôliez pas, et vous devez néanmoins les rendre prêts à la diffusion. Un séparateur vous offre une étape de nettoyage reproductible au lieu de peaufiner chaque fichier à la main.
L'exception honnête : si votre audio est déjà enregistré dans un studio traité, avec des stems séparés pour le dialogue et la musique, un séparateur est un confort plutôt qu'une nécessité. Pour tous les autres qui travaillent avec du son du monde réel, il gagne une place permanente dans le pipeline.
Comment fonctionne la séparation de parole en coulisses
La séparation de parole moderne repose sur l'apprentissage profond et la recherche en séparation de sources, et non sur de simples égaliseurs et filtres. La tâche sous-jacente est simple à énoncer et difficile à résoudre : étant donné un signal mixte contenant plusieurs sources, récupérer les signaux de parole individuels sans les connaître à l'avance.
La plupart des systèmes actuels suivent un pipeline encodeur–séparateur–estimateur–décodeur. L'encodeur transforme la forme d'onde brute ou le spectrogramme en un espace de caractéristiques à haute dimension où les motifs pertinents pour la parole, comme les formants et les harmoniques, deviennent plus faciles à détecter. Le séparateur — un réseau de neurones — traite ces caractéristiques et apprend à découpler les informations appartenant à différentes sources sonores, qu'il s'agisse de parole contre bruit ou d'un locuteur contre un autre. L'étape d'estimation prédit ensuite soit des masques qui filtrent les composantes non vocales, soit estime directement la représentation caractéristique de chaque source. Enfin, le décodeur reconvertit ces représentations séparées en audio dans le domaine temporel, produisant une ou plusieurs pistes de parole propres et éventuellement une piste de fond résiduelle.
Ces modèles sont entraînés sur de vastes ensembles de données remplis de mélanges de parole et de bruit, apprenant les motifs discriminants de la parole, des locuteurs et des interférences à partir d'exemples annotés. Des recherches plus récentes conditionnent le séparateur sur des embeddings de locuteurs ou des invites, ce qui permet de cibler la séparation sur une voix spécifique au sein d'un audio encombré.
L'enseignement pratique pour les créateurs est qu'un séparateur moderne n'est pas un noise gate amélioré. C'est un modèle qui a appris à quoi ressemble la parole, en apparence et en son, dans de nombreuses conditions, et qui peut reconstruire une voix même lorsqu'elle est enfouie sous la musique, le bruit de foule ou l'écho d'une pièce.
Les deux principales tâches de séparation
En pratique, vous rencontrerez deux variantes de séparation de parole, et les plateformes les combinent souvent.
La première est la parole d'un locuteur unique contre le fond : extraire une piste vocale cohérente du bruit, de la musique ou de l'ambiance. C'est la tâche sur laquelle se concentre notre Séparateur de parole pour les films, les podcasts et les interviews, car elle correspond directement à ce dont la plupart des créateurs ont besoin au quotidien.
La seconde est la séparation multi-locuteurs, où le système produit une piste distincte pour chaque locuteur d'une conversation. C'est particulièrement utile pour la diarisation et l'analyse dans les réunions ou les tables rondes en format long, où savoir qui a dit quoi importe autant que ce qui a été dit.
Les outils grand public ont tendance à présenter ces fonctions dans des interfaces simples — téléchargez une chanson pour obtenir des pistes vocales et instrumentales séparées, ou isolez le dialogue d'une vidéo pour le montage. Notre implémentation met l'accent sur la séparation parole/fond, car c'est la tâche la plus immédiatement précieuse pour les flux de travail de doublage, de transcription et de clonage.
Ce qu'il faut évaluer avant de choisir un séparateur
Lorsque vous évaluez si un séparateur répond à des besoins professionnels, quelques critères comptent davantage que les arguments marketing.
Commencez par la qualité de la parole et les artefacts. Un bon séparateur préserve le timbre naturel d'une voix au lieu de la faire sonner métallique, sous l'eau ou déphasée, et il évite d'introduire du bruit musical ou une distorsion agressive lorsqu'il supprime des éléments de fond forts comme la musique. Les études universitaires signalent les interférences résiduelles et les artefacts comme les principaux défis, en particulier dans le bruit non stationnaire. Le test le plus fiable reste encore de vérifier des échantillons de sortie sur votre propre matériel.
La robustesse face au bruit du monde réel vient ensuite. Les modèles entraînés sur des données de laboratoire propres peuvent avoir du mal avec la circulation, le vent, le murmure de la foule, les salles réverbérantes et les contenus où la parole chevauche une musique ou des effets forts. Les travaux de pointe ciblent précisément ces mélanges complexes, mais les performances varient encore selon les conditions d'enregistrement — testez donc dans les environnements où vous enregistrez réellement, des bureaux aux rues en passant par les home studios.
La gestion de la musique et du contenu mixte est un besoin fréquent et spécifique. Retirer une bande-son pour redoubler, ou isoler une narration d'images d'illustration, exige un outil qui prend explicitement en charge la séparation musique/voix et produit deux fichiers utilisables plutôt qu'un seul résultat étouffé. Notre pipeline de séparation détecte les fréquences vocales, les isole de la musique et produit des fichiers distincts de haute qualité : l'un avec des voix propres et l'autre avec le fond musical. C'est particulièrement utile lorsque vous prévoyez de remixer, réorchestrer ou redoubler dans d'autres langues.
L'intégration avec les outils en aval détermine le temps que le séparateur fait réellement gagner. La séparation vit rarement seule — elle alimente des modèles de transcription où une entrée plus propre réduit les taux d'erreur de mots, des moteurs de clonage vocal qui récompensent les échantillons sans bruit, et des systèmes de doublage qui alignent la parole d'origine avec les pistes traduites. Notre plateforme est bâtie autour d'un flux de travail unifié qui réunit Séparateur de parole, Reconnaissance vocale, Synthèse vocale, Clonage vocal et Doublage IA en un seul endroit, de sorte qu'un seul enregistrement nettoyé peut devenir un contenu multilingue, à voix clonée et entièrement localisé sans reconstruire un pipeline à chaque fois.
La latence, l'échelle et l'automatisation comptent pour quiconque a un arriéré à traiter. Les podcasts, cours et archives en format long nécessitent un traitement par lots capable de gérer des fichiers de plusieurs heures, des temps de traitement par fichier raisonnables et des points d'ancrage d'automatisation où la séparation s'insère dans vos propres systèmes. Nous proposons des API de Synthèse vocale, de Clonage vocal et de Doublage IA afin que les développeurs puissent intégrer le traitement de la parole dans des pipelines de bout en bout.
Enfin, la confidentialité et la conformité ne disparaissent pas une fois l'audio nettoyé. Séparer la parole du fond ne supprime pas votre responsabilité concernant des enregistrements pouvant contenir des conversations sensibles, ni le respect des droits lorsque vous extrayez et réutilisez des voix issues de contenus sous licence. Les équipes d'entreprise devraient confirmer des politiques claires sur la conservation et l'utilisation des données et aligner tout flux de travail de séparation sur les directives de conformité internes.
Ses limites
Un séparateur de parole peut transformer un enregistrement, mais ce n'est pas de la magie, et prétendre le contraire mène à de mauvaises décisions.
Le débruitage excessif est le piège le plus courant. Une séparation agressive peut supprimer des indices vocaux subtils — consonnes douces, ambiance naturelle de la pièce — et laisser une voix qui sonne artificielle ou fatigante à l'écoute. Les artefacts résiduels sont le revers de la médaille : dans des conditions difficiles, un modèle peut laisser des traces de musique ou de bruit dans la piste de parole, ou générer du bruit musical, en particulier lorsque l'interférence est forte et change constamment.
Il y a également le biais de locuteur et de langue à prendre en compte. Les modèles entraînés majoritairement sur certaines langues, certains accents ou certains styles de parole peuvent moins bien performer sur des voix sous-représentées. Et une forme d'onde d'apparence propre peut créer un faux sentiment de sécurité : elle ne garantit pas que l'audio convient à des tâches critiques comme l'analyse médico-légale ou des contextes de conformité stricts.
Pour le travail créatif et de localisation, ces limites sont gérables, mais elles constituent un argument fort en faveur de tests avec des échantillons représentatifs de votre propre matériel plutôt que de faire confiance aux démos des fournisseurs.
Le Séparateur de parole au sein de notre flux de travail
Nous considérons le Séparateur de parole comme une implémentation pratique et adaptée aux créateurs de cette technologie, étroitement intégrée au reste de la plateforme DubSmart AI plutôt qu'ajoutée après coup.
À l'usage, il supprime le bruit de fond et isole la parole de n'importe quel enregistrement, produisant une voix propre adaptée à la post-production de films, de podcasts et d'interviews. Il extrait des voix claires de pistes mixtes et génère des fichiers distincts de haute qualité pour la parole et la musique de fond, afin que vous puissiez monter, redoubler ou remixer sans vous battre avec le mix d'origine. Il fonctionne aussi bien sur des sources audio que vidéo — vous téléchargez des fichiers ou utilisez des liens, les faites passer par le pipeline et téléchargez les pistes finales. Et surtout, ces sorties sont optimisées pour alimenter nos autres outils, de sorte qu'un seul enregistrement nettoyé peut être transformé en contenu multilingue, à voix clonée et entièrement localisé.
Pour les créateurs YouTube, les petites entreprises, les formateurs, les cinéastes, les podcasteurs et les équipes de développeurs, cette intégration change le rôle même de la séparation. Elle cesse d'être une corvée isolée de « réparation de l'audio » pour devenir la première étape standardisée d'un cycle de vie plus large et automatisé de création et de localisation de contenu. Si vous construisez une chaîne ou une bibliothèque de cours multilingue, c'est là que se cumulent les véritables gains de temps.
Foire aux questions
Qu'est-ce qu'un séparateur de parole, en termes simples ?
C'est un outil d'IA qui prend un enregistrement bruyant et mixte et produit une piste où vous n'entendez principalement que la voix humaine, plus des pistes de fond optionnelles que vous pouvez conserver ou écarter.
Un séparateur de parole est-il la même chose que la réduction de bruit ?
Non. La réduction de bruit se contente d'abaisser les sons indésirables. La séparation de parole identifie et reconstruit explicitement la parole comme une source distincte, généralement avec une plus grande clarté et un meilleur contrôle du résultat.
Un séparateur de parole peut-il gérer plus d'un locuteur ?
De nombreux systèmes de niveau recherche et certains produits peuvent séparer plusieurs locuteurs en pistes individuelles, bien que la qualité varie selon le chevauchement et les conditions d'enregistrement. Notre Séparateur de parole se concentre principalement sur l'isolation de la parole du fond pour les flux de travail courants des créateurs.
L'utilisation d'un séparateur de parole améliorera-t-elle mes résultats de doublage et de clonage vocal ?
Oui. Un audio d'entrée plus propre améliore généralement la reconnaissance vocale, l'alignement et la qualité du clonage vocal, ce qui rend le doublage multilingue et les voix clonées plus naturels et cohérents.
La séparation de parole fonctionne-t-elle quelle que soit la langue ?
La plupart des modèles de séparation opèrent sur des motifs acoustiques plutôt que sur du texte, ils peuvent donc gérer de nombreuses langues. Les performances dépendent néanmoins des données d'entraînement et de la mesure dans laquelle votre accent est représenté.