Un changeur de voix IA en temps réel transforme votre voix en une voix différente pendant que vous parlez, en captant l'audio du microphone, en l'analysant, en transformant l'identité du locuteur et en restituant l'audio converti avec un léger délai. Contrairement à un simple filtre de modification de hauteur, il peut conserver l'essentiel de vos mots, de votre rythme et de votre expression tout en modifiant des qualités comme le timbre, l'âge perçu, la présentation du genre ou le style de personnage. Et contrairement à la synthèse vocale, il part d'un discours en direct plutôt que d'un texte saisi.
La véritable décision pour les créateurs, streamers, enseignants et entreprises ne consiste pas simplement à savoir si le résultat sonne réaliste. Il s'agit de savoir si l'outil correspond à votre type d'entrée, à votre tolérance à la latence, à vos besoins de contrôle de la voix, à vos intégrations, à vos obligations en matière de droits et à votre qualité de production cible. Ce guide explique comment fonctionne la technologie, où elle se situe par rapport aux outils vocaux IA associés, et quand un flux de travail enregistré vous conviendra mieux.
Table des matières
Ce que signifie réellement le « temps réel »
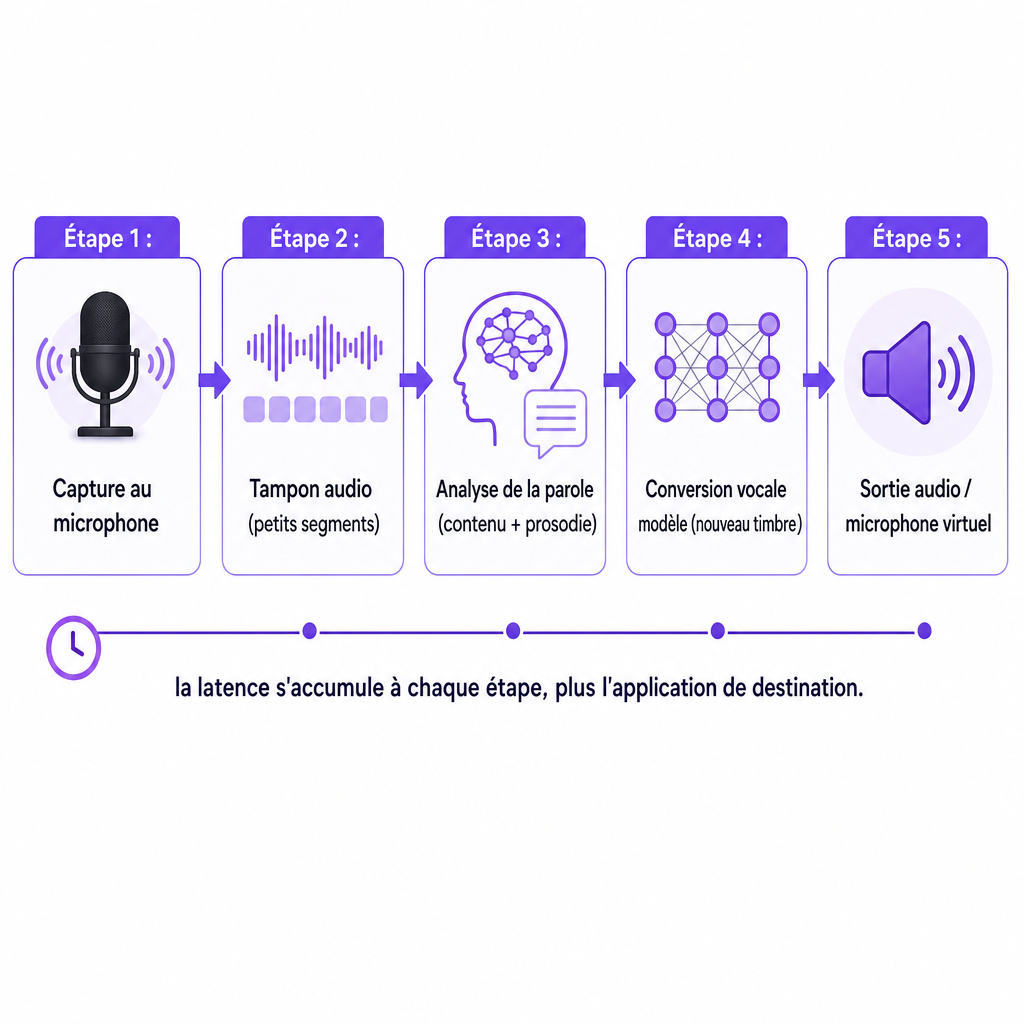
Le « temps réel » signifie que le système traite un flux audio entrant pendant que vous parlez au lieu d'attendre un enregistrement complet ou un script terminé. Le signal suit un chemin continu : microphone, tampon audio, analyse de la parole, modèle de conversion vocale, sortie audio. Comme le convertisseur travaille sur de courts segments plutôt que sur des phrases complètes, la conversion vocale en streaming est techniquement différente du rendu d'une voix off finalisée où l'ensemble du script est connu à l'avance.
Un certain délai est inévitable. Le système a besoin de temps pour capturer, analyser, synthétiser et restituer chaque fragment audio. La recherche démontre qu'une conversion à faible latence est réalisable, bien que les chiffres dépendent fortement du modèle, du matériel, de la taille du tampon et de la qualité audio. Le modèle de recherche LLVC rapporte une latence inférieure à 20 millisecondes sur un processeur grand public, tandis que StreamVC rapporte une latence de bout en bout de 70,8 millisecondes dans son environnement d'évaluation. Ce sont des résultats de recherche dans des conditions spécifiques, et non des garanties de performance pour un quelconque outil commercial que vous pourriez télécharger.
Comment fonctionne un changeur de voix IA en temps réel
Le processus se déroule en boucle pendant que vous parlez, et non comme un rendu unique. Comprendre les quatre étapes vous aide à juger pourquoi un outil semble naturel et un autre robotique ou saccadé.
Premièrement, le système capture votre discours. Il reçoit l'audio d'un microphone ou d'une autre entrée en direct et le divise en courts fragments afin que le modèle puisse le traiter en continu. La qualité de l'entrée compte plus que de nombreux utilisateurs ne le pensent. Le bruit de fond, l'écho de la pièce, le cliquetis du clavier, l'écrêtage et un signal instable poussent tous la conversion vers des artefacts non naturels.
Deuxièmement, il sépare le contenu de la parole de l'identité du locuteur. Une voix porte plusieurs couches superposées à la fois : le contenu linguistique, ou les mots ; la prosodie, c'est-à-dire le rythme, l'emphase et l'intonation ; la hauteur ; le timbre qui rend une voix reconnaissable ; et l'identité plus large du locuteur. Les systèmes de conversion tentent de préserver le contenu et l'expression tout en remplaçant les caractéristiques du locuteur. La recherche moderne sur le streaming décrit cela comme le fait de conserver le contenu et la prosodie du discours source tout en faisant correspondre le timbre vocal d'un locuteur cible. Cette séparation est la raison pour laquelle un bon convertisseur vous permet de parler spontanément avec une voix transformée au lieu d'étaler un filtre « robot » figé sur la forme d'onde.
Troisièmement, le modèle synthétise une nouvelle voix. Il reconstruit l'audio à l'aide d'un profil de voix cible, qui peut être un personnage intégré, une voix de bibliothèque, une voix personnalisée créée à partir d'enregistrements autorisés, ou un profil conçu pour l'anonymisation plutôt que pour l'imitation. La sortie est produite en continu avec un petit tampon d'anticipation. Plus de contexte peut améliorer la stabilité, mais cela ajoute aussi du délai, ce qui constitue le compromis central de la conversion en direct.
Quatrièmement, le signal converti est acheminé vers une application. Un outil de bureau expose généralement la sortie sous la forme d'un microphone virtuel, de sorte que d'autres programmes la reçoivent comme s'il s'agissait d'un microphone normal. Ce routage est ce qui rend possibles les diffusions en direct, les jeux en ligne, les appels vidéo, les discussions vocales et les événements virtuels. Un changeur en temps réel doit donc fonctionner au niveau du système d'exploitation et de l'application, et pas seulement au sein du modèle. La compatibilité avec les logiciels de streaming, Discord, Zoom, les navigateurs et les appareils mobiles peut compter autant que la qualité brute de la voix. Si vous souhaitez extraire un texte propre de ce même audio capturé pour des sous-titres ou une réutilisation, une étape distincte de reconnaissance vocale gère la transcription plutôt que la conversion.
Conversion en temps réel vs outils vocaux IA associés
Ces technologies se chevauchent dans l'esprit des gens mais résolvent des problèmes réellement différents. Le tableau ci-dessous clarifie ce que chacune prend en entrée et quand la sortie arrive.
| Technologie | Entrée | Moment de la sortie | Convient le mieux à |
|---|---|---|---|
| Changeur de voix en temps réel | Discours en direct au microphone | Pendant la conversation | Appels en direct, jeux, streaming, performance |
| Synthèse vocale | Texte écrit | Après soumission du texte | Narration, tutoriels, publicités, e-learning |
| Clonage vocal | Échantillons de voix | Généré à la demande | Voix synthétique réutilisable pour narration ou doublage |
| Doublage IA | Audio ou vidéo existants | Après traitement | Traduction et localisation de contenu enregistré |
| Effet de hauteur ou de formant | Audio en direct ou enregistré | En direct ou quasi direct | Modification vocale créative simple |
Cette distinction est pratique, et non académique. Une plateforme peut offrir une génération vocale IA ou un clonage vocal puissants sans proposer de changeur de microphone en direct pour les appels et les diffusions. Nos propres outils se concentrent sur les médias générés et localisés : nous proposons Synthèse vocale, Clonage vocal, Doublage IA, Reconnaissance vocale, Séparateur de voix, Texte en image et Image en vidéo au sein d'un même flux de travail. Ceux-ci sont conçus pour produire de l'audio à partir de texte ou pour construire une voix réutilisable pour du contenu généré ; ils appartiennent donc au côté « flux de travail enregistré » de ce tableau plutôt qu'à la conversion de microphone en direct.
À quoi sert la conversion vocale en direct
Les streamers et les joueurs ont recours à la conversion vocale pour maintenir un personnage, protéger leur vie privée ou conserver une identité de chaîne cohérente. La faible latence compte le plus ici, car vous réagissez à d'autres joueurs et parlez avec un public. Un léger délai est tolérable dans un monologue de type diffusion, mais devient flagrant lors d'échanges rapides, de jeu compétitif ou de timing comique.
Dans les réunions en ligne et les événements virtuels, une voix convertie peut soutenir le jeu de rôle, les démonstrations, les scénarios d'accessibilité ou une participation soucieuse de la confidentialité. Pour les contextes professionnels, l'intelligibilité et la fiabilité devraient primer sur la nouveauté, et les participants devraient être informés lorsqu'une voix est transformée si le silence pouvait les induire en erreur.
La performance de personnage est un autre usage en direct. Les cinéastes indépendants, les développeurs de jeux et les podcasteurs peuvent auditionner des voix de personnages ou interpréter des dialogues temporaires à la volée. Pour la livraison finale, cependant, une voix off IA enregistrée ou une performance humaine offre généralement un meilleur contrôle de montage et une cohérence d'une session à l'autre.
La confidentialité de la voix et l'anonymisation sont un objectif distinct de l'imitation. L'anonymisation tente de masquer l'identité de celui qui parle, tandis que l'imitation tente de reproduire une identité cible spécifique. Aucune des deux n'est infaillible, et une voix transformée peut encore laisser transparaître des habitudes de parole, des tournures de phrases ou des bruits de fond qui aident à identifier le locuteur.
Enfin, la technologie de voix synthétique soutient l'accessibilité et la communication assistée pour les personnes ayant perdu la capacité de parler. La Federal Trade Commission reconnaît ce bénéfice médical et d'accessibilité tout en avertissant que la réplication vocale peut être détournée à des fins de fraude et d'utilisation abusive de données biométriques.
Les critères de décision qui comptent vraiment
La latence vient en premier, et vous devriez demander une latence de bout en bout mesurée, et non la seule vitesse d'inférence du modèle. Le délai que vous ressentez réellement comprend la capture par le microphone, la mise en tampon, l'extraction de caractéristiques, l'inférence du modèle, la synthèse, le routage de sortie, et tout ce que l'application d'appel ou de streaming ajoute par-dessus. Un modèle qui obtient de bons résultats de référence isolément peut sembler lent une fois le parcours complet assemblé.
Le naturel est le test suivant. Écoutez les artefacts métalliques, les sauts tonals soudains, les problèmes de respiration et de prononciation, les pauses non naturelles, les consonnes déformées, les accrocs aux limites des phrases et la perte d'expression émotionnelle. Une voix convaincante doit rester compréhensible pendant un discours spontané, et pas seulement pendant des lignes de démonstration soigneusement lues.
La préservation du contenu de la parole est facile à négliger jusqu'à ce qu'elle échoue. Testez le débit rapide, les interruptions, les chiffres, les noms, les accents, les rires, les questions et les changements de volume. Un outil qui change l'identité mais aplatit votre rythme et votre intonation est mal adapté à la performance ou à l'interaction en direct.
La sélection et la personnalisation de la voix déterminent jusqu'où vous pouvez façonner le résultat. Vérifiez la présence de voix intégrées, la création de voix personnalisées, les contrôles de hauteur et de ton, les options d'émotion ou de style, les choix d'accent, la cohérence entre les sessions et les éventuelles restrictions d'usage commercial. La création de voix personnalisées devrait toujours exiger une autorisation claire : un échantillon de voix n'est pas une permission d'imiter la personne dont il provient.
Le support matériel et de plateforme décide si l'outil s'adapte tout simplement à votre configuration. Confirmez s'il fonctionne localement sur CPU ou GPU, dans un navigateur, via une application de bureau, sur mobile, via un microphone virtuel ou via une API. Le traitement dans le cloud peut simplifier la configuration mais introduit une latence réseau et des questions de gouvernance des données, tandis que le traitement local peut réduire le délai réseau mais exiger un matériel plus performant. Par ailleurs, vérifiez le routage audio : un modèle puissant est inutile si sa sortie ne peut pas être sélectionnée comme microphone dans l'application visée.
La gestion des données clôt la liste. Avant de télécharger un quelconque échantillon de voix, examinez si les enregistrements sont conservés, s'ils alimentent l'amélioration du modèle, comment les voix personnalisées sont supprimées, qui peut accéder aux fichiers, si des contrôles professionnels ou d'entreprise existent, et ce qu'il advient de l'audio généré par la suite. Les enregistrements vocaux peuvent constituer des données personnelles sensibles ou liées à la biométrie selon le contexte et la loi applicable, alors traitez-les en conséquence.
Quand un flux de travail enregistré surpasse le temps réel
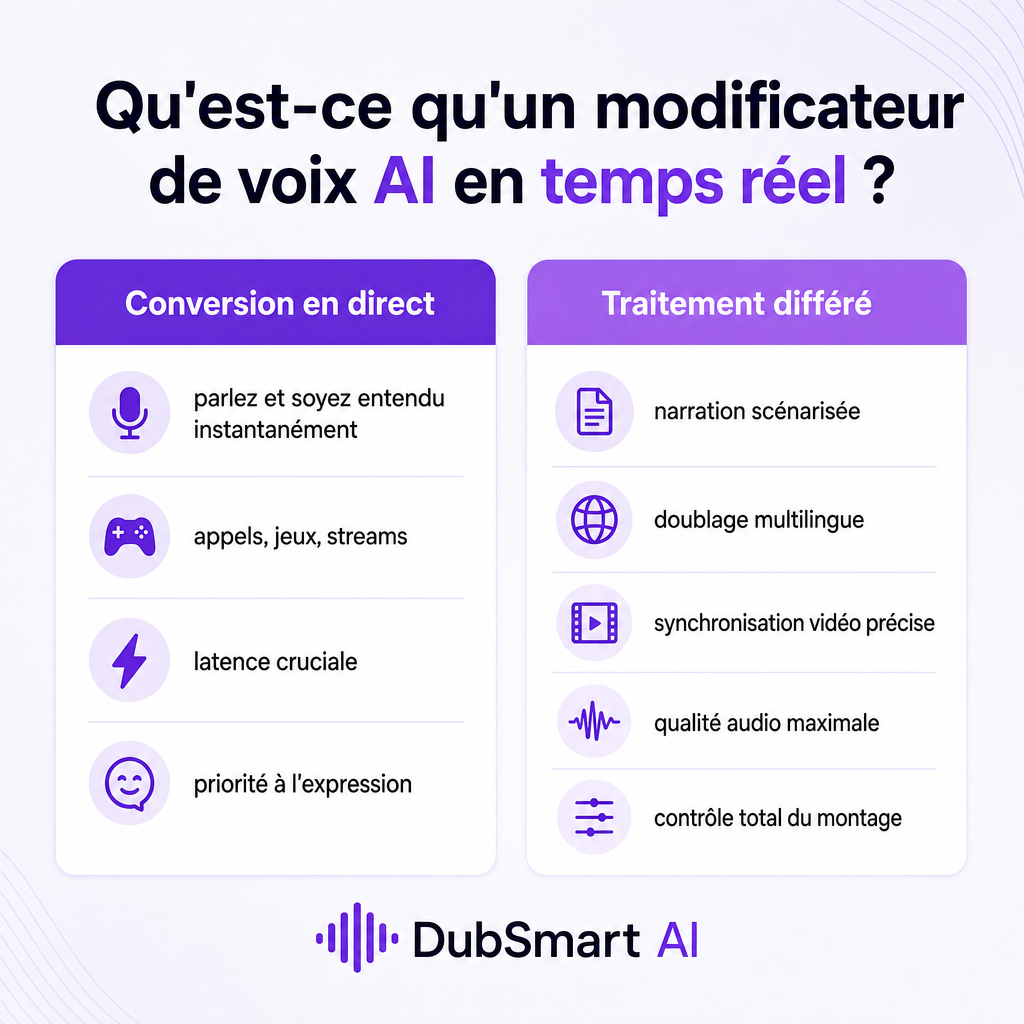
La conversion en direct est le bon choix lorsqu'une personne doit parler naturellement et faire entendre immédiatement la voix transformée. C'est le mauvais choix lorsque votre priorité est une qualité audio maximale, une prononciation précise, une narration multilingue, un timing exact par rapport à la vidéo, un montage détaillé, une voix off commerciale cohérente ou un doublage de haute qualité.
Pour ces objectifs, un pipeline enregistré l'emporte. Avec la synthèse vocale, vous contrôlez et peaufinez le script avant qu'un quelconque audio ne soit généré, ce qui élimine entièrement le problème de latence en direct. Avec le doublage IA, le système traite une vidéo existante et aligne la parole traduite sur la source, ce qu'aucun changeur en direct ne peut faire. Si votre fichier source mélange des dialogues avec de la musique ou du bruit, un séparateur de voix peut isoler une piste vocale propre avant de la traiter. Notre Doublage IA est conçu pour traduire de l'audio ou de la vidéo enregistrés dans les langues cibles prises en charge, et non pour convertir un flux de microphone en direct.
Risques et usage responsable
L'usurpation d'identité et la fraude constituent le risque principal. Une voix convertie réaliste peut rendre une fausse identité plus crédible, et la FTC avertit que les systèmes de clonage vocal sont utilisés dans des arnaques familiales, l'usurpation d'identité d'entreprise, l'extorsion et d'autres fraudes, ainsi que pour des risques envers les artistes vocaux dont la voix peut être détournée. N'utilisez pas la voix reconnaissable d'une personne réelle sans autorisation, et ne présentez jamais une voix générée ou convertie par IA comme preuve qu'une personne précise a parlé.
Le consentement et les droits vocaux en découlent directement. Obtenez une permission avant de cloner ou d'imiter délibérément la voix d'une autre personne, et conservez une trace de cette permission, en particulier pour les projets commerciaux, la publicité, la formation, les jeux ou les médias publics. Le document de la FTC cité ici traite des préjudices, de l'application de la loi et des solutions proposées plutôt que d'établir une règle de consentement unique pour chaque usage, de sorte que les obligations spécifiques peuvent dépendre de la juridiction, du contrat, de la plateforme et du cas d'usage. En cas de doute, vérifiez pour votre situation.
La divulgation est judicieuse chaque fois qu'un public pourrait raisonnablement croire qu'une personne réelle parle en direct. Un bref avis indiquant que la voix est générée ou convertie par IA réduit la confusion. La sécurité compte aussi : protégez les échantillons de voix et les fichiers de voix personnalisées comme d'autres actifs sensibles, limitez l'accès, évitez de télécharger des enregistrements sans permission, et supprimez les profils de voix inutilisés lorsque le service le permet. Enfin, prévoyez les défaillances de qualité. La latence, les coupures audio et les artefacts de conversion peuvent faire dérailler une conversation ; testez donc l'installation complète avec le microphone, le casque, l'application, le réseau et le matériel réels avant de passer en public.
Où nos outils s'intègrent dans votre projet vocal
Nous présentons un flux de travail média IA intégré plutôt qu'un produit de changeur de voix par microphone en direct. Sur notre plateforme, vous pouvez générer de la parole à partir de texte, choisir parmi plus de 300 voix, créer des voix clonées à partir d'un court échantillon et utiliser ces voix dans les projets de Synthèse vocale et de Doublage IA. Nous prenons en charge le doublage à partir de plus de 60 langues sources vers 33 langues cibles, ce qui fait de nous un excellent choix lorsqu'il s'agit de créer une voix off à partir d'un script, de produire de la parole avec une voix personnalisée, de doubler de l'audio ou de la vidéo enregistrés, ou de localiser du contenu pour des audiences multilingues.
Pour les développeurs, nous publions des pages API distinctes pour Synthèse vocale, Clonage vocal et Doublage IA. Il s'agit de flux de travail de génération et de localisation. Si votre projet nécessite spécifiquement un changeur de voix par microphone en direct, confirmez que l'entrée en streaming en temps réel, le routage de sortie, les objectifs de latence et le support des sessions en direct sont explicitement documentés avant de vous engager dans une quelconque API, la nôtre ou celle d'un autre.
Si vous hésitez entre la conversion en direct et un pipeline enregistré et que vous ne savez pas quelle voie convient à votre contenu, indiquez-nous votre format source, vos langues cibles et si vous avez besoin d'une sortie en direct ou préenregistrée, et nous vous orienterons vers le bon flux de travail.
Foire aux questions
Un changeur de voix IA en temps réel est-il identique à la synthèse vocale ?
Non. Un changeur de voix en temps réel transforme le discours en direct au microphone pendant que vous parlez, tandis que la synthèse vocale génère un nouveau discours à partir d'un texte écrit que vous soumettez d'abord. Notre Synthèse vocale est conçue pour générer de la parole à partir de texte, et non pour la conversion de microphone en direct.
Un changeur de voix IA en temps réel a-t-il un délai nul ?
Non. Chaque système a besoin de temps pour capturer et traiter l'audio, donc une certaine latence est inévitable. Le délai pratique dépend du modèle, de l'appareil, des réglages de tampon, du réseau et de l'application de destination, et les systèmes de recherche rapportent des chiffres différents dans des conditions de test différentes.
Un changeur de voix IA peut-il copier la voix d'une célébrité ?
Certains systèmes peuvent techniquement imiter des voix reconnaissables, mais la capacité technique n'est pas une permission. Évitez l'usurpation d'identité non autorisée et vérifiez les contrats, règles de plateforme et lois pertinents avant d'utiliser la voix reconnaissable de toute personne.
Que devrais-je utiliser pour créer des vidéos YouTube multilingues ?
Pour les vidéos préenregistrées, le doublage IA convient généralement mieux qu'un changeur de voix en direct, car il traite la vidéo existante et produit un audio localisé et aligné. Notre Doublage IA traduit et double de l'audio ou de la vidéo enregistrés dans les langues prises en charge.
Votre plateforme peut-elle modifier ma voix en direct pendant un appel ?
Notre plateforme documente la Synthèse vocale, le Clonage vocal et le Doublage IA plutôt que la conversion de voix par microphone en direct. Si vous planifiez un flux de travail d'appel en direct, confirmez d'abord la documentation produit actuelle avec nous afin que nous puissions recommander la bonne approche.