Ce narrateur au ton plat et légèrement robotique qui lit les légendes par-dessus un clip est devenu l'un des sons les plus reconnaissables de la vidéo au format court. Dès que les gens l'entendent, ils savent exactement quel type de contenu ils regardent. Si vous cherchez un moyen fiable d'intégrer cet effet de synthèse vocale de la voix tiktok dans les vidéos que vous publiez partout ailleurs, la bonne nouvelle, c'est que vous n'avez pas à rester enfermé dans l'éditeur d'une seule application pour l'obtenir. Avec notre outil de synthèse vocale, vous écrivez le script, choisissez une voix qui correspond au ton souhaité, générez l'audio et le synchronisez avec vos images pour TikTok, YouTube Shorts, Reels ou tout autre endroit où vous publiez.
La raison pour laquelle cela compte va au-delà de la simple copie d'une tendance. Une voix de narrateur distinctive fait partie de l'identité de votre chaîne. Une fois qu'elle est reconnaissable, les spectateurs l'associent à vous sur toutes les plateformes. Le problème lorsqu'on se fie uniquement au narrateur intégré d'une application, c'est qu'on est limité à cette application, à sa courte liste de voix et à ses règles. Nous avons conçu notre flux de travail pour que la même voix que vous aimez puisse suivre votre contenu partout et, lorsque vous êtes prêt, dans d'autres langues également.
Table des matières
- Pourquoi la voix du narrateur TikTok est devenue un outil de narration
- Recréer l'effet avec notre outil de synthèse vocale
- Aller au-delà des voix prédéfinies avec le clonage vocal
- Transporter une même voix à travers les langues et les formats
- Automatiser la narration de style TikTok avec nos API
- Choisir votre voie : voix prédéfinie, voix clonée ou API
- Questions fréquemment posées
Pourquoi la voix du narrateur TikTok est devenue un outil de narration
Le narrateur intégré a commencé comme une fonctionnalité pratique. Vous ajoutez du texte à un clip, appuyez pour le convertir en parole, choisissez parmi une poignée de voix, et l'application lit vos légendes à voix haute. Des tutoriels partout sur le web guident les débutants exactement de cette manière : ajouter du texte, appuyer longuement dessus ou toucher l'icône de la voix, puis choisir un narrateur. Comme le processus est si simple, les créateurs l'ont adopté pour des sketchs comiques, des explications étape par étape, des publications de type storytime et des présentations de produits.
Ce qui a transformé un utilitaire en tendance, c'est la répétition. Lorsque des millions de clips utilisent la même narration neutre et régulière, ce son devient un raccourci pour un certain style de contenu. Les spectateurs cessent de l'entendre comme une machine et commencent à l'entendre comme la voix de la narration au format court. C'est cette familiarité qui explique pourquoi tant de créateurs veulent désormais le même effet sur toutes les plateformes où ils publient, et veulent plus de contrôle que ne le permet une liste de voix fixe.
La limitation pratique est facile à atteindre. Le narrateur intégré d'une application vous offre un court menu de voix et garde tout à l'intérieur de cette seule application. Si vous réutilisez une vidéo pour une autre plateforme, soit vous perdez la narration, soit vous la réenregistrez. Si vous voulez une voix qui ne figure pas dans la liste, vous êtes coincé. Et si vous prévoyez de publier la même idée dans une autre langue, l'outil intégré ne transposera pas votre narrateur pour vous. Ces lacunes sont exactement là où un flux de travail dédié à la synthèse vocale trouve sa place, en vous permettant de générer la narration une seule fois et de la réutiliser partout où vous publiez.
Recréer l'effet avec notre outil de synthèse vocale
Notre outil de synthèse vocale est l'élément qui recrée directement l'effet du narrateur à l'écran. Au lieu de taper des légendes dans une application en espérant que son narrateur convienne, vous collez votre script, choisissez parmi une bibliothèque de plus de 300 voix au son naturel et générez un audio propre que vous pouvez intégrer dans n'importe quelle vidéo. Le résultat est un fichier téléchargeable, il appartient donc à votre projet plutôt qu'à l'éditeur d'une seule plateforme.
L'application web suit quatre étapes simples. Premièrement, choisissez la synthèse vocale. Deuxièmement, créez la parole en saisissant votre texte et en sélectionnant un locuteur. Troisièmement, modifiez le projet, où vous pouvez ajouter d'autres locuteurs ou ajuster le texte. Quatrièmement, téléchargez le projet terminé dans le format dont vous avez besoin. Il n'y a rien de technique là-dedans, et c'est bien le but : vous devriez consacrer votre énergie au script et au montage, et non à vous battre avec un logiciel.
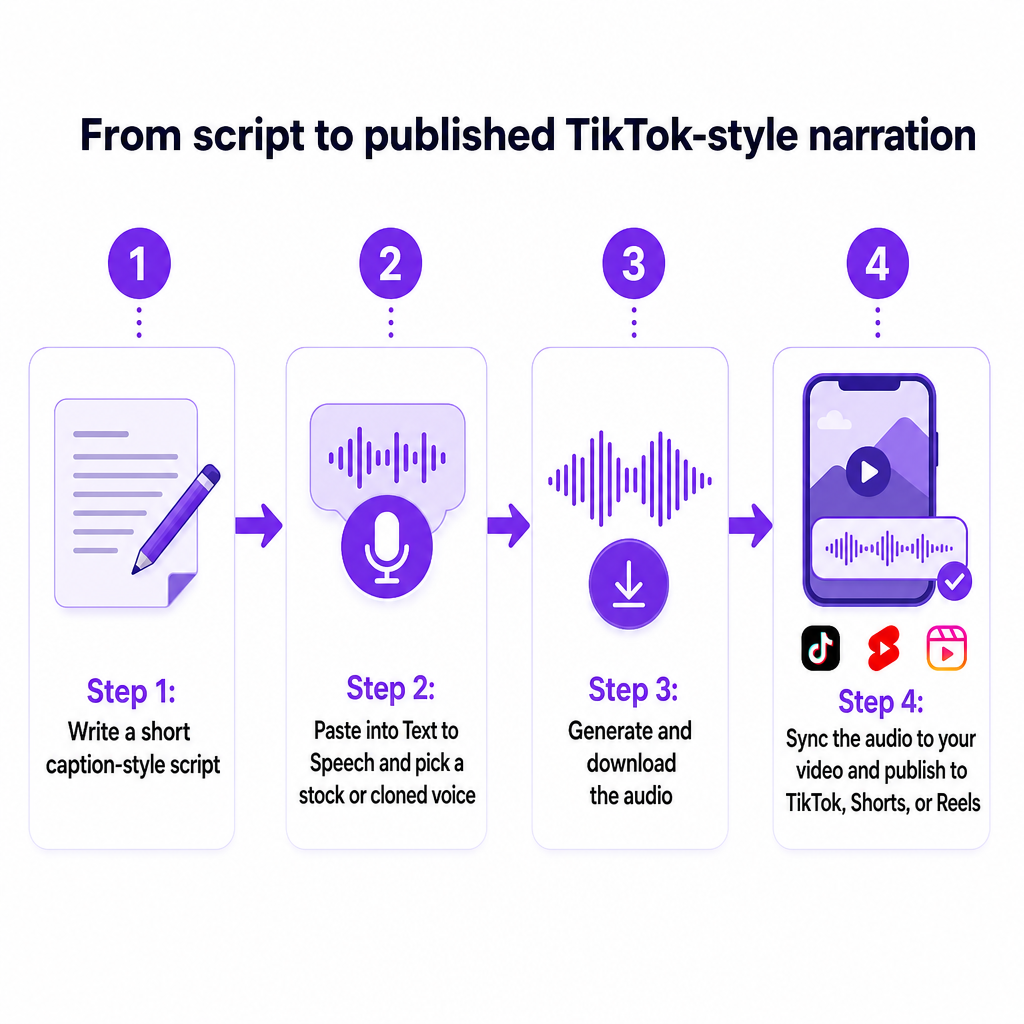
Appliqué à la vidéo au format court, le processus devient encore plus concret. Commencez par écrire un court script de style légende, exactement les mots que vous voulez lire par-dessus votre clip. Gardez-le percutant ; l'effet de narrateur fonctionne mieux avec des phrases serrées et rythmées. Collez ce script dans la synthèse vocale et choisissez une voix dont le ton correspond à l'ambiance que vous recherchez, qu'elle soit pince-sans-rire, enjouée ou factuelle. Générez l'audio, puis importez-le dans l'éditeur de votre choix et alignez-le avec les visuels avant de publier sur TikTok, Shorts ou Reels.
Parce que vous générez la narration en dehors de toute application unique, le même fichier audio fonctionne sur chaque plateforme de votre rotation de publication. Enregistrez une fois, réutilisez partout. Cela résout à lui seul la plus grande frustration liée au narrateur intégré d'une application : vous ne reconstruisez plus la même voix off trois fois pour trois destinations.
Écrire des scripts adaptés au style du narrateur
La voix fait une grande partie du travail, mais le script en donne le rythme. Les phrases déclaratives courtes se lisent proprement et sonnent avec la cadence nette que les spectateurs associent à la tendance. Les chiffres, les listes et les transitions claires comme « d'abord », « ensuite » et « enfin » se traduisent bien en parole synthétisée car ils offrent à la voix des points de pause naturels. Si une phrase sonne bizarrement lorsque vous la lisez à voix haute, elle sonnera bizarrement lorsque la voix la lira aussi, donc une rapide lecture à voix haute avant de générer vous évite beaucoup de régénérations par la suite.
Aller au-delà des voix prédéfinies avec le clonage vocal
Choisir dans une bibliothèque est la voie rapide, et pour de nombreux créateurs, une voix prédéfinie bien choisie est tout ce dont ils ont besoin. Mais sonner comme tout le monde a ses limites. Si votre objectif est un narrateur indéniablement vôtre, notre clonage vocal transforme votre propre voix, ou une voix de marque avec consentement, en un modèle réutilisable que vous pouvez piloter à partir de texte.
La distinction est importante. La synthèse vocale générique consiste à sélectionner parmi des narrateurs prédéfinis. Le clonage vocal construit un modèle synthétique d'un locuteur spécifique, de sorte qu'une nouvelle parole dans cette voix peut être générée à partir de n'importe quel texte que vous tapez. Dans l'application web, vous téléchargez un fichier audio d'au moins 20 secondes de parole propre, avec un minimum de bruit de fond, dans la section de clonage vocal. À partir de ce court échantillon calme, nous créons une voix personnalisée que vous pouvez utiliser comme n'importe quelle autre dans vos projets de synthèse vocale.
Vingt secondes d'audio propre représentent un effort de production minime. Une pièce calme, un téléphone ou un micro basique, et une courte lecture suffisent à générer un narrateur signature que vous pouvez réutiliser indéfiniment. Une fois qu'elle existe, vous ne choisissez plus entre des voix prédéfinies anonymes ; vous avez une voix qui porte votre identité dans chaque clip, et elle reste cohérente que vous publiiez aujourd'hui ou dans six mois.
C'est là qu'un narrateur reconnaissable devient un atout de marque plutôt qu'un effet ponctuel. Une voix clonée lit des scripts que vous n'avez jamais réellement enregistrés, conserve son caractère tout au long d'un calendrier de contenu complet, et ne nécessite jamais de session de réenregistrement parce que vous avez changé votre configuration. Pour les créateurs qui bâtissent une identité de chaîne à long terme, cette cohérence est la véritable amélioration par rapport à un menu tournant de voix d'application.
Transporter une même voix à travers les langues et les formats
Une voix de narrateur qui ne fonctionne que dans une seule langue limite votre portée dès que vous voulez vous développer à l'international. Notre plateforme prend en charge le doublage multilingue dans 33 langues cibles et peut générer de la parole à partir de texte dans la langue de votre choix, de sorte que la même tendance qui fonctionne en anglais peut être reproduite pour des audiences ailleurs.
Voici comment les éléments s'articulent. La synthèse vocale vous fournit la narration. Le clonage vocal permet à cette narration de rester dans une seule voix reconnaissable. Notre doublage IA étend le même contenu à d'autres langues en traitant la vidéo et l'audio à travers la synthèse vocale, la reconnaissance vocale et le clonage vocal au sein d'un seul flux de travail. Au lieu d'engager des narrateurs distincts pour chaque marché, vous conservez une seule identité vocale et laissez la plateforme la transporter à travers les versions.
Le flux de travail s'adapte également au-delà des clips courts. Pour du contenu plus long, vous pouvez télécharger des vidéos ou des fichiers audio complets, ajuster les paramètres des locuteurs, choisir les langues et sélectionner les voix préférées au sein d'un projet avant l'exportation. Ainsi, la même approche que vous utilisez pour ajouter un narrateur de style viral à un clip de quinze secondes s'applique aussi à une vidéo explicative, une leçon ou un épisode complet. Le format court est là où vit la tendance, mais les outils sous-jacents ne s'arrêtent pas au format court.
Pour les créateurs qui planifient une croissance mondiale, cela change l'économie de la localisation. Un seul script devient un short en anglais, une version en espagnol et des versions dans d'autres langues, toutes narrées dans une voix cohérente, sans reconstruire votre audio à partir de zéro à chaque fois. L'effet du narrateur reconnaissable devient quelque chose que vous pouvez exploiter comme un système reproductible plutôt qu'un coup de chance ponctuel.
Automatiser la narration de style TikTok avec nos API
Les créateurs individuels peuvent tout faire ci-dessus dans le navigateur. Les agences, les grandes chaînes et les équipes disposant de catalogues arrière ont généralement besoin du même résultat à grande échelle, et c'est là qu'interviennent nos API. L'API de synthèse vocale est un service RESTful qui convertit le texte en parole au son naturel : vous envoyez une requête POST avec votre texte et vos préférences de voix et recevez en retour un fichier audio prêt à l'emploi. Elle prend en charge les mêmes 300+ voix et le clonage vocal disponibles dans l'application.
Pour rendre un narrateur personnalisé programmable, notre API de clonage vocal suit un schéma compact en trois étapes. Premièrement, téléchargez un fichier audio et recevez une clé de fichier. Deuxièmement, créez une voix personnalisée en fournissant un nom et cette clé de fichier. Troisièmement, utilisez la voix clonée résultante dans les projets de synthèse vocale via les points de terminaison de projet TTS de la plateforme. Une fois qu'une voix existe, elle devient un atout réutilisable que vos applications peuvent appeler, et non une exportation à usage unique.
Assemblé, cela permet à une équipe d'industrialiser l'effet. Imaginez une agence gérant plusieurs chaînes clientes : elle peut maintenir une voix de marque clonée par client, alimenter les scripts via l'API et générer de l'audio narré pour des dizaines de vidéos sans qu'une personne colle manuellement du texte dans un outil à chaque fois. Le même schéma prend en charge les systèmes d'apprentissage et les pipelines de localisation, où les voix clonées sont appelées à la demande à mesure que le contenu est produit.
Pour les équipes qui génèrent également des visuels ou qui souhaitent créer des vidéos courtes autour d'éléments fixes, notre outil de conversion image-en-vidéo fait partie du même écosystème, de sorte que la production audio et visuelle vit au même endroit plutôt que dispersée entre des applications déconnectées. L'objectif est un flux de travail unique : une seule plateforme pour écrire, sonoriser, localiser et assembler.
Une note sur les attentes : nous décrivons ces API en termes fonctionnels car c'est ce dont dépend le flux de travail. Si vous souhaitez des détails sur les limites de débit, le débit ou les configurations spécifiques à un forfait, indiquez-nous votre volume attendu et votre cas d'utilisation afin que nous puissions préparer une recommandation adaptée à votre charge de travail.
Choisir votre voie : voix prédéfinie, voix clonée ou API
La plupart des lecteurs arrivent avec l'un des trois besoins, et le bon point de départ dépend de celui qui vous décrit. Le tableau ci-dessous associe chaque situation à la première action utile la plus rapide.
| Votre situation | Meilleur point de départ | Pourquoi c'est adapté |
|---|---|---|
| Tester l'effet rapidement | Voix prédéfinie dans la synthèse vocale | Choisissez parmi 300+ voix, générez l'audio en quelques minutes, aucun enregistrement nécessaire |
| Construire une voix de chaîne signature | Clonage vocal | Transformez un échantillon propre de 20 secondes en un narrateur personnalisé réutilisable |
| Produire à grande échelle ou pour plusieurs clients | API de synthèse vocale et de clonage vocal | Automatisez la narration sur de nombreuses vidéos et versions multilingues |
Si vous n'êtes pas sûr, commencez simplement. Rédigez un court script de style légende pour votre prochaine publication, ouvrez la synthèse vocale dans le navigateur et générez-le avec une voix prédéfinie qui correspond à votre ton. Si vous aimez l'effet mais que vous voulez qu'il sonne comme vous, téléchargez un échantillon propre de 20 secondes et clonez votre voix, puis comparez les deux sur le même clip. Cette simple comparaison règle généralement la question de savoir si vous voulez un narrateur prédéfini de style viral ou une voix de marque unique à l'avenir.
Les équipes et développeurs gérant plusieurs chaînes ou un grand catalogue arrière tireront plus de valeur de l'accès à l'API, car le flux manuel du navigateur ne s'adapte pas à des centaines d'éléments. Quel que soit ce qui convient à votre volume, la capacité sous-jacente est la même : un narrateur reconnaissable, selon vos conditions, sur chaque plateforme où vous publiez. Si vous souhaitez de l'aide pour associer votre plan de chaîne, la taille de votre catalogue et vos langues cibles à la bonne approche, partagez ces détails avec nous et nous vous suggérerons une configuration adaptée.
Une précaution pratique à garder à l'esprit : lorsque vous clonez une voix, utilisez la vôtre ou une pour laquelle vous avez une autorisation claire, et respectez les règles de publication de la plateforme sur laquelle vous publiez. Cela permet à votre stratégie de narrateur reconnaissable de rester durable plutôt que risquée.
Questions fréquemment posées
DubSmart AI dispose-t-il d'un préréglage intitulé « voix TikTok » ?
Nous nous concentrons sur la recréation de l'effet plutôt que sur l'imitation d'un préréglage propriétaire spécifique. Vous obtenez cette impression familière de narrateur à l'écran en générant de l'audio dans la synthèse vocale à partir d'une bibliothèque de plus de 300 voix, puis en choisissant celle dont le ton correspond au style souhaité. Vous pouvez également cloner une voix personnalisée pour un narrateur qui vous est propre. Si vous avez un ton particulier ou une voix de marque en tête, dites-le-nous et nous vous suggérerons une approche adaptée.
Comment ajouter l'effet de narrateur à des vidéos en dehors de TikTok ?
Écrivez un court script de style légende, collez-le dans notre outil de synthèse vocale, sélectionnez un locuteur et générez l'audio. Téléchargez le fichier et alignez-le avec vos images dans n'importe quel éditeur, puis publiez sur Shorts, Reels ou ailleurs. Parce que l'audio est un fichier autonome, une seule narration fonctionne sur chaque plateforme où vous publiez.
De quoi ai-je besoin pour cloner ma propre voix ?
Téléchargez un fichier audio d'au moins 20 secondes de parole propre avec un minimum de bruit de fond dans la section de clonage vocal. À partir de ce court échantillon calme, nous créons un modèle de voix personnalisé que vous pouvez ensuite utiliser dans vos projets de synthèse vocale comme n'importe quelle autre voix.
Puis-je utiliser la même voix dans différentes langues ?
Oui. Notre plateforme prend en charge le doublage multilingue dans 33 langues cibles, et en combinant la synthèse vocale, le clonage vocal et le doublage IA, vous pouvez conserver une seule voix reconnaissable à travers les versions du même contenu, de sorte qu'un short en anglais et ses versions dans d'autres langues partagent un narrateur cohérent.
Existe-t-il un moyen d'automatiser cela pour de nombreuses vidéos à la fois ?
Les développeurs et les agences peuvent utiliser notre API de synthèse vocale pour convertir le texte en audio de manière programmatique, et l'API de clonage vocal pour télécharger un échantillon, créer une voix personnalisée nommée et l'appeler dans les projets TTS. Cela vous permet de générer de la narration sur de grands catalogues et plusieurs chaînes sans travail manuel par vidéo.
Dois-je choisir une voix prédéfinie ou cloner la mienne ?
Une voix prédéfinie est le moyen le plus rapide de tester l'effet et fonctionne bien pour de nombreux créateurs. Le clonage est le meilleur choix lorsque vous voulez un narrateur indéniablement lié à votre marque et cohérent dans le temps. Essayer les deux sur le même clip est le moyen le plus rapide de décider lequel vous préférez.