Le moyen le plus rapide d'intégrer une API de synthèse vocale est de la traiter comme un service REST : authentifiez-vous avec une clé API, envoyez votre texte accompagné des paramètres vocaux au format JSON, laissez le service générer la parole en arrière-plan, puis récupérez et stockez les fichiers audio résultants pour les diffuser là où vos utilisateurs en ont besoin. Notre API de synthèse vocale suit exactement ce modèle tout en proposant plus de 300 voix naturelles et le clonage vocal illimité, afin que vous puissiez intégrer une parole réaliste dans des sites web, des applications, des pipelines vidéo et des plateformes d'apprentissage. Ce guide détaille ce que vous connectez réellement, comment fonctionne notre moteur, et les décisions qui déterminent si l'intégration convient à votre produit.
Table des matières
Ce que fait une API de synthèse vocale dans DubSmart
Une API de synthèse vocale transforme du texte structuré en audio parlé à la demande, afin que votre code puisse demander une narration ou un dialogue dès qu'un script est prêt, au lieu d'attendre un enregistrement manuel. Notre moteur de synthèse vocale alimente à la fois l'outil Synthèse vocale basé sur navigateur et l'API, donnant accès à plus de 300 voix IA dans différentes langues, genres et styles, avec une prosodie ajustée pour la narration, les explications et les dialogues.
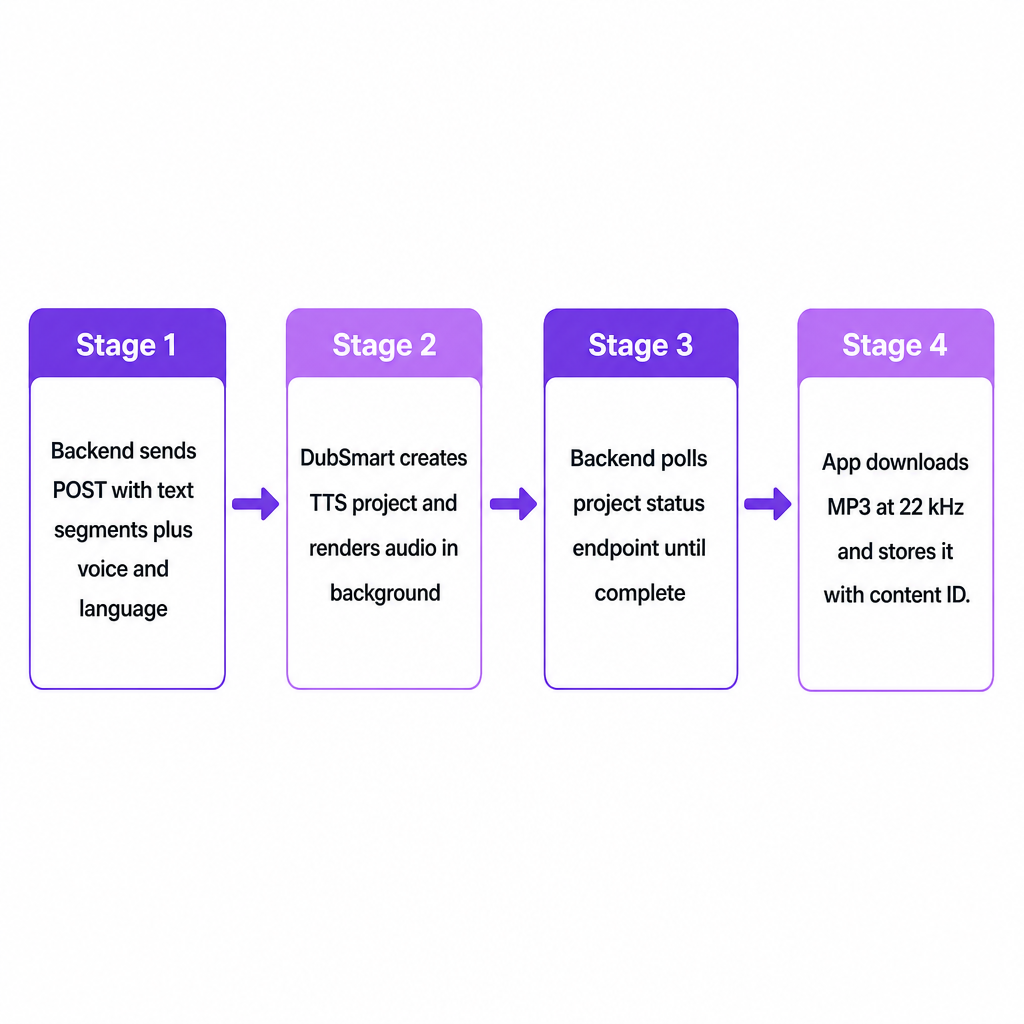
Au niveau de l'API, nous exposons ce moteur comme un service RESTful : votre backend envoie une requête POST contenant des segments de texte et des paramètres vocaux, et le service renvoie un objet projet dont vous pouvez interroger le statut jusqu'à ce que l'audio soit prêt à être téléchargé. La sortie est livrée sous forme de fichiers audio de haute qualité, généralement en MP3 à 22 kHz, adaptés à une utilisation directe dans les éditeurs vidéo, les workflows de podcast ou les lecteurs web sans conversion supplémentaire.
Pour les créateurs et les équipes que nous servons—YouTubeurs, petites entreprises, producteurs d'e-learning, cinéastes et agences de développement—l'API relie la planification du contenu à la publication. Dès qu'un script arrive dans un CMS ou une plateforme d'apprentissage, le backend peut générer automatiquement des voix off, ce qui élimine le goulot d'étranglement des enregistrements manuels répétés.
La décision d'intégration : que connectez-vous réellement ?
« Intégrer une API de synthèse vocale » semble générique, mais en pratique vous décidez de trois choses : à quel endroit de votre workflow la parole doit être générée, quelles voix et langues représenteront votre marque, et à quel point vous automatisez la génération et la récupération de l'audio.
Pour un créateur YouTube qui se développe dans le contenu multilingue, l'intégration signifie souvent lier notre API à un outil de planification vidéo ou à une base de données de scripts afin que chaque script finalisé devienne une voix off dans la bonne langue et le bon style. Pour les petites entreprises et les équipes marketing, l'API se situe généralement derrière un CMS ou une plateforme d'automatisation marketing, transformant les articles de blog, les explications de produits et les textes des réseaux sociaux en actifs audio réutilisables. Les fournisseurs d'e-learning et de formation en entreprise ont tendance à intégrer l'API dans des outils de création afin que les modules de leçon puissent demander une narration par diapositive ou par sujet et la régénérer instantanément lorsque le contenu est mis à jour.
Les développeurs et les agences qui intègrent l'IA vocale plus profondément choisissent généralement entre deux modèles. Un modèle par lots collecte les scripts et les traite via des tâches planifiées. Un modèle transactionnel déclenche une requête immédiate chaque fois qu'un nouveau contenu ou une action utilisateur arrive. Notre API basée sur les projets fonctionne parfaitement pour l'un ou l'autre, car chaque projet TTS encapsule le texte, le choix de voix, la langue et l'audio résultant d'une manière qui correspond à vos propres unités de contenu—vidéos, leçons ou épisodes de podcast. Si vous réfléchissez encore au concept lui-même, notre article complémentaire sur ce qu'est une API de synthèse vocale et comment elle fonctionne couvre les fondamentaux avant que vous ne vous engagiez dans une conception.
Comment fonctionne notre API de synthèse vocale en coulisses
Notre API de synthèse vocale est construite autour de projets et de segments, ce qui la rend plus flexible qu'un simple point de terminaison « texte en entrée, audio en sortie ». Un projet TTS regroupe un ou plusieurs segments de texte sous un titre et une configuration partagée telle que la langue et la voix par défaut. Chaque segment porte son propre texte, son identifiant de voix et son étiquette de langue, ce qui vous permet de mélanger les styles de narration ou les langues au sein d'une seule sortie.
Une charge utile JSON typique vers le point de terminaison du projet TTS comprend un titre de projet lisible par un humain pour vos tableaux de bord et journaux, ainsi qu'un tableau de segments. Chaque segment définit text (le script ou la phrase à prononcer), voice (soit un ID de voix intégrée, soit un ID de voix personnalisée créée via l'API de clonage vocal), et language (un code indiquant la langue du segment).
Lorsque votre backend envoie cette charge utile au point de terminaison TTS avec une clé API valide dans l'en-tête Authorization, nous créons le projet et commençons à générer l'audio en arrière-plan. L'API expose un point de terminaison de statut de projet qui indique si le traitement est encore en cours ou terminé, ainsi que des références aux fichiers audio générés une fois prêts. Cette conception asynchrone garde vos propres requêtes rapides : enregistrez l'ID du projet, rendez le contrôle à l'utilisateur, et laissez un worker en arrière-plan vérifier l'achèvement et récupérer l'audio lorsqu'il est disponible.
La parole générée arrive sous forme de fichiers téléchargeables dans des formats standard, notamment MP3 à 22 kHz, qui s'intègre facilement dans les lecteurs web, les applications mobiles et les timelines de montage vidéo. Comme le même moteur alimente notre outil basé sur navigateur, les développeurs peuvent prototyper des voix et des scripts de manière interactive, puis migrer les combinaisons gagnantes vers des appels API automatisés. La référence complète des points de terminaison se trouve sur la page API de synthèse vocale.
Connecter le clonage vocal et le doublage IA à la synthèse vocale
Notre caractéristique distinctive est que la Synthèse vocale, le Clonage vocal et le Doublage IA partagent un seul moteur vocal et workflow sous-jacent. Cela signifie que l'API TTS n'est pas isolée—elle est le cœur d'un pipeline de localisation plus large.
L'API de clonage vocal vous permet de télécharger des échantillons audio d'un locuteur, de créer une voix IA personnalisée et de référencer cette voix dans les projets TTS. Une fois qu'une voix personnalisée existe, son identifiant devient le champ voice dans vos segments de synthèse vocale, de sorte que la narration se joue avec la voix clonée au lieu d'une voix standard générique. Cette continuité est importante pour les animateurs, les podcasteurs et les porte-parole de marque qui souhaitent une identité sonore cohérente à travers les langues et les formats. Si vous prévoyez d'ajouter le clonage, notre guide sur l'intégration d'une API de clonage vocal dans votre application couvre les détails.
L'API de doublage IA étend cela encore davantage en combinant transcription, traduction et synthèse vocale dans un seul pipeline qui double les vidéos dans plus de 33 langues cibles. Ici, le moteur TTS convertit les scripts traduits en parole en utilisant la même bibliothèque de plus de 300 voix ou votre voix clonée, de sorte que les versions doublées préservent le ton et le timing. Pour les créateurs et les entreprises multilingues, l'API de synthèse vocale devient la brique de base à la fois pour les voix off monolingues et le contenu doublé entièrement localisé. Notre aperçu de comment fonctionne la localisation par IA montre comment ces éléments s'assemblent de bout en bout.
Critères de décision clés lors de l'intégration de notre API TTS
Intégrer « n'importe quelle » API TTS ne suffit pas ; les choix autour de la mise en œuvre déterminent à quel point elle correspond à votre production, à votre marque et à votre pile technique.
Besoins en matière d'échelle et d'automatisation. Si le volume de contenu est faible et sporadique, l'outil basé sur navigateur peut suffire. Une fois que les scripts sont générés régulièrement ou liés à des calendriers de contenu, à des systèmes de gestion de l'apprentissage ou à l'automatisation marketing, l'API devient la bonne couche car elle peut être déclenchée par programmation et évoluer avec votre backend.
Stratégie de voix et de langues. Notre plateforme prend en charge le doublage de plus de 60 langues sources vers 33 langues cibles, alimenté par le même moteur vocal que l'API TTS utilise. Si votre marque a besoin d'une voix de porte-parole distinctive, associer l'API de clonage vocal au TTS maintient cette voix cohérente à travers les langues et les canaux. Si vous privilégiez la rapidité à la personnalisation, les voix intégrées simplifient la mise en œuvre.
Point d'intégration dans votre pile. Pour les chaînes YouTube, un endroit naturel est le pipeline vidéo : des scripts stockés dans un outil de planification, envoyés à l'API TTS une fois finalisés, et renvoyés sous forme d'audio prêt pour les monteurs. Les plateformes d'e-learning peuvent s'intégrer au niveau de la leçon ou de la diapositive, où chaque bloc de contenu correspond à un segment et les projets représentent des cours entiers. Les équipes marketing s'intègrent souvent au niveau du CMS afin que chaque article ou page produit puisse demander une version audio pour l'accessibilité.
Gouvernance, conformité et risque. Comme le clonage vocal peut reproduire des voix reconnaissables, le consentement, les licences et les politiques d'utilisation sont importants. Les voix clonées sont identifiées par des ID et peuvent être étiquetées avec des métadonnées, ce qui facilite l'application de règles internes sur les endroits où des voix spécifiques peuvent être utilisées. Décidez dès le départ quels environnements peuvent déclencher des voix clonées par rapport aux voix génériques, et ajoutez la journalisation dans vos propres systèmes.
Attentes en matière de latence et d'expérience utilisateur. Le traitement asynchrone offre de la flexibilité mais ajoute une considération de timing. Pour les workflows où les utilisateurs s'attendent à une lecture immédiate—comme un éditeur de script avec aperçu instantané—créez des projets ou des segments plus petits et affichez des indicateurs de progression pendant que l'audio se génère. Pour la localisation par lots de bibliothèques entières, la latence importe moins, et les tâches peuvent s'exécuter selon des calendriers avec l'audio terminé attaché aux enregistrements de contenu par la suite.
| Domaine de décision | Modèle par lots | Modèle transactionnel |
|---|---|---|
| Déclencheur | Tâches planifiées | Par élément de contenu ou action utilisateur |
| Tolérance à la latence | Élevée | Faible |
| Meilleur cas d'usage | Catalogues de cours, bibliothèques vidéo | Éditeurs de scripts, aperçus en direct |
| Stratégie de voix | Voix approuvée par langue | Voix approuvée par langue |
Risques et mesures de protection pratiques
L'intégration d'une API de synthèse vocale comporte quelques risques prévisibles qu'une conception réfléchie peut atténuer.
Choisir des voix sans les tester peut produire une parole qui semble hors de caractère pour une marque ou un animateur. Testez d'abord les voix dans l'interface interactive, et maintenez un catalogue de voix approuvées dans vos propres systèmes, organisé par langue et type de contenu, avant de codifier les ID de voix dans les appels API.
La sur-automatisation du contenu sensible est un autre piège. Générer de la parole automatiquement pour du matériel de conformité, médical ou juridique peut ne pas être approprié. Comme notre API fonctionne sur des projets et segments distincts, vous pouvez maintenir des règles de routage qui n'envoient que les catégories approuvées vers le TTS tout en gardant le contenu sensible dans des workflows enregistrés par des humains.
Les erreurs opérationnelles—projets échoués ou téléchargements manquants—surviennent lorsque des problèmes de réseau ou des charges utiles invalides interrompent le traitement. Les points de terminaison de statut de projet et les réponses structurées vous permettent de confirmer qu'un projet est terminé et que ses sorties sont disponibles avant la publication. Associez chaque ID de projet TTS à votre propre ID de contenu, et implémentez des relances ou des solutions de repli lorsque les vérifications de statut signalent des erreurs.
Le mauvais usage des voix clonées mérite des contrôles explicites. Les voix personnalisées doivent être créées via des points de terminaison dédiés puis référencées par ID dans les projets TTS, ce qui vous donne une frontière technique claire à surveiller. Restreignez qui peut créer ou attribuer des ID de voix clonées, et journalisez où elles sont utilisées.
Un chemin de départ pratique consiste à intégrer d'abord le TTS pour les voix off standard, à valider les voix et la gestion des erreurs en production, puis à ajouter le Clonage vocal et le Doublage IA une fois l'intégration de base stable. Indiquez-nous votre volume de contenu, vos langues cibles et l'endroit où l'API devrait se situer dans votre pile, et nous pourrons vous orienter vers les bons points de terminaison et planifier pour votre workflow.
Questions fréquemment posées
En quoi l'API de synthèse vocale diffère-t-elle de l'outil de navigateur ?
L'outil de navigateur est une interface visuelle où vous collez du texte, choisissez une voix et téléchargez manuellement l'audio. L'API expose le même moteur via des points de terminaison REST afin que votre backend puisse générer et récupérer l'audio automatiquement en réponse à des scripts, des calendriers ou des actions utilisateur.
L'API peut-elle parler avec ma propre voix, pas seulement des voix standard ?
Oui. En intégrant l'API de clonage vocal, vous téléchargez des échantillons audio d'un locuteur, créez une voix IA personnalisée, puis référencez l'ID de cette voix dans vos segments de synthèse vocale afin que toute la parole générée se joue avec la voix clonée.
Comment cela aide-t-il pour les chaînes YouTube ou les podcasts multilingues ?
Notre plateforme transforme la parole ou les scripts de plus de 60 langues sources en sortie doublée dans 33 langues cibles, le TTS générant l'audio final en utilisant plus de 300 voix ou votre voix clonée. Intégrer les API TTS et de doublage IA dans votre pipeline de publication permet aux nouvelles vidéos ou épisodes de recevoir des voix off ou des doublages complets une fois que les scripts ou l'audio source sont prêts.
Quels formats audio mon application ou mon éditeur recevra-t-il ?
L'API TTS fournit des fichiers audio de haute qualité, y compris du MP3 à 22 kHz, adaptés à la plupart des environnements web, mobiles et de montage vidéo sans conversion supplémentaire.
Puis-je intégrer la synthèse vocale maintenant et ajouter le doublage IA plus tard ?
Oui. La Synthèse vocale, le Clonage vocal et le Doublage IA partagent un écosystème d'API commun, vous pouvez donc commencer par le TTS pour les voix off et ajouter ultérieurement le Clonage vocal et le Doublage IA pour automatiser le doublage multilingue sans reconstruire votre intégration de base.