Demandez comment sont créées les voix off par IA et vous demandez en réalité comment un script écrit devient de la parole sans que personne n'entre dans une cabine d'enregistrement. La réponse courte : un modèle neuronal de synthèse vocale convertit votre script en audio synthétique, une voix clonée optionnelle fait sonner cet audio comme une personne spécifique, et une couche de doublage aligne tout avec votre vidéo dans plusieurs langues. Chez DubSmart AI, nous exécutons toute cette chaîne au sein d'un même espace de travail, afin que vous puissiez passer d'un paragraphe de texte à une voix off multilingue terminée sans changer d'outil ni réserver de temps en studio.
À quoi ressemble ce processus pour vous dépend d'une décision, et le reste de ce guide passe en revue les mécanismes, les options, et comment choisir.
Table des matières
La décision derrière la façon dont les voix off par IA sont créées
Avant que le moindre audio ne soit généré, vous faites deux choix qui façonnent tout ce qui suit. Le premier est de savoir si vous voulez une voix préétablie provenant d'une bibliothèque ou un clone de la vôtre. Le second est de savoir si vous avez besoin d'une voix off dans une seule langue ou d'une version entièrement localisée dans plusieurs langues.
Pour un créateur YouTube ou une petite entreprise, cela se règle généralement rapidement : choisissez une voix standard pour la rapidité, clonez une voix lorsque la cohérence de marque compte, et recourez au doublage uniquement lorsque vous passez au multilingue. Pour les développeurs et les agences, cette même bifurcation devient une question d'architecture — appelez-vous un point de terminaison de synthèse vocale pour de l'audio ponctuel, ou reliez-vous le clonage de voix et le doublage ensemble en un pipeline qui fonctionne de manière autonome ?
Nous avons conçu DubSmart précisément autour de ces bifurcations. Text to Speech, Voice Cloning, Speech to Text, Speech Separator, Text to Image, Image to Video et AI Dubbing vivent tous sur une seule plateforme, vous permettant d'augmenter ou de diminuer le niveau d'automatisation et de personnalisation sans assembler plusieurs fournisseurs distincts.
Les mécanismes : comment les voix off par IA sont réellement créées
Synthèse vocale : transformer le script en son
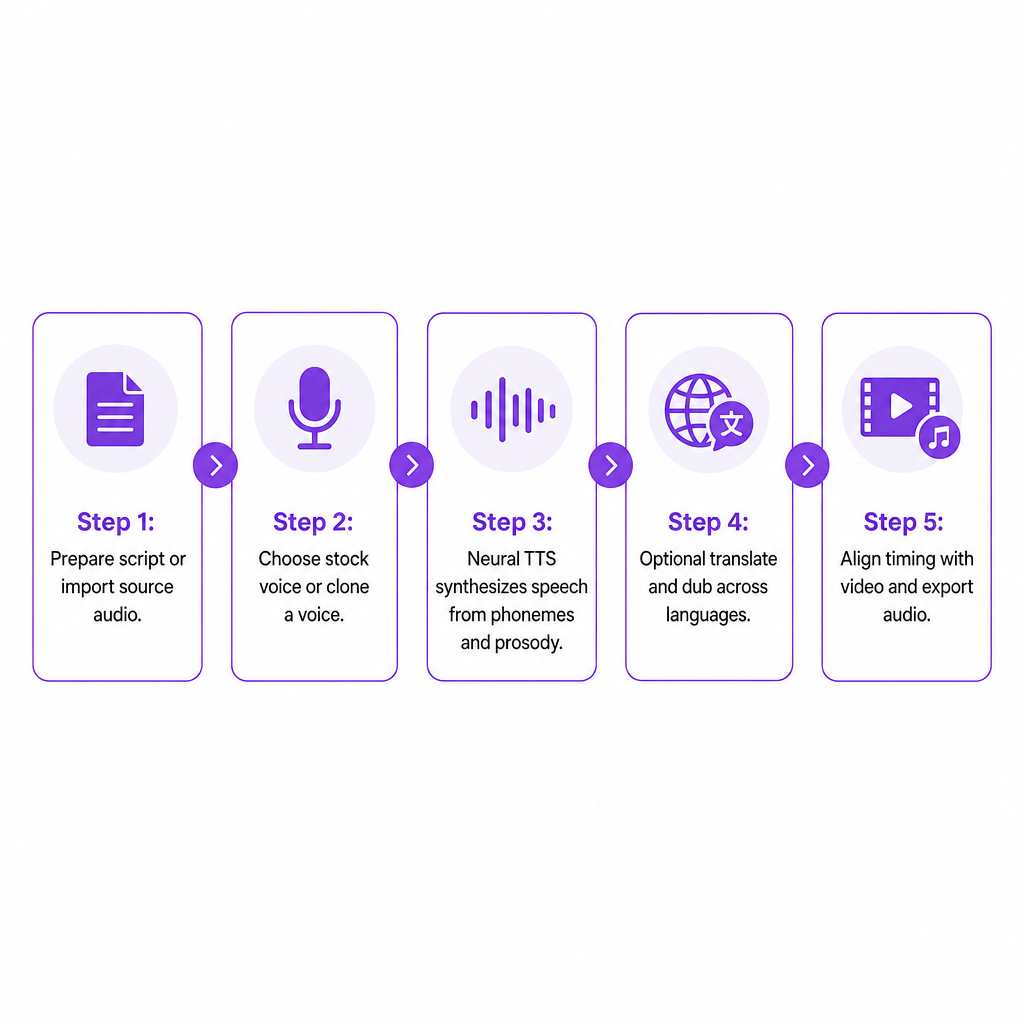
La synthèse vocale (TTS) se situe au cœur de chaque voix off par IA. Le moteur analyse d'abord votre script — découpant le texte en phonèmes, lisant la ponctuation et la structure, et déduisant la prosodie, c'est-à-dire le rythme, l'accentuation et l'intonation qui empêchent la parole de sonner plate. Les modèles neuronaux synthétisent ensuite ces phonèmes en audio et appliquent les motifs prosodiques qui rendent la diction fluide plutôt que robotique.
Notre moteur Text to Speech vous permet de coller du texte dans n'importe quelle langue, de choisir une voix parmi une bibliothèque de plus de 300, et de générer une parole réaliste en quelques secondes. Les voix sont naturelles et humaines, et elles sont catégorisées par langue, genre et style afin que vous puissiez faire correspondre le ton de ce que vous produisez. Pour les développeurs, le même moteur est exposé via une API Text to Speech RESTful : envoyez une requête POST avec votre texte et vos paramètres de voix, recevez en retour des fichiers audio prêts à l'emploi. Texte structuré en entrée, audio réaliste en sortie, sans enregistrement manuel.
Modèles de voix et bibliothèques de voix
Les voix off par IA reposent sur des modèles de voix entraînés — des réseaux neuronaux qui apprennent comment une voix particulière devrait sonner à travers différents mots, langues et émotions. Une bibliothèque de voix est simplement un catalogue de ces modèles. Nous maintenons une bibliothèque de plus de 300 voix naturelles couvrant plusieurs genres, accents et styles de parole dans de nombreuses langues, et elle est disponible à la fois dans l'application web et via l'API afin que les outils internes puissent générer de la parole à la demande.
Clonage de voix : faire sonner l'IA comme vous
Le clonage est le mécanisme qui fait sonner une voix off comme une personne spécifique plutôt que comme un narrateur générique. Le système analyse un échantillon d'enregistrement, apprend le timbre, la tessiture et les schémas de prononciation du locuteur, puis applique ces caractéristiques à de la nouvelle parole synthétique.
En pratique, vous téléchargez un fichier audio d'au moins 20 secondes vers Voice Cloning — idéalement propre et exempt de bruit de fond. Nous transformons cet échantillon en un profil de voix personnalisé que vous pouvez nommer et réutiliser, le clonage prenant généralement seulement quelques secondes. Une fois créée, la voix clonée devient disponible dans Text to Speech et AI Dubbing, vous permettant de générer des scripts ou des versions doublées avec votre propre voix. Par programmation, l'API Voice Cloning reflète cela : obtenez une URL de téléchargement, envoyez votre audio dans un format pris en charge, créez une voix personnalisée à partir de la clé de fichier résultante, puis utilisez-la dans des projets TTS ou de doublage.
Doublage et voix off multilingues
Passer d'une voix off dans une seule langue à un contenu multilingue ajoute une localisation par-dessus le TTS de base. Le schéma général est cohérent :
- Capturer ou importer la parole originale.
- La transcrire en texte.
- Traduire ce texte.
- Générer une nouvelle parole dans la langue cible.
- Aligner le timing avec la vidéo ou l'audio original.
Notre flux de travail AI Dubbing suit exactement ce schéma, combinant la reconnaissance vocale, la traduction automatique et la synthèse vocale, réutilisant éventuellement une voix clonée pour que la piste doublée corresponde au locuteur original. Il transforme du contenu parlé provenant de plus de 60 langues sources en versions doublées dans 33 langues cibles. Le doublage voix-à-voix vise à garder le ton et le timing proches de la performance originale, ce qui compte le plus pour le e-learning, la formation et le contenu cinématographique où la synchronisation labiale et le rythme portent l'expérience.
API et flux de travail automatisés
Pour les équipes produisant des voix off à grande échelle, les API sont ce qui intègre la création de voix dans les systèmes existants. L'API TTS gère le texte en entrée, l'audio en sortie ; l'API Voice Cloning ajoute la création et la gestion par programmation de voix personnalisées ; et l'API AI Dubbing étend les deux à la traduction et au doublage automatiques dans plus de 33 langues avec accès aux voix clonées. Ensemble, elles vous permettent de construire des pipelines où les scripts, sous-titres ou transcriptions extraits d'un système de contenu deviennent automatiquement des voix off ou des pistes doublées, sans manipulation manuelle de fichiers.
Vos trois façons de créer des voix off par IA dans DubSmart
Au sein de notre plateforme, la question se résout en trois points de départ pratiques.
Partez d'un script avec Text to Speech. Collez votre texte, choisissez une voix standard ou clonée, définissez la langue et les contrôles de base, et générez une parole que vous pouvez télécharger dans des formats standard. Cela convient aux vidéos de formation, au contenu explicatif, aux spots marketing et aux intros de podcast où vous possédez le script dès le départ.
Partez de médias existants avec AI Dubbing. Téléchargez une vidéo source ou un fichier audio, laissez le système transcrire et traduire, puis générez des pistes doublées dans les langues de votre choix — en réutilisant des voix clonées pour garder le son cohérent. C'est la voie pour les chaînes s'étendant vers des audiences multilingues et pour les entreprises réutilisant des webinaires ou des démonstrations de produits.
Partez de vos propres systèmes avec la génération basée sur API. Votre application envoie du texte et des paramètres de voix à l'API TTS, lie éventuellement le contenu à une voix spécifique via l'API Voice Cloning, et récupère de l'audio prêt à être attaché à des vidéos ou à des voix off e-learning pour des modules de formation. Cela convient aux développeurs, agences et fournisseurs de LMS qui ont besoin d'une sortie cohérente et programmatique.
Critères de décision : choisir votre configuration de voix off par IA
Naturel et qualité audio
Le naturel est non négociable. Les moteurs performants modélisent la prosodie et l'articulation afin que la parole s'écoule avec des pauses et une accentuation appropriées. Parce que la génération est rapide, vous pouvez itérer sur un script et régénérer l'audio jusqu'à ce que la diction sonne juste plutôt que de vous contenter de la première prise.
Couverture linguistique et profondeur de localisation
Si des chaînes multilingues ou de la formation internationale figurent dans votre feuille de route, la couverture décide jusqu'où vous pouvez aller. Transformer du contenu de plus de 60 langues sources en 33 langues cibles à partir d'un seul flux de travail définit les marchés que vous pouvez servir, et le doublage voix-à-voix aide à garder le ton et le timing cohérents dans chaque version.
Image de marque vocale et capacité de clonage
Une voix reconnaissable compte pour les entreprises, les créateurs et les podcasts. Le clonage vous permet de porter la même voix à travers les langues et les canaux. Pouvoir cloner à partir d'environ 20 secondes d'audio propre et réutiliser ce profil dans Text to Speech et AI Dubbing rend un son signature pratique à établir et à maintenir.
Simplicité du flux de travail versus intégration technique
Les créateurs veulent souvent que le téléchargement, l'édition et le téléchargement soient gérés au même endroit. Les équipes techniques ont souvent besoin d'API. Nous offrons les deux : des outils orientés utilisateur dans une application unifiée et des API pour développeurs qui exposent les mêmes moteurs. Le choix se résume à savoir si votre équipe travaille principalement dans un navigateur ou construit sur des systèmes internes.
Vitesse, évolutivité et cohérence
Un outil de voix off devrait raccourcir la production et évoluer sans que la qualité ne baisse. La génération TTS quasi instantanée et le clonage qui s'achève en quelques secondes permettent une itération rapide et une production en masse, tandis que les API permettent de traiter automatiquement des milliers de scripts ou de segments avec des voix et des paramètres cohérents.
Structure budgétaire et contrôle
Au lieu de frais de studio par session, les outils de voix off par IA utilisent généralement une tarification basée sur l'usage. Notre modèle basé sur des crédits vous donne accès à AI Dubbing, Text to Speech, Voice Cloning, Speech to Text, Speech Separator, Text to Image et Image to Video sous un seul compte, avec un niveau gratuit et des forfaits entreprise. Les crédits offrent des plafonds d'usage prévisibles tandis que le report et la mise à l'échelle restent disponibles lorsque le volume grimpe. Si vous souhaitez dimensionner les crédits par rapport à la durée d'exécution, notre analyse du coût du doublage par IA par minute détaille les calculs.
Conformité, consentement et gestion des données
Le clonage et la parole synthétique comportent un poids éthique et juridique. Nous exigeons que vous téléchargiez de l'audio pour lequel vous détenez les droits et recommandons des enregistrements propres pour de meilleurs résultats, ce qui maintient le consentement et le contrôle au centre. Notre documentation d'API utilise des URL de téléchargement sécurisées et présignées ainsi que des formats audio standard, offrant aux développeurs un schéma clair pour un usage conforme au sein des applications.
Risques à anticiper
Même avec des outils performants, quelques modes de défaillance méritent d'être anticipés.
Un audio non naturel ou robotique remonte généralement à des scripts mal ponctués ou à une voix inadaptée au contenu. Choisir parmi une bibliothèque de voix naturelles et régénérer jusqu'à ce que la diction convienne est la solution pratique, et la génération rapide rend cette expérimentation peu coûteuse.
Les erreurs de prononciation ont tendance à apparaître avec les noms, les termes techniques et le contenu localisé. Un pipeline qui exécute la transcription, la traduction et la révision — plutôt qu'une conversion audio-à-audio à l'aveugle — détecte davantage de ces erreurs avant leur diffusion.
Les décalages de timing entre la parole synthétisée et les visuels à l'écran nuisent à l'expérience du spectateur. Le doublage voix-à-voix qui reste proche du ton et du timing originaux, associé à l'édition au sein de l'environnement du projet, vous donne un meilleur contrôle sur l'alignement.
Sur le plan éthique, cloner une voix sans les droits appropriés entraîne de sérieux problèmes. Exiger un échantillon propre sous votre contrôle, et présenter le clonage comme un outil pour les créateurs et les entreprises plutôt que comme une usurpation anonyme, est ce qui maintient la pratique responsable. Lorsque vous localisez des séquences existantes, notre guide sur comment changer la langue de la voix dans une vidéo montre la voie propice à la révision.
Comment différents créateurs mettent cela en pratique
Un créateur YouTube s'étendant à l'étranger peut transformer une seule vidéo en anglais en versions espagnole, portugaise et allemande avec AI Dubbing et une voix clonée, afin que l'animateur reste reconnaissable sur chaque marché — le tout au sein du pipeline de plus de 60 langues sources et 33 langues cibles.
Une petite entreprise ou une équipe marketing peut rédiger un script explicatif de produit ou une publicité dans un document, le convertir en audio avec Text to Speech, et choisir une voix qui correspond au ton de la marque — énergique, formel ou conversationnel. Ces mêmes scripts peuvent être localisés ultérieurement via AI Dubbing en utilisant une voix de marque clonée.
Un producteur de e-learning ou de formation en entreprise peut automatiser la narration pour des présentations de diapositives et des packages SCORM en envoyant le texte de la leçon via l'API TTS et en attachant l'audio retourné à chaque module, le clonage gardant la voix de l'instructeur cohérente même à travers les versions régionales.
Un cinéaste indépendant ou un créateur de podcast peut produire des bandes-annonces, des promos ou des dialogues traduits sans réserver un studio dans chaque langue, en combinant Speech to Text, AI Dubbing et des voix clonées pour maintenir l'identité des personnages stable.
Les développeurs et les agences peuvent intégrer les API TTS, Voice Cloning et AI Dubbing dans des outils internes ou des plateformes clients, automatisant tout, des voix off pour réseaux sociaux au format court aux agents vocaux interactifs.
Questions fréquentes
En quoi les voix off par IA diffèrent-elles des voix off enregistrées traditionnelles ?
Les voix off traditionnelles nécessitent un comédien de doublage humain, du temps en studio et plusieurs sessions. Les voix off par IA sont générées par des moteurs de synthèse vocale et de clonage de voix qui transforment directement les scripts en audio à l'aide de modèles neuronaux entraînés plutôt que d'une performance en direct.
Une voix off par IA peut-elle sonner comme une personne spécifique ?
Oui. Le clonage de voix analyse un court échantillon de la voix de quelqu'un et construit un modèle personnalisé capable de dire n'importe quel script dans cette voix, disponible dans notre outil et notre API Voice Cloning.
Quelle quantité d'audio est nécessaire pour cloner une voix ?
Nous demandons au moins 20 secondes d'audio propre, exempt de bruit de fond, pour créer un profil de voix clonée fiable, le clonage se terminant généralement en quelques secondes.
Puis-je créer des voix off dans plusieurs langues à partir d'une seule vidéo source ?
Oui. Nous combinons la reconnaissance vocale, la traduction et la synthèse vocale pour transformer du contenu provenant de plus de 60 langues sources en une sortie doublée dans 33 langues cibles, de sorte qu'une seule vidéo originale peut produire de nombreuses voix off localisées.
Existe-t-il un moyen d'automatiser la création de voix off au lieu d'utiliser l'interface ?
Nos API TTS et Voice Cloning permettent aux applications et aux outils internes d'envoyer du texte et des échantillons audio, de créer des voix personnalisées et de recevoir de la parole synthétique par programmation, afin que les voix off puissent être générées automatiquement à grande échelle.