La séparation vocale par IA est un processus d'apprentissage profond qui extrait une voix humaine d'un mélange bruyant et restitue une piste vocale propre, prête pour la transcription, le doublage ou le clonage vocal. Cette seule capacité répond à la question que se posent réellement la plupart des créateurs : puis-je sauver cet enregistrement sans le refaire ? Comprendre le fonctionnement de la séparation vocale par IA vous aide à décider quand vous appuyer dessus, quand enregistrer plus proprement dès le départ, et comment une piste vocale propre améliore discrètement tout ce qui suit. Ce guide parcourt le mécanisme, la différence entre l'amélioration d'un seul locuteur et la séparation de plusieurs, la place de ce processus dans un pipeline de localisation, et ce qu'il ne peut toujours pas corriger.
Table des matières
La décision derrière la séparation vocale
Tout enregistrement réel capture bien plus que le locuteur. Les vlogs, webinaires, vidéos de formation et podcasts captent le bruit de la rue, l'ambiance de la pièce, les fonds musicaux, les cliquetis de clavier et les bavardages superposés qui peuvent enterrer les mots qui comptent. Un séparateur vocal existe pour démêler ce mélange : il prend un fichier mixé et restitue une piste contenant essentiellement de la parole humaine, plus une piste optionnelle contenant l'audio de fond restant.
Cette piste vocale propre devient la base de tout ce qui suit : reconnaissance vocale précise, doublage multilingue, clonage vocal haute fidélité, ou simplement un original au meilleur son. La véritable décision n'est donc pas technique, elle est pratique. Faites-vous suffisamment confiance à votre audio actuel pour construire du contenu multilingue par-dessus, ou voulez-vous que l'IA nettoie et sépare d'abord la parole ? Et voulez-vous un utilitaire de nettoyage autonome, ou un séparateur intégré dans une plateforme de création et de localisation plus large afin de ne pas jongler entre plusieurs applications ?
Nous avons conçu notre Séparateur vocal pour agir comme la première porte IA dans un flux de travail unifié. Il se situe avant la reconnaissance vocale, la synthèse vocale, le clonage vocal et le doublage, afin que chaque système en aval voie le signal vocal le plus clair possible au lieu d'hériter du bruit qui était dans la pièce.
Le mécanisme : de la forme d'onde à la voix propre
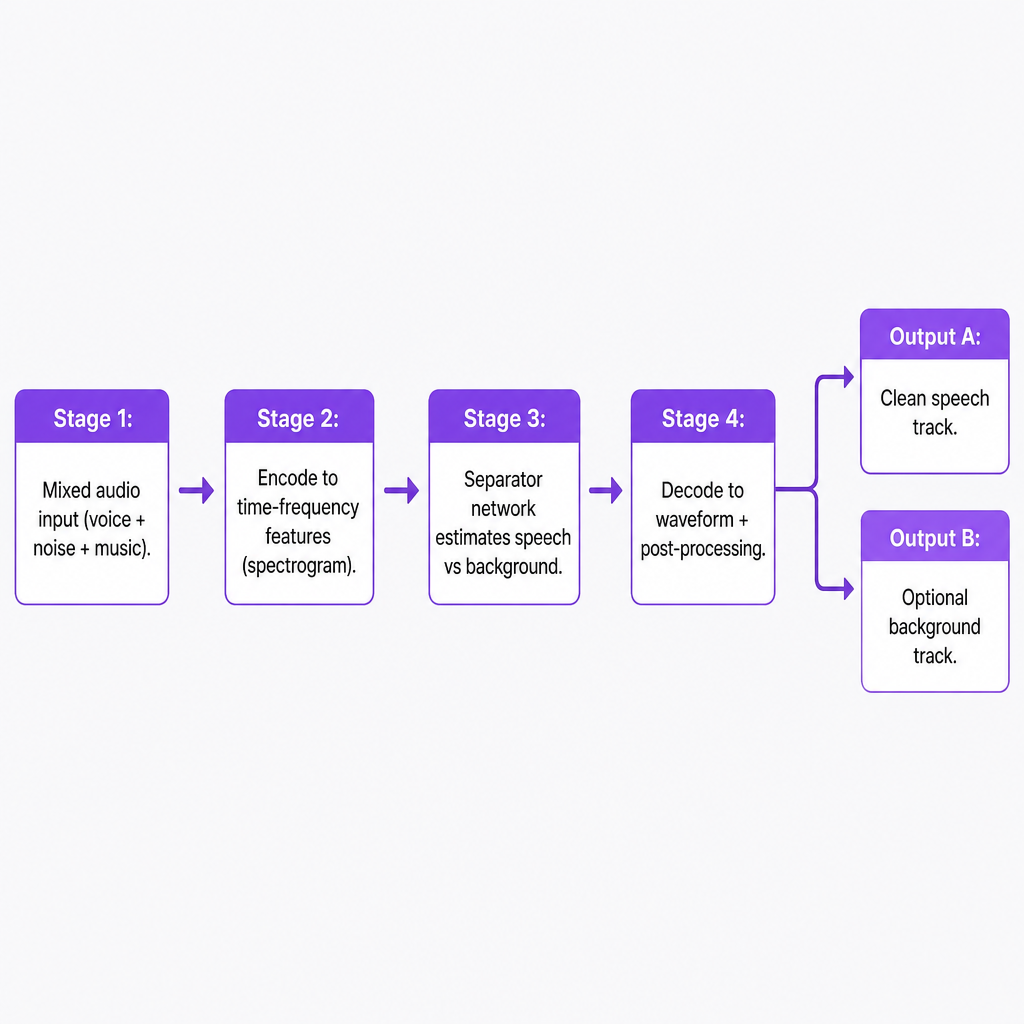
La séparation vocale par IA moderne suit un pipeline en quatre étapes : encoder le signal, séparer les sources dans un espace de caractéristiques appris, estimer la parole propre, et la décoder à nouveau en audio.
De la forme d'onde aux caractéristiques
La plupart des systèmes convertissent d'abord la forme d'onde brute de votre microphone en une représentation temps-fréquence telle qu'un spectrogramme, qui montre comment l'énergie dans différentes bandes de fréquences évolue au fil du temps. Cette vue facilite pour un réseau de neurones la reconnaissance des motifs correspondant à la parole humaine par opposition au bruit ou à la musique. Un réseau encodeur mappe ensuite l'entrée dans un espace de caractéristiques de haute dimension où les différentes sources sonores deviennent plus distinguables, mettant en valeur les traits de la parole comme les formants, les harmoniques et la structure temporelle tout en supprimant le contenu de fond non pertinent.
Réseaux séparateurs et masques
Le cœur du processus est le réseau séparateur, un modèle profond entraîné à juger ce qui appartient à la voix et ce qui n'y appartient pas à chaque point temps-fréquence. Deux stratégies dominent. La séparation basée sur les masques prédit un masque pour le spectrogramme qui conserve l'énergie de la parole et atténue tout le reste ; lorsqu'il est appliqué au spectrogramme original, le bruit de fond et la musique chutent fortement tandis que la parole demeure. L'estimation directe de la source prédit plutôt le spectrogramme de la parole propre lui-même, et parfois un fond résiduel, qui est ensuite décodé à nouveau en audio.
Des approches plus spécialisées existent pour les cas plus difficiles. Le clustering profond apprend un embedding pour chaque bin temps-fréquence afin que les bins de la même source se regroupent, après quoi un clustering standard sépare la parole des autres sources. D'autres modèles utilisent l'entraînement invariant aux permutations pour pouvoir séparer plusieurs locuteurs sans présumer quel locuteur est la sortie une par rapport à la sortie deux.
Entraînement avec des exemples supervisés
Ces modèles apprennent à partir de mélanges d'exemples associés à de la parole propre de référence, s'ajustant pour minimiser l'écart entre leur sortie et la référence. Les cibles d'entraînement peuvent être des masques, des spectrogrammes propres ou des formes d'onde reconstruites, et les fonctions de perte sont souvent liées à des mesures de qualité perceptive comme le rapport signal/distorsion. Alimenté par de nombreux échantillons variés à travers accents, microphones et environnements, le réseau intègre des indices robustes qui séparent la parole humaine du contenu de fond et généralise à des enregistrements qu'il n'a jamais vus.
Décodage vers l'audio
Enfin, le système mappe la représentation de la parole séparée à nouveau vers une forme d'onde dans le domaine temporel via une transformée inverse, suivie d'un post-traitement tel que le débruitage et la normalisation de la sonie. Le résultat est une piste dominée par la parole qui peut tenir seule ou être recombinée avec une quantité contrôlée de fond pour plus de naturel. Notre Séparateur vocal suit exactement ce modèle : il ingère votre audio ou vidéo téléchargé, exécute le pipeline de séparation, et restitue une piste axée sur la parole plus un fond optionnel afin que vous décidiez à quel point le mixage final doit être sec ou ambiant.
Amélioration d'un seul locuteur vs séparation de plusieurs locuteurs
Il existe une frontière importante entre l'amélioration d'un locuteur dominant et le véritable fractionnement de plusieurs voix superposées, et elle façonne ce à quoi vous pouvez raisonnablement vous attendre.
L'amélioration d'un seul locuteur isole une voix principale du bruit de fond, de la réverbération et des sons non vocaux afin que l'intelligibilité bondisse. Cela fonctionne particulièrement bien pour les vlogs, webinaires, conférences et contenus de type talking-head, où le problème est le bruit ambiant ou un fond musical plutôt que la diaphonie. Notre Séparateur vocal est optimisé pour ce cas : il traite la parole humaine comme la source principale et tout le reste comme du fond, livrant une piste vocale nettoyée et une piste de fond optionnelle.
La séparation de plusieurs locuteurs est une tâche différente : fractionner un mélange de plusieurs personnes parlant en même temps en flux individuels, un par voix. Des modèles de recherche ont séparé jusqu'à cinq voix à partir d'un seul microphone en entraînant différents réseaux pour différents nombres de locuteurs et en choisissant le meilleur ajustement pour chaque échantillon. Des techniques comme le clustering profond et le beamforming neuronal multi-microphones repoussent davantage les performances dans les configurations en champ lointain et multicanaux, mais elles sont plus complexes et coûteuses en calcul. En pratique, ces systèmes ciblent toujours des scénarios spécialisés tels que la transcription de réunions, les centres d'appels et les appareils intelligents plutôt que les flux de travail quotidiens des créateurs. Pour la plupart de nos utilisateurs, qui gèrent des chaînes YouTube, des équipes marketing ou des bibliothèques de cours, le plus grand gain pratique provient d'une forte amélioration d'un seul locuteur et de la séparation parole/fond, et non d'un fractionnement complet multi-voix.
La place de la séparation dans un flux de localisation
La séparation est le pont entre les enregistrements bruyants du monde réel et le travail vocal IA de haute qualité. Un parcours typique passe proprement à travers plusieurs outils.
Un créateur télécharge un fichier audio ou vidéo, et le séparateur isole la piste vocale et éventuellement le fond. Cette parole propre alimente la reconnaissance vocale, de sorte que la transcription et la traduction opèrent sur un signal clair, ce qui améliore la précision et réduit les mots hallucinés causés par une musique ou un bruit intenses. Le texte et les traductions qui en résultent passent ensuite dans la synthèse vocale et le doublage IA, qui génèrent de nouvelles versions linguistiques à l'aide de voix clonées ou synthétiques ; comme la parole source était propre, l'alignement temporel est plus précis et les artefacts de mixage comme le pumping sont réduits.
Le clonage vocal dépend de la même entrée propre. Les modèles ont besoin d'exemples relativement exempts de bruit pour apprendre de manière fiable le timbre, la prosodie et l'articulation d'un locuteur, et la séparation réduit la contamination de fond qui peut déformer une voix clonée. Notre guide en langue espagnole sur la séparation capture bien l'expérience quotidienne : téléchargez un fichier, laissez l'IA séparer la voix du fond, puis téléchargez soit la piste vocale propre soit le fond isolé pour un montage, un doublage ou une narration ultérieurs, le tout au sein d'un même flux de travail. Cette consolidation est le point clé pour les petites équipes, qui autrement rebondissent entre des plugins de réduction de bruit distincts, des outils de transcription, des services de doublage et des plateformes de clonage.
Choisir et utiliser la séparation vocale par IA
Lorsque vous décidez comment adopter la séparation, une poignée de critères pratiques font l'essentiel du travail.
Conditions audio et type de contenu. Avec un seul locuteur principal et un bruit de fond ou une musique modérés, la séparation est très efficace et peu risquée. Avec un fort chevauchement, des microphones en champ lointain ou une entrée de très faible qualité, attendez-vous à des rendements décroissants et associez l'IA à un meilleur enregistrement plutôt que de compter sur elle pour tout sauver.
Intégration avec les outils en aval. Un séparateur qui alimente directement la transcription, la synthèse vocale et le doublage réduit les frictions et les artefacts cumulatifs par rapport à l'exportation et la réimportation entre applications. Nous connectons le Séparateur vocal au reste de nos outils de localisation pour exactement cette raison, ce qui importe davantage lorsque votre objectif est la publication multilingue plutôt qu'une réduction de bruit ponctuelle.
Contrôle sur l'audio de fond. Pour la narration de marque, vous voulez souvent conserver un peu d'ambiance ou de musique pour un impact émotionnel. Les systèmes qui produisent à la fois une piste vocale propre et un fond isolé offrent aux monteurs plus de marge que les outils qui ne produisent qu'un seul mixage débruité. Notre séparateur prend en charge ce paradigme parole-plus-fond-optionnel afin que vous puissiez remixer de manière délibérée.
Rapidité, simplicité et échelle. Pour les créateurs et les petites équipes, la facilité d'utilisation rivalise avec la performance brute. La séparation en un clic via un navigateur ou une API, avec gestion automatique des formats courants, l'emporte sur les chaînes de plugins complexes qui supposent une expertise en ingénierie audio. Une fois que vous gérez des centaines de vidéos ou de modules de cours, le traitement par lots et l'automatisation cessent d'être des luxes.
Fiabilité et artefacts. Un modèle solide améliore l'intelligibilité sans ajouter de distorsion évidente, de résonance métallique ou d'artefacts de respiration. Les démos peuvent flatter un système, alors testez avec vos propres enregistrements représentatifs avant de faire d'un séparateur une partie fixe de votre pipeline.
Confidentialité et conformité. La séparation opère directement sur des données vocales qui peuvent inclure des informations sensibles. Les équipes d'entreprise doivent confirmer comment l'audio est stocké, s'il est utilisé pour l'entraînement de modèles, et quels contrôles existent pour la conservation et l'accès, en particulier pour les secteurs réglementés et le contenu de formation interne.
En pesant ces critères par rapport à vos cas d'usage réels, qu'il s'agisse d'expansion de chaîne, de formation, de marketing, de travail narratif ou d'un produit API, vous saurez si un séparateur intégré avec des outils vocaux en aval correspond à votre façon d'opérer.
Risques, limites et ce qu'elle ne peut pas corriger
Même les modèles solides ont des limites nettes qu'il vaut la peine de connaître avant de s'engager.
- Bruit extrême ou rapport signal/bruit très faible. Lorsque la parole est enterrée sous un bruit ou une musique forts, le modèle peut ne pas récupérer chaque mot, produisant des coupures ou une sortie étouffée.
- Fort chevauchement de locuteurs. Les personnes parlant exactement en même temps mettent au défi même les systèmes multi-locuteurs avancés et peuvent provoquer un saignement de la parole entre les flux séparés.
- Artefacts de sur-séparation. Un masquage agressif peut introduire un bruit musical ou un timbre robotique, le plus visible sur les sons soutenus et les sifflantes.
- Décalage entre entraînement et réalité. Les modèles réglés sur certains microphones, langues ou environnements peuvent sous-performer sur des enregistrements très différents, ce qui dégrade ensuite la précision de la transcription et du doublage.
- Éthique et droits. Une parole proprement séparée est plus facile à transcrire, analyser et remixer, de sorte que les équipes doivent respecter le consentement et les droits lors de la réutilisation de voix dans de nouvelles langues ou contextes.
La conclusion honnête est que la séparation est une amélioration puissante, et non un remplacement des bonnes habitudes d'enregistrement. De bons microphones, des niveaux raisonnables et des choix de lieu réfléchis restent payants, et l'IA multiplie ensuite ces choix en rendant le contenu bien plus flexible pour la localisation et la réutilisation. Si vous explorez comment intégrer cela dans une configuration de publication plus large, notre article explicatif sur ce qu'est un séparateur vocal couvre les fondamentaux plus en profondeur.
Questions fréquentes
Qu'est-ce que la séparation vocale par IA en termes simples ?
C'est un processus IA qui prend un enregistrement mixé et isole la parole humaine, vous donnant une piste vocale propre et, éventuellement, une piste de fond distincte que vous pouvez conserver ou écarter.
En quoi notre Séparateur vocal diffère-t-il de la réduction de bruit basique ?
La réduction de bruit traditionnelle atténue principalement le bruit en régime permanent. Notre séparateur utilise l'apprentissage profond pour reconnaître les motifs de la parole et les extraire d'une large gamme de sons de fond et de musique, ce qui produit généralement un dialogue plus propre et plus naturel.
Peut-il gérer plusieurs locuteurs ?
Notre Séparateur vocal est optimisé pour isoler la parole humaine des fonds non vocaux, ce qui fonctionne le mieux avec un locuteur principal dans le mélange. Le fractionnement de plusieurs voix superposées est un domaine de recherche actif, et des modèles spécialisés existent, mais ils ciblent généralement les réunions ou les centres d'appels plutôt que les flux de travail généraux des créateurs.
Pourquoi la séparation vocale est-elle importante pour le doublage multilingue ?
La localisation repose sur une transcription et un minutage précis. Une piste vocale propre réduit les erreurs de reconnaissance et aide les voix off traduites à s'aligner avec la vidéo originale, réduisant les artefacts audibles lorsque de nouvelles voix sont mixées avec la musique et les effets conservés.
De combien de connaissances techniques ai-je besoin pour l'utiliser ?
Très peu. Vous téléchargez un fichier audio ou vidéo, laissez l'IA le traiter, et téléchargez les pistes de parole et de fond séparées pour le montage, le doublage ou l'automatisation, sans réglage manuel de paramètres requis.