La traducción de voz a voz convierte las palabras habladas en un idioma en voz audible en otro, de modo que tu audiencia escucha la traducción en lugar de leerla. Imagina a un instructor que grabó una lección en inglés y ahora necesita una versión en español sin tener que volver a grabar nada: el sistema transcribe el inglés, traduce el significado y genera el audio en español en su lugar. Ese cambio de leer a escuchar es el objetivo central, y modifica la forma en que planificas, revisas y publicas contenido multilingüe.
La verdadera pregunta rara vez es si la tecnología funciona. Es cuál versión de ella necesitas: traducción grabada para vídeos, cursos y pódcast; traducción casi en tiempo real para reuniones y eventos; salida con preservación de voz que mantiene la identidad del hablante original; o una API que puedas integrar en tu propia aplicación. Cada uno de esos caminos implica compensaciones distintas en calidad, latencia y esfuerzo de revisión, y esta guía los mapea para que puedas elegir con pleno conocimiento.
Tabla de contenidos
Cómo funciona la traducción de voz a voz
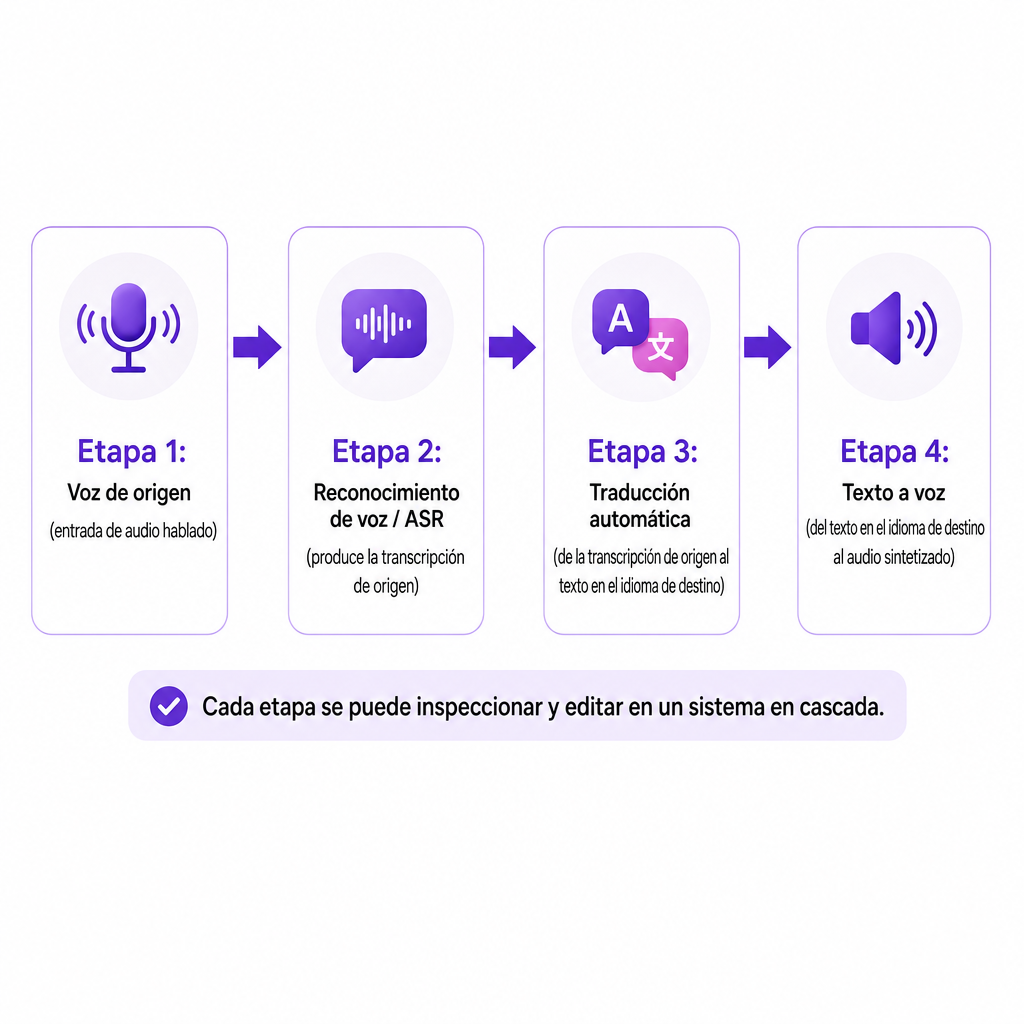
La mayoría de los sistemas ejecutan una canalización conectada de tres tecnologías. Primero, el reconocimiento automático del habla (ASR) analiza el audio de origen y produce una transcripción. Luego, la traducción automática convierte ese texto en el idioma de origen al idioma de destino. Finalmente, la conversión de texto a voz transforma el texto traducido en audio hablado. El flujo se lee claramente como habla de origen, luego reconocimiento, luego texto traducido, luego habla sintetizada.
Habla de origen → reconocimiento del habla → texto traducido → habla sintetizada
Este diseño por capas se denomina traducción de voz a voz en cascada, y la publicación del NIST sobre la evaluación de la traducción del habla describe la misma estructura: el ASR construye la transcripción de origen, la traducción automática produce el texto en el idioma de destino y la conversión de texto a voz genera la salida hablada. La ventaja de una cascada es que cada etapa es inspeccionable, por lo que puedes corregir una transcripción o una traducción antes de que el audio se genere.
Un enfoque más reciente entrena un modelo de extremo a extremo para mapear el audio de origen directamente al audio en el idioma de destino sin exponer etapas separadas de transcripción y síntesis. La investigación compartida a través del informe técnico del DTIC sobre traducción directa del habla plantea esto como una forma de reducir el retardo y preservar más la voz del hablante original, aunque señala que todavía implica compensaciones en velocidad, contexto, cobertura de idiomas y calidad de salida. En la práctica, la cascada te da más control editorial; el enfoque de extremo a extremo persigue menor latencia y continuidad de voz.
Traducción de voz a voz frente a tareas relacionadas
A menudo se confunde la traducción de voz a voz con la transcripción, la traducción de texto y el doblaje, pero cada una termina con un entregable distinto. La traducción de texto se detiene en la salida escrita. La traducción de voz a voz termina con salida hablada, aunque un sistema en cascada sigue usando texto internamente como representación intermedia. Aclarar las entradas y salidas te evita elegir la herramienta equivocada para la tarea.
| Tecnología | Entrada | Salida | Uso típico |
|---|---|---|---|
| Voz a texto | Audio hablado | Transcripción escrita | Subtítulos, notas, contenido buscable |
| Traducción de texto | Texto escrito | Texto traducido | Documentos, subtítulos, páginas web |
| Texto a voz | Texto escrito | Habla sintética | Narración, accesibilidad, interfaces de voz |
| Traducción de voz a voz | Audio hablado | Habla traducida | Conversaciones, doblaje, medios multilingües |
El doblaje merece su propia distinción. La traducción de voz a voz se centra estrictamente en cambiar el idioma hablado. El doblaje es el flujo de trabajo más amplio de localización de medios que lo envuelve: traducir diálogos, asignar hablantes, generar nuevas voces, ajustar los tiempos, mezclar las voces traducidas con la música y el audio de fondo, y exportar un proyecto terminado. Para un vídeo grabado de YouTube, un curso en línea, un pódcast o una película, el doblaje suele ser el formato más práctico porque añade esos controles editoriales sobre la traducción. Si estás sopesando el audio frente al texto en pantalla, nuestra explicación sobre doblaje frente a subtítulos para vídeo recorre esa elección específica, y los mecanismos más amplios están en nuestra guía sobre qué es el doblaje con IA y cómo funciona.
Los tres componentes que determinan la calidad
La calidad de salida no es un número único. Es el producto de tres etapas, cada una con sus propios modos de fallo, por lo que conviene evaluarlas por separado en lugar de confiar en una impresión general.
El reconocimiento automático del habla identifica las palabras en la grabación de origen, y su precisión disminuye con música de fondo, hablantes solapados, acentos marcados, habla rápida o incompleta, términos específicos del dominio, micrófonos de baja calidad y el cambio de código entre idiomas. Una métrica común aquí es la tasa de error de palabras (WER), que compara una transcripción automática con una referencia humana contando sustituciones, eliminaciones e inserciones. La misma publicación del NIST usa la WER como punto de referencia del reconocimiento, aunque una WER baja no confirma que la traducción posterior haya preservado el significado o el tono. Si tu audio de origen es ruidoso, aislar primero el habla limpia con una herramienta como nuestro separador de voz puede mejorar la precisión del reconocimiento antes incluso de que empiece la traducción.
La traducción automática tiene que interpretar más que palabras individuales. Maneja la estructura de las oraciones, el contexto, los pronombres y el género, las expresiones idiomáticas, el humor, la formalidad, las referencias culturales, la terminología técnica y las diferencias en el orden de las palabras. Una traducción literal puede ser gramaticalmente correcta y, sin embargo, sonar poco natural o cambiar sutilmente el significado pretendido, lo cual es especialmente arriesgado para afirmaciones publicitarias, instrucciones legales, información médica, contenido financiero y material educativo.
La síntesis del habla genera la voz final en el idioma de destino, controlando la pronunciación, las pausas, la velocidad de habla, la entonación, el énfasis, el tono emocional, la identidad de voz y el acento o la variante del idioma. Nuestro producto de Texto a Voz ofrece más de 300 voces de IA, generación multilingüe y clonación de voz en 33 idiomas, con controles de velocidad del habla, énfasis, lectura de números y entrega emocional. Una traducción técnicamente precisa aún puede quedar mal si la entrega no se ajusta a la marca, el curso o el documental al que pertenece.
Clonación de voz en el habla traducida
La clonación de voz es opcional, pero es lo que hace que el contenido traducido se sienta como el mismo creador en lugar de un extraño leyendo un guion. En lugar de asignar una voz genérica no relacionada a cada idioma, un sistema puede construir una interpretación en el idioma de destino modelada a partir de la identidad vocal del hablante original. Esa continuidad importa para un canal que quiere una voz reconocible en todos los idiomas, una empresa con un presentador conocido, un curso largo dirigido por un instructor, un cineasta que necesita coherencia en todas las versiones dobladas, o un anfitrión de pódcast que mantiene un sonido familiar en los episodios traducidos.
No es una garantía. La clonación preserva la identidad vocal, pero la emoción, el humor, el ritmo, la pronunciación y el contexto cultural aún necesitan una revisión humana antes de publicar. Igual de importante es la autorización: un flujo de trabajo responsable confirma que quien suministró la grabación ha dado su consentimiento para la clonación y que la voz resultante puede usarse para la distribución comercial, pública o geográfica prevista. Si te interesan los mecanismos detrás de esto, nuestra descripción general de cómo funciona la clonación de voz profundiza más, y la herramienta de Clonación de Voz muestra el lado de la producción.
Traducción grabada frente a traducción en tiempo real
Esta es la decisión que la mayoría de los equipos enfrenta realmente, y los dos modos no deberían juzgarse con la misma vara.
La traducción grabada suele ser la mejor opción para la producción de medios porque te da tiempo para trabajar. Puedes corregir la transcripción, editar la terminología, revisar la traducción, identificar a los hablantes, ajustar los tiempos, regenerar voces, mezclar el audio de fondo y realizar un control de calidad humano antes de que se publique nada. Eso la hace muy adecuada para canales de YouTube, aprendizaje en línea, formación corporativa, pódcast, vídeos de producto y películas independientes.
La traducción en tiempo real opera bajo una restricción más dura: debe empezar a producir salida antes de que el hablante termine una oración. Más contexto mejora la calidad de la traducción pero añade retardo, mientras que retardos más cortos obligan a hacer predicciones o traducciones parciales, y los errores son difíciles de retractar una vez que el audio ya se ha reproducido. El informe del DTIC señala que los sistemas en cascada anteriores a menudo funcionaban con retardos de cuatro a cinco segundos, acumulaban errores a lo largo de las etapas y tenían una personalización limitada, y que aumentar la anticipación de un modelo puede elevar la calidad a la vez que hace que la interacción se sienta menos inmediata. Una función de conferencia en vivo y un doblaje multilingüe pulido resuelven problemas diferentes, así que mídelos con estándares diferentes.
Cómo evaluar un flujo de trabajo de voz a voz
Prueba con una muestra representativa, no con una frase de demostración impecable. La lista de verificación de abajo refleja las condiciones reales que tu contenido encontrará y mantiene la evaluación honesta.
- Cobertura de idiomas y dialectos: "Admite español" puede no significar el acento, el vocabulario o las preferencias regionales que tu audiencia espera. Confirma las variantes de origen y destino, incluido el inglés de EE. UU. frente a otros, el español latinoamericano frente al europeo y el francés canadiense frente al europeo.
- Precisión de la transcripción: Una traducción no puede corregir de forma fiable una transcripción que distorsiona nombres, números o términos de producto. Comprueba si puedes inspeccionar y editar la transcripción antes de generar el audio.
- Significado y contexto: Prueba deliberadamente expresiones idiomáticas, chistes, llamadas a la acción, afirmaciones de producto y terminología del sector. La fluidez no es precisión.
- Gestión de hablantes: Para entrevistas, mesas redondas y películas, verifica que la herramienta pueda identificar a varios hablantes y mantener sus voces consistentes, incluso cuando las personas se interrumpen entre sí.
- Tiempos y sincronización: Las oraciones traducidas rara vez coinciden con la duración original. Busca controles de tiempo o velocidad del habla, además de ediciones de diálogo, preservación del audio de fondo, ajuste de volumen, regeneración de segmentos y alineación visual cuando sea necesario.
- Naturalidad de la voz: Escucha la pronunciación, las pausas, el énfasis, el rango emocional y el ritmo poco natural.
- Latencia: Para uso en vivo, mide el retardo entre el hablante y el audio. Para uso grabado, prioriza la flexibilidad de edición sobre la velocidad bruta de procesamiento.
- Controles de revisión y exportación: Una herramienta lista para producción te permite corregir texto, regenerar segmentos individuales, ajustar los tiempos y exportar en un formato que acepte tu flujo de trabajo de publicación.
Procesa estas muestras a través de tu lista de finalistas y compara la precisión de la transcripción, el significado de la traducción, la pronunciación, la naturalidad de la voz, la consistencia de los hablantes, los tiempos, la calidad del audio de fondo, el esfuerzo de revisión y el costo total con tu volumen esperado. El sistema más fuerte no es el que tiene más voces o idiomas. Es el que produce resultados aceptables para tu contenido específico con una carga de revisión que tu equipo pueda sostener realmente.
Riesgos y limitaciones que conviene prever
Cada etapa introduce su propio tipo de error, y una voz de sonido natural puede disimularlos todos. La IA puede traducir mal expresiones ambiguas, nombres, modismos y términos especializados, por lo que la revisión humana sigue siendo esencial dondequiera que la precisión tenga peso legal, de seguridad, financiero o de reputación. Los errores de reconocimiento agravan el problema: el ruido, la diafonía, los acentos y las grabaciones de mala calidad pueden hacer que el sistema escuche mal el origen, razón por la cual revisar la transcripción antes de aprobar la traducción no es negociable.
El significado cultural es fácil de perder. Una traducción directa puede descartar el humor, la cortesía o las referencias que solo sobreviven a una reescritura en lugar de una traducción palabra por palabra. La clonación de voz añade riesgo de consentimiento y suplantación, así que documenta quién autorizó la voz, el alcance de uso, el territorio, la duración y si puede aparecer en publicidad o declaraciones públicas sintéticas. También hay una dimensión de confianza de la audiencia: el informe del DTIC describe cómo una experiencia de traducción informa a los usuarios de que el audio traducido se genera sintéticamente, una expectativa razonable que debes prever en tus propias divulgaciones.
Dos riesgos más silenciosos completan la lista. La privacidad importa siempre que el audio contenga información personal, conversaciones confidenciales, datos de clientes o contenido no publicado, así que revisa el tratamiento de datos, la retención, el acceso y las condiciones de eliminación de un proveedor antes de subir nada. Y la falsa confianza es el fallo más insidioso de todos: una voz pulida hace que una traducción incorrecta suene con autoridad, así que nunca trates la fluidez como prueba de precisión factual.
Dónde encaja DubSmart
Somos más directamente relevantes para la traducción grabada de voz a voz mediante el Doblaje con IA, en lugar de reclamar una traducción conversacional en vivo universal. Nuestro flujo de trabajo de doblaje acepta cargas de audio y vídeo y enlaces de YouTube, admite más de 60 idiomas de origen y 33 idiomas de destino, clona la voz de cada hablante para la versión traducida y te permite editar texto, hablantes y tiempos, regenerar segmentos, ajustar el volumen del sonido de fondo y descargar el proyecto terminado. Esa capa editorial es exactamente lo que necesita la producción de medios grabados.
Para equipos que construyen sus propias canalizaciones, también ofrecemos API de Doblaje con IA, Texto a Voz y Clonación de Voz, que son adecuadas para agencias, flujos de trabajo de medios y aplicaciones que necesitan automatizar la producción de voz multilingüe. La elección correcta se reduce a si tu proyecto quiere un editor de medios terminado, una canalización impulsada por API o ambos. Para un mensaje breve y de alto riesgo, la traducción y grabación humana profesional todavía pueden ganar; para una biblioteca de contenido grande y actualizada con frecuencia, un flujo de trabajo de IA escala mejor con la revisión humana centrada en el material de mayor riesgo.
Preguntas frecuentes
¿Es la traducción de voz a voz lo mismo que la interpretación?
No. La interpretación humana se basa en una persona capacitada que escucha, comprende y transmite el significado en el momento. La traducción de voz a voz es automatizada: rápida y escalable, pero puede requerir revisión y tener dificultades con matices que un intérprete profesional maneja con naturalidad.
¿Funciona siempre en tiempo real?
No. Algunos sistemas procesan audio grabado con control total de edición, mientras que otros proporcionan salida en vivo o casi en tiempo real. Los sistemas en vivo equilibran constantemente el contexto de la traducción, la latencia y la precisión.
¿Puede preservar la voz del hablante original?
A veces. Los sistemas que usan clonación de voz o síntesis con preservación de voz pueden modelar la identidad del hablante original, pero el resultado depende de la tecnología, el par de idiomas, la calidad del audio y la autorización para usar esa voz.
¿Es el doblaje con IA una forma de traducción de voz a voz?
Sí. El doblaje con IA es una aplicación de medios grabados de la traducción de voz a voz que añade funciones de edición, gestión de hablantes, tiempos, mezcla y exportación sobre la traducción central.
¿Qué tan precisa es?
La precisión varía según el idioma, la calidad de la grabación, la terminología, el hablante y el sistema. Evalúa la transcripción, la traducción y el audio generado por separado en lugar de confiar en un único porcentaje de precisión.