Si tu micrófono capta el tráfico, las conversaciones de una cafetería o una pista musical que se sitúa justo encima del diálogo, la pregunta no es si la grabación es utilizable, sino cómo extraer la voz de nuevo de forma limpia. Eso es exactamente lo que hace un separador de voz. En términos sencillos, un separador de voz es una herramienta de audio impulsada por IA que aísla el habla humana de todo lo demás en una grabación —ruido de fondo, música y otros sonidos— para que te quede una pista de voz limpia que puedas transcribir, doblar, clonar o remezclar. Para cualquiera que produzca contenido multilingüe, esa pista limpia es la diferencia entre un doblaje que suena profesional y uno que suena «lo suficientemente bueno».
Esta guía explica qué es realmente un separador de voz, cómo funciona por dentro, cuándo lo necesitas de verdad y qué debes sopesar antes de comprometerte con una herramienta. Integramos el Separador de Voz en el flujo de trabajo de DubSmart AI precisamente porque el habla limpia es la base sobre la que se sostiene todo lo demás.
Tabla de contenidos
Qué es realmente un separador de voz
En la investigación de audio, la separación de voz se define como la tarea de separar el habla objetivo de la interferencia de fondo en una grabación mixta. Los sistemas más avanzados van más allá y separan a múltiples hablantes entre sí, produciendo una pista aislada para cada voz.
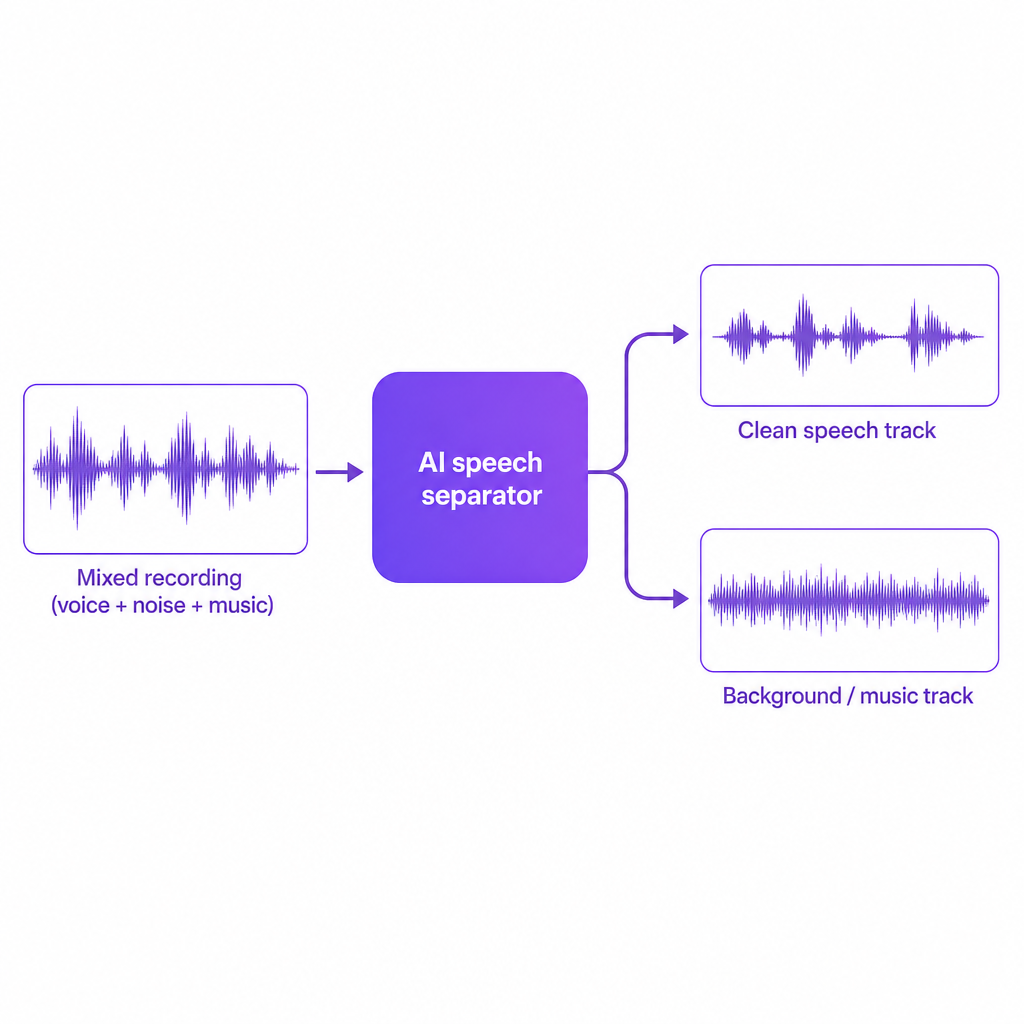
Trasladado al trabajo cotidiano de producción, un separador de voz toma un archivo de audio mixto —diálogo más ruido o música— y produce una o más pistas que contienen únicamente habla, además de una pista opcional que contiene el audio de fondo restante. Nuestro Separador de Voz está diseñado para eliminar el ruido de fondo y aislar el habla de cualquier grabación, lo que lo hace muy adecuado para la posproducción de películas, pódcasts y entrevistas. Funciona tanto con archivos de audio como de vídeo: puede eliminar el ruido de grabaciones realizadas en entornos ruidosos y separar la voz de una pista de acompañamiento para que termines con stems de voz y de fondo diferenciados.
Aquí es donde un concepto erróneo común confunde a la gente. Un separador de voz no es lo mismo que la reducción de ruido tradicional. La reducción de ruido baja el volumen del sonido no deseado. Un separador de voz identifica activamente dónde está presente el habla en la señal y la reconstruye como un flujo separado y más limpio. Esa distinción es la razón por la que un separador puede rescatar una voz enterrada bajo la música, mientras que una puerta de ruido en su mayoría solo hace que toda la grabación sea más silenciosa.
¿Realmente necesitas uno?
La verdadera decisión es si tu trabajo depende de un audio de voz limpio y fiable en lugar de lo que sea que el micrófono haya captado. Si es así, un separador dedicado deja de ser algo prescindible y se convierte en un paso fundamental.
Varias situaciones hacen que esa mejora sea evidente. Los creadores de YouTube y las pequeñas empresas a menudo reutilizan metraje antiguo grabado en habitaciones con eco, cafeterías o en la calle, donde el ruido hace que el habla sea difícil de entender y de transcribir. Los equipos de e-learning y formación construyen cursos multilingües a partir de seminarios web y conferencias en directo, donde cada transcripción y doblaje posterior hereda la calidad del habla original. Los cineastas y productores de pódcasts con frecuencia necesitan rescatar una gran actuación captada en condiciones imperfectas antes de mezclarla de nuevo con música y diseño de sonido. Y los desarrolladores o agencias que introducen audio de usuarios en flujos de transcripción, clonación de voz o doblaje saben que las entradas ruidosas reducen directamente la precisión del modelo.
Algunos desencadenantes concretos indican que vale la pena adoptar un separador:
- Estás localizando a varios idiomas y quieres un doblaje y subtítulos coherentes y claros. El habla limpia alimenta nuestros motores de Doblaje con IA y Voz a Texto de forma mucho más fiable que una mezcla ruidosa.
- Dependes de la clonación de voz para una voz de marca o de personaje y quieres los mejores resultados posibles entrenando con muestras sin ruido ni artefactos.
- Recibes regularmente grabaciones generadas por usuarios o de campo que no controlaste, y aun así necesitas que estén listas para emisión. Un separador te ofrece una etapa de limpieza repetible en lugar de ajustar cada archivo a mano.
La excepción honesta: si tu audio ya está grabado en un estudio tratado, con stems separados para diálogo y música, un separador es una comodidad más que un requisito. Para todos los demás que trabajan con sonido del mundo real, se gana un lugar permanente en el flujo de trabajo.
Cómo funciona la separación de voz por dentro
La separación de voz moderna se basa en el aprendizaje profundo y la investigación de separación de fuentes, no en simples ecualizadores y filtros. La tarea subyacente es fácil de enunciar y difícil de resolver: dada una señal mixta que contiene varias fuentes, recuperar las señales de habla individuales sin conocerlas de antemano.
La mayoría de los sistemas actuales siguen un flujo de codificador–separador–estimador–decodificador. El codificador mapea la forma de onda o el espectrograma sin procesar a un espacio de características de alta dimensión donde los patrones relevantes para el habla, como los formantes y los armónicos, resultan más fáciles de detectar. El separador —una red neuronal— procesa esas características y aprende a desacoplar la información que pertenece a diferentes fuentes de sonido, ya sea habla frente a ruido o un hablante frente a otro. La etapa de estimación entonces predice máscaras que filtran los componentes que no son de habla o estima directamente la representación de características de cada fuente. Finalmente, el decodificador convierte esas representaciones separadas de nuevo en audio en el dominio del tiempo, produciendo una o más pistas de habla limpias y, opcionalmente, una pista de fondo residual.
Estos modelos se entrenan con grandes conjuntos de datos llenos de mezclas de habla y ruido, aprendiendo los patrones discriminativos del habla, los hablantes y la interferencia a partir de ejemplos etiquetados. La investigación más reciente condiciona el separador con embeddings de hablantes o prompts, lo que permite dirigir la separación hacia una voz específica dentro de un audio saturado.
La conclusión práctica para los creadores es que un separador moderno no es una puerta de ruido glorificada. Es un modelo que ha aprendido cómo se ve y suena el habla en muchas condiciones, y puede reconstruir una voz incluso cuando está enterrada bajo música, ruido de multitud o eco de la sala.
Las dos tareas principales de separación
En la práctica te encontrarás con dos variantes de separación de voz, y las plataformas suelen combinarlas.
La primera es habla de un solo hablante frente al fondo: extraer una pista de voz coherente del ruido, la música o el ambiente. Esta es la tarea en la que se centra nuestro Separador de Voz para películas, pódcasts y entrevistas, porque se corresponde directamente con lo que la mayoría de los creadores necesita en el día a día.
La segunda es la separación de múltiples hablantes, donde el sistema produce una pista separada para cada hablante en una conversación. Esto es especialmente útil para la diarización y la analítica en reuniones o mesas redondas de larga duración, donde saber quién dijo qué importa tanto como lo que se dijo.
Las herramientas de consumo tienden a empaquetar esto en interfaces sencillas —sube una canción para obtener pistas de voz e instrumental separadas, o aísla el diálogo en un vídeo para editar—. Nuestra implementación hace hincapié en la separación de habla frente a fondo porque es la tarea de valor más inmediato para los flujos de trabajo de doblaje, transcripción y clonación.
Qué sopesar antes de elegir un separador
Cuando evalúas si un separador cumple con las necesidades profesionales, un puñado de criterios importa más que el texto de marketing.
Empieza por la calidad del habla y los artefactos. Un buen separador preserva el timbre natural de una voz en lugar de hacerla sonar metálica, como bajo el agua o con efecto de fase, y evita introducir ruido musical o distorsión brusca cuando elimina elementos de fondo fuertes como la música. Los estudios académicos señalan la interferencia residual y los artefactos como los principales desafíos, especialmente en el ruido no estacionario. La prueba más fiable sigue siendo comprobar las salidas de muestra con tu propio material.
La robustez ante el ruido del mundo real es lo siguiente. Los modelos entrenados con datos limpios de laboratorio pueden tener dificultades con el tráfico, el viento, el murmullo de la multitud, las salas reverberantes y el contenido donde el habla se superpone con música o efectos fuertes. El trabajo de vanguardia se dirige exactamente a estas mezclas complejas, pero el rendimiento sigue variando con las condiciones de grabación, así que pruébalo en los entornos en los que realmente grabas, desde oficinas hasta calles y estudios caseros.
Manejar música y contenido mixto es una necesidad frecuente y específica. Eliminar una banda sonora para redoblar, o aislar la narración del B-roll, requiere una herramienta que admita explícitamente la separación de música y voz y produzca dos archivos utilizables en lugar de un único resultado apagado. Nuestro flujo de separación detecta las frecuencias vocales, las aísla de la música y produce archivos separados de alta calidad: uno con voces limpias y otro con la pista de música. Esto es especialmente útil cuando planeas remezclar, volver a componer la banda sonora o redoblar a otros idiomas.
La integración con las herramientas posteriores decide cuánto tiempo ahorra realmente el separador. La separación rara vez vive sola: alimenta modelos de transcripción donde una entrada más limpia reduce las tasas de error de palabra, motores de clonación de voz que se benefician de muestras sin ruido y sistemas de doblaje que alinean el habla original con las pistas traducidas. Nuestra plataforma se construye en torno a un flujo de trabajo unificado que mantiene el Separador de Voz, Voz a Texto, Texto a Voz, Clonación de Voz y Doblaje con IA en un solo lugar, de modo que una única grabación limpia puede convertirse en contenido multilingüe, con voz clonada y totalmente localizado sin reconstruir un flujo de trabajo cada vez.
La latencia, la escala y la automatización importan para cualquiera con una lista de tareas pendientes. Los pódcasts, cursos y archivos de larga duración necesitan procesamiento por lotes que maneje archivos de varias horas, tiempos de procesamiento por archivo razonables y ganchos de automatización donde la separación se sitúe dentro de tus propios sistemas. Ofrecemos APIs de Texto a Voz, Clonación de Voz y Doblaje con IA para que los desarrolladores puedan integrar el procesamiento de voz en flujos de trabajo de principio a fin.
Por último, la privacidad y el cumplimiento normativo no desaparecen una vez que el audio está limpio. Separar el habla del fondo no elimina tu responsabilidad respecto a grabaciones que puedan contener conversaciones sensibles, ni respecto al respeto de los derechos cuando extraes y reutilizas voces de material con licencia. Los equipos empresariales deben confirmar políticas claras sobre la retención y el uso de datos y alinear cualquier flujo de trabajo de separación con las directrices internas de cumplimiento.
Dónde se queda corto
Un separador de voz puede transformar una grabación, pero no es magia, y fingir lo contrario lleva a malas decisiones.
El exceso de eliminación de ruido es la trampa más común. Una separación agresiva puede eliminar señales sutiles del habla —consonantes suaves, el tono natural de la sala— y dejar una voz que suena antinatural o fatigante de escuchar. Los artefactos residuales son la otra cara de la moneda: en condiciones difíciles, un modelo puede dejar rastros de música o ruido en la pista de habla, o generar ruido musical, especialmente cuando la interferencia es fuerte y cambia constantemente.
También hay que tener en cuenta el sesgo de hablante y de idioma. Los modelos entrenados predominantemente con ciertos idiomas, acentos o estilos de habla pueden rendir peor con voces subrepresentadas. Y una forma de onda de aspecto limpio puede crear una falsa sensación de seguridad: no garantiza que el audio sea adecuado para tareas críticas como el análisis forense o contextos de cumplimiento estricto.
Para el trabajo creativo y de localización, estas limitaciones son manejables, pero son un fuerte argumento a favor de probar con muestras representativas de tu propio material en lugar de confiar en las demostraciones de los proveedores.
El Separador de Voz dentro de nuestro flujo de trabajo
Tratamos el Separador de Voz como una implementación práctica y amigable para creadores de esta tecnología, estrechamente integrada con el resto de la plataforma DubSmart AI en lugar de añadida a última hora.
En uso, elimina el ruido de fondo y aísla el habla de cualquier grabación, produciendo una voz limpia adecuada para la posproducción en películas, pódcasts y entrevistas. Extrae voces claras de pistas mixtas y genera archivos separados de alta calidad para el habla y la música de fondo, de modo que puedas editar, redoblar o remezclar sin luchar contra la mezcla original. Funciona tanto con fuentes de audio como de vídeo: subes archivos o usas enlaces, los pasas por el flujo de trabajo y descargas las pistas terminadas. Y, fundamentalmente, esas salidas están optimizadas para alimentar nuestras otras herramientas, de modo que una grabación limpia puede convertirse en contenido multilingüe, con voz clonada y totalmente localizado.
Para creadores de YouTube, pequeñas empresas, formadores, cineastas, podcasters y equipos de desarrolladores, esa integración cambia el papel de la separación en sí misma. Deja de ser una tarea aislada de «arreglar el audio» y se convierte en el primer paso estandarizado de un ciclo de vida más amplio y automatizado de creación y localización de contenido. Si estás construyendo un canal o una biblioteca de cursos multilingüe, ahí es donde se acumula el verdadero ahorro de tiempo.
Preguntas frecuentes
¿Qué es un separador de voz, en términos sencillos?
Es una herramienta de IA que toma una grabación ruidosa y mixta y produce una pista donde en su mayoría solo escuchas la voz humana, más pistas de fondo opcionales que puedes conservar o descartar.
¿Un separador de voz es lo mismo que la reducción de ruido?
No. La reducción de ruido simplemente baja los sonidos no deseados. La separación de voz identifica y reconstruye explícitamente el habla como una fuente distinta, normalmente con mayor claridad y más control sobre el resultado.
¿Puede un separador de voz manejar más de un hablante?
Muchos sistemas de nivel investigación y algunos productos pueden separar a múltiples hablantes en pistas individuales, aunque la calidad varía con la superposición y las condiciones de grabación. Nuestro Separador de Voz se centra principalmente en aislar el habla del fondo para los flujos de trabajo comunes de creadores.
¿Usar un separador de voz mejorará mis resultados de doblaje y clonación de voz?
Sí. Un audio de entrada más limpio generalmente mejora el reconocimiento de voz, la alineación y la calidad de la clonación de voz, lo que hace que el doblaje multilingüe y las voces clonadas sean más naturales y coherentes.
¿Funciona la separación de voz independientemente del idioma?
La mayoría de los modelos de separación operan sobre patrones acústicos en lugar de texto, por lo que pueden manejar muchos idiomas. El rendimiento sigue dependiendo de los datos de entrenamiento y de lo bien representado que esté tu acento.