Un cambiador de voz con IA en tiempo real convierte tu voz en otra voz mientras hablas, capturando el audio del micrófono, analizándolo, transformando la identidad del hablante y reproduciendo el audio convertido con un breve retardo. A diferencia de un filtro básico de cambio de tono, puede mantener intactas gran parte de tus palabras, el ritmo y la expresión, mientras cambia cualidades como el timbre, la edad percibida, la presentación de género o el estilo del personaje. Y a diferencia del texto a voz, parte del habla en directo en lugar de texto escrito.
La verdadera decisión para creadores, streamers, educadores y empresas no es simplemente si el resultado suena realista. Es si la herramienta se ajusta a tu tipo de entrada, tolerancia a la latencia, necesidades de control de voz, integraciones, obligaciones de derechos y calidad de producción objetivo. Esta guía explica cómo funciona la tecnología, dónde encaja frente a herramientas de voz con IA relacionadas y cuándo un flujo de trabajo grabado te sirve mejor.
Tabla de contenidos
Qué significa realmente "tiempo real"
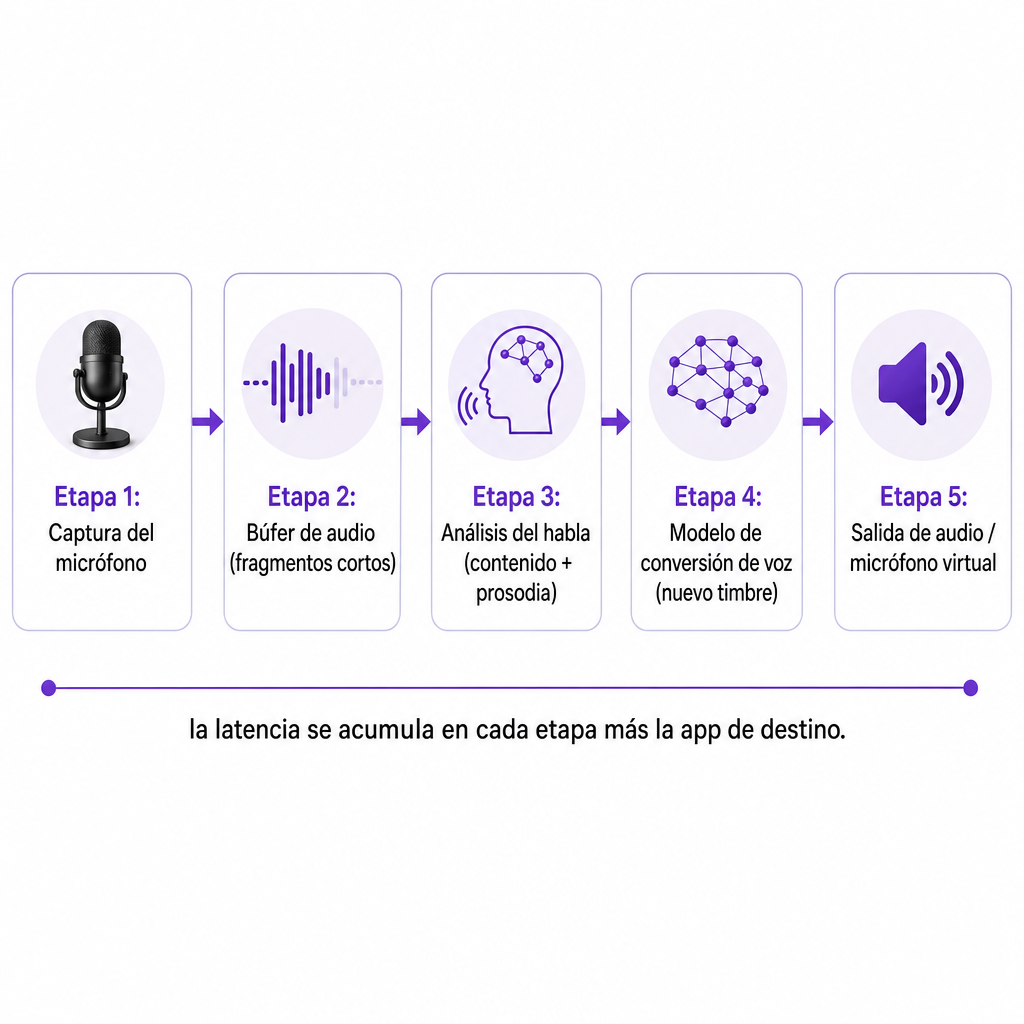
"Tiempo real" significa que el sistema procesa un flujo de audio entrante mientras hablas en lugar de esperar a una grabación completa o un guion terminado. La señal recorre un camino continuo: micrófono, búfer de audio, análisis del habla, modelo de conversión de voz, salida de audio. Debido a que el convertidor trabaja sobre segmentos cortos en lugar de frases completas, la conversión de voz por streaming es técnicamente distinta de renderizar una locución terminada en la que todo el guion se conoce de antemano.
Cierto retardo es inevitable. El sistema necesita tiempo para capturar, analizar, sintetizar y emitir cada fragmento de audio. La investigación demuestra que la conversión de baja latencia es alcanzable, aunque las cifras dependen mucho del modelo, el hardware, el tamaño del búfer y la calidad del audio. El modelo de investigación LLVC reporta una latencia inferior a 20 milisegundos en una CPU de consumo, mientras que StreamVC reporta una latencia de extremo a extremo de 70,8 milisegundos en su entorno de evaluación. Estos son resultados de investigación bajo condiciones específicas, no garantías de rendimiento para ninguna herramienta comercial que puedas descargar.
Cómo funciona un cambiador de voz con IA en tiempo real
El proceso funciona como un bucle mientras hablas, no como un único renderizado. Comprender las cuatro etapas te ayuda a juzgar por qué una herramienta suena natural y otra suena robótica o con retardo.
Primero, el sistema captura tu habla. Recibe audio de un micrófono u otra entrada en directo y lo divide en fragmentos cortos para que el modelo pueda procesarlo de forma continua. La calidad de la entrada importa más de lo que muchos usuarios esperan. El ruido de fondo, el eco de la sala, el repiqueteo del teclado, el recorte (clipping) y una señal inestable empujan la conversión hacia artefactos poco naturales.
Segundo, separa el contenido del habla de la identidad del hablante. Una voz lleva varias capas superpuestas a la vez: el contenido lingüístico, o palabras; la prosodia, es decir, el ritmo, el énfasis y la entonación; el tono; el timbre que hace reconocible una voz; y la identidad más amplia del hablante. Los sistemas de conversión intentan preservar el contenido y la expresión mientras reemplazan las características del hablante. La investigación moderna sobre streaming describe esto como mantener el contenido y la prosodia del habla fuente mientras se iguala el timbre vocal de un hablante objetivo. Esa separación es la razón por la que un buen convertidor te permite hablar espontáneamente en una voz transformada en lugar de aplicar un filtro fijo de "robot" sobre la forma de onda.
Tercero, el modelo sintetiza una nueva voz. Reconstruye el audio usando un perfil de voz objetivo, que podría ser un personaje integrado, una voz de biblioteca, una voz personalizada creada a partir de grabaciones autorizadas, o un perfil diseñado para la anonimización en lugar de la imitación. La salida se produce de forma continua con un pequeño búfer de anticipación. Más contexto puede mejorar la estabilidad, pero también añade retardo, que es el compromiso central de la conversión en directo.
Cuarto, la señal convertida se enruta hacia una aplicación. Una herramienta de escritorio normalmente expone la salida como un micrófono virtual, de modo que otros programas la reciben como si fuera un micrófono normal. Ese enrutamiento es lo que hace posibles las transmisiones en directo, los juegos en línea, las videollamadas, los chats de voz y los eventos virtuales. Por tanto, un cambiador en tiempo real tiene que funcionar a nivel del sistema operativo y de la aplicación, no solo dentro del modelo. La compatibilidad con software de streaming, Discord, Zoom, navegadores y dispositivos móviles puede importar tanto como la calidad bruta de la voz. Si quieres extraer texto limpio de ese mismo audio capturado para subtítulos o reutilización, un paso independiente de voz a texto se encarga de la transcripción en lugar de la conversión.
Conversión en tiempo real frente a herramientas de voz con IA relacionadas
Estas tecnologías se solapan en la mente de la gente, pero resuelven problemas genuinamente diferentes. La siguiente tabla aclara qué toma cada una como entrada y cuándo llega la salida.
| Tecnología | Entrada | Momento de la salida | Más adecuado para |
|---|---|---|---|
| Cambiador de voz en tiempo real | Habla en directo por micrófono | Durante la conversación | Llamadas en directo, juegos, streaming, actuación |
| Texto a voz | Texto escrito | Después de enviar el texto | Narración, tutoriales, anuncios, e-learning |
| Clonación de voz | Muestras de voz | Generada bajo demanda | Voz sintética reutilizable para narración o doblaje |
| Doblaje con IA | Audio o vídeo existente | Después del procesamiento | Traducir y localizar contenido grabado |
| Efecto de tono o formante | Audio en directo o grabado | En directo o casi en directo | Modificación creativa simple de la voz |
Esa distinción es práctica, no académica. Una plataforma puede ofrecer una sólida generación de voz con IA o clonación de voz sin ofrecer un cambiador de micrófono en directo para llamadas y transmisiones. Nuestras propias herramientas se centran en medios generados y localizados: ofrecemos Texto a Voz, Clonación de Voz, Doblaje con IA, Voz a Texto, Separador de Voz, Texto a Imagen e Imagen a Vídeo dentro de un solo flujo de trabajo. Están diseñadas para producir audio a partir de texto o construir una voz reutilizable para contenido generado, por lo que pertenecen al lado del flujo de trabajo grabado de esta tabla en lugar de a la conversión de micrófono en directo.
Para qué sirve la conversión de voz en directo
Los streamers y gamers recurren a la conversión de voz para mantener un personaje, proteger la privacidad o conservar una persona de canal coherente. La baja latencia importa más aquí, porque estás reaccionando a otros jugadores y hablando con una audiencia. Un pequeño retardo es tolerable en un monólogo de estilo emisión, pero se vuelve evidente durante charlas rápidas, juego competitivo o la sincronización cómica.
En reuniones en línea y eventos virtuales, una voz convertida puede apoyar juegos de rol, demostraciones, escenarios de accesibilidad o participación consciente de la privacidad. Para entornos profesionales, la inteligibilidad y la fiabilidad deberían prevalecer sobre la novedad, y a los participantes se les debería informar cuando una voz está transformada si el silencio pudiera inducirlos a error.
La interpretación de personajes es otro uso en directo. Cineastas independientes, desarrolladores de videojuegos y podcasters pueden hacer pruebas de voces de personajes o interpretar diálogos temporales sobre la marcha. No obstante, para la entrega final, una locución con IA grabada o una interpretación humana suele dar mejor control de edición y coherencia entre sesiones.
La privacidad y anonimización de la voz es un objetivo distinto de la imitación. La anonimización intenta ocultar quién está hablando, mientras que la imitación intenta reproducir una identidad objetivo específica. Ninguna es infalible, y una voz transformada todavía puede filtrar hábitos del habla, formas de expresión o sonidos de fondo que ayudan a identificar al hablante.
Finalmente, la tecnología de voz sintética apoya la accesibilidad y la comunicación asistida para personas que han perdido la capacidad de hablar. La Comisión Federal de Comercio reconoce este beneficio médico y de accesibilidad, al tiempo que advierte que la replicación de voz puede ser objeto de abuso para fraude y uso indebido de datos biométricos.
Los criterios de decisión que realmente importan
La latencia va primero, y deberías pedir la latencia de extremo a extremo medida, no solo la velocidad de inferencia del modelo. El retardo que realmente sientes incluye la captura del micrófono, el almacenamiento en búfer, la extracción de características, la inferencia del modelo, la síntesis, el enrutamiento de salida y lo que sea que la aplicación de llamada o streaming añada encima. Un modelo que marca buenos resultados en pruebas aisladas puede sentirse lento una vez que se ensambla el camino completo.
La naturalidad es la siguiente prueba. Escucha por artefactos metálicos, saltos tonales repentinos, problemas de respiración y pronunciación, pausas poco naturales, consonantes distorsionadas, fallos en los límites de las frases y pérdida de expresión emocional. Una voz convincente debería permanecer comprensible durante el habla espontánea, no solo durante líneas de demostración leídas con cuidado.
La preservación del contenido del habla es fácil de pasar por alto hasta que falla. Prueba el habla rápida, las interrupciones, los números, los nombres, los acentos, la risa, las preguntas y los cambios de volumen. Una herramienta que cambia la identidad pero aplana tu ritmo y entonación es una mala opción para la interpretación o la interacción en directo.
La selección de voz y la personalización determinan hasta dónde puedes moldear el resultado. Comprueba si hay voces integradas, creación de voz personalizada, controles de tono y timbre, opciones de emoción o estilo, elecciones de acento, coherencia entre sesiones y cualquier restricción de uso comercial. La creación de voz personalizada siempre debería requerir una autorización clara: una muestra de voz no es permiso para imitar a la persona de la que proviene.
El soporte de hardware y plataforma decide si la herramienta encaja en tu configuración en absoluto. Confirma si funciona localmente en CPU o GPU, en un navegador, a través de una aplicación de escritorio, en móvil, mediante un micrófono virtual o a través de una API. El procesamiento en la nube puede simplificar la configuración, pero introduce latencia de red y cuestiones de gobernanza de datos, mientras que el procesamiento local puede reducir el retardo de red pero exigir hardware más capaz. Por separado, verifica el enrutamiento de audio: un modelo potente es inútil si su salida no puede seleccionarse como micrófono en tu aplicación prevista.
El manejo de datos cierra la lista. Antes de subir cualquier muestra de voz, revisa si las grabaciones se conservan, si alimentan la mejora del modelo, cómo se eliminan las voces personalizadas, quién puede acceder a los archivos, si existen controles empresariales o corporativos, y qué ocurre con el audio generado después. Las grabaciones de voz pueden ser datos personales sensibles o relacionados con biometría según el contexto y la ley aplicable, así que trátalas como tales.
Cuándo un flujo de trabajo grabado supera al tiempo real
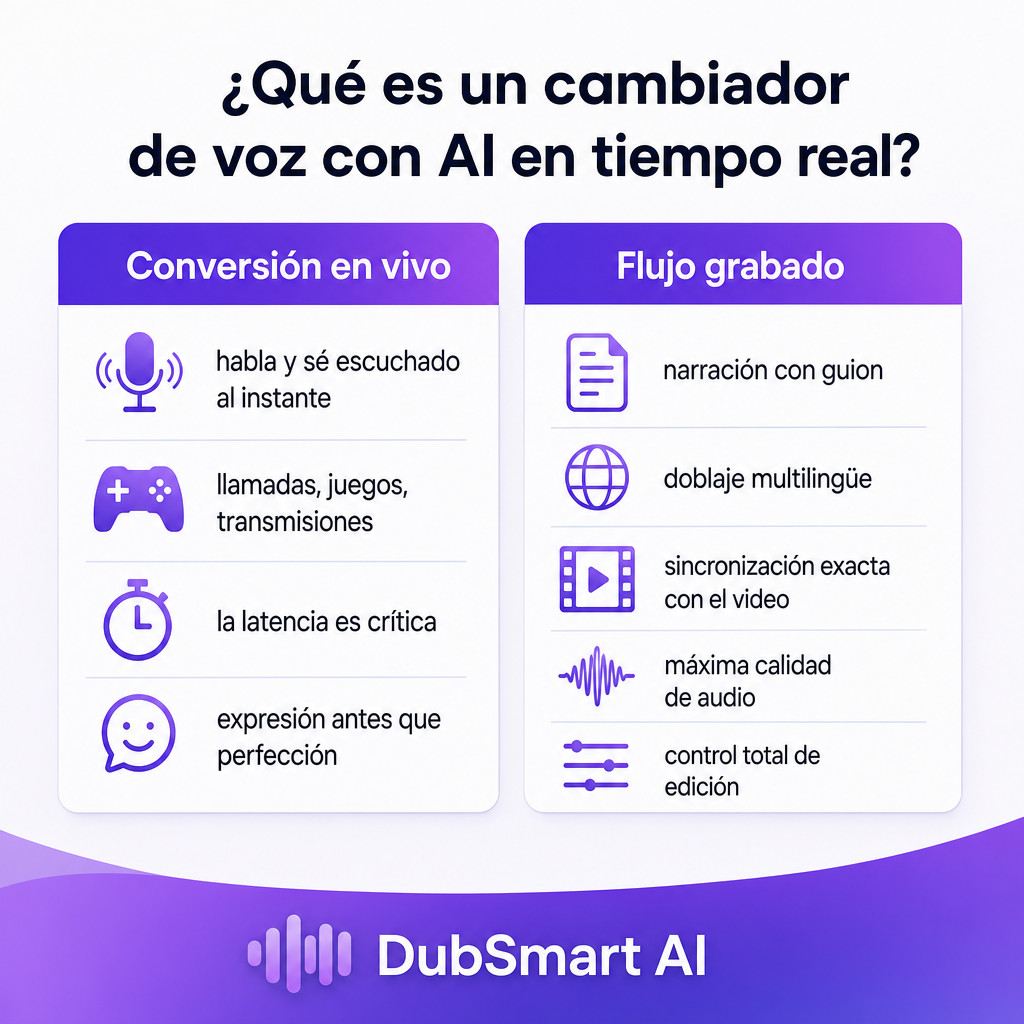
La conversión en directo es la opción adecuada cuando una persona necesita hablar con naturalidad y que la voz transformada se escuche de inmediato. Es la opción equivocada cuando tu prioridad es la máxima calidad de audio, la pronunciación precisa, la narración multilingüe, la sincronización exacta con el vídeo, la edición detallada, una locución comercial coherente o un doblaje de alta calidad.
Para esos objetivos, gana un flujo grabado. Con el texto a voz, controlas y refinas el guion antes de generar cualquier audio, lo que elimina por completo el problema de latencia en directo. Con el doblaje con IA, el sistema procesa un vídeo existente y alinea el habla traducida con la fuente, algo que ningún cambiador en directo puede hacer. Si tu archivo fuente mezcla diálogo con música o ruido, un separador de voz puede aislar una pista de voz limpia antes de procesarla. Nuestro Doblaje con IA está diseñado para traducir audio o vídeo grabado a los idiomas de destino admitidos, no para convertir una señal de micrófono en directo.
Riesgos y uso responsable
La suplantación y el fraude son el riesgo principal. Una voz convertida realista puede hacer más creíble una identidad falsa, y la FTC advierte que los sistemas de clonación de voz se usan en estafas familiares, suplantación de empresas, extorsión y otros fraudes, junto con riesgos para los artistas de voz cuyas voces pueden ser apropiadas. No uses la voz reconocible de una persona real sin autorización, y nunca presentes una voz generada o convertida por IA como prueba de que una persona específica habló.
El consentimiento y los derechos de voz vienen directamente a continuación. Obtén permiso antes de clonar o imitar deliberadamente la voz de otra persona, y guarda un registro de ese permiso, especialmente para proyectos comerciales, publicidad, formación, juegos o medios públicos. El material de la FTC citado aquí analiza los daños, la aplicación de la ley y las soluciones propuestas en lugar de establecer una única regla de consentimiento para cada uso, por lo que las obligaciones específicas pueden depender de la jurisdicción, el contrato, la plataforma y el caso de uso. Ante la duda, verifica para tu situación.
La divulgación es sensata siempre que una audiencia pueda creer razonablemente que una persona real está hablando en directo. Un breve aviso de que la voz es generada por IA o convertida reduce la confusión. La seguridad también importa: protege las muestras de voz y los archivos de voz personalizada como otros activos sensibles, limita el acceso, evita subir grabaciones sin permiso y elimina los perfiles de voz no utilizados donde el servicio lo permita. Finalmente, planifica para los fallos de calidad. La latencia, el audio cortado y los artefactos de conversión pueden descarrilar una conversación, así que prueba toda la configuración con el micrófono, los auriculares, la aplicación, la red y el hardware reales antes de salir en público.
Dónde encajan nuestras herramientas en tu proyecto de voz
Presentamos un flujo de trabajo de medios con IA integrado en lugar de un producto de cambiador de voz de micrófono en directo. En nuestra plataforma puedes generar habla a partir de texto, elegir entre más de 300 voces, crear voces clonadas a partir de una muestra breve y usar esas voces en proyectos de Texto a Voz y Doblaje con IA. Admitimos el doblaje desde más de 60 idiomas de origen a 33 idiomas de destino, lo que nos convierte en una gran opción cuando el trabajo consiste en crear una locución a partir de un guion, producir habla con una voz personalizada, doblar audio o vídeo grabado, o localizar contenido para audiencias multilingües.
Para desarrolladores, publicamos páginas de API separadas para Texto a Voz, Clonación de Voz y Doblaje con IA. Estos son flujos de trabajo de generación y localización. Si tu proyecto necesita específicamente un cambiador de voz de micrófono en directo, confirma que la entrada de streaming en tiempo real, el enrutamiento de salida, los objetivos de latencia y el soporte de sesiones en directo estén documentados explícitamente antes de comprometerte con cualquier API, la nuestra o la de otros.
Si estás sopesando la conversión en directo frente a un flujo grabado y no estás seguro de qué camino encaja con tu contenido, dinos tu formato de origen, los idiomas de destino y si necesitas salida en directo o pregrabada, y te indicaremos el flujo de trabajo adecuado.
Preguntas frecuentes
¿Es un cambiador de voz con IA en tiempo real lo mismo que el texto a voz?
No. Un cambiador de voz en tiempo real transforma el habla en directo del micrófono mientras hablas, mientras que el texto a voz genera nuevo habla a partir de texto escrito que envías primero. Nuestro Texto a Voz está diseñado para generar habla a partir de texto, no para la conversión de micrófono en directo.
¿Un cambiador de voz con IA en tiempo real tiene retardo cero?
No. Todo sistema necesita tiempo para capturar y procesar el audio, por lo que cierta latencia es inevitable. El retardo práctico depende del modelo, el dispositivo, la configuración del búfer, la red y la aplicación de destino, y los sistemas de investigación reportan cifras diferentes bajo distintas condiciones de prueba.
¿Puede un cambiador de voz con IA copiar la voz de una celebridad?
Algunos sistemas pueden técnicamente imitar voces reconocibles, pero la capacidad técnica no es permiso. Evita la suplantación no autorizada y revisa los contratos relevantes, las reglas de la plataforma y las leyes antes de usar la voz de cualquier persona reconocible.
¿Qué debería usar para crear vídeos multilingües de YouTube?
Para vídeos pregrabados, el doblaje con IA generalmente encaja mejor que un cambiador de voz en directo porque procesa el vídeo existente y produce audio localizado y alineado. Nuestro Doblaje con IA traduce y dobla audio o vídeo grabado a los idiomas admitidos.
¿Puede vuestra plataforma cambiar mi voz en directo durante una llamada?
Nuestra plataforma documenta Texto a Voz, Clonación de Voz y Doblaje con IA en lugar de la conversión de voz de micrófono en directo. Si estás planificando un flujo de trabajo de llamada en directo, confirma primero con nosotros la documentación actual del producto para que podamos recomendarte el enfoque adecuado.