Si estás considerando voiceforge text to speech para un proyecto, la verdadera pregunta rara vez es si las voces suenan interesantes. Es si la herramienta se ajusta a la longitud de tu guion, tus derechos de publicación y el tipo de contenido que realmente creas. VoiceForge es un servicio de texto a voz basado en navegador construido en torno a voces de personajes distintivas. Convierte un guion en audio descargable mediante un motor de síntesis por selección de unidades que une segmentos de habla grabados de hablantes humanos en lugar de generar cada sonido a partir de una sola forma de onda matemática. La decisión práctica se reduce a cuatro necesidades: una voz divertida y reconocible para proyectos personales; audio con licencia para medios monetizados; control preciso sobre la pronunciación y el ritmo; o un flujo de trabajo multilingüe escalable. Solo las tres primeras encajan limpiamente con un generador de voces de personajes, y esa brecha es donde la mayoría de los creadores se tropiezan.
Publicamos esta guía porque la misma confusión aparece una y otra vez: la gente genera audio en una prueba gratuita, asume que puede monetizarlo y luego descubre que la licencia está vinculada a un plan específico. A continuación, desglosamos cómo funciona el motor, qué puede y qué no puede hacer, y cuándo una herramienta de novedad de una sola voz es la opción correcta frente a un flujo de trabajo de localización completo.
Tabla de contenidos
Qué es realmente VoiceForge text to speech
VoiceForge convierte palabras escritas en audio hablado: introduces un guion, eliges una voz, generas el clip, lo previsualizas y descargas el resultado cuando tu plan lo permite. Lo que lo diferencia de una biblioteca de narración general es su orientación. VoiceForge se inclina hacia voces con personalidad en lugar de una entrega corporativa neutra, lo que lo convierte en una opción natural para sketches de YouTube, clips de videojuegos, personajes animados, memes, anuncios de novedad y proyectos musicales.
Ese enfoque centrado en los personajes es una ventaja para cierto contenido y una desventaja para otros. Una voz cómica o deliberadamente sintética puede sostener una parodia o un NPC de un juego, pero esa misma voz se vuelve molesta en un curso de e-learning, una demostración de producto o un anuncio de marca premium. Así que el primer filtro no es "¿suena esto humano?". Es "¿pertenece esta voz frente a mi audiencia específica?".
Si aún estás decidiendo si un generador de voces de stock se adapta a tus necesidades en absoluto, nuestra explicación sobre qué hace un generador de voz con IA cubre la categoría más amplia y cómo estas herramientas se diferencian de la clonación y el doblaje.
Cómo el motor de selección de unidades construye una voz
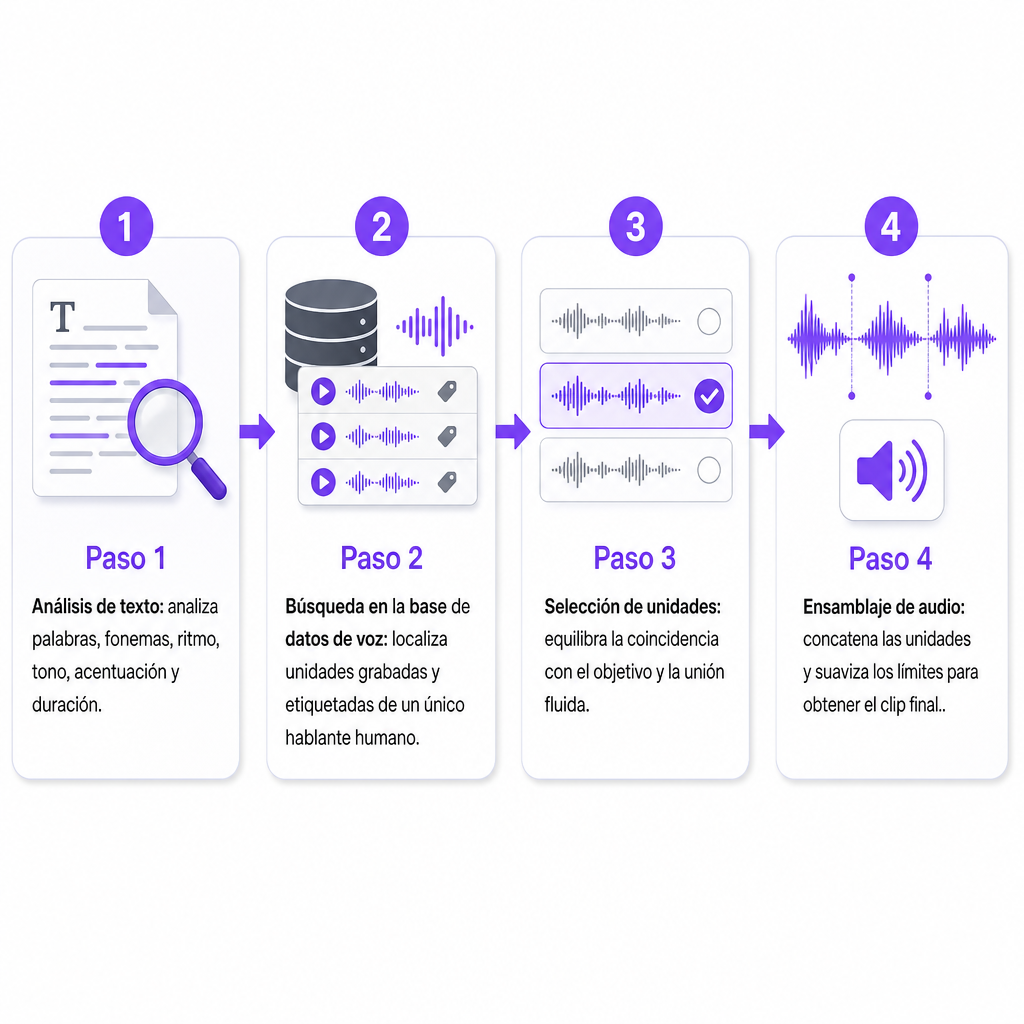
VoiceForge utiliza síntesis por selección de unidades, también llamada síntesis concatenativa. En lugar de generar una grabación completa a partir de una sola forma de onda producida por un modelo, el sistema busca en una base de datos de segmentos de habla grabados y une las piezas que mejor encajan en tu frase. Entender esta cadena de procesamiento explica tanto por qué las voces suenan reconocibles como por qué se comportan de la manera en que lo hacen bajo presión.
El proceso se desarrolla en unas pocas etapas. Primero, el análisis de texto: el motor analiza palabras, estructura de oraciones, fonemas, ritmo, tono, acento y duración para decidir cómo debe pronunciarse una línea. A continuación, una búsqueda en la base de datos de voces: cada voz se construye a partir de las grabaciones de un hablante humano, troceadas en unidades más pequeñas y etiquetadas por sonido y contexto. Luego la selección de unidades, donde el motor equilibra dos objetivos en competencia a la vez: la coincidencia con el objetivo, que elige una unidad con el sonido, tono, duración y contexto correctos, y la unión suave, que favorece las unidades vecinas que se conectan sin una costura evidente. Finalmente, el ensamblaje de audio une la secuencia elegida y aplica un suavizado ligero en los límites.
Debido a que la salida se ensambla a partir de grabaciones reales, cada voz conserva una identidad distintiva. La contrapartida es que este método no fue diseñado para ofrecer una dirección emocional ilimitada ni la entrega completamente ajustable asociada con los sistemas generativos más nuevos. Un fraseo inusual, cambios rápidos o combinaciones de pronunciación extrañas pueden exponer las uniones entre unidades, produciendo resultados que suenan menos consistentes que una toma humana continua. Si quieres ver en qué se diferencia una cadena totalmente generativa, nuestro desglose de cómo funciona el texto a voz neuronal recorre el enfoque de aprendizaje profundo que reemplaza la concatenación.
Voces, SSML y el límite de 500 caracteres
VoiceForge enumera 42 voces únicas, cada una grabada por un hablante diferente con su propio timbre y estilo de habla. Eso es suficiente cuando la voz en sí es parte del concepto creativo: un narrador cómico para un corto, una personalidad extraña para un vídeo de juegos, un tono sintético para un meme. Es un catálogo más pequeño, sin embargo, para equipos que necesitan muchas variantes regionales o un narrador cuidadosamente ajustado en varios mercados.
Para el control de la entrega, VoiceForge admite un subconjunto del Lenguaje de Marcado de Síntesis de Voz (SSML). En lugar de depender solo de la puntuación, incrustas instrucciones directamente en el guion.
| Control SSML | Qué hace |
|---|---|
<break> |
Inserta una pausa |
<emphasis> |
Enfatiza una palabra o frase |
<prosody> |
Ajusta el tono, la velocidad de habla o el volumen |
<phoneme> |
Fuerza una pronunciación exacta |
<sub> |
Pronuncia un sustituto del texto visible |
<p> / <s> |
Marca un párrafo o una oración |
Estas etiquetas se ganan su lugar cuando el motor lee mal un nombre de producto, un acrónimo o un término técnico. Envolver una abreviatura en <sub alias="application programming interface">API</sub> hace que se pronuncie la frase completa, y <phoneme> fija un nombre complicado. Un <break time="500ms"/> entre líneas añade una pausa deliberada donde la puntuación no lo haría.
Aquí está la trampa que reconfigura la forma en que escribes para él: la entrada de texto está limitada a 500 caracteres, y el marcado SSML cuenta para ese límite. Cada etiqueta que añades consume el espacio disponible para las palabras reales. La narración larga tiene que dividirse en varias generaciones, y el marcado abundante reduce aún más cada fragmento. En la práctica, eso significa planificar tu guion en pasajes cortos y autónomos en lugar de pegar una página completa.
Prueba gratuita frente a licencia comercial: la decisión que importa
VoiceForge ofrece una prueba gratuita limitada, pero una prueba no es una licencia de publicación. Sus planes trazan una línea clara entre el uso personal y el comercial, y esa línea es donde ocurren la mayoría de los errores.
El nivel Fan Voice está pensado para bromas, vídeos, juegos, animaciones y memes que no están monetizados. El plan Publisher es la suscripción que otorga una licencia comercial para audio TTS en contenido monetizado o comercial —vídeos monetizados, juegos indie y música— y anuncia descargas ilimitadas. La prueba gratuita existe para que puedas probar el servicio antes de comprometerte.
La regla operativa es simple: si un proyecto genera dinero, promociona un negocio, aparece en medios monetizados o se comercializa, confirma el plan aplicable antes de publicar. El audio que generas durante una prueba gratuita no conlleva automáticamente derechos comerciales solo porque se haya descargado. El lenguaje de licencia también puede cambiar, por lo que la página del plan es un punto de partida, no un sustituto de una revisión específica del proyecto cuando hay mucho en juego: una entrega para un cliente, un anuncio pagado, una campaña de marca o el lanzamiento de una app.
Fortalezas y limitaciones para proyectos reales
Las fortalezas de VoiceForge se concentran en la personalidad y la simplicidad. Las voces de personajes destacan cuando el timbre es parte de la broma o de la marca de un canal. Debido a que la base es habla humana grabada, las voces conservan características vocales naturales y una identidad reconocible. Los controles de pronunciación SSML te dan verdadera influencia sobre acrónimos, nombres y términos extraños. Y el plan Publisher hace que la cuestión del uso comercial sea más explícita que en herramientas que separan el acceso a la generación de los detalles de licencia.
Las limitaciones son igual de concretas. El límite de 500 caracteres obliga a dividir los guiones largos en muchas generaciones pequeñas, y el marcado hace que cada una sea más corta. El catálogo de 42 voces es modesto junto a bibliotecas grandes, lo cual importa si necesitas cientos de opciones o muchos acentos regionales. El estilo centrado en los personajes que brilla en el entretenimiento puede perjudicar el contenido legal, médico, instructivo o de marca premium. Las restricciones de plan son fáciles de pasar por alto, ya que la capacidad de generar audio no es lo mismo que el derecho a monetizarlo. Y debido a que el motor une unidades grabadas, ciertos fraseos pueden revelar artefactos de costura que una grabación continua no mostraría.
Ninguno de estos es descalificante por sí solo. Simplemente definen el punto óptimo: clips cortos, impulsados por la personalidad, en un solo idioma, donde la voz es lo que importa.
Cuándo encaja una voz de personaje y cuándo gana un flujo de trabajo de localización
VoiceForge es la elección correcta cuando la personalidad de la voz es central, tus guiones se dividen limpiamente en secciones cortas, necesitas un control básico de pronunciación y ritmo, y estás produciendo vídeos, memes, animaciones, música o contenido de juegos indie, ya sea personal (Fan Voice) o monetizado con la suscripción adecuada.
Un flujo de trabajo más amplio te sirve mejor cuando necesitas un narrador neutro pulido, muchos idiomas y acentos, tu propia voz clonada, narración de formato largo, actualizaciones comerciales frecuentes, integración con API o voces consistentes en un catálogo grande donde la novedad importa menos que la fiabilidad. Un canal que se expande internacionalmente ilustra bien la división: VoiceForge podría proporcionar la voz del personaje para un sketch en inglés, mientras que una configuración de TTS y doblaje multilingüe produce las versiones localizadas para otras audiencias.
Ese segundo escenario es en el que nos enfocamos. Nuestra herramienta de texto a voz ofrece más de 300 voces con IA, locuciones multilingües, controles de velocidad de habla y proyectos descargables creados para producción en lugar de novedad puntual. Los creadores que quieren mantener su propia identidad en cada vídeo pueden usar Clonación de Voz en lugar de conformarse con un personaje de stock, y los desarrolladores que necesitan generación de voz dentro de una app pueden construir sobre nuestra API de Texto a Voz. Cuando el objetivo es convertir un solo clip en un lanzamiento localizado completo, el Doblaje con IA lleva el mismo guion a idiomas adicionales en un solo lugar.
Una lista de verificación de calidad antes de publicar
Antes de publicar audio de VoiceForge, haz una revisión rápida de las cosas que fallan con más frecuencia. Generar primero pasajes de prueba cortos vale los pocos minutos extra, porque una voz que funciona en una sola frase puede volverse cansina o molesta a lo largo de un vídeo completo.
- Pronunciación: ¿Se pronuncian correctamente los nombres, abreviaturas, números y términos técnicos?
- Ritmo: ¿Caen las pausas de forma natural, no a mitad de frase?
- Consistencia del personaje: ¿La misma voz encaja en cada escena, no solo en la apertura?
- Transiciones de audio: ¿Hay saltos audibles entre clips generados por separado?
- Licencia: ¿Tu plan actual realmente cubre el uso monetizado o comercial?
- Adecuación a la audiencia: ¿Es el estilo del personaje apropiado para la plataforma y el tema?
- Alineación: ¿El audio se ajusta limpiamente con tu vídeo, música o diálogo de juego?
- Derechos: ¿Tienes permiso para cualquier guion, nombre o referencia de terceros incluido en el audio?
Preguntas frecuentes
¿Qué es VoiceForge text to speech?
Es un servicio basado en navegador que convierte texto escrito en audio hablado utilizando una biblioteca de voces de personajes distintivas. Se basa en la síntesis por selección de unidades, que ensambla segmentos de habla grabados de bases de datos de voces humanas en lugar de generar audio a partir de una sola forma de onda de un modelo.
¿VoiceForge está generado por IA?
Es un servicio de síntesis de voz, pero su método documentado es la selección de unidades, no un sistema de voz neuronal totalmente generativo. El motor selecciona y une unidades de habla humana grabadas para producir cada enunciado.
¿Cuántas voces de VoiceForge están disponibles?
VoiceForge enumera 42 voces únicas, cada una asociada con un hablante y una personalidad vocal diferentes.
¿Cuál es el límite de caracteres de VoiceForge?
El servicio documenta un límite de 500 caracteres por entrada de texto, y cualquier marcado SSML que añadas cuenta para ese límite. Los guiones más largos deben dividirse en varias generaciones.
¿Puedo usar audio de VoiceForge en YouTube?
Puedes, pero el contenido monetizado requiere la suscripción comercial adecuada. El plan Publisher se describe como la licencia para audio TTS utilizado en contenido monetizado o comercial, así que confirma tu plan antes de publicar un vídeo monetizado.
¿Es VoiceForge lo mismo que la clonación de voz?
No. VoiceForge usa su biblioteca de voces existente, mientras que la clonación de voz crea una voz sintética personalizada a partir de grabaciones autorizadas de un hablante específico. Explicamos ese flujo de trabajo separado en nuestra página de Clonación de Voz.