Pregunta cómo funciona la síntesis de voz neuronal y la respuesta corta es esta: convierte el texto escrito en audio realista al pasar tu guion a través de redes neuronales profundas que modelan cómo hablan realmente los humanos—pronunciación, ritmo y entonación en conjunto. En lugar de unir fragmentos pregrabados como lo hacían los sistemas antiguos, la síntesis de voz neuronal genera el habla desde cero, aprendiendo patrones directamente de grandes conjuntos de datos de grabaciones humanas reales emparejadas con texto. Esa distinción es la razón por la que las voces sintéticas modernas suenan como un narrador que podrías escuchar durante un video completo en lugar de un anuncio robótico. En DubSmart AI, nos basamos en este mismo enfoque neuronal para impulsar nuestra Síntesis de Voz, conectándola con la clonación de voz y el doblaje para que un solo guion pueda viajar de un idioma a muchos.
Esta guía recorre el mecanismo etapa por etapa, y luego lo traduce en decisiones prácticas: dónde una voz neuronal es lo suficientemente fuerte como para valerse por sí misma, dónde aún deseas una interpretación humana y cómo encajan las piezas dentro de nuestra plataforma.
Tabla de contenidos
Qué significa realmente "cómo funciona la síntesis de voz neuronal"
La síntesis de voz neuronal es una forma de síntesis del habla que utiliza redes neuronales profundas para generar el habla desde cero. La clave que la diferencia de los métodos basados en reglas o concatenativos es que el sistema aprende de grandes conjuntos de datos de grabaciones humanas emparejadas con texto, por lo que puede predecir tanto cómo deben sonar las palabras como la forma en que una persona las pronunciaría naturalmente. Ese comportamiento aprendido es lo que captura la prosodia—acento, ritmo, pausas y tono emocional—haciendo que la voz resultante sea cómoda durante largas sesiones de escucha. Los principales proveedores en la nube describen estas voces neuronales como habla sintetizada de aspecto humano cuya articulación reduce la fatiga auditiva en asistentes, herramientas de accesibilidad y experiencias de lectura en voz alta.
Nuestro motor de Síntesis de Voz sigue este camino neuronal. Analiza tu guion, lo divide en fonemas, infiere el ritmo y la entonación, y luego usa modelos neuronales para producir audio fluido en lugar de la entrega plana asociada con la síntesis de voz heredada. El resultado es habla realista generada a partir de texto en segundos, extraída de una biblioteca de más de 300 voces adaptadas a diferentes tonos y casos de uso.
Por qué la síntesis de voz neuronal importa para creadores y equipos
Para los creadores de YouTube, pequeñas empresas, productores de e-learning, cineastas, podcasters y desarrolladores, la verdadera pregunta no es solo cómo funciona la tecnología, sino si conviene apoyarse en ella dentro de un flujo de producción. La síntesis de voz neuronal importa porque saca a las voces sintéticas del terreno de "utilidad"—indicaciones de GPS, mensajes básicos—y las lleva al terreno de intérprete: lo suficientemente buenas para encabezar contenido, narrar cursos completos y transmitir mensajes de marca sin sonar obviamente artificial. Combínala con traducción y doblaje y se convierte en un multiplicador, permitiendo que un solo guion llegue a docenas de idiomas a una fracción del costo y el tiempo del trabajo de estudio tradicional.
Diseñamos DubSmart en torno a exactamente esa decisión. Síntesis de Voz, Clonación de Voz, Doblaje con IA, Voz a Texto, Separador de Voz, Texto a Imagen e Imagen a Video se encuentran en un solo flujo, para que el contenido hablado pase de la carga a la exportación multilingüe sin tener que hacer malabares con herramientas separadas. Tú eliges cuánto automatizar y cuánto personalizar en cada etapa—guion, voz, idioma, mezcla—dentro de un solo entorno.
Dónde encaja esto depende de lo que produzcas:
- Expandir un canal de YouTube a nuevos idiomas: la síntesis de voz neuronal más el doblaje te permiten reutilizar guiones y sincronización mientras intercambias voces localizadas.
- Localizar videos de marketing o capacitación: obtienes una narración de marca consistente en todos los idiomas sin contratar talento de voz para cada actualización.
- Producir e-learning o capacitación corporativa: la narración de formato largo se vuelve escalable y fácil de revisar cuando el contenido cambia.
- Gestionar un podcast o una película independiente: puedes crear versiones multilingües, insertos de narración o pistas de accesibilidad.
- Crear aplicaciones: nuestras APIs convierten el habla neuronal en un servicio invocable para IVR, agentes y herramientas de contenido.
Comprender el mecanismo te ayuda a juzgar dónde una voz neuronal puede valerse por sí misma y dónde una grabación humana debe seguir siendo la fuente para la clonación o el doblaje.
Bajo el capó: el flujo de la síntesis de voz neuronal
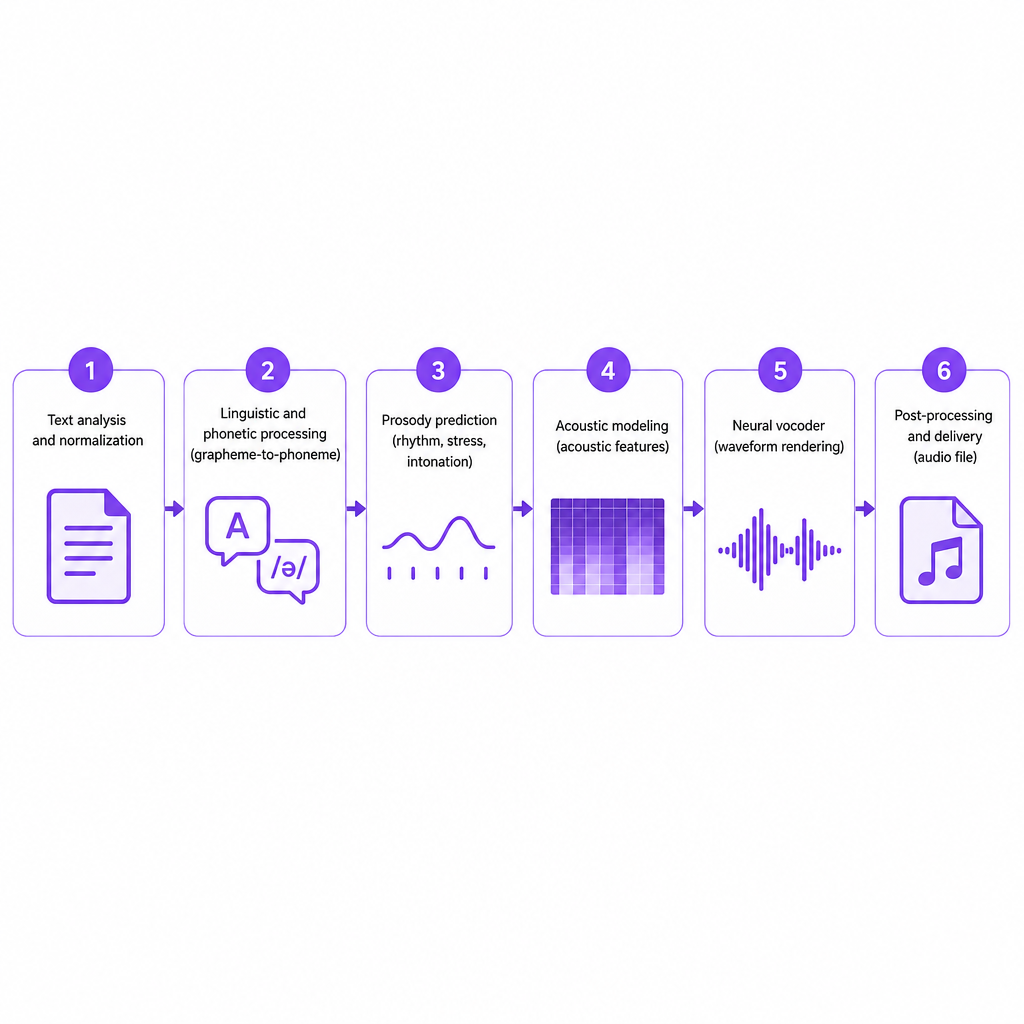
Los motores difieren en los detalles, pero comparten un flujo ampliamente similar descrito en la documentación técnica y las divulgaciones de IA responsable de los principales proveedores, y nuestras propias explicaciones de cómo se crean las locuciones con IA coinciden con él.
Análisis y normalización del texto
Primero, el sistema ingiere tu texto y lo normaliza a una forma pronunciable. Eso significa expandir números ("2026" se convierte en "veinte veintiséis"), fechas y abreviaturas; resolver tokens ambiguos como "US" versus "us" según el contexto; y leer la puntuación y la estructura para planificar pausas y énfasis. Nuestro motor interpreta la puntuación y la estructura para inferir el ritmo y el flujo en lugar de tratar el texto como una secuencia plana de caracteres. Esta etapa tiene un peso real para guiones más largos—cursos, explicaciones, podcasts—donde la estructura de párrafos y los encabezados dan forma a cómo un humano leería naturalmente.
Procesamiento lingüístico y fonético
El texto normalizado se convierte en fonemas, las unidades básicas de sonido de un idioma. Un modelo de grafema a fonema mapea los caracteres a sonidos, manejando reglas de pronunciación, excepciones y entrada multilingüe. Esto es lo que permite que nuestra Síntesis de Voz acepte guiones en muchos idiomas y produzca la secuencia fonética correcta para el seleccionado, ya uses una voz integrada o una voz clonada. Nuestras voces neuronales cubren más de 33 idiomas, incluyendo inglés, portugués, español, francés, alemán, chino y japonés.
Predicción de prosodia
La prosodia—ritmo, acento y entonación—es la diferencia entre una voz robótica y una interpretación de aspecto humano. Los modelos neuronales aprenden patrones prosódicos directamente de las grabaciones, por lo que pueden decidir dónde pausar y por cuánto tiempo, elegir qué palabras llevan énfasis y ajustar el tono y la energía a lo largo de una oración o párrafo. Las voces neuronales de alta definición van más allá, detectando el sentimiento en el texto y ajustando el tono mientras mantienen una persona estable, que es lo que permite una entrega conversacional o empática para contenido de soporte y narración. Nuestro motor infiere la prosodia antes de sintetizar el audio por la misma razón: para evitar una entrega plana y producir un habla que podrías escuchar durante un módulo entero.
Modelado acústico
Una vez que los fonemas y la prosodia están definidos, un modelo acústico neuronal convierte esa representación en características acústicas—un plano para la onda de sonido. Las divulgaciones de IA responsable señalan que, junto con las grabaciones de un talento de voz específico, estos modelos también se basan en una biblioteca fuente más amplia de muchos hablantes. Esa mezcla ayuda a la red a aprender patrones generales del habla mientras aún captura el timbre, el acento y el estilo de una voz en particular. En nuestra plataforma, este modelado es lo que permite que más de 300 voces suenen distintas pero naturales, y sustenta la clonación de voz rápida, donde el sistema aprende la firma acústica y prosódica de una voz a partir de una muestra corta.
Vocoder y renderizado de audio
Las características acústicas pasan a un vocoder neuronal, que las renderiza en una onda de audio completa. Los vocoders más nuevos producen un habla de alta fidelidad que es casi indistinguible de las grabaciones de estudio, con consonantes claras, vocales suaves y artefactos mínimos. La combinación de modelo acústico neuronal más vocoder es la razón por la que las voces neuronales suenan mucho más naturales que la tecnología más antigua utilizada en los lectores de pantalla tradicionales y los IVR. Usamos avances similares para que el audio generado esté listo para publicar directamente o incorporarse a una mezcla con música y efectos de sonido.
Posprocesamiento y entrega
Finalmente, el sistema puede aplicar posprocesamiento—modelado de ruido, normalización de volumen o conversión de formato—antes de devolver el archivo de audio. Para los flujos de trabajo con API, esto se envuelve en un endpoint RESTful que acepta texto y parámetros de voz y devuelve un recurso listo para usar. Nuestra Síntesis de Voz sigue exactamente este flujo: pega o envía texto, elige idioma y voz, ajusta la entrega donde los controles estén disponibles, genera y descarga audio en formato estándar. El mismo motor se encuentra bajo nuestro Doblaje con IA, donde la transcripción, la traducción y la síntesis se encadenan para crear versiones multilingües.
Opciones dentro de DubSmart: voces, clonación, doblaje y APIs
Conocer los mecanismos explica por qué nuestro conjunto de funciones está construido de la manera en que lo está.
Síntesis de Voz para narración directa
Nuestra herramienta de Síntesis de Voz es la interfaz central para convertir guiones en audio. Pegas o cargas texto en cualquier idioma compatible, eliges entre las más de 300 voces de sonido natural, configuras el idioma y los controles básicos de entrega donde estén disponibles, y generas habla en segundos. Cubre ganchos de YouTube y narración de video completa, locuciones explicativas y promocionales para pequeñas empresas, módulos claros de e-learning y capacitación, e introducciones, cierres y anuncios intermedios de podcast. Si estás evaluando herramientas para ese trabajo, nuestra recopilación del mejor software de doblaje con IA para creadores muestra cómo se conectan la narración y la localización.
Clonación de voz: mantener la voz de tu marca o presentador
La clonación de voz se basa en los mismos pasos neuronales—fonemas, prosodia, características acústicas—pero optimiza la red para coincidir con un timbre y estilo específicos, de modo que puedas generar nuevas líneas en esa voz sin volver a grabar. Nuestra clonación de voz rápida crea voces personalizadas que puedes usar dentro de la Síntesis de Voz o el Doblaje con IA, lo que significa que el contenido localizado sigue sonando como tu presentador, narrador o marca. Esa continuidad importa más para canales y empresas que han invertido en una identidad de voz reconocible.
Doblaje con IA: encadenando voz a texto, traducción y TTS
El doblaje con IA usa el motor de TTS como paso final en una cadena más larga: transcribir el audio existente, traducir la transcripción y luego sintetizar un nuevo habla en el idioma de destino. Nuestro Doblaje con IA mantiene el doblaje, la síntesis de voz, la voz a texto y la clonación dentro de un solo flujo de trabajo para que el contenido pase de la carga a la exportación multilingüe sin salir de la plataforma. En la práctica, puedes cargar un video o podcast, hacer que se transcriba y se separe del audio de fondo, traducirlo a uno o más idiomas, y luego generar pistas dobladas usando voces predefinidas o clonadas que preservan la sincronización y el tono. Para un recorrido sobre contenido hablado, consulta nuestra guía sobre cómo traducir un podcast a otro idioma.
APIs para desarrolladores y agencias
Exponemos la síntesis de voz neuronal y el doblaje a través de APIs para que los desarrolladores y las agencias puedan integrar la generación de voz en sus propios productos. Nuestra API de Síntesis de Voz es un servicio RESTful que acepta una solicitud POST con contenido de texto y preferencias de voz y devuelve audio de alta calidad, con acceso a voces neuronales premium en más de 33 idiomas. La API de Doblaje con IA extiende eso al doblaje multilingüe automatizado. Para agencias que manejan la localización entre clientes, estos endpoints estandarizan la generación de voz mientras aún personalizan los idiomas y las personas por marca.
Criterios de decisión: elegir y usar bien la síntesis de voz neuronal
Una vez que el mecanismo está claro, el trabajo práctico consiste en decidir cuándo y cómo usarlo.
Naturalidad y comodidad auditiva. La prueba central es si la voz es lo suficientemente natural como para que tu audiencia la acepte como narrador principal. Las redes neuronales profundas y las voces HD están construidas para reducir la fatiga auditiva, pero la elección correcta aún depende del tipo de contenido. Usa nuestra amplia biblioteca de voces para probar personas—enérgica, calmada, juguetona, autoritaria—y para cursos o podcasts de formato largo, favorece las voces cuya prosodia se sienta conversacional en lugar de anunciadora.
Cobertura de idiomas y adecuación del acento. Para la expansión multilingüe necesitas tanto el idioma como un acento apropiado para el público objetivo. Nuestras voces neuronales abarcan más de 33 idiomas en los principales mercados. Al elegir pistas localizadas, decide si quieres un acento neutro o específico de una región, y prueba muestras con hablantes nativos siempre que sea posible.
Consistencia de marca versus flexibilidad. La clonación transmite una voz específica a través de idiomas y proyectos, pero introduce responsabilidades en torno al consentimiento y la divulgación. Úsala cuando una persona consistente sea central para tu marca, y documenta quién posee y controla esa voz—especialmente en trabajo empresarial o de agencia.
Integración del flujo de trabajo. La síntesis de voz neuronal ofrece el mayor valor cuando encaja en tu forma de trabajar actual. Debido a que nuestras herramientas combinan síntesis de voz, clonación, doblaje, voz a texto y utilidades multimedia, puedes automatizar gran parte de la cadena de localización mientras aún editas guiones y audio. Los creadores individuales pueden encontrar suficientes las herramientas del navegador; los desarrolladores y las agencias obtienen endpoints programables para escalar.
Riesgos, límites y uso responsable
Incluso los modelos avanzados tienen límites que vale la pena planificar.
- Matiz emocional: Las voces HD responden al sentimiento, pero pueden pasar por alto señales sutiles o interpretaciones complejas que un actor experto entregaría. Los mensajes de marca críticos o el drama narrativo aún pueden justificar una grabación humana como fuente.
- Casos límite de pronunciación: Nombres raros, términos novedosos o guiones en idiomas mezclados pueden desafiar los modelos de grafema a fonema, así que incorpora verificaciones manuales.
- Ética de la clonación: La orientación de IA responsable enfatiza que las voces personalizadas deben crearse y usarse con consentimiento explícito, contratos claros y divulgación a la audiencia. Imitar a personas sin permiso plantea preocupaciones legales y éticas.
- Sesgo y representación: Los datos de entrenamiento dan forma a cómo las voces manejan los acentos y dialectos, así que verifica que las voces elegidas representen equitativamente a tu audiencia y eviten reforzar estereotipos.
Debido a que nuestro flujo de trabajo integrado facilita la generación e implementación del habla sintética, la revisión interna importa más, no menos—particularmente cuando manejas voces de clientes o empleados. Un camino concreto ayuda: un creador puede escribir un guion en inglés, generar una locución en inglés y luego doblar versiones en español, portugués y alemán para canales adicionales mientras mantiene la misma sincronización y entrega. Un equipo de capacitación puede construir narración modular y regenerarla rápidamente cada vez que cambien las políticas. Esa es la verdadera recompensa de entender el flujo—sabes qué etapa controlar y cuál dejar que el modelo maneje.
Preguntas frecuentes
¿Qué es la síntesis de voz neuronal en términos simples?
La síntesis de voz neuronal es una IA que convierte el texto escrito en habla usando redes neuronales profundas entrenadas con grandes conjuntos de datos de grabaciones humanas, produciendo voces que suenan mucho más cerca de personas reales que los sistemas de TTS más antiguos.
¿En qué se diferencia la Síntesis de Voz de DubSmart de un TTS básico?
Usamos modelos neuronales que analizan tu guion, infieren la prosodia y sintetizan el habla desde cero, respaldados por más de 300 voces naturales y clonación de voz rápida, para que el resultado funcione como narrador principal para videos, cursos y podcasts.
¿Puede DubSmart mantener mi propia voz en otros idiomas?
Sí. Nuestra clonación de voz puede aprender tu voz a partir de grabaciones y luego usarla en la síntesis de voz y el doblaje con IA, para que las versiones localizadas de tu contenido sigan sonando como tú o el narrador de tu marca.
¿Cómo funciona el doblaje con IA con la síntesis de voz neuronal?
El doblaje con IA encadena la transcripción de voz a texto, la traducción y la síntesis de voz neuronal, convirtiendo tu audio existente en pistas dobladas multilingües en un solo flujo de trabajo, usando ya sea voces predefinidas o tu voz clonada.
¿Es seguro y ético usar la síntesis de voz neuronal?
Usada con consentimiento, divulgación clara y las salvaguardas apropiadas, la síntesis de voz neuronal es una herramienta poderosa para la accesibilidad y la localización. La orientación de IA responsable enfatiza el respeto por los derechos del talento de voz y evitar usos engañosos de las voces sintéticas.