La forma más rápida de integrar una API de texto a voz es tratarla como un servicio REST: autentícate con una clave de API, envía tu texto junto con la configuración de voz en formato JSON, deja que el servicio genere el habla en segundo plano y luego recupera y almacena los archivos de audio resultantes para reproducirlos donde tus usuarios los necesiten. Nuestra API de Texto a Voz sigue exactamente este patrón, a la vez que ofrece más de 300 voces naturales y clonación de voz ilimitada, para que puedas incorporar habla realista en sitios web, aplicaciones, flujos de trabajo de vídeo y plataformas de aprendizaje. Esta guía explica qué estás conectando realmente, cómo funciona nuestro motor y las decisiones que determinan si la integración se ajusta a tu producto.
Tabla de contenidos
Qué hace una API de texto a voz en DubSmart
Una API de texto a voz convierte texto estructurado en audio hablado bajo demanda, de modo que tu código puede solicitar narración o diálogo en el momento en que un guion está listo, en lugar de esperar a una grabación manual. Nuestro motor de Texto a Voz impulsa tanto la herramienta de Texto a Voz basada en navegador como la API, dando acceso a más de 300 voces de IA en distintos idiomas, géneros y estilos, con una prosodia ajustada para narración, explicativos y diálogo.
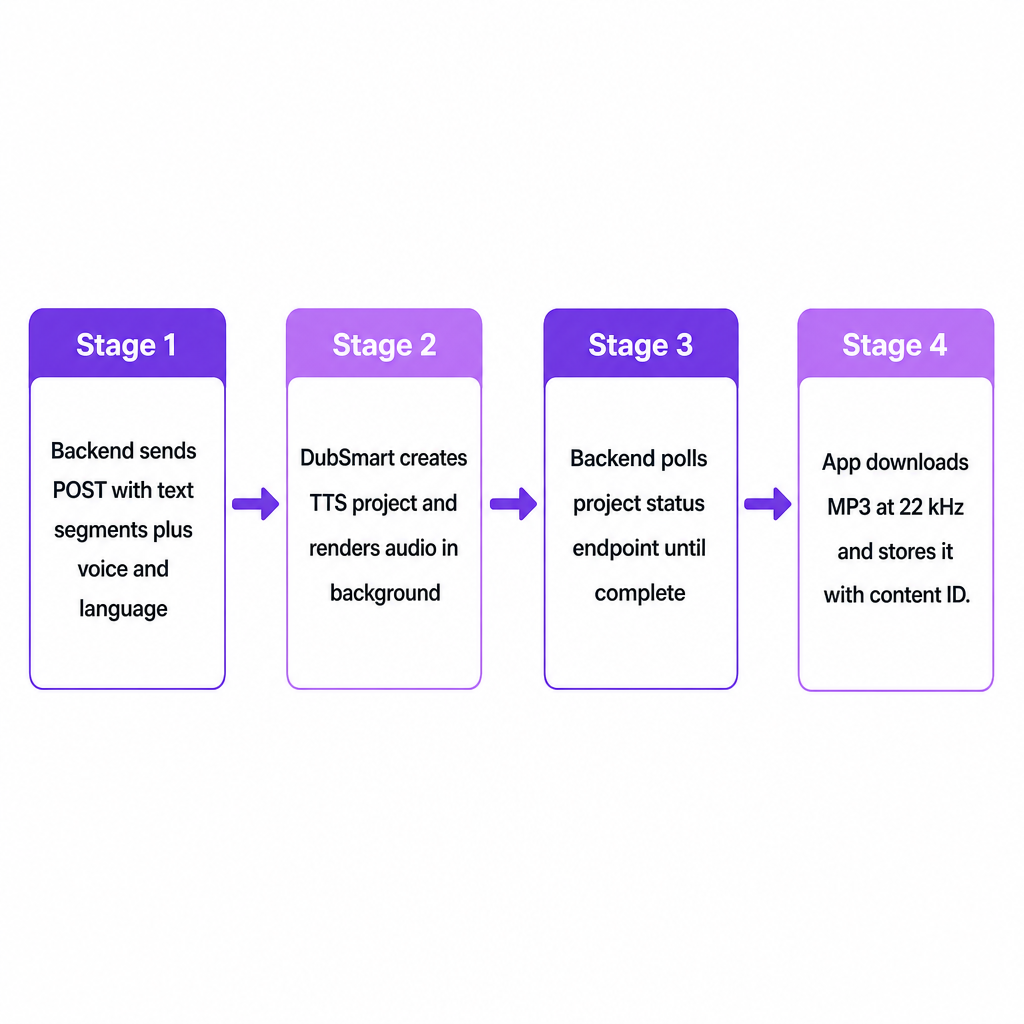
En la capa de la API exponemos este motor como un servicio RESTful: tu backend envía una petición POST que contiene segmentos de texto y parámetros de voz, y el servicio devuelve un objeto de proyecto cuyo estado puedes consultar hasta que el audio esté listo para descargar. La salida se entrega como archivos de audio de alta calidad, normalmente MP3 a 22 kHz, adecuados para su uso directo en editores de vídeo, flujos de trabajo de pódcast o reproductores web sin conversión adicional.
Para los creadores y equipos a los que servimos —youtubers, pequeñas empresas, productores de e-learning, cineastas y agencias de desarrollo— la API conecta la planificación de contenido con la publicación. En cuanto un guion llega a un CMS o a una plataforma de aprendizaje, el backend puede generar locuciones automáticamente, lo que elimina el cuello de botella de la grabación manual repetida.
La decisión de integración: ¿qué estás conectando realmente?
«Integrar una API de texto a voz» suena genérico, pero en la práctica estás decidiendo tres cosas: en qué parte de tu flujo de trabajo debe generarse el habla, qué voces e idiomas representarán tu marca y con qué nivel de rigor automatizas la generación y recuperación del audio.
Para un creador de YouTube que se expande hacia contenido multilingüe, la integración a menudo significa conectar nuestra API a una herramienta de planificación de vídeo o a una base de datos de guiones para que cada guion finalizado se convierta en una locución en el idioma y el estilo adecuados. Para pequeñas empresas y equipos de marketing, la API suele ubicarse detrás de un CMS o de una plataforma de automatización de marketing, convirtiendo entradas de blog, explicativos de producto y textos para redes sociales en activos de audio reutilizables. Los proveedores de e-learning y formación corporativa tienden a conectar la API a herramientas de autoría para que los módulos de las lecciones puedan solicitar narración por diapositiva o por tema y regenerarla al instante cuando el material se actualiza.
Los desarrolladores y agencias que integran la IA de voz de forma más profunda suelen elegir entre dos patrones. Un modelo por lotes recopila guiones y los procesa mediante trabajos programados. Un modelo transaccional activa una petición inmediata cada vez que llega contenido nuevo o una acción del usuario. Nuestra API basada en proyectos funciona limpiamente para cualquiera de los dos, porque cada proyecto de TTS encapsula texto, elección de voz, idioma y el audio resultante de una manera que se corresponde con tus propias unidades de contenido: vídeos, lecciones o episodios de pódcast. Si aún estás valorando el concepto en sí, nuestro artículo complementario sobre qué es una API de texto a voz y cómo funciona cubre los fundamentos antes de que te comprometas con un diseño.
Cómo funciona nuestra API de Texto a Voz por dentro
Nuestra API de Texto a Voz está construida en torno a proyectos y segmentos, lo que la hace más flexible que un único endpoint de «texto entra, audio sale». Un proyecto de TTS agrupa uno o más segmentos de texto bajo un título y una configuración compartida, como el idioma y la voz predeterminada. Cada segmento lleva su propio texto, identificador de voz y etiqueta de idioma, lo que te permite mezclar estilos de narración o idiomas dentro de una sola salida.
Un payload JSON típico enviado al endpoint del proyecto de TTS incluye un título de proyecto legible por humanos para tus paneles y registros, además de un array de segmentos. Cada segmento define text (el guion o la frase que se hablará), voice (ya sea un ID de voz integrada o un ID de voz personalizada creada mediante la API de Clonación de Voz) y language (un código que indica el idioma del segmento).
Cuando tu backend envía este payload al endpoint de TTS con una clave de API válida en la cabecera de autorización, creamos el proyecto y comenzamos a generar el audio en segundo plano. La API expone un endpoint de estado del proyecto que informa de si el procesamiento sigue en curso o ha finalizado, junto con referencias a los archivos de audio generados una vez estén listos. Este diseño asíncrono mantiene tus propias peticiones rápidas: registra el ID del proyecto, devuelve el control al usuario y deja que un proceso en segundo plano compruebe la finalización y descargue el audio cuando esté disponible.
El habla generada llega como archivos descargables en formatos estándar, en particular MP3 a 22 kHz, que se integran fácilmente en reproductores web, aplicaciones móviles y líneas de tiempo de edición de vídeo. Como el mismo motor impulsa nuestra herramienta basada en navegador, los desarrolladores pueden prototipar voces y guiones de forma interactiva y luego migrar las combinaciones ganadoras a llamadas automatizadas a la API. La referencia completa de endpoints está en la página de la API de Texto a Voz.
Conectar la clonación de voz y el doblaje con IA al texto a voz
Nuestra característica distintiva es que el Texto a Voz, la Clonación de Voz y el Doblaje con IA comparten un único motor de voz y flujo de trabajo subyacente. Eso significa que la API de TTS no está aislada: es el núcleo de una canalización de localización más amplia.
La API de Clonación de Voz te permite subir muestras de audio de un locutor, crear una voz de IA personalizada y referenciar esa voz en proyectos de TTS. Una vez que existe una voz personalizada, su identificador se convierte en el campo voice de tus segmentos de Texto a Voz, de modo que la narración se reproduce con la voz clonada en lugar de una voz genérica de catálogo. Esa continuidad es importante para presentadores, podcasters y portavoces de marca que quieren una identidad sonora coherente entre idiomas y formatos. Si planeas añadir clonación, nuestra guía sobre cómo integrar una API de clonación de voz en tu aplicación cubre los detalles.
La API de Doblaje con IA amplía esto aún más al combinar transcripción, traducción y texto a voz en una única canalización que dobla vídeos a más de 33 idiomas de destino. Aquí el motor de TTS convierte los guiones traducidos en habla usando la misma biblioteca de más de 300 voces o tu voz clonada, de modo que las versiones dobladas conservan el tono y el ritmo. Para creadores y empresas multilingües, la API de Texto a Voz se convierte en el bloque de construcción tanto de locuciones monolingües como de contenido doblado totalmente localizado. Nuestra descripción general de cómo funciona la localización con IA muestra cómo encajan estas piezas de principio a fin.
Criterios clave de decisión al integrar nuestra API de TTS
Integrar «cualquier» API de TTS no es suficiente; las decisiones en torno a la implementación determinan qué tan bien se adapta a tu producción, marca y stack técnico.
Necesidades de escala y automatización. Si el volumen de contenido es bajo y esporádico, la herramienta basada en navegador puede ser suficiente. Una vez que los guiones se generan con regularidad o están vinculados a calendarios de contenido, sistemas de gestión del aprendizaje o automatización de marketing, la API se convierte en la capa adecuada porque puede activarse de forma programática y escalar con tu backend.
Estrategia de voz e idioma. Nuestra plataforma admite el doblaje desde más de 60 idiomas de origen a 33 idiomas de destino, impulsada por el mismo motor de voz que usa la API de TTS. Si tu marca necesita una voz de portavoz distintiva, combinar la API de Clonación de Voz con el TTS mantiene esa voz coherente entre idiomas y canales. Si priorizas la velocidad sobre la personalización, las voces integradas simplifican la implementación.
Punto de integración en tu stack. Para canales de YouTube, un lugar natural es la canalización de vídeo: guiones almacenados en una herramienta de planificación, enviados a la API de TTS cuando se finalizan y devueltos como audio listo para los editores. Las plataformas de e-learning pueden integrar a nivel de lección o de diapositiva, donde cada bloque de contenido se corresponde con un segmento y los proyectos representan cursos enteros. Los equipos de marketing suelen integrar a nivel de CMS para que cada artículo o página de producto pueda solicitar una versión en audio con fines de accesibilidad.
Gobernanza, cumplimiento y riesgo. Dado que la clonación de voz puede replicar voces reconocibles, el consentimiento, las licencias y las políticas de uso son importantes. Las voces clonadas se identifican mediante ID y pueden etiquetarse con metadatos, lo que facilita aplicar reglas internas sobre dónde se pueden usar voces específicas. Decide de antemano qué entornos pueden activar voces clonadas frente a voces genéricas, y añade registro en tus propios sistemas.
Expectativas de latencia y experiencia de usuario. El procesamiento asíncrono ofrece flexibilidad pero añade una consideración de tiempo. Para flujos de trabajo en los que los usuarios esperan reproducción inmediata —como un editor de guiones con vista previa instantánea— crea proyectos o segmentos más pequeños y muestra indicadores de progreso mientras se genera el audio. Para la localización por lotes de bibliotecas enteras, la latencia importa menos, y los trabajos pueden ejecutarse según programaciones, con el audio finalizado adjuntado posteriormente a los registros de contenido.
| Área de decisión | Modelo por lotes | Modelo transaccional |
|---|---|---|
| Activador | Trabajos programados | Por elemento de contenido o acción del usuario |
| Tolerancia a la latencia | Alta | Baja |
| Mejor adaptación | Catálogos de cursos, bibliotecas de vídeo | Editores de guiones, vistas previas en vivo |
| Estrategia de voz | Voz aprobada por idioma | Voz aprobada por idioma |
Riesgos y salvaguardas prácticas
Integrar una API de texto a voz conlleva algunos riesgos predecibles que un diseño cuidadoso puede mitigar.
Elegir voces sin probarlas puede producir un habla que resulte fuera de carácter para una marca o presentador. Prueba primero las voces en la interfaz interactiva y mantén un catálogo de voces aprobadas dentro de tus propios sistemas, organizado por idioma y tipo de contenido, antes de codificar los ID de voz en las llamadas a la API.
La automatización excesiva de contenido sensible es otra trampa. Generar habla automáticamente para material de cumplimiento, médico o legal puede no ser apropiado. Como nuestra API opera con proyectos y segmentos discretos, puedes mantener reglas de enrutamiento que envíen solo las categorías aprobadas al TTS, manteniendo el contenido sensible en flujos de trabajo grabados por humanos.
Los errores operativos —proyectos fallidos o descargas ausentes— ocurren cuando problemas de red o payloads no válidos interrumpen el procesamiento. Los endpoints de estado del proyecto y las respuestas estructuradas te permiten confirmar que un proyecto se completó y que sus salidas están disponibles antes de publicar. Empareja cada ID de proyecto de TTS con tu propio ID de contenido, e implementa reintentos o alternativas cuando las comprobaciones de estado informen de errores.
El uso indebido de voces clonadas merece controles explícitos. Las voces personalizadas deben crearse mediante endpoints dedicados y luego referenciarse por ID en los proyectos de TTS, lo que te da un límite técnico claro para supervisar. Restringe quién puede crear o asignar ID de voces clonadas, y registra dónde se usan.
Un camino inicial práctico es integrar primero el TTS para locuciones estándar, validar las voces y el manejo de errores en producción, y luego incorporar la Clonación de Voz y el Doblaje con IA una vez que la integración principal sea estable. Cuéntanos tu volumen de contenido, los idiomas de destino y dónde debe ubicarse la API en tu stack, y podremos orientarte hacia los endpoints adecuados y planificar tu flujo de trabajo.
Preguntas frecuentes
¿En qué se diferencia la API de Texto a Voz de la herramienta de navegador?
La herramienta de navegador es una interfaz visual donde pegas texto, eliges una voz y descargas el audio manualmente. La API expone el mismo motor a través de endpoints REST para que tu backend pueda generar y recuperar audio automáticamente en respuesta a guiones, programaciones o acciones del usuario.
¿Puede la API hablar con mi propia voz, no solo con voces de catálogo?
Sí. Al integrar la API de Clonación de Voz, subes muestras de audio de un locutor, creas una voz de IA personalizada y luego referencias el ID de esa voz en tus segmentos de Texto a Voz para que todo el habla generada se reproduzca con la voz clonada.
¿Cómo ayuda esto con canales de YouTube o pódcast multilingües?
Nuestra plataforma convierte habla o guiones de más de 60 idiomas de origen en salida doblada en 33 idiomas de destino, con el TTS generando el audio final usando más de 300 voces o tu voz clonada. Conectar las API de TTS y Doblaje con IA a tu canalización de publicación permite que nuevos vídeos o episodios reciban locuciones o doblajes completos una vez que los guiones o el audio de origen estén listos.
¿Qué formatos de audio recibirá mi aplicación o editor?
La API de TTS entrega archivos de audio de alta calidad, incluido MP3 a 22 kHz, adecuados para la mayoría de los entornos web, móviles y de edición de vídeo sin conversión adicional.
¿Puedo integrar el Texto a Voz ahora y añadir el Doblaje con IA más adelante?
Sí. El Texto a Voz, la Clonación de Voz y el Doblaje con IA comparten un ecosistema de API común, por lo que puedes empezar con el TTS para locuciones y luego añadir la Clonación de Voz y el Doblaje con IA para automatizar el doblaje multilingüe sin reconstruir tu integración principal.