La separación de voz por IA es un proceso de aprendizaje profundo que extrae una voz humana de una mezcla ruidosa y devuelve una pista de voz limpia, lista para transcripción, doblaje o clonación de voz. Esa única capacidad responde la pregunta que la mayoría de los creadores realmente tienen: ¿puedo rescatar esta grabación sin volver a grabarla? Comprender cómo funciona la separación de voz por IA te ayuda a decidir cuándo apoyarte en ella, cuándo grabar de forma más limpia desde el principio, y cómo una pista de voz limpia mejora silenciosamente todo lo que viene después. Esta guía recorre el mecanismo, la diferencia entre mejorar a un solo hablante y separar a muchos, dónde encaja el proceso en un flujo de localización, y qué es lo que aún no puede corregir.
Tabla de contenidos
La decisión detrás de la separación de voz
Cualquier grabación real capta mucho más que al hablante. Los vlogs, seminarios web, videos de formación y pódcasts recogen ruido de la calle, ambiente de la sala, fondos musicales, clics de teclado y conversaciones superpuestas que pueden enterrar las palabras importantes. Un separador de voz existe para desenredar esa mezcla: toma un archivo mezclado y devuelve una pista que contiene mayormente voz humana, más una pista opcional con el audio de fondo restante.
Esa pista de voz limpia se convierte en la base para lo que venga después: conversión de voz a texto precisa, doblaje multilingüe, clonación de voz de alta fidelidad, o simplemente un original que suena mejor. Así que la verdadera decisión no es técnica, es práctica. ¿Confías lo suficiente en tu audio actual como para construir contenido multilingüe sobre él, o quieres que la IA limpie y separe primero la voz? ¿Y quieres una utilidad de limpieza independiente, o un separador integrado en una plataforma más amplia de creación y localización para no tener que hacer malabares con varias aplicaciones?
Diseñamos nuestro Separador de Voz para que actúe como la primera compuerta de IA en un flujo unificado. Se sitúa antes de la conversión de voz a texto, la conversión de texto a voz, la clonación de voz y el doblaje, de modo que cada sistema posterior vea la señal de voz más clara posible en lugar de heredar cualquier ruido que hubiera en la sala.
El mecanismo: de la forma de onda a la voz limpia
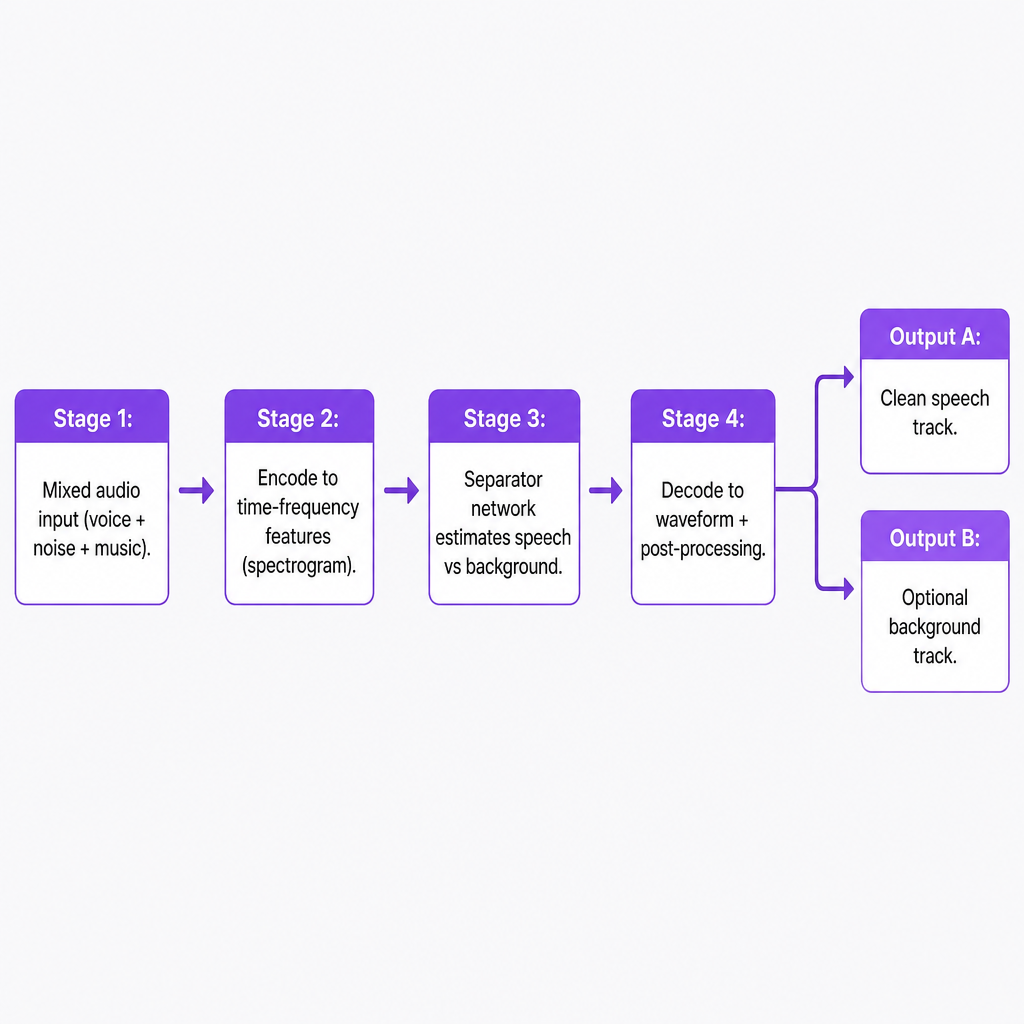
La separación de voz por IA moderna sigue un flujo de cuatro etapas: codificar la señal, separar las fuentes en un espacio de características aprendido, estimar la voz limpia y decodificarla de vuelta a audio.
De la forma de onda a las características
La mayoría de los sistemas primero convierten la forma de onda cruda de tu micrófono en una representación tiempo-frecuencia como un espectrograma, que muestra cómo cambia la energía en diferentes bandas de frecuencia a lo largo del tiempo. Esa vista facilita que una red neuronal detecte los patrones que corresponden a la voz humana frente al ruido o la música. Una red codificadora luego mapea la entrada a un espacio de características de alta dimensión donde las distintas fuentes de sonido se vuelven más distinguibles, enfatizando rasgos del habla como formantes, armónicos y estructura temporal mientras suprime el contenido de fondo irrelevante.
Redes separadoras y máscaras
El núcleo del proceso es la red separadora, un modelo profundo entrenado para juzgar qué pertenece a la voz y qué no en cada punto tiempo-frecuencia. Dominan dos estrategias. La separación basada en máscaras predice una máscara para el espectrograma que conserva la energía de la voz y atenúa todo lo demás; cuando se aplica al espectrograma original, el ruido de fondo y la música caen bruscamente mientras la voz permanece. La estimación directa de fuentes, en cambio, predice el propio espectrograma de voz limpia, y a veces un fondo residual, que luego se decodifica de vuelta a audio.
Existen enfoques más especializados para casos más difíciles. El agrupamiento profundo aprende una incrustación para cada bin tiempo-frecuencia de modo que los bins de la misma fuente se agrupen, tras lo cual un agrupamiento estándar separa la voz de otras fuentes. Otros modelos usan entrenamiento invariante a la permutación para poder separar a varios hablantes sin asumir qué hablante es la salida uno frente a la salida dos.
Entrenamiento con ejemplos supervisados
Estos modelos aprenden a partir de mezclas de ejemplo emparejadas con voz limpia de referencia (ground-truth), ajustándose para minimizar la diferencia entre su salida y la referencia. Los objetivos de entrenamiento pueden ser máscaras, espectrogramas limpios o formas de onda reconstruidas, y las funciones de pérdida a menudo están vinculadas a medidas de calidad perceptiva como la relación señal-distorsión. Alimentada con muchas muestras diversas de acentos, micrófonos y entornos, la red internaliza señales robustas que separan la voz humana del contenido de fondo y generaliza a grabaciones que nunca ha visto.
Decodificación de vuelta a audio
Finalmente, el sistema mapea la representación de la voz separada de vuelta a una forma de onda en el dominio del tiempo mediante una transformada inversa, seguida de un posprocesamiento como la reducción de ruido y la normalización de sonoridad. El resultado es una pista dominada por la voz que puede ir sola o recombinarse con una cantidad controlada de fondo para lograr naturalidad. Nuestro Separador de Voz sigue exactamente este patrón: ingiere tu audio o video subido, ejecuta el flujo de separación y devuelve una pista centrada en la voz más un fondo opcional, para que tú decidas qué tan seca o ambiental debe ser la mezcla final.
Mejora de un solo hablante frente a separación de múltiples hablantes
Hay una línea importante entre mejorar a un hablante dominante y separar realmente varias voces superpuestas, y esto determina lo que puedes esperar de forma realista.
La mejora de un solo hablante aísla una voz principal del ruido de fondo, la reverberación y los sonidos no vocales, de modo que la inteligibilidad da un salto. Esto funciona especialmente bien para vlogs, seminarios web, conferencias y contenido de tipo talking-head, donde el problema es el ruido ambiental o un fondo musical en lugar de la interferencia de voces. Nuestro Separador de Voz está optimizado para este caso: trata la voz humana como la fuente principal y todo lo demás como fondo, entregando una pista de voz limpia y una pista de fondo opcional.
La separación de múltiples hablantes es una tarea diferente: dividir una mezcla de varias personas hablando a la vez en flujos individuales, uno por voz. Los modelos de investigación han separado hasta cinco voces de un solo micrófono entrenando distintas redes para distintas cantidades de hablantes y eligiendo la que mejor se ajusta a cada muestra. Técnicas como el agrupamiento profundo y el beamforming neuronal multimicrófono llevan el rendimiento más allá en entornos de campo lejano y multicanal, pero son más complejas y computacionalmente pesadas. En la práctica, estos sistemas siguen dirigiéndose a escenarios especializados como la transcripción de reuniones, los centros de llamadas y los dispositivos inteligentes, en lugar de los flujos cotidianos de los creadores. Para la mayoría de nuestros usuarios —que gestionan canales de YouTube, equipos de marketing o bibliotecas de cursos— la mayor ganancia práctica proviene de una fuerte mejora de un solo hablante y la separación de voz frente a fondo, no de la división completa de múltiples voces.
Dónde encaja la separación en un flujo de localización
La separación es el puente entre las grabaciones ruidosas del mundo real y el trabajo de voz por IA de alta calidad. Un recorrido típico fluye limpiamente a través de varias herramientas.
Un creador sube un archivo de audio o video, y el separador aísla la pista de voz y, opcionalmente, el fondo. Esa voz limpia alimenta la conversión de voz a texto, de modo que la transcripción y la traducción operan sobre una señal clara, lo que mejora la precisión y reduce las palabras alucinadas causadas por música o ruido intensos. El texto y las traducciones resultantes pasan luego a la conversión de texto a voz y al doblaje por IA, que generan nuevas versiones en distintos idiomas usando voces clonadas o sintéticas; como la voz de origen era limpia, la alineación temporal es más precisa y se reducen artefactos de mezcla como el pumping.
La clonación de voz depende de la misma entrada limpia. Los modelos necesitan ejemplos relativamente libres de ruido para aprender el timbre, la prosodia y la articulación de un hablante de manera fiable, y la separación reduce la contaminación de fondo que puede distorsionar una voz clonada. Nuestra guía en español sobre la separación capta bien la experiencia cotidiana: sube un archivo, deja que la IA separe la voz del fondo, luego descarga ya sea la pista de voz limpia o el fondo aislado para más edición, doblaje o narración, todo dentro de un solo flujo. Esa consolidación es lo que importa para los equipos pequeños, que de otro modo saltan entre complementos de reducción de ruido, herramientas de transcripción, servicios de doblaje y plataformas de clonación por separado.
Elegir y usar la separación de voz por IA
Cuando decides cómo adoptar la separación, un puñado de criterios prácticos hacen la mayor parte del trabajo.
Condiciones del audio y tipo de contenido. Con un solo hablante principal y ruido de fondo o música moderados, la separación es altamente eficaz y de bajo riesgo. Con mucha superposición, micrófonos de campo lejano o entrada de muy baja calidad, espera rendimientos decrecientes y combina la IA con una mejor grabación en lugar de confiar en ella para rescatarlo todo.
Integración con herramientas posteriores. Un separador que fluye directamente hacia la transcripción, la conversión de texto a voz y el doblaje reduce la fricción y los artefactos acumulativos en comparación con exportar y reimportar entre aplicaciones. Conectamos el Separador de Voz al resto de nuestras herramientas de localización precisamente por esta razón, lo que importa más cuando tu objetivo es la publicación multilingüe en lugar de una reducción de ruido puntual.
Control sobre el audio de fondo. Para el storytelling de marca a menudo querrás conservar algo de ambiente o música para lograr impacto emocional. Los sistemas que generan tanto una pista de voz limpia como un fondo aislado dan a los editores más margen que las herramientas que solo producen una única mezcla sin ruido. Nuestro separador admite este paradigma de voz más fondo opcional para que puedas remezclar de forma deliberada.
Velocidad, simplicidad y escala. Para creadores y equipos pequeños, la usabilidad rivaliza con el rendimiento en bruto. La separación con un solo clic a través de un navegador o una API, con manejo automático de formatos comunes, supera a las cadenas de complementos complejas que asumen experiencia en ingeniería de audio. Una vez que estás gestionando cientos de videos o módulos de curso, el procesamiento por lotes y la automatización dejan de ser lujos.
Fiabilidad y artefactos. Un modelo sólido mejora la inteligibilidad sin añadir distorsión evidente, resonancia metálica o artefactos de respiración. Las demostraciones pueden favorecer a un sistema, así que prueba con tus propias grabaciones representativas antes de convertir cualquier separador en una parte fija de tu flujo.
Privacidad y cumplimiento. La separación opera directamente sobre datos de voz que pueden incluir información sensible. Los equipos empresariales deben confirmar cómo se almacena el audio, si se usa para entrenar modelos y qué controles existen para la retención y el acceso, especialmente en industrias reguladas y contenido de formación interna.
Sopesar estos criterios frente a tus casos de uso reales —ya sea expansión de canal, formación, marketing, trabajo narrativo o un producto de API— te dice si un separador integrado con herramientas de voz posteriores encaja en tu forma de operar.
Riesgos, límites y lo que no puede corregir
Incluso los modelos sólidos tienen límites que conviene conocer antes de comprometerse.
- Ruido extremo o relación señal-ruido muy baja. Cuando la voz está enterrada bajo ruido o música fuertes, el modelo puede no recuperar cada palabra, produciendo cortes o una salida amortiguada.
- Fuerte superposición de hablantes. Las personas que hablan exactamente al mismo tiempo desafían incluso a los sistemas avanzados de múltiples hablantes y pueden hacer que la voz se filtre entre los flujos separados.
- Artefactos de sobre-separación. El enmascaramiento agresivo puede introducir ruido musical o un timbre robótico, más notable en sonidos sostenidos y sibilantes.
- Desajuste entre entrenamiento y realidad. Los modelos ajustados a ciertos micrófonos, idiomas o entornos pueden rendir por debajo de lo esperado en grabaciones muy diferentes, lo que luego perjudica la precisión de la transcripción y el doblaje.
- Ética y derechos. La voz separada limpiamente es más fácil de transcribir, analizar y remezclar, por lo que los equipos deben respetar el consentimiento y los derechos al reutilizar voces en nuevos idiomas o contextos.
La conclusión honesta es que la separación es una mejora poderosa, no un sustituto de buenos hábitos de grabación. Los buenos micrófonos, los niveles razonables y las elecciones cuidadosas de ubicación siguen dando resultado, y la IA luego multiplica esas elecciones al hacer el contenido mucho más flexible para la localización y la reutilización. Si estás explorando cómo encajar esto en una configuración de publicación más amplia, nuestro artículo explicativo sobre qué es un separador de voz cubre los fundamentos con mayor profundidad.
Preguntas frecuentes
¿Qué es la separación de voz por IA en términos sencillos?
Es un proceso de IA que toma una grabación mezclada y aísla la voz humana, dándote una pista de voz limpia y, opcionalmente, una pista de fondo separada que puedes conservar o descartar.
¿En qué se diferencia nuestro Separador de Voz de la reducción de ruido básica?
La reducción de ruido tradicional atenúa principalmente el ruido de estado estacionario. Nuestro separador usa aprendizaje profundo para reconocer patrones de voz y extraerlos de una amplia gama de sonidos de fondo y música, lo que suele producir un diálogo más limpio y natural.
¿Puede manejar múltiples hablantes?
Nuestro Separador de Voz está optimizado para aislar la voz humana de fondos no vocales, lo que funciona mejor con un hablante principal en la mezcla. Separar varias voces superpuestas es un área de investigación activa, y existen modelos especializados, pero normalmente se dirigen a reuniones o centros de llamadas en lugar de a los flujos generales de los creadores.
¿Por qué importa la separación de voz para el doblaje multilingüe?
La localización depende de una transcripción y una sincronización precisas. Una pista de voz limpia reduce los errores de reconocimiento y ayuda a que las voces en off traducidas se alineen con el video original, reduciendo los artefactos audibles cuando se mezclan nuevas voces con la música y los efectos conservados.
¿Cuánto conocimiento técnico necesito para usarlo?
Muy poco. Subes un archivo de audio o video, dejas que la IA lo procese y descargas las pistas de voz y de fondo separadas para edición, doblaje o automatización, sin necesidad de ajustar parámetros manualmente.