Elige una voz TTS estándar cuando necesites una narración rápida y flexible y nadie necesite reconocer al hablante. Elige una voz clonada cuando el sonido de una persona concreta aporte confianza, continuidad o reconocimiento de marca. Esa única disyuntiva entre velocidad e identidad está en el centro de la decisión voz clonada vs voz TTS estándar, y la mayoría de los creadores le dan demasiadas vueltas porque las tratan como rivales en lugar de como herramientas para trabajos diferentes.
Aquí en DubSmart AI integramos ambas en un solo flujo de trabajo, así que esta guía se centra en la decisión en sí: qué es realmente cada opción, cómo funciona y los criterios concretos que te indican cuál encaja en un proyecto determinado. Al final deberías poder mirar cualquier guion y saber en segundos si necesitas una voz lista para usar o una personalizada.
Tabla de contenidos
Qué distingue una voz clonada de una voz TTS estándar
La diferencia se reduce a una sola cosa: la identidad de la voz.
Una voz TTS estándar es una voz sintética lista para usar que eliges de una biblioteca. Pegas un guion, eliges una voz y un idioma, y generas el audio. Está diseñada para ser reutilizable en muchos proyectos y públicos, que es exactamente por lo que se siente neutral en lugar de personal.
Una voz clonada es una versión sintética de un hablante concreto. El sistema analiza una grabación de esa persona y reproduce su tono, pronunciación, ritmo y carácter vocal en un discurso nuevo. El resultado está vinculado a un individuo autorizado en lugar de a un valor predeterminado de la plataforma.
Esa distinción determina cada decisión posterior sobre configuración, flexibilidad, continuidad y gobernanza.
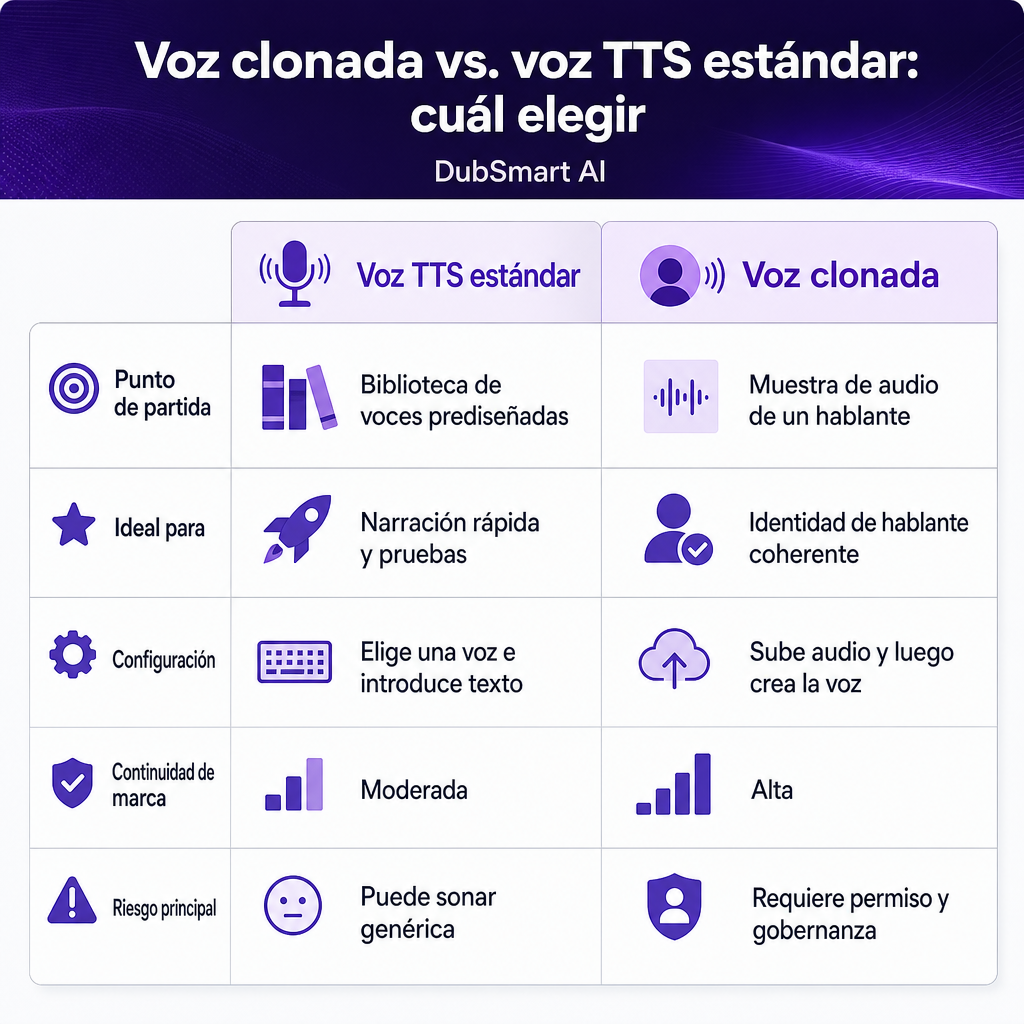
| Factor | Voz TTS estándar | Voz clonada |
|---|---|---|
| Punto de partida | Biblioteca de voces predefinidas | Muestra de audio de un hablante |
| Ideal para | Narración rápida y pruebas | Identidad de hablante consistente |
| Configuración | Elige una voz, introduce el texto | Sube audio y luego crea la voz |
| Continuidad de marca | Moderada | Alta |
| Riesgo principal | Puede sentirse genérica | Requiere permiso y gobernanza |
Si quieres un análisis más profundo de cómo divergen las herramientas subyacentes, nuestro artículo explicativo sobre clonación de voz vs texto a voz compara en detalle identidad, configuración, escala y gobernanza.
Cómo funciona realmente cada opción
Entender la mecánica hace que la decisión sea obvia, porque cada camino concentra el esfuerzo en un lugar diferente.
El TTS estándar convierte el texto en voz con una voz que ya existe. Escribes o pegas un guion, eliges una voz y un idioma, ajustas la interpretación si es necesario y exportas. No hay ningún conjunto de datos que mantener ni ningún hablante al que llamar de nuevo por un pequeño cambio en el guion. Nuestra herramienta de Texto a voz ofrece más de 300 voces de aspecto humano y controles como la velocidad del habla, indicaciones de emoción y formato de énfasis, para que puedas probar varias direcciones en minutos.
La clonación de voz, en cambio, concentra el esfuerzo al principio. Comienza con una grabación del hablante; el sistema analiza sus características vocales y crea una voz personalizada reutilizable que luego puedes controlar con texto nuevo. En DubSmart puedes subir un archivo de audio de al menos 20 segundos para crear un clon, y una grabación limpia y sin ruido de fondo produce mejores resultados. El estilo de habla de la muestra también importa: un clip monótono tiende a generar un habla más plana, mientras que una muestra que transmite la emoción que deseas ayuda a reproducir ese estilo. Nuestra herramienta de Clonación de voz deja disponible esa voz personalizada después tanto para Texto a voz como para Doblaje con IA.
La consecuencia práctica es el tiempo. El TTS estándar te da audio hoy sin ninguna configuración. La clonación pide una grabación, permiso y una comprobación de calidad por adelantado, y luego recupera ese esfuerzo en cada generación futura.
Los seis criterios que lo deciden
Pasa un proyecto por estas seis preguntas y la respuesta normalmente se resuelve sola.
1. ¿La voz en sí misma aporta significado? Si al público le importa quién habla, la clonación gana. Un educador de YouTube, un presentador de pódcast o un fundador que generó confianza a través de su voz pierde algo cuando un narrador genérico la reemplaza. Si la voz solo transmite información, como un tutorial de software o un anuncio interno, el TTS estándar es suficiente.
2. ¿Cuánto contenido vas a producir? Para un solo anuncio de 30 segundos, tomar una voz estándar es más rápido que preparar un clon. Para cientos de vídeos, lecciones o episodios, una voz clonada elimina el trabajo repetido de grabación y mantiene la continuidad en toda la biblioteca.
3. ¿Necesitas localización multilingüe? Ambas manejan varios idiomas, pero resuelven problemas diferentes. Con el TTS estándar seleccionas una voz adecuada para cada idioma de destino, lo que ayuda cuando importa más un estilo regional que el hablante original. Con la clonación el objetivo es preservar al hablante original en todos los idiomas. Nuestra clonación de voz admite 33 idiomas, y nuestro servicio de Doblaje con IA dobla contenido desde más de 60 idiomas de origen a 33 idiomas de destino.
4. ¿Cuánto control emocional necesitas? Un clon no inventa una emoción que nunca escuchó. Si el clip de origen es plano, el resultado tiende a ser plano, por lo que recomendamos grabar la emoción y el estilo de habla que quieres reproducir. Las voces estándar son más fáciles de probar con varios tonos cuando un día necesitas un explicador tranquilo y al siguiente un anuncio enérgico. Hacia cualquiera que te inclines, prueba ambas con el mismo guion y escucha la pronunciación de nombres y términos técnicos, el ritmo de las frases, la credibilidad emocional, el énfasis y la consistencia en pasajes largos.
5. ¿Con qué rapidez necesitas el primer borrador? El TTS estándar tiene el camino más corto del guion al audio porque la voz está lista. La clonación añade un paso de preparación y luego se vuelve eficiente para la producción recurrente. Para un plazo puntual, empieza con el TTS estándar; para un sistema de contenido continuo, invierte en un clon cuando la identidad tenga un valor duradero.
6. ¿Quién controla la identidad del hablante? La clonación exige gobernanza. Clona una voz solo cuando tengas el permiso del hablante y el derecho a usar la grabación y el resultado para el propósito previsto. Mantén documentación que cubra de quién se grabó la voz, qué autorizó, dónde puede usarse la voz, si se permite el uso comercial y publicitario, y cómo debe desactivarse la voz si la autorización termina. Esto es especialmente importante para agencias y desarrolladores que producen contenido para clientes, y una voz que suena como una persona real puede engañar al público si nunca se revela que la narración es sintética.
Qué deberían elegir los distintos creadores
La misma disyuntiva cae de forma diferente según lo que crees.
Creadores de YouTube: Clona tu voz si el canal gira en torno a tu personalidad, para que las introducciones, correcciones, shorts y versiones multilingües sigan siendo reconocibles. Recurre al TTS estándar en canales sin rostro, experimentos de nicho o formatos que necesitan voces de personajes distintas.
Pequeñas empresas y equipos de marketing: Empieza con el TTS estándar para vídeos de producto, anuncios en redes sociales, capacitación de ventas y borradores internos, porque es rápido y fácil de probar con A/B para tono y ritmo. Pasa a una voz clonada de fundador o de marca cuando el mismo narrador aparezca en todas las campañas y en la educación del cliente.
Equipos de e-learning y formación corporativa: Usa el TTS estándar para contenido modular que cambia a menudo o necesita varias voces instructivas. Usa una voz clonada cuando los alumnos esperen continuidad de un mismo instructor a lo largo de una gran biblioteca, para que los módulos separados se sientan como un solo curso.
Cineastas y creadores de pódcast: Clona cuando preservar la identidad de un presentador o personaje sea esencial; nuestro flujo de trabajo de Doblaje con IA está diseñado para clonar la voz de cada hablante para la localización multilingüe. Usa el TTS estándar para pistas de referencia, vistas previas, papeles menores o ediciones tempranas antes del reparto final.
Desarrolladores y agencias: Elige una API de Texto a voz estándar cuando tu aplicación necesite una selección de voces y prototipado rápido sin incorporar hablantes. Elige una API de Clonación de voz cuando tu producto necesite voces personalizadas autorizadas creadas a partir de muestras de audio.
Cuándo usar ambas es la decisión más inteligente
El TTS estándar y la clonación de voz no son mutuamente excluyentes, y los sistemas de producción más sólidos los combinan de forma deliberada.
Una configuración realista podría combinar una voz de presentador clonada para la narración principal de YouTube con voces estándar para los personajes secundarios. Un curso podría usar una voz de instructor clonada en las lecciones principales y voces estándar en los diálogos de juego de roles. Un equipo podría redactar los primeros guiones con TTS estándar y luego generar la versión final aprobada con un clon. Para la localización, las voces clonadas preservan al narrador en todos los idiomas mientras que las voces regionales estándar intervienen cuando un narrador local encaja mejor.
Este enfoque híbrido mantiene la flexibilidad creativa donde importa la velocidad y protege la identidad donde importa el reconocimiento, sin forzar un único compromiso en todo el proyecto.
La única regla que resuelve la mayoría de las decisiones
Cuando los criterios parecen equilibrados, esta regla rompe el empate:
Si el hablante forma parte del producto, elige una voz clonada. Si el discurso es el producto, elige una voz TTS estándar.
El hablante forma parte del producto cuando su identidad genera confianza, reconocimiento o continuidad: creadores, instructores, fundadores, presentadores y personajes de ficción. El discurso es el producto cuando la prioridad es una narración clara, asequible y rápidamente editable: explicadores, actualizaciones de producto, formación interna, prototipos y variaciones de gran volumen.
La mayoría de los primeros proyectos empiezan mejor con el TTS estándar porque es inmediato y fácil de cambiar. Avanza hacia una voz clonada una vez que el sonido del narrador se convierta en un verdadero activo en tu marca, canal, curso o contenido localizado. Para equipos que necesitan tanto velocidad como continuidad, nuestra biblioteca estándar maneja la narración flexible mientras que nuestras herramientas de clonación de voz y doblaje manejan la consistencia multilingüe autorizada.
Preguntas frecuentes
¿Es mejor una voz clonada que una voz TTS estándar?
No de forma universal. Una voz clonada gana en identidad y consistencia; una voz TTS estándar gana en velocidad, variedad y producción de bajo compromiso. La elección correcta depende de si la identidad del hablante importa para ese proyecto.
¿Cuánto audio se necesita para clonar una voz con DubSmart?
La muestra mínima es de 20 segundos. Para una mejor calidad recomendamos una grabación limpia sin ruido de fondo, y una muestra que transmita la emoción y el estilo que quieres reproducir.
¿Puede una voz clonada hablar otro idioma?
Sí. Nuestra clonación de voz admite 33 idiomas, y nuestro servicio de Doblaje con IA dobla contenido desde más de 60 idiomas de origen a 33 idiomas de destino preservando la identidad del hablante original.
¿Puedo usar una voz clonada para el doblaje con IA?
Sí. Una voz clonada puede usarse tanto en Texto a voz como en Doblaje con IA, y nuestra herramienta de doblaje también puede clonar automáticamente la voz de cada hablante durante la localización multilingüe.
¿Cuál es la forma más segura de usar la clonación de voz?
Clona solo a un hablante autorizado, documenta el uso permitido, protege el audio de origen, revisa cada resultado generado y revela que la narración es sintética siempre que tu plataforma, cliente o las normas aplicables lo exijan.