Videosynchronisation ist der Prozess, bei dem der ursprünglich gesprochene Dialog eines Videos durch eine neue Aufnahme in einer anderen Sprache ersetzt wird, wobei Bedeutung, Timing und Seherlebnis erhalten bleiben, sodass das Ergebnis für ein neues Publikum muttersprachlich wirkt. Der neue Dialog kann von menschlichen Sprechern vorgetragen, mit Text-to-Speech generiert oder mit KI-Stimmenklonen nachgebildet werden. Wenn Sie abwägen, ob Sie einen Kanal, eine Kursbibliothek oder ein einzelnes Marketingvideo lokalisieren sollen, erspart Ihnen das Verständnis dessen, was Synchronisation tatsächlich beinhaltet, die falsche Methode zu wählen und später alles neu zu machen.
Der Haken für Anfänger ist, dass Synchronisation niemals nur Übersetzung ist. Eine überzeugende Synchronisation muss Timing, Sprecheridentität, Emotion, Aussprache, Hintergrundton und manchmal sichtbare Lippenbewegungen bewältigen. Wir haben DubSmart AI rund um diese gesamte Kette aufgebaut, damit Sie vom Ausgangsvideo zu einer fertigen mehrsprachigen Tonspur gelangen, ohne separate Tools zusammenfügen zu müssen, und dieser Leitfaden erklärt jeden Bestandteil, damit Sie entscheiden können, was Ihr Projekt wirklich braucht.
Inhaltsverzeichnis
Im einfachsten Fall erstellt die Videosynchronisation eine neue Tonspur in gesprochener Sprache für ein bereits existierendes Video. Ein US-amerikanischer Creator veröffentlicht vielleicht ein Tutorial auf Englisch und fügt spanischen, französischen und deutschen Ton hinzu, sodass die Zuschauer den Dialog in ihrer eigenen Sprache hören, während das Bildmaterial gleich bleibt. Dieses Muster findet sich bei YouTube-Videos und Shorts, Online-Kursen, Filmen und Dokumentationen, Produktdemos, Werbung, Video-Podcasts, Software-Tutorials und Schulungsbibliotheken für Unternehmen.
Was wie ein einfacher Austausch der Tonspur aussieht, besteht tatsächlich aus mehreren koordinierten Elementen: übersetzter Dialog, aufgenommene oder synthetisierte Stimmen, Sprecheridentifikation, Timing-Anpassungen, erhaltene Musik und Soundeffekte, eine saubere finale Abmischung, optionale Lippensynchronisation und manchmal übersetzte Untertitel und Metadaten. Jedes dieser Elemente richtig hinzubekommen, ist das, was eine Synchronisation, die im Video verschwindet, von einer unterscheidet, die die Zuschauer ständig daran erinnert, dass sie eine Übersetzung sehen.
Synchronisation vs. Untertitel, Voice-over und Übersetzung
Diese Begriffe werden oft synonym verwendet, aber sie beschreiben unterschiedliche Aufgaben innerhalb der Lokalisierung, und die falsche zu wählen ist einer der häufigsten Anfängerfehler.
| Format | Was sich ändert | Am besten geeignet für |
|---|---|---|
| Untertitel | Text erscheint auf dem Bildschirm; Originalton bleibt erhalten | Schneller, kostengünstiger Zugang zu übersetzten Inhalten |
| Voice-over | Eine übersetzte Stimme wird über das Original gelegt, das leise hörbar bleibt | Dokumentationen, Nachrichten, Erklärvideos, Schulungen |
| Synchronisation | Der Originaldialog wird durch eine Darbietung in der neuen Sprache ersetzt | Unterhaltung, Kurse, Marketing, immersives Seherlebnis |
| Übersetzung | Wörter werden von einer Sprache in eine andere übertragen | Skripte, Untertitel, Dokumentationsvorbereitung |
| Lokalisierung | Sprache, kulturelle Bezüge, Ton und Grafiken werden angepasst | Globale Kampagnen, Bildung, Software, regionale Inhalte |
Synchronisation ist ein Teil des umfassenderen Lokalisierungsprozesses. Die Übersetzung liefert die Bedeutung; die Synchronisation verwandelt diese Bedeutung in eine gesprochene Darbietung, der ein Publikum ohne Lesen zuhören kann. Wenn Sie einen tiefergehenden Vergleich der beiden häufigsten Optionen wünschen, legt unsere Analyse von Synchronisation versus Untertitel für Video klare Schwellenwerte für beide fest.
Wie Videosynchronisation tatsächlich funktioniert
Ein typischer Arbeitsablauf verkettet fünf Phasen: Transkription, Übersetzung, Stimmerzeugung, Timing-Bearbeitung und Audiomischung. Das Verständnis der Reihenfolge hilft Ihnen zu erkennen, wo sich Fehler einschleichen und wo sich die menschliche Überprüfung am meisten lohnt.
Zunächst wird der Originalton mit Spracherkennung in Text umgewandelt. Dieses Transkript legt genau fest, was übersetzt und vertont werden muss, weshalb es eine sorgfältige Durchsicht verdient. Falsch verstandene Namen, Fachbegriffe, Akzente, überlappende Sprecher und Hintergrundgeräusche erzeugen allesamt Fehler, die sich sonst direkt bis in die fertige Synchronisation durchziehen. Für reine Transkriptionsarbeiten übernimmt unser Speech-to-Text-Tool diesen ersten Schritt eigenständig.
Als Nächstes wird das Transkript übersetzt und angepasst. Gute Synchronisation bedeutet oft Anpassung statt wörtlicher Übersetzung, da sich Sprachen in Satzlänge, Wortstellung, Förmlichkeit, Humor, Redewendungen und Sprechgeschwindigkeit unterscheiden. Eine Zeile kann grammatikalisch perfekt sein und trotzdem laut gesprochen falsch klingen, daher sollte bei öffentlichkeitswirksamen Inhalten ein fließend sprechender Korrekturleser das übersetzte Skript prüfen, bevor Audio generiert wird.
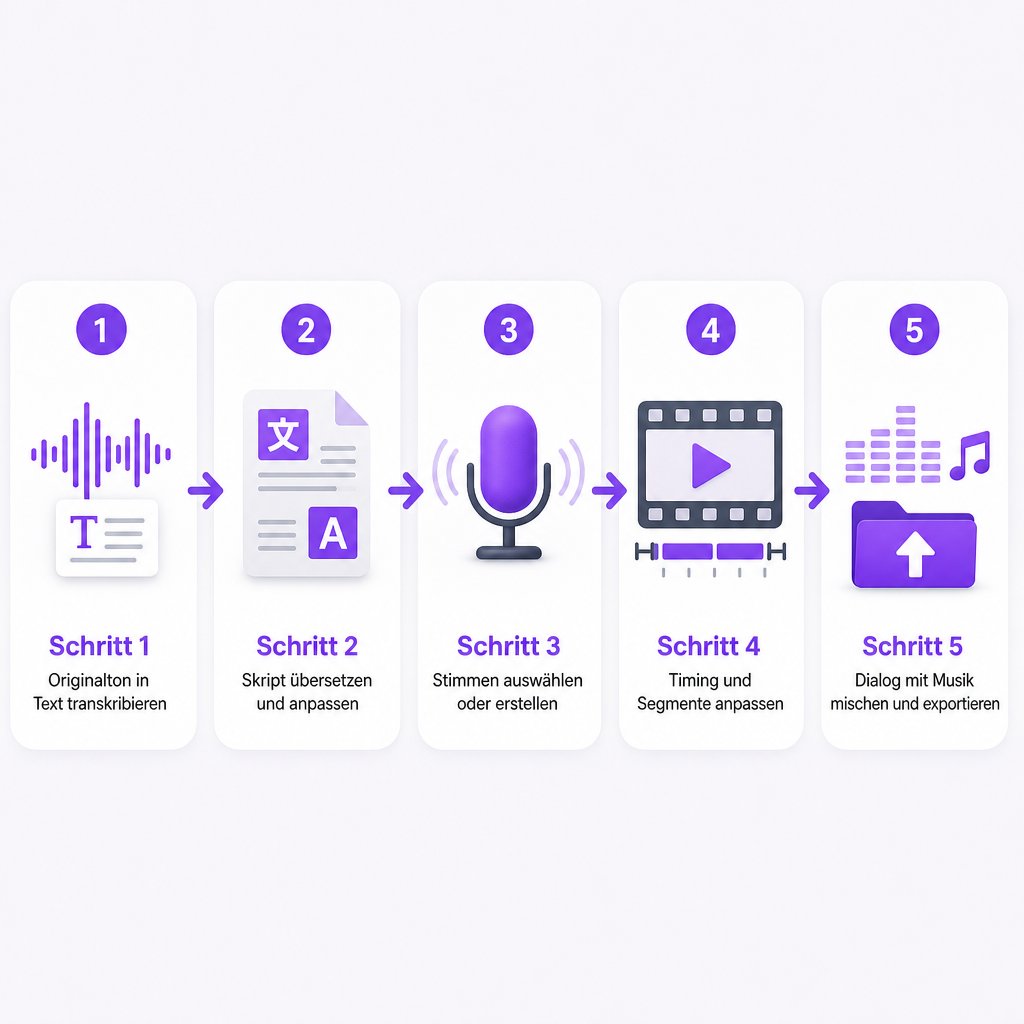
Dann werden Stimmen ausgewählt oder erstellt. Der übersetzte Dialog kann von professionellen Sprechern, dem ursprünglichen Sprecher, einer Standard-Synthesestimme oder einem einwilligungsbasierten KI-Stimmenklon aufgenommen werden. Eine Standard-Text-to-Speech-Stimme ist meist der schnellste Weg, während das Klonen dann wichtig ist, wenn es darum geht, die Identität des Moderators zu bewahren. Auf unserer Seite zu KI-Synchronisation beschreiben wir ein System, das die Stimme jedes Sprechers für mehrsprachige Ausgabe klonen kann und die Synchronisation aus über 60 Ausgangssprachen in 33 Zielsprachen unterstützt; wie bei jeder Plattformfunktion sollten Sie repräsentative Clips testen, bevor Sie sich auf ein großes Projekt festlegen.
Nach der Vertonung folgt das Timing. Übersetzte Sprache entspricht selten der ursprünglichen Länge, daher passen Bearbeiter Sprechgeschwindigkeit, Pausen, Segmentgrenzen und den Sprecherwechsel an. Unser Dubbing Studio bietet Steuerungen zum Bearbeiten von Timings, Ändern der Sprechgeschwindigkeit, erneuten Generieren einzelner Segmente und Anpassen der Hintergrundton-Lautstärke, was in Tutorials, Interviews, Werbung und jeder Aufnahme, bei der der Mund des Sprechers sichtbar ist, am wichtigsten ist.
Schließlich wird der neue Dialog wieder mit Musik und Soundeffekten abgemischt. Wenn der Originaldialog entfernt werden muss, trennt das System zunächst die Sprache von der Hintergrundtonspur; wenn das Ausgangsvideo mit separaten Spuren für Dialog, Musik und Effekte vorliegt, ist dieser Schritt deutlich sauberer. Für Fälle, in denen Sie nur eine einzige gemischte Spur haben, isoliert unser Speech Separator die Stimme, sodass Musik und Effekte den Prozess überstehen. Bevor Sie veröffentlichen, hören Sie einmal durch und achten Sie auf falsche Namen, falsch zugeordnete Sprecher, falsche Aussprachen, unangenehme Pausen, flache Emotionen, zu kurze oder zu lange Zeilen und Musik, die die Sprache überdeckt. KI beschleunigt all dies, aber die menschliche Überprüfung schützt weiterhin alles, was eine Marke repräsentiert oder rechtliche, medizinische, finanzielle oder sicherheitsrelevante Aussagen enthält.
Die vier Haupttypen der Videosynchronisation
Vier Produktionsansätze decken nahezu jedes Projekt ab, und jeder gewichtet Kosten, Geschwindigkeit und Kontrolle unterschiedlich.
Menschliche Synchronisation lässt Sprecher das übersetzte Skript vortragen und bietet die stärkste Kontrolle über Emotion, Charakterinterpretation, Akzente und kulturelle Nuancen. Sie eignet sich für Filme, hochwertige Serien, komplexen Humor und alles, bei dem die Regie der Sprachdarbietung zentral ist. Die Nachteile sind höhere Kosten, längere Zeitpläne und schwierigere Terminplanung.
Traditionelles Voice-over legt einen übersetzten Erzähler über Ton, der teilweise hörbar bleibt. Es ist Standard für Dokumentationen, Interviews, Nachrichten und Bildung und ist schneller als eine vollständige Synchronisation, da eine präzise Lippensynchronisation meist unnötig ist.
Text-to-Speech-Synchronisation erzeugt eine Stimme direkt aus dem übersetzten Skript, was sich für Creator eignet, die viele Sprachen, häufige Aktualisierungen oder schnelle Durchlaufzeiten benötigen. Sie funktioniert gut für Tutorials, Produkterklärungen, interne Schulungen, vertonte Präsentationen, Kurzformate und frühe Lokalisierungstests. Für reine Sprachprojekte bietet unser Text-to-Speech-Tool die KI-Stimmen und Klonoptionen, um dies zu tun, ohne das Video anzutasten.
KI-Stimmenklon-Synchronisation versucht, die stimmliche Identität des ursprünglichen Sprechers über Sprachen hinweg zu bewahren, sodass ein Creator eine wiedererkennbare Kanalstimme behalten kann, ohne jede Sprache persönlich aufzunehmen. Sie trägt zudem die größten Verantwortlichkeiten in Bezug auf Einwilligung, Datenschutz und Rechte: dokumentieren Sie, wem die Stimme gehört, welche Sprachen und Kanäle abgedeckt sind, wie lange die Erlaubnis gilt und ob der Ton bearbeitet oder wiederverwendet werden darf.
Wann Synchronisation Untertitel schlägt
Synchronisation ist die bessere Wahl, wenn Zuschauer gesprochenen Informationen folgen müssen, ohne ständig zu lesen. Greifen Sie darauf zurück, wenn das Video dialoglastig ist, ein Teil Ihres Publikums eine andere Sprache bevorzugt, der Inhalt lehrreich ist, Sie ein Video erhalten und zugleich Sprachoptionen hinzufügen möchten, die Darbietung des Sprechers wichtig ist, Sie regelmäßig neu veröffentlichen oder einen Kanal international ausbauen.
Untertitel können gewinnen, wenn das Budget sehr begrenzt ist, das Video wenig Dialog enthält, Sie schnell eine Übersetzung benötigen, die Originaldarbietung entscheidend ist, Ihr Publikum gerne liest oder Sie durchsuchbaren Bildschirmtext wünschen. In der Praxis setzen viele Publisher beides ein: Synchronisation verbessert den Hörkomfort, während Untertitel Zuschauern dienen, die gehörlos oder schwerhörig sind, die Sprache lernen, stummgeschaltet zuschauen oder den genauen Wortlaut prüfen.
So wählen Sie die richtige Synchronisationsmethode
Die richtige Methode hängt vom Projekt ab, nicht allein von der Technologie. Diese Matrix stellt die drei KI-relevanten Wege den Faktoren gegenüber, die ein Projekt in der Regel entscheiden.
| Entscheidungsfaktor | Menschliche Synchronisation | Standard-KI-Stimme | KI-Stimmenklon |
|---|---|---|---|
| Emotionale Darbietung | Stärkste Kontrolle | Variiert je nach Stimme und Modell | Behält einige Sprechermerkmale bei |
| Produktionsgeschwindigkeit | Am langsamsten | Schnell | Schnell nach der Einrichtung |
| Kosten bei hohem Volumen | Teurer | Meist effizient | Effizient für wiederkehrende Inhalte |
| Sprecheridentität | Neuer Darsteller | Neue synthetische Stimme | Darauf ausgelegt, die Originalstimme zu bewahren |
| Komplexität der Einwilligung | Darstellervereinbarung | Stimmlizenz ist weiterhin relevant | Höchste Rechtesensibilität |
| Beste Eignung | Filme, Premium, Charakterarbeit | Tutorials, Erklärvideos, Schulungen | Von Creatorn geführte wiederkehrende Kanäle |
Für ein kleines Unternehmen oder einen einzelnen Creator ist KI-Synchronisation oft der praktische Weg, die Nachfrage in einer oder zwei Sprachen zu testen, bevor eine ganze Bibliothek lokalisiert wird. Entwickler und Agenturen, die Automatisierung statt eines Browser-Workflows benötigen, können unsere AI Dubbing API für mehrsprachige Videos und unsere Voice Cloning API anbinden, um benutzerdefinierte Stimmen aus Audioproben zu erstellen. Wenn Sie ein Tool bewerten, prüfen Sie die Sprachabdeckung in beide Richtungen, ob Sie das übersetzte Transkript vor der Audioerzeugung bearbeiten können, wie gut Sprecher identifiziert werden, die Timing-Steuerungen, die Behandlung des Hintergrundtons sowie die Export- und Vorschauoptionen.
Synchronisierten Ton auf YouTube veröffentlichen
YouTube unterstützt zwei verschiedene Wege. Mit mehrsprachigem Audio laden Sie Ihre eigenen synchronisierten Tonspuren zu einem einzelnen Video hoch; mit automatischer Synchronisation generiert YouTube übersetzten Ton für Sie. YouTube gibt an, dass mehrsprachiges Audio zu neuen oder bestehenden Videos hinzugefügt werden kann, dass Sie die synchronisierte Datei selbst bereitstellen und dass die Datei ein reines Audioformat sein sollte, das in etwa der Länge des Videos entspricht. Es weist außerdem darauf hin, dass Zuschauer die Tonspuren im Player wechseln können, dass übersetzte Titel und Beschreibungen die Auffindbarkeit fördern und dass die Funktion aktivierte erweiterte Funktionen erfordert.
Die praktische Frage für alle, die eine externe Synchronisationsplattform nutzen, ist, ob sie eine fertige Tonspur zum Originalvideo hochladen oder auf die automatische Synchronisation setzen sollen. Eine extern produzierte Tonspur gibt Ihnen mehr Kontrolle über Übersetzung, Stimme, Timing und Überprüfung, weshalb Creator, denen Markenkonsistenz wichtig ist, die Synchronisation meist selbst besitzen, anstatt sie der automatisierten Erzeugung zu überlassen. Wenn Sie einen Kanal im großen Maßstab betreiben, behandelt unser Leitfaden zum Aufbau eines mehrsprachigen YouTube-Kanals, wie Sie Sprachen nach Publikumsnachfrage priorisieren.
Risiken, Rechte und Einschränkungen, die zu bedenken sind
Synchronisation hat reale Fehlerquellen, und sie im Voraus zu kennen, bewahrt ein erstes Projekt davor, schiefzugehen.
Bedeutungen können sich verschieben, selbst wenn eine Übersetzung technisch korrekt ist, da Slang, Humor und kulturell spezifische Beispiele nicht immer übertragbar sind. Die Spracherkennung stolpert über Namen, Akzente, überlappende Dialoge, schwache Mikrofone und Geräusche, was der Hauptgrund ist, das Transkript zu überprüfen, bevor eine Übersetzung genehmigt wird. Synthetische Stimmen können ungewöhnliche Wörter falsch aussprechen, Emotionen abflachen oder die Aussprache zwischen Segmenten variieren lassen. Lippensynchronisation ist nie garantiert, da übersetzte Sätze oft länger oder kürzer sind als das Original; eine Synchronisation kann vollkommen verständlich sein, ohne vollkommen synchron zu sein.
Stimmrechte verdienen die größte Aufmerksamkeit. Das U.S. Copyright Office beschreibt eine digitale Nachbildung als Audio, Video oder Bild, das digital erstellt oder manipuliert wurde, um eine Person realistisch, aber fälschlicherweise darzustellen, und sein Bericht identifiziert Risiken wie Betrug, falsche Empfehlungen, Rufschädigung, Belästigung und die Verdrängung von Darstellern. Es erklärt zudem, dass sich der Schutz auf bundesstaatliche Persönlichkeits- und Datenschutzgesetze, das Urheberrecht an der zugrunde liegenden Aufnahme, Verbraucherschutzvorschriften und Verträge stützen kann, mit Ergebnissen, die je nach Situation und Rechtsordnung variieren. Bevor Sie eine identifizierbare Stimme klonen, holen Sie eine klare schriftliche Erlaubnis ein, die die einwilligende Person, die konkrete Probe, zulässige Sprachen, zulässige Inhalte und Kanäle, kommerzielle Nutzung, Dauer, Bearbeitungs- und Wiederverwendungsrechte, Vergütung, Datenaufbewahrung und was beim Ende der Erlaubnis geschieht, abdeckt. Dies ist eine praktische Rechte-Checkliste, keine Rechtsberatung; für kommerzielle Kampagnen, Unterhaltungsarbeiten oder Stimmen Dritter konsultieren Sie qualifizierten Rechtsbeistand.
Schließlich gelten die Plattformrichtlinien. YouTube gibt an, dass eine sekundäre Tonspur entfernt werden kann, wenn urheberrechtlich geschützte Inhalte erkannt werden, die vom Original abweichen, sodass das Klären von Musik- und Quellrechten ebenso wichtig ist wie das Klären der Stimme.
Wählen Sie für ein erstes Projekt ein kurzes, gut aufgenommenes Video mit einem oder zwei Sprechern, beginnen Sie mit einer einzigen Zielsprache und überprüfen Sie das gesamte Ergebnis, bevor Sie skalieren. Vergleichen Sie Transkriptionsgenauigkeit, Übersetzungsgenauigkeit, Natürlichkeit der Stimme, Sprecherkonsistenz, Timing, Qualität des Hintergrundtons, Zuschauerreaktion, Produktionszeit und Kosten pro fertiger Minute. Für einen Kanal veröffentlichen Sie zuerst Ihre stärkste Sprache und nutzen Wiedergabezeit, Standort des Publikums, Bindung und Kommentare, um zu entscheiden, ob weitere Sprachen lohnenswert sind.
Häufig gestellte Fragen
Was ist Videosynchronisation in einem Satz?
Videosynchronisation ersetzt den ursprünglich gesprochenen Dialog eines Videos durch eine Audiodarbietung in einer neuen Sprache, wobei das Bildmaterial und die Gesamtbedeutung erhalten bleiben.
Ist Synchronisation besser als Untertitel?
Keines ist allgemein besser. Synchronisation ist bequemer für Zuschauer, die lieber in ihrer Sprache zuhören, während Untertitel in der Regel schneller und günstiger sind. Beides zu verwenden bietet die breiteste Zugänglichkeit.
Kann ich ein YouTube-Video in eine andere Sprache synchronisieren?
Ja. Sie können mit einem Synchronisationstool oder Sprechern eine übersetzte Tonspur erstellen und sie über die mehrsprachige Audiofunktion von YouTube hochladen, wenn Ihr Kanal Zugriff hat. Die Tonspur sollte eine reine Audiodatei sein und in etwa die gleiche Länge wie das Video haben.
Ist KI-Synchronisation dasselbe wie Videosynchronisation?
Nein. Videosynchronisation ist der umfassendere Prozess, den Dialog eines Videos in einer anderen Sprache zu ersetzen. KI-Synchronisation ist eine Möglichkeit, dieses Ergebnis mithilfe von automatisierter Transkription, Übersetzung, Sprachsynthese, Stimmenklonen und Audioverarbeitung zu erzielen.
Wie viele Sprachen unterstützt DubSmart für die Synchronisation?
Wir unterstützen die Synchronisation aus über 60 Ausgangssprachen in 33 Zielsprachen, mit Stimmenklonen und Bearbeitungssteuerungen für Timing, Sprechgeschwindigkeit, einzelne Segmente und Hintergrundton. Testen Sie repräsentative Clips für Ihr spezifisches Sprachpaar, bevor Sie ein großes Projekt starten.