Sprache-zu-Sprache-Übersetzung wandelt gesprochene Wörter einer Sprache in hörbare Sprache einer anderen um, sodass Ihr Publikum die Übersetzung hört, anstatt sie zu lesen. Stellen Sie sich eine Dozentin vor, die eine Lektion auf Englisch aufgenommen hat und nun eine spanische Version benötigt, ohne irgendetwas neu aufnehmen zu müssen: Das System transkribiert das Englische, übersetzt die Bedeutung und erzeugt an dessen Stelle spanisches Audio. Dieser Wechsel vom Lesen zum Hören ist der eigentliche Zweck, und er verändert die Art, wie Sie mehrsprachige Inhalte planen, prüfen und veröffentlichen.
Die eigentliche Frage ist selten, ob die Technologie funktioniert. Es geht darum, welche Version davon Sie benötigen: aufgezeichnete Übersetzung für Videos, Kurse und Podcasts; nahezu Echtzeit-Übersetzung für Meetings und Veranstaltungen; stimmerhaltende Ausgabe, die die Identität des ursprünglichen Sprechers bewahrt; oder eine API, die Sie in Ihre eigene Anwendung einbinden können. Jeder dieser Wege bringt unterschiedliche Kompromisse bei Qualität, Latenz und Prüfaufwand mit sich, und dieser Leitfaden stellt sie dar, damit Sie mit offenen Augen wählen können.
Inhaltsverzeichnis
So funktioniert die Sprache-zu-Sprache-Übersetzung
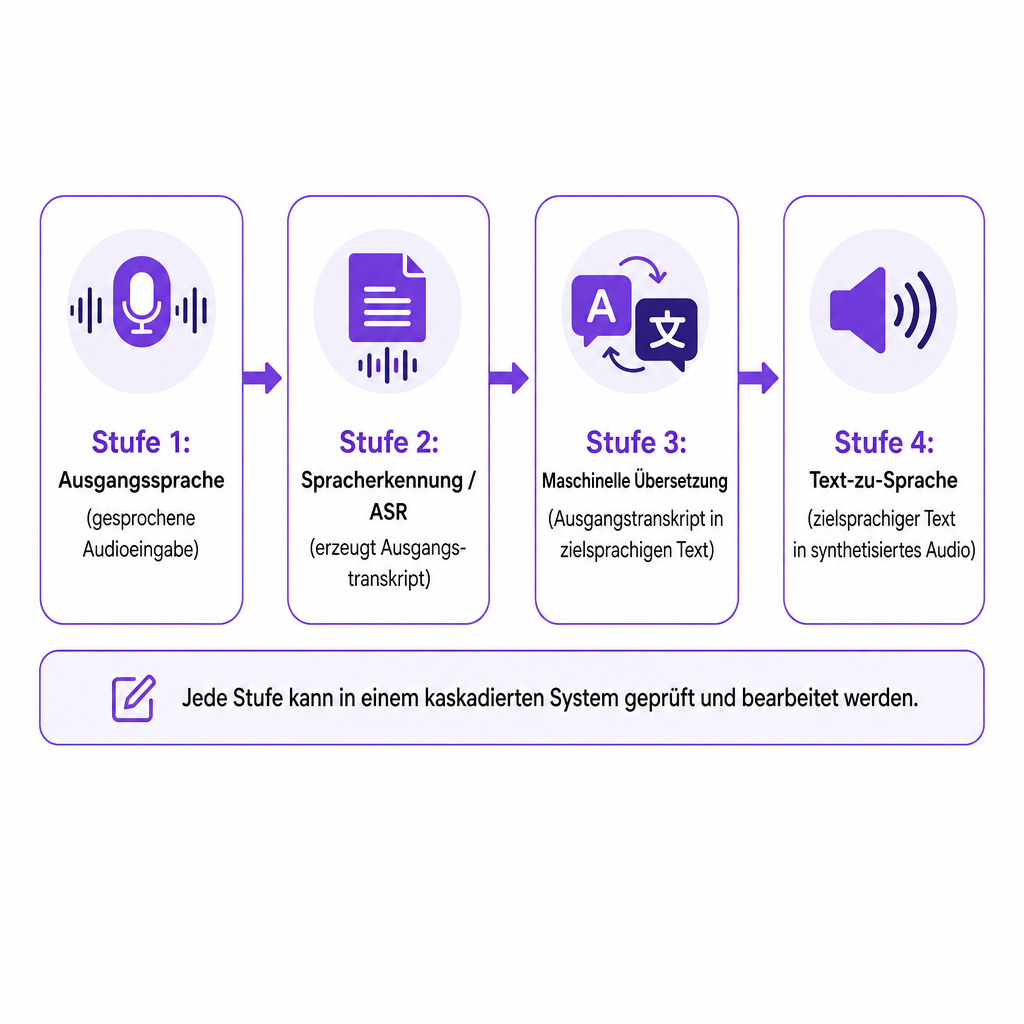
Die meisten Systeme nutzen eine verbundene Pipeline aus drei Technologien. Zuerst analysiert die automatische Spracherkennung (ASR) das Quellaudio und erstellt ein Transkript. Als Nächstes wandelt die maschinelle Übersetzung diesen Text der Ausgangssprache in die Zielsprache um. Schließlich verwandelt die Text-zu-Sprache den übersetzten Text in gesprochenes Audio. Der Ablauf liest sich klar als Quellsprache, dann Erkennung, dann übersetzter Text, dann synthetisierte Sprache.
Quellsprache → Spracherkennung → übersetzter Text → synthetisierte Sprache
Dieses mehrschichtige Design wird als kaskadierte Sprache-zu-Sprache-Übersetzung bezeichnet, und die NIST-Veröffentlichung zur Bewertung der Sprachübersetzung beschreibt dieselbe Struktur: ASR erstellt das Quelltranskript, die maschinelle Übersetzung erzeugt den Text in der Zielsprache, und die Text-zu-Sprache generiert die gesprochene Ausgabe. Der Vorteil einer Kaskade besteht darin, dass jede Stufe überprüfbar ist, sodass Sie ein Transkript oder eine Übersetzung korrigieren können, bevor das Audio überhaupt erzeugt wird.
Ein neuerer Ansatz trainiert ein End-to-End-Modell, das Quellaudio direkt auf Audio in der Zielsprache abbildet, ohne separate Transkriptions- und Synthesestufen offenzulegen. Forschung, die über den technischen DTIC-Bericht zur direkten Sprachübersetzung geteilt wurde, stellt dies als eine Möglichkeit dar, Verzögerungen zu reduzieren und mehr von der ursprünglichen Stimme des Sprechers zu bewahren, merkt jedoch an, dass dabei weiterhin Kompromisse bei Geschwindigkeit, Kontext, Sprachabdeckung und Ausgabequalität gemacht werden. In der Praxis gibt Ihnen die Kaskade mehr redaktionelle Kontrolle; der End-to-End-Ansatz strebt geringere Latenz und Stimmkontinuität an.
Sprache-zu-Sprache-Übersetzung im Vergleich zu verwandten Aufgaben
Menschen vermischen oft Sprache-zu-Sprache-Übersetzung mit Transkription, Textübersetzung und Synchronisation, aber jede davon endet mit einem anderen Ergebnis. Die Textübersetzung endet bei schriftlicher Ausgabe. Die Sprache-zu-Sprache-Übersetzung endet mit gesprochener Ausgabe, auch wenn ein kaskadiertes System intern weiterhin Text als Zwischenrepräsentation verwendet. Die Klärung der Eingaben und Ausgaben bewahrt Sie davor, das falsche Werkzeug für die Aufgabe zu wählen.
| Technologie | Eingabe | Ausgabe | Typische Verwendung |
|---|---|---|---|
| Sprache zu Text | Gesprochenes Audio | Schriftliches Transkript | Untertitel, Notizen, durchsuchbare Inhalte |
| Textübersetzung | Schriftlicher Text | Übersetzter Text | Dokumente, Untertitel, Webseiten |
| Text zu Sprache | Schriftlicher Text | Synthetische Sprache | Erzählung, Barrierefreiheit, Sprachschnittstellen |
| Sprache-zu-Sprache-Übersetzung | Gesprochenes Audio | Übersetzte Sprache | Gespräche, Synchronisation, mehrsprachige Medien |
Die Synchronisation verdient eine eigene Abgrenzung. Die Sprache-zu-Sprache-Übersetzung konzentriert sich eng auf den Wechsel der gesprochenen Sprache. Synchronisation ist der umfassendere Workflow der Medienlokalisierung, der sie umschließt: Übersetzung von Dialogen, Zuordnung von Sprechern, Erzeugung neuer Stimmen, Anpassung des Timings, Mischung übersetzter Stimmen mit Musik und Hintergrundaudio sowie Export eines fertigen Projekts. Für ein aufgezeichnetes YouTube-Video, einen Online-Kurs, einen Podcast oder einen Film ist die Synchronisation in der Regel das praktischere Format, da sie diese redaktionellen Kontrollmöglichkeiten über die Übersetzung hinaus hinzufügt. Wenn Sie zwischen Audio und Bildschirmtext abwägen, führt unser Erklärtext zu Synchronisation versus Untertitel für Videos durch diese spezielle Entscheidung, und die umfassenderen Mechanismen finden Sie in unserem Leitfaden dazu, was KI-Synchronisation ist und wie sie funktioniert.
Die drei Komponenten, die über die Qualität entscheiden
Die Ausgabequalität ist keine einzelne Zahl. Sie ist das Produkt aus drei Stufen, jede mit ihren eigenen Fehlermöglichkeiten, daher ist es hilfreich, sie separat zu bewerten, anstatt sich auf einen Gesamteindruck zu verlassen.
Die automatische Spracherkennung identifiziert die Wörter in der Quellaufnahme, und ihre Genauigkeit sinkt bei Hintergrundmusik, überlappenden Sprechern, starken Akzenten, schnellem oder unvollständigem Sprechen, fachspezifischen Begriffen, schlechten Mikrofonen und Code-Switching zwischen Sprachen. Eine gängige Kennzahl hier ist die Wortfehlerrate (WER), die ein automatisches Transkript mit einer menschlichen Referenz vergleicht, indem sie Ersetzungen, Streichungen und Einfügungen zählt. Dieselbe NIST-Veröffentlichung verwendet die WER als Erkennungs-Benchmark, obwohl eine niedrige WER nicht bestätigt, dass die spätere Übersetzung Bedeutung oder Ton bewahrt hat. Wenn Ihr Quellaudio verrauscht ist, kann das vorherige Isolieren sauberer Sprache mit einem Werkzeug wie unserem Sprach-Separator die Erkennungsgenauigkeit erhöhen, noch bevor die Übersetzung überhaupt beginnt.
Die maschinelle Übersetzung muss mehr als einzelne Wörter interpretieren. Sie bewältigt Satzstruktur, Kontext, Pronomen und Geschlecht, Redewendungen, Humor, Förmlichkeit, kulturelle Bezüge, Fachterminologie und Unterschiede in der Wortstellung. Eine wörtliche Übersetzung kann grammatikalisch korrekt sein, aber dennoch unnatürlich klingen oder die beabsichtigte Bedeutung unmerklich verändern, was besonders riskant ist bei Werbeaussagen, rechtlichen Anweisungen, medizinischen Informationen, Finanzinhalten und Lehrmaterial.
Die Sprachsynthese erzeugt die endgültige Stimme in der Zielsprache und steuert Aussprache, Pausen, Sprechtempo, Intonation, Betonung, emotionalen Ton, Stimmidentität sowie Akzent oder Sprachvariante. Unser Produkt Text-zu-Sprache bietet mehr als 300 KI-Stimmen, mehrsprachige Generierung und Voice Cloning in 33 Sprachen mit Steuerung für Sprechtempo, Betonung, Zahlenlesung und emotionale Wiedergabe. Eine technisch korrekte Übersetzung kann dennoch schlecht ankommen, wenn die Wiedergabe nicht zur Marke, zum Kurs oder zur Dokumentation passt, zu der sie gehört.
Voice Cloning in übersetzter Sprache
Voice Cloning ist optional, aber es ist das, was übersetzte Inhalte wie denselben Urheber wirken lässt, statt wie einen Fremden, der ein Skript vorliest. Anstatt jeder Sprache eine unzusammenhängende Standardstimme zuzuweisen, kann ein System eine Darbietung in der Zielsprache erstellen, die auf der stimmlichen Identität des ursprünglichen Sprechers basiert. Diese Kontinuität ist wichtig für einen Kanal, der eine wiedererkennbare Stimme über mehrere Sprachen hinweg wünscht, ein Unternehmen mit einem bekannten Moderator, einen langen dozentengeführten Kurs, einen Filmemacher, der Konsistenz über synchronisierte Versionen hinweg benötigt, oder einen Podcast-Moderator, der einen vertrauten Klang in übersetzten Episoden beibehält.
Es ist keine Garantie. Cloning bewahrt die stimmliche Identität, aber Emotion, Humor, Tempo, Aussprache und kultureller Kontext brauchen vor der Veröffentlichung weiterhin einen menschlichen Durchgang. Ebenso wichtig ist die Autorisierung: Ein verantwortungsvoller Workflow bestätigt, dass die Person, die die Aufnahme bereitgestellt hat, dem Cloning zugestimmt hat und dass die daraus entstehende Stimme für die beabsichtigte kommerzielle, öffentliche oder geografische Verbreitung verwendet werden darf. Wenn Sie an den Mechanismen dahinter interessiert sind, geht unser Überblick dazu, wie Voice Cloning funktioniert, tiefer, und das Voice-Cloning-Werkzeug zeigt die Produktionsseite.
Aufgezeichnete Übersetzung im Vergleich zur Echtzeit-Übersetzung
Dies ist die Entscheidung, mit der die meisten Teams tatsächlich konfrontiert sind, und die beiden Modi sollten nicht mit demselben Maßstab beurteilt werden.
Die aufgezeichnete Übersetzung passt in der Regel besser zur Medienproduktion, weil sie Ihnen Zeit zum Arbeiten gibt. Sie können das Transkript korrigieren, Terminologie bearbeiten, die Übersetzung prüfen, Sprecher identifizieren, das Timing anpassen, Stimmen neu generieren, Hintergrundaudio mischen und eine menschliche Qualitätssicherung durchführen, bevor etwas veröffentlicht wird. Das macht sie gut geeignet für YouTube-Kanäle, E-Learning, Unternehmensschulungen, Podcasts, Produktvideos und unabhängige Filme.
Die Echtzeit-Übersetzung arbeitet unter einer härteren Einschränkung: Sie muss mit der Ausgabe beginnen, bevor der Sprecher einen Satz beendet hat. Mehr Kontext verbessert die Übersetzungsqualität, erhöht aber die Verzögerung, während kürzere Verzögerungen Vorhersagen oder Teilübersetzungen erzwingen, und Fehler lassen sich schwer zurücknehmen, sobald das Audio bereits abgespielt wurde. Der DTIC-Bericht merkt an, dass frühere kaskadierte Systeme oft mit vier- bis fünfsekündigen Verzögerungen liefen, Fehler über die Stufen hinweg anhäuften und begrenzte Personalisierung aufwiesen, und dass eine Erhöhung des Vorausschauens eines Modells die Qualität steigern kann, während die Interaktion weniger unmittelbar wirkt. Eine Live-Konferenzfunktion und eine ausgefeilte mehrsprachige Synchronisation lösen unterschiedliche Probleme, halten Sie sie also an unterschiedlichen Maßstäben fest.
So bewerten Sie einen Sprache-zu-Sprache-Workflow
Testen Sie mit einer repräsentativen Probe, nicht mit einem sauberen Demosatz. Die folgende Checkliste spiegelt die realen Bedingungen wider, auf die Ihre Inhalte stoßen werden, und sie hält die Bewertung ehrlich.
- Sprach- und Dialektabdeckung: „Unterstützt Spanisch" bedeutet möglicherweise nicht den Akzent, den Wortschatz oder die regionalen Präferenzen, die Ihr Publikum erwartet. Bestätigen Sie die Ausgangs- und Zielvarianten, einschließlich US-amerikanischem gegenüber anderem Englisch, lateinamerikanischem gegenüber europäischem Spanisch und kanadischem gegenüber europäischem Französisch.
- Transkriptgenauigkeit: Eine Übersetzung kann ein Transkript, das Namen, Zahlen oder Produktbegriffe verstümmelt, nicht zuverlässig korrigieren. Prüfen Sie, ob Sie das Transkript vor der Audiogenerierung einsehen und bearbeiten können.
- Bedeutung und Kontext: Testen Sie gezielt Redewendungen, Witze, Handlungsaufforderungen, Produktaussagen und Branchenterminologie. Flüssigkeit ist nicht Genauigkeit.
- Umgang mit Sprechern: Überprüfen Sie bei Interviews, Podiumsdiskussionen und Filmen, ob das Werkzeug mehrere Sprecher identifizieren und ihre Stimmen konsistent halten kann, auch wenn sich Personen gegenseitig unterbrechen.
- Timing und Synchronisation: Übersetzte Sätze stimmen selten mit der ursprünglichen Dauer überein. Achten Sie auf Timing- oder Sprechtempo-Steuerungen sowie Dialogbearbeitungen, Erhaltung von Hintergrundaudio, Lautstärkeanpassung, Segment-Regenerierung und bei Bedarf visuelle Ausrichtung.
- Natürlichkeit der Stimme: Achten Sie auf Aussprache, Pausen, Betonung, emotionale Bandbreite und unnatürlichen Rhythmus.
- Latenz: Messen Sie bei Live-Nutzung die Verzögerung zwischen Sprecher und Audio. Priorisieren Sie bei aufgezeichneter Nutzung die Bearbeitungsflexibilität gegenüber der reinen Verarbeitungsgeschwindigkeit.
- Prüf- und Exportkontrollen: Ein produktionsreifes Werkzeug ermöglicht es Ihnen, Text zu korrigieren, einzelne Segmente neu zu generieren, das Timing anzupassen und in einem Format zu exportieren, das Ihr Veröffentlichungs-Workflow akzeptiert.
Lassen Sie diese Proben durch Ihre engere Auswahl laufen und vergleichen Sie Transkriptgenauigkeit, Übersetzungsbedeutung, Aussprache, Natürlichkeit der Stimme, Sprecherkonsistenz, Timing, Qualität des Hintergrundaudios, Prüfaufwand und Gesamtkosten bei Ihrem erwarteten Volumen. Das stärkste System ist nicht dasjenige mit den meisten Stimmen oder Sprachen. Es ist dasjenige, das akzeptable Ergebnisse für Ihre spezifischen Inhalte mit einem Prüfaufwand liefert, den Ihr Team tatsächlich dauerhaft bewältigen kann.
Risiken und Einschränkungen, die man einplanen sollte
Jede Stufe führt ihre eigene Art von Fehlern ein, und eine natürlich klingende Stimme kann sie alle verbergen. KI kann mehrdeutige Ausdrücke, Namen, Redewendungen und Fachbegriffe falsch übersetzen, daher bleibt menschliche Prüfung überall dort unerlässlich, wo Genauigkeit rechtliches, sicherheitsrelevantes, finanzielles oder reputationsbezogenes Gewicht hat. Erkennungsfehler verschärfen das Problem: Rauschen, Nebengeräusche, Akzente und schlechte Aufnahmen können dazu führen, dass das System die Quelle verhört, weshalb die Überprüfung des Transkripts vor der Freigabe der Übersetzung nicht verhandelbar ist.
Kulturelle Bedeutung geht leicht verloren. Eine direkte Übersetzung kann Humor, Höflichkeit oder Bezüge weglassen, die nur eine Umformulierung statt eines Wort-für-Wort-Durchgangs überleben. Voice Cloning fügt Einwilligungs- und Identitätsmissbrauchsrisiken hinzu, dokumentieren Sie also, wer die Stimme autorisiert hat, den Nutzungsumfang, das Gebiet, die Dauer und ob sie in Werbung oder synthetischen öffentlichen Aussagen erscheinen darf. Es gibt auch eine Dimension des Publikumsvertrauens: Der DTIC-Bericht beschreibt, wie eine Übersetzungserfahrung Nutzer darüber informiert, dass das übersetzte Audio synthetisch erzeugt wurde, eine angemessene Erwartung, die Sie bei Ihren eigenen Offenlegungen einplanen sollten.
Zwei leisere Risiken runden die Liste ab. Datenschutz ist wichtig, wann immer Audio persönliche Informationen, vertrauliche Gespräche, Kundendaten oder unveröffentlichte Inhalte enthält, überprüfen Sie also die Datenverarbeitungs-, Aufbewahrungs-, Zugriffs- und Löschbestimmungen eines Anbieters vor dem Hochladen. Und falsches Vertrauen ist das heimtückischste Versagen von allen: Eine ausgefeilte Stimme lässt eine falsche Übersetzung autoritativ klingen, betrachten Sie Flüssigkeit also niemals als Beweis für sachliche Richtigkeit.
Wo DubSmart passt
Wir sind am unmittelbarsten relevant für die aufgezeichnete Sprache-zu-Sprache-Übersetzung durch KI-Synchronisation, statt irgendeinen Anspruch auf universelle Live-Gesprächsübersetzung zu erheben. Unser Synchronisations-Workflow akzeptiert Audio- und Video-Uploads sowie YouTube-Links, unterstützt mehr als 60 Ausgangssprachen und 33 Zielsprachen, klont die Stimme jedes Sprechers für die übersetzte Version und ermöglicht Ihnen, Text, Sprecher und Timings zu bearbeiten, Segmente neu zu generieren, die Lautstärke des Hintergrundklangs anzupassen und das fertige Projekt herunterzuladen. Genau diese redaktionelle Ebene ist das, was die aufgezeichnete Medienproduktion braucht.
Für Teams, die ihre eigenen Pipelines aufbauen, bieten wir außerdem APIs für KI-Synchronisation, Text-zu-Sprache und Voice Cloning an, die sich für Agenturen, Medien-Workflows und Anwendungen eignen, die die mehrsprachige Sprachproduktion automatisieren müssen. Die richtige Wahl hängt davon ab, ob Ihr Projekt einen fertigen Medieneditor, eine API-gesteuerte Pipeline oder beides wünscht. Für eine kurze Nachricht mit hohem Einsatz können professionelle menschliche Übersetzung und Aufnahme immer noch gewinnen; für eine große, häufig aktualisierte Inhaltsbibliothek skaliert ein KI-Workflow besser, wobei sich die menschliche Prüfung auf das risikoreichste Material konzentriert.
Häufig gestellte Fragen
Ist die Sprache-zu-Sprache-Übersetzung dasselbe wie Dolmetschen?
Nein. Menschliches Dolmetschen beruht darauf, dass eine geschulte Person im Moment zuhört, versteht und die Bedeutung vermittelt. Die Sprache-zu-Sprache-Übersetzung ist automatisiert: schnell und skalierbar, aber sie kann eine Prüfung erfordern und hat möglicherweise Schwierigkeiten mit Nuancen, die ein professioneller Dolmetscher auf natürliche Weise bewältigt.
Funktioniert sie immer in Echtzeit?
Nein. Einige Systeme verarbeiten aufgezeichnetes Audio mit vollständiger Bearbeitungskontrolle, während andere Live- oder nahezu Echtzeit-Ausgabe bieten. Live-Systeme balancieren ständig Übersetzungskontext, Latenz und Genauigkeit.
Kann sie die Stimme des ursprünglichen Sprechers bewahren?
Manchmal. Systeme, die Voice Cloning oder stimmerhaltende Synthese verwenden, können die Identität des ursprünglichen Sprechers modellieren, aber das Ergebnis hängt von der Technologie, dem Sprachpaar, der Audioqualität und der Autorisierung zur Nutzung dieser Stimme ab.
Ist KI-Synchronisation eine Form der Sprache-zu-Sprache-Übersetzung?
Ja. KI-Synchronisation ist eine Anwendung der Sprache-zu-Sprache-Übersetzung für aufgezeichnete Medien, die Bearbeitung, Sprecherverwaltung, Timing, Mischung und Exportfunktionen über die Kernübersetzung hinaus hinzufügt.
Wie genau ist sie?
Die Genauigkeit variiert je nach Sprache, Aufnahmequalität, Terminologie, Sprecher und System. Bewerten Sie das Transkript, die Übersetzung und das erzeugte Audio separat, statt sich auf einen einzelnen Genauigkeitsprozentsatz zu verlassen.