Wenn Sie ein Video haben, das funktioniert, und fünf Märkte, die es nicht hören können, ist mehrsprachige Voiceover-Produktion der Weg, diese Lücke zu schließen. Was ist also mehrsprachiges Voiceover, einfach ausgedrückt? Es ist der Prozess, gesprochenes Audio für denselben Inhalt in mehr als einer Sprache zu produzieren, sodass ein einziges Tutorial, eine Produktdemo, ein Kurs oder ein Podcast ein Publikum erreicht, das Ihre Originalsprache nicht teilt. Ein übersetztes Skript wird von einem Sprecher aufgenommen, mit Text-to-Speech generiert oder mit einem einwilligungsbasierten Voice-Clone erstellt und dann wieder mit dem Originalmedium synchronisiert. Der Reiz ist einfach: Sie passen einen einzigen starken Inhalt an, anstatt ihn für jeden Markt von Grund auf neu aufzubauen.
Die Entscheidung, bei der dieser Artikel Ihnen hilft, ist nicht nur, ob Sie Audio lokalisieren sollten, sondern wie: menschliche Aufnahme, vorgefertigte KI-Stimmen, Voice-Cloning oder Speech-to-Speech, und ob Voiceover, Untertitel oder vollständige Synchronisation zu Ihrem Inhalt passt. Wir treffen diese Entscheidungen täglich über unsere Synchronisations- und Stimmentools hinweg, daher konzentrieren sich die folgenden Abschnitte auf die Mechanik, die Kompromisse und die Prüfschritte, die eine brauchbare Tonspur von einer unterscheiden, die Sie neu machen müssen.
Inhaltsverzeichnis
Voiceover, Synchronisation und wo die Grenze verläuft
Menschen verwenden „Voiceover“ und „Synchronisation“, als ob sie dasselbe bedeuten, und diese Verwirrung führt zur falschen Produktionsentscheidung. Voiceover fügt Erzählung in einer anderen Sprache hinzu oder ersetzt sie, während das Originalaudio manchmal schwach darunter hörbar bleibt. Es ist der Standard für Dokumentarfilme, Erklärvideos, Schulungsvideos, Podcasts und Unternehmensinhalte. Synchronisation ersetzt in der Regel den Originaldialog vollständig, sodass der Zuschauer die lokalisierte Tonspur als Hauptdarbietung erlebt. Lippensynchrone Synchronisation geht noch weiter und formt die übersetzten Zeilen und deren Timing so um, dass sie zu den sichtbaren Mundbewegungen auf dem Bildschirm passen.
Die sauberste Art, die Unterscheidung festzuhalten: Mehrsprachiges Voiceover ist das übergeordnete Produktionsziel, gesprochene Inhalte über Sprachen hinweg zu liefern, und Synchronisation ist eine Methode, dies zu erreichen. Ein kurzer Lehrfilm braucht möglicherweise nur eine saubere übersetzte Erzählspur. Ein charaktergetriebener Film oder eine Werbung benötigt in der Regel vollständige Synchronisation, Sprechertrennung, Darbietungsregie und engere Synchronisation. Wenn Sie speziell die tiefere Aufschlüsselung der Mundabstimmungsarbeit möchten, behandelt unser Erklärtext zu was lippensynchrone Synchronisation beinhaltet, wo sich dieser zusätzliche Aufwand auszahlt.
Was tatsächlich in einem mehrsprachigen Voiceover passiert
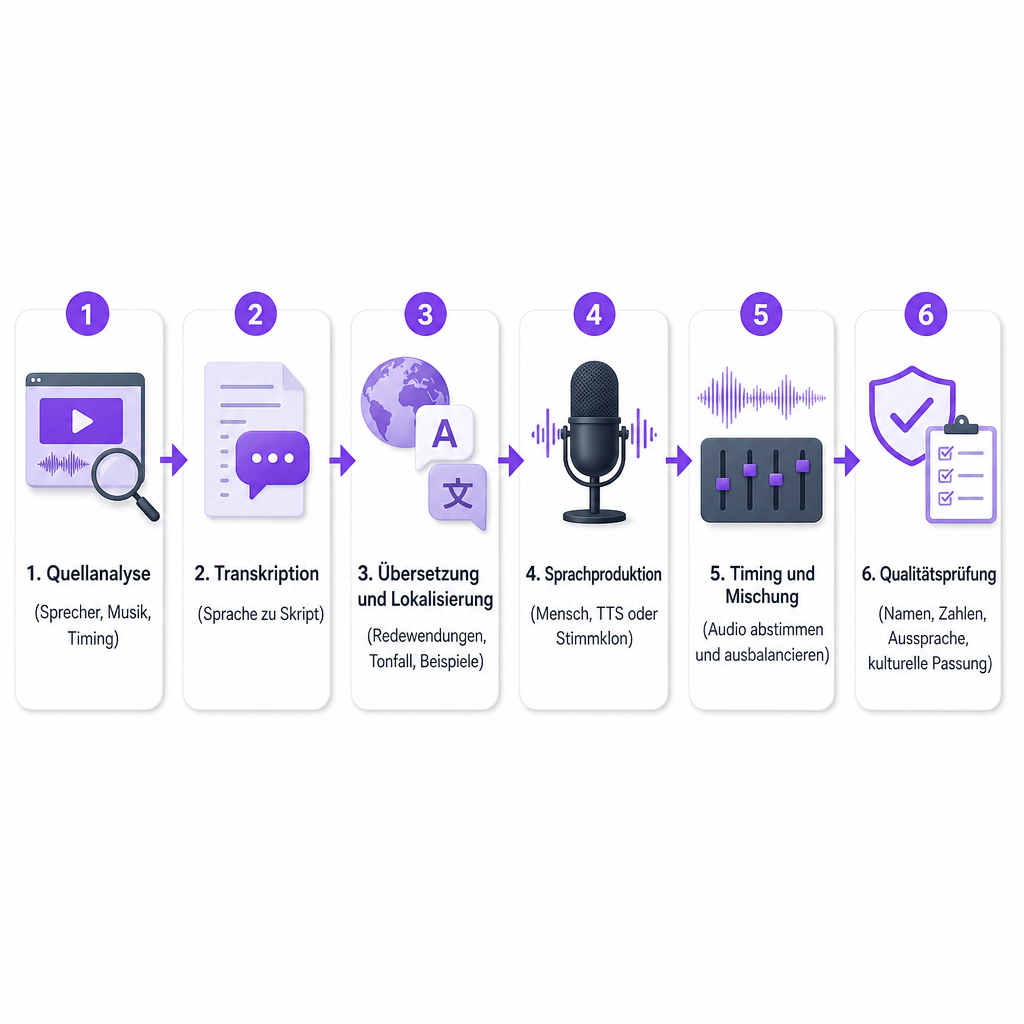
Eine fertige Tonspur verbirgt mehrere unterschiedliche Aufgaben, und das Überspringen einer davon ist der Punkt, an dem die Qualität leidet. Das Quellmedium wird zunächst analysiert, um Sprecher, Dialoge, Musik, Effekte, Terminologie und Timing zu identifizieren. Gesprochene Dialoge werden dann in ein geschriebenes Skript transkribiert, entweder manuell oder mit Speech-to-Text. Dieses Skript wird übersetzt und lokalisiert, was bedeutet, Redewendungen, Humor, Maßeinheiten, Beispiele und Tonfall anzupassen, damit das Ergebnis muttersprachlich klingt und nicht nur korrekt ist. Erst dann wird die Stimme produziert, auf das Bild abgestimmt und mit der verbleibenden Musik und den Effekten gemischt. Eine abschließende Prüfung überprüft Bedeutung, Aussprache, Namen, Zahlen, Timing und kulturelle Passung, bevor irgendetwas ausgeliefert wird.
KI-Synchronisationstools komprimieren einen Großteil davon in einen einzigen Workflow. Unser KI-Synchronisation-Workflow akzeptiert einen YouTube-Link oder eine hochgeladene Datei, lässt Sie Sprecher, Text und Timing bearbeiten und exportiert das fertige Projekt, mit Unterstützung für Inhalte aus über 60 Ausgangssprachen in 33 Zielsprachen. Die Transkriptionsphase stützt sich auf dieselbe Engine hinter unserem Speech-to-Text-Tool, was wichtig ist, da ein ungenaues Transkript jeden darauf folgenden Schritt beschädigt.
Vier Wege, die Stimme zu produzieren
Es gibt vier unterschiedliche Methoden, ein übersetztes Skript sprechen zu lassen, und jede passt zu einer anderen Kombination aus Budget, Umfang und emotionalem Einsatz.
Menschliches Voiceover. Ein professioneller Sprecher nimmt jede Sprachversion auf. Dies ist die Wahl für Markenkampagnen, Film und Fernsehen, Schulungen mit hohem Einsatz und charaktergetriebenes Storytelling, bei dem die emotionale Darbietung den Inhalt trägt. Sie erhalten nuancierte Darbietung, muttersprachliche Formulierungen und echte Regie. Sie bezahlen dafür mit Kosten, längeren Zeitplänen, schwierigeren Überarbeitungen und der Terminplanung über Sprachen hinweg.
Vorgefertigte KI-Text-to-Speech. Eine synthetische Stimme liest das übersetzte Skript. Dies passt zu YouTube-Erklärvideos, Produkttutorials, internen Schulungen, Entwürfen und Output in großem Volumen, bei dem Geschwindigkeit und eine konsistente Stimmidentität wichtiger sind als eine einmalige Darbietung. Überarbeitungen sind trivial, weil Sie einfach den Text bearbeiten und neu generieren. Die Kompromisse sind, dass die Aussprache überprüft werden muss, die emotionale Bandbreite variiert und einige Stimmen ohne sorgfältige Auswahl generisch klingen können. Unsere Text-to-Speech-Bibliothek bietet über 300 Stimmen für genau diese Art von skalierbarer Erzählung.
KI-Voice-Cloning. Das System erstellt eine synthetische Version der Stimme eines bestimmten Sprechers und verwendet sie, um das übersetzte Skript zu sprechen, wobei erkennbarer Tonfall, Tonhöhe, Akzent und Stil erhalten bleiben. Es ist für kreatorgeführte Kanäle, persönliche Marken, Kursleiter, Podcasts und Gründer gedacht, die in jeder Sprache wie sie selbst klingen müssen. Die nicht verhandelbare Bedingung: Ein Voice-Clone sollte nur mit der Erlaubnis des Sprechers und dokumentierten Rechten erstellt und verwendet werden. Unser Voice-Cloning-Tool funktioniert anhand einer kurzen Probe, aber die Einwilligung ist eine Voraussetzung, keine Formalität.
Speech-to-Speech-Konvertierung. Diese verwendet eine bestehende Darbietung als Eingabe und generiert Sprache in einer anderen Sprache, wobei versucht wird, Aspekte des ursprünglichen Rhythmus und der Darbietung beizubehalten, anstatt rein von geschriebenem Text auszugehen. Sie hilft, wenn ausdrucksstarker Stil wichtig ist, erfordert aber dennoch Übersetzungsprüfung, Ausspracheprüfungen, Timing-Anpassungen und die Erlaubnis, die Stimme des Sprechers zu reproduzieren.
Voiceover, Untertitel oder vollständige Synchronisation?
Bevor Sie eine Produktionsmethode wählen, entscheiden Sie, ob gesprochene Lokalisierung überhaupt das richtige Format ist. Die Entscheidung hängt meist von der Inhaltsart, dem Budget und dem gewünschten Seherlebnis ab.
| Option | Am besten geeignet für | Hauptvorteil | Hauptkompromiss |
|---|---|---|---|
| Untertitel | Kurzvideos, Interviews, Tests mit geringem Budget | Geringster Produktionsaufwand | Zuschauer müssen beim Sehen lesen |
| Voiceover | Erklärvideos, Dokumentarfilme, Kurse, Podcasts | Klare gesprochene Übersetzung, einfachere Synchronisation | Originalaudio kann hörbar bleiben |
| Vollständige Synchronisation | Erzählvideos, Werbung, Unterhaltung | Immersiveres Seherlebnis | Mehr Produktions- und QC-Arbeit |
| Lippensynchrone Synchronisation | Nahaufnahmen von Dialogen und Darbietung | Enge Abstimmung von Sprache und Gesicht | Benötigt engere Anpassung und Timing |
Eine praktische Regel: Wählen Sie Untertitel, wenn Geschwindigkeit und Kosten dominieren, Voiceover, wenn Verständnis und freihändiges Sehen wichtig sind, vollständige Synchronisation, wenn das übersetzte Audio das Original vollständig ersetzen soll, und lippensynchrone Synchronisation, wenn sichtbare Mundbewegungen zentral für das Erlebnis sind. Viele Herausgeber setzen Voiceover und Untertitel gemeinsam ein, da das eine Zuhörer unterstützt und das andere Zuschauer, die gehörlos oder schwerhörig sind, sich in lauten Umgebungen befinden oder einfach lieber lesen.
Wie Sie eine Methode für Ihren Inhalt wählen
Vier praktische Filter grenzen die Wahl schneller ein als jede Funktionsliste.
Schauen Sie zuerst auf die Inhaltsart. Erzählungsintensives Material lässt sich weitaus leichter mit Voiceover versehen als dialoglastiges Filmmaterial mit häufigen Schnitten und sichtbaren Sprechern. Ein Talking-Head-Tutorial benötigt Sprecheridentifikation und Timing-Anpassungen; eine animierte Werbung benötigt Darbietungsabstimmung und detaillierte Synchronisation.
Definieren Sie zweitens das erforderliche Qualitätsniveau ehrlich. Ein interner Entwurf, ein Social-Media-Experiment, eine öffentliche Bildungsressource, eine bezahlte Werbung, eine regulierte Kommunikation und ein hochwertiges Unterhaltungsstück tragen sehr unterschiedliche Reputations-, Rechts- und Sicherheitsrisiken. Je höher das Risiko, desto mehr menschliche sprachliche und redaktionelle Prüfung müssen Sie einbauen.
Bestätigen Sie drittens die Sprach- und Dialektabdeckung. „Spanisch“, „Englisch“ oder „Chinesisch“ umfassen jeweils mehrere regionale Varianten, prüfen Sie also, ob der Dienst die spezifische Sprache, den Akzent und den Markt unterstützt, auf den Sie abzielen. Unsere öffentliche KI-Synchronisationsseite gibt Unterstützung für über 60 Ausgangssprachen und 33 Zielsprachen an, während unsere API-Dokumentation separat über 33 Zielsprachen und über 99 Ausgangssprachen beschreibt, prüfen Sie also die aktuelle Liste und die relevante Dialektverfügbarkeit für Ihr Projekt, bevor Sie sich auf die Produktion festlegen.
Bewerten Sie viertens die Stimm- und Timing-Kontrolle. Übersetzte Sprache ist oft länger oder kürzer als das Original, daher sollte ein brauchbares System Ihnen erlauben, den übersetzten Text zu bearbeiten, Sprecher neu zuzuweisen, die Sprechgeschwindigkeit anzupassen, Zeitstempel zu ändern, die Hintergrundlautstärke zu justieren und nur das betroffene Segment neu zu generieren, anstatt der gesamten Datei. Für wiederkehrende Kreatoren und Marken ist die Stimmkonsistenz über Segmente und Sprachen hinweg in der Regel wichtiger als die Größe der Stimmbibliothek.
Risiken, die eine lokalisierte Tonspur still und leise ruinieren
Eine generierte Tonspur kann flüssig klingen und dennoch falsch sein. Dies sind die Fehlermodi, vor denen man sich schützen sollte, jeder mit einer konkreten Gegenmaßnahme.
- Wörtliche Übersetzung. Wort-für-Wort-Ausgabe kann grammatikalisch, aber unnatürlich oder irreführend sein. Lassen Sie einen muttersprachlichen Prüfer Redewendungen, Humor und Handlungsaufforderungen anpassen.
- Falsche Namen und Begriffe. KI kann Personen, Produkte, Akronyme und Orte falsch aussprechen. Erstellen Sie einen Ausspracheleitfaden und prüfen Sie eine kurze Probe, bevor Sie das vollständige Projekt generieren.
- Timing-Fehlabstimmungen. Ein übersetzter Satz kann die ursprüngliche Pause oder Szene überschreiten. Verwenden Sie engere Formulierungen, passen Sie die Sprechgeschwindigkeit sorgfältig an und bearbeiten Sie Segment-Zeitstempel.
- Stimmidentität und Einwilligung. Die Verwendung einer erkennbaren Stimme ohne Erlaubnis schafft rechtliche und reputationsbezogene Risiken. Holen Sie eine schriftliche Genehmigung ein und dokumentieren Sie, wo, wie lange und in welchen Sprachen die Stimme verwendet werden darf.
- Kulturelle Fehltritte. Ein Witz oder Beispiel, das in einem Markt ankommt, kann in einem anderen scheitern. Bitten Sie einen qualifizierten muttersprachlichen Prüfer, die vollständige lokalisierte Version zu bewerten, nicht nur das Skript.
- Übermäßiges Vertrauen auf Automatisierung. Behandeln Sie KI als Produktionsbeschleuniger, nicht als finalen Editor; prüfen Sie Transkript, Übersetzung, Aussprache, Timing, Mischung und Export.
Offenlegung verdient eine gesonderte Anmerkung. In den Vereinigten Staaten hat die FCC bestätigt, dass ihre Beschränkungen für künstliche oder vorab aufgezeichnete Sprachanrufe auf KI-generierte menschliche Stimmen in abgedeckten Anrufen anwendbar sind, wie in der FCC-Entscheidung zum TCPA und KI-Stimmen dargelegt. Diese Regel bezieht sich speziell auf Kommunikation, die unter dem Telephone Consumer Protection Act reguliert ist, und klärt nicht automatisch die Offenlegung für ein YouTube-Video, eine Werbung, einen Kurs oder einen Podcast. Dennoch ist transparente Kennzeichnung sinnvoll, wann immer eine KI-generierte oder geklonte Stimme ein Publikum in die Irre führen könnte, und die Anforderungen variieren je nach Anwendungsfall und Rechtsraum, prüfen Sie also, was für Ihren zutrifft.
Wie wir in die mehrsprachige Voiceover-Produktion passen
Unsere Plattform ist darauf ausgelegt, die gesamte Voiceover-Kette an einem Ort zu bewältigen, anstatt separate Tools zusammenzufügen. Sie laden Audio oder Video hoch, wählen Zielsprachen aus, verwalten Sprecher und Timings und laden lokalisierte Ergebnisse herunter. Die KI-Synchronisationsoberfläche bietet die Bearbeitung von Sprechern, Text, Timings, Sprechgeschwindigkeit, Zeitstempeln, Hintergrundlautstärke und einzelnen Segmenten, was Ihnen ermöglicht, eine einzelne falsch übersetzte Zeile zu korrigieren, ohne ein ganzes Projekt neu zu generieren.
Für Entwickler und Agenturen unterstützt unsere KI-Synchronisations-API mehrere Zielsprachen in einer einzigen Projektanfrage und bietet Endpunkte für die Projektbearbeitung und den Ergebnis-Download. Die Dokumentation beschreibt vorsignierte Uploads, Projekterstellung über mehrere Sprachen hinweg und herunterladbare Ergebnisse, listet gängige Video- und Audioformate mit einer maximalen Dateigröße von 5 GB auf und gibt ein Beispiel, bei dem ein fünfminütiges Video typischerweise in etwa einer Minute verarbeitet wird, wobei das tatsächliche Timing von Länge und Dateigröße abhängt. Das macht es praktisch, Sprachversionen automatisch auszulösen, sobald ein Video freigegeben ist.
Der stärkste Workflow ist nicht „jede Sprache generieren und veröffentlichen“. Es geht darum, Automatisierung für Transkription, Übersetzungsentwürfe, Stimmgenerierung und wiederholte Überarbeitungen zu nutzen und dann menschliche Prüfung auf die Sprache und Inhalte anzuwenden, die Ihrem Publikum am wichtigsten sind. Für einfache Erzählung macht dies die mehrsprachige Produktion schnell und skalierbar; für hochwertige, emotionale oder risikoreiche Inhalte bleiben menschliche sprachliche Prüfung und Stimmregie unerlässlich. Die richtige Methode ist diejenige, die zu Ihren Qualitätsanforderungen, Ihrem Publikum, Ihrer Sprachvariante, Ihren Einwilligungsverpflichtungen und Ihrer Prüfkapazität passt.
Häufig gestellte Fragen
Was ist mehrsprachiges Voiceover?
Es ist die Erstellung gesprochener Versionen desselben Inhalts in mehreren Sprachen, unter Verwendung menschlicher Sprecher, KI-Text-to-Speech, Voice-Cloning oder Speech-to-Speech-Technologie, synchronisiert mit dem Originalmedium.
Ist mehrsprachiges Voiceover dasselbe wie Synchronisation?
Nicht ganz. Voiceover kann das Originalaudio schwach hörbar lassen, während Synchronisation in der Regel den Originaldialog ersetzt. Lippensynchrone Synchronisation stimmt die übersetzte Sprache zusätzlich auf sichtbare Mundbewegungen ab.
Ist KI-gestütztes mehrsprachiges Voiceover genau?
Es kann schnell nützliche Ergebnisse liefern, aber die Genauigkeit hängt vom Quellaudio, der Übersetzung, dem Sprachpaar, der Aussprache, dem Timing und dem Prüfprozess ab. Menschliche Überprüfung wird für öffentliche, kommerzielle, technische und risikoreiche Inhalte empfohlen.
Kann ich meine eigene Stimme in mehreren Sprachen verwenden?
Ja. Ein Voice-Cloning-System kann übersetzte Sprache generieren, die Ihrer Stimme ähnelt. Verwenden Sie nur Ihre eigene Stimme oder eine Stimme, für die Sie eine dokumentierte Erlaubnis und die erforderlichen Rechte besitzen.
Wie viele Sprachen unterstützen Sie?
Unsere öffentliche KI-Synchronisationsseite listet Synchronisation aus über 60 Ausgangssprachen in 33 Zielsprachen auf, während unsere API-Seite über 33 Zielsprachen und über 99 Ausgangssprachen beschreibt. Überprüfen Sie die aktuelle Sprach- und Dialektliste für Ihr spezifisches Projekt vor der Produktion.
Ersetzt mehrsprachiges Voiceover die Lokalisierung?
Nein. Voiceover ändert die gesprochene Sprache, während Lokalisierung Inhalte für einen Markt anpasst, was auch die Änderung von Terminologie, Humor, Grafiken, Maßeinheiten, Beispielen, Untertiteln und Handlungsaufforderungen bedeuten kann.