Medienlokalisierung ist der Prozess, durch den ein Video, ein Podcast oder ein Kurs, der in einer Sprache erstellt wurde, zu etwas wird, das sich für Zuschauer in einer anderen Sprache muttersprachlich anfühlt – kein aufgesetzter Untertitel, sondern Inhalte, die klingen und sich lesen, als wären sie von Anfang an für dieses Publikum geschaffen worden. Wenn Sie sich fragen, was Medienlokalisierung ist, lautet die kurze Antwort: Es ist die Anpassung audiovisueller Inhalte – Dialoge, Erzählung, Bildschirmtext, Grafiken, Timing und manchmal ganze Szenen – damit Menschen in einem anderen Markt dieselbe emotionale und informative Wirkung wie beim Original erleben. Übersetzung überträgt Worte. Lokalisierung überträgt Bedeutung, Ton und kulturelle Passung.
Diese Unterscheidung ist wichtig, weil die meisten Inhalte, die „global gehen“, bei der Wort-für-Wort-Übersetzung stehen bleiben und sich dann wundern, warum das Engagement stagniert. Die Ebene, die Inhalte, die Menschen verstehen können, in Inhalte verwandelt, von denen Menschen das Gefühl haben, sie seien für sie gemacht, ist der ganze Sinn der Lokalisierung – und sie ist nun auch für kleine Teams erreichbar, nicht nur für Studios.
Inhaltsverzeichnis
Was Medienlokalisierung wirklich bedeutet
Fachlich gesehen ist Medienlokalisierung die Anpassung von kreativen, Audio- und Videoinhalten, um den sprachlichen, kulturellen und technischen Erwartungen einer bestimmten Region oder Zielgruppe zu entsprechen. Sie umfasst Filme, Serien, Werbung, Podcasts, E-Learning-Module, Social-Media-Clips und alle anderen Multimedia-Inhalte, die Worte, Ton und Bilder kombinieren.
Was sie von einer einfachen Übersetzung unterscheidet, ist der Umfang. Lokalisierung verändert Dialoge, Bildschirmtext, Erzählung, Grafiken und gelegentlich Szenen, damit die Inhalte in der Zielkultur natürlich und respektvoll ankommen. Das kann bedeuten, Redewendungen so umzuarbeiten, dass ein Witz noch zündet, eine Markennennung auszutauschen, die ein lokales Publikum nicht kennen würde, die Farbsymbolik zu überdenken oder das Tempo an die Sehgewohnheiten anzupassen. Ein wörtlicher Untertitel mag zwar korrekt sein und sich trotzdem fremd anfühlen; eine lokalisierte Version liest sich, als würde sie dazugehören.
Für digitale Kreative und Unternehmen liegt hier der Unterschied zwischen einem Video, das in einer anderen Sprache lediglich verständlich ist, und einem, das auf Augenhöhe mit lokalen Inhalten konkurriert. Es ist der Mechanismus, der einen Kanal, einen Kurs oder eine Kampagne wirklich mehrsprachig macht und nicht nur untertitelt.
Die eigentliche Entscheidung: Brauchen Sie sie, und in welcher Form?
Die ehrliche Frage für die meisten Teams lautet nicht, ob Lokalisierung existiert – sondern welche Art zum Ziel passt. Die von Ihnen gewählte Tiefe verändert Kosten, Zeitplan und Wirkung.
Kreative, die einen YouTube-Kanal international ausbauen, wägen drei Wege ab: die Originalsprache mit Untertiteln beibehalten, lokalisierte Voiceovers hinzufügen oder vollständig in mehrere Sprachen synchronisieren mit einheitlichem Kanal-Branding. Kleine Unternehmen und Marketingteams stehen vor einer verwandten Wahl – sollen lokalisierte Werbespots wie ein muttersprachlicher Moderator aus jedem Markt klingen, oder soll die Kernstimme der Marke über alle Sprachen hinweg getragen werden? Produzenten von E-Learning und Unternehmensschulungen entscheiden oft zwischen einfacher Untertitelung, teilweiser Lokalisierung wie etwa Voiceover für zentrale Module oder vollständiger Multimedia-Lokalisierung, bei der Folien, Beispiele und Prüfungen an lokale Normen und Vorschriften angepasst werden.
Unabhängige Filmemacher und Podcaster entscheiden, wie viel der Originaldarbietung sie bewahren und wie weit sie Dialoge, Sounddesign und Marketing für jedes Gebiet anpassen. Entwickler und Agenturen stehen vor einer eher technischen Weggabelung: die Lokalisierung direkt über APIs für Text-to-Speech, Voice-Cloning und Synchronisation in ihre Produkte und Pipelines einbetten oder die Audiobearbeitung für jede Sprache manuell erledigen.
So betrachtet ist Lokalisierung eher eine Strategiefrage als eine Produktionsaufgabe: Wie weit sollten Ihre Inhalte gehen, um sich in jedem Markt muttersprachlich anzufühlen, und welche Kombination von Tools bringt Sie dorthin, ohne Ihr Budget oder Ihren Veröffentlichungsrhythmus zu sprengen?
Wie Medienlokalisierung funktioniert: Mechanismen und Optionen
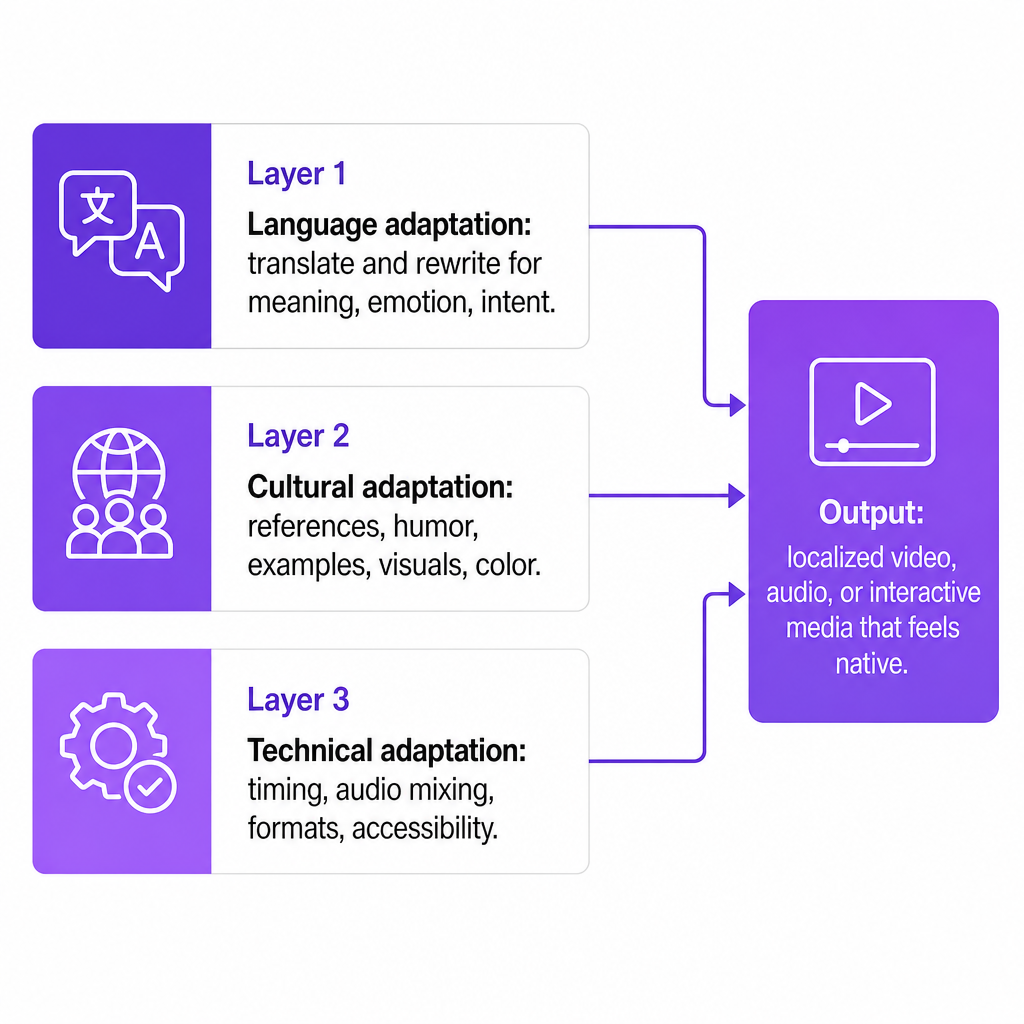
Die meisten Projekte kombinieren drei grundlegende Mechanismen. Sprachliche Anpassung übersetzt und schreibt Skripte um, um Bedeutung, Emotion und Absicht zu bewahren, statt sich am wörtlichen Wortlaut zu orientieren. Kulturelle Anpassung überarbeitet Referenzen, Humor, Beispiele und Bilder, um sie an lokale Normen anzugleichen und Verwirrung oder Anstoß zu vermeiden. Technische Anpassung passt Timing, Tonmischung, Dateiformate und Barrierefreiheit an, damit das Ergebnis den Anforderungen jeder Plattform oder jedes Senders entspricht. Diese drei greifen je nach Inhaltstyp und benötigter Tiefe unterschiedlich ineinander.
Synchronisation und Voiceover
Bei der Synchronisation wird das originale gesprochene Audio durch lokalisierte, bildsynchrone Sprache ersetzt oder überlagert. Traditionelle Arbeitsabläufe erfordern muttersprachliche Sprecher, Studioaufnahmen, Audiobearbeitung sowie sorgfältige Lippensynchronisation und Timing. KI-Synchronisation automatisiert vieles davon, indem sie das Quell-Audio analysiert, Übersetzungen generiert und synthetische Sprache erzeugt, die auf das Video abgestimmt ist. Moderne Systeme nutzen Voice-Cloning, um Ton, Tonhöhe, Akzent und Stil des ursprünglichen Sprechers in der neuen Sprache zu bewahren, sodass synchronisierte Versionen weiterhin nach dem Kreativen oder der Marke klingen und nicht nach einem generischen Erzähler.
Unsere KI-Synchronisation übersetzt und synchronisiert Videos in mehr als 33 Sprachen und wendet Voice-Cloning an, um die Stimme jedes Sprechers zu replizieren – so behält ein Kreativer eine einheitliche Kanalidentität in jedem Markt und liefert zugleich lokalisierte Sprache in jeder Sprache.
Untertitelung und Bildunterschriften
Bei der Untertitelung werden Bildschirmtextübersetzungen der gesprochenen Dialoge hinzugefügt, die auf bestimmte Frames abgestimmt sind. Untertitel für Hörgeschädigte erweitern dies, indem sie zur Barrierefreiheit auch nicht-sprachliche Hinweise wie Soundeffekte und Musik einbeziehen. Bei der Lokalisierungsarbeit müssen Untertitel sprachlich korrekt, kulturell angemessen und technisch präzise sein – abgestimmt auf das Timing jeder Zeile, die Lesegeschwindigkeit und den verfügbaren Platz auf dem Bildschirm. Für viele Kreative sind Untertitel der erste kostengünstige Schritt zur internationalen Reichweite, besonders wenn eine vollständige Synchronisation noch nicht machbar ist.
Bildschirmtext, Grafiken und interaktive Elemente
Lokalisierung umfasst auch Text und Bilder, die fest in die Inhalte eingebettet sind: Bauchbinden, Titel, UI-Beschriftungen, Diagramme, Grafiken und Handlungsaufforderungen im Video. Effektive Arbeit aktualisiert diesen Bildschirmtext, passt Layouts für Sprachen an, die länger oder kürzer sind, und passt Grafiken oder Farben an lokale Erwartungen an. Interaktive Medien – Apps, E-Learning-Module, Web-Erlebnisse – fügen eine weitere Ebene hinzu: Schaltflächen, Menüs, Anweisungen und Rückmeldungen müssen alle lokalisiert werden, damit Nutzer natürlich in ihrer eigenen Sprache navigieren.
Audio-Bereinigung, Transkription und unterstützende Tools
Vor all dem muss das Quell-Audio meist vorbereitet werden: Stimmen von Hintergrundgeräuschen trennen, Transkripte erstellen sowie Sprecher und Segmente identifizieren. Diese Vorverarbeitungsschritte machen Synchronisation, Untertitelung und Cloning deutlich genauer. Unser Speech to Text erstellt saubere Transkripte, und unser Speech Separator isoliert Stimmen von Musik und Geräuschen – beides fließt direkt in die nachgelagerte Lokalisierung ein, statt manuellen Export und Reimport zwischen Tools zu erzwingen.
Wo wir bei der Medienlokalisierung ins Spiel kommen
DubSmart AI ist eine All-in-One-Plattform für KI-gestützte Medienerstellung und -lokalisierung mit Hauptsitz in Boca Raton, Florida, die KI-Synchronisation, Voice-Cloning, Text to Speech, Speech to Text, Sprachtrennung, Text-to-Image und Image-to-Video in einem Workflow bündelt. Wir bedienen mehr als 500.000 Nutzer, die skalierbare mehrsprachige Produktion benötigen – einzelne Kreative, YouTuber, Unternehmen und Entwickler.
Speziell für die Lokalisierung greifen die Bausteine ineinander:
- Die KI-Synchronisation lokalisiert Inhalte in über 33 Zielsprachen und nutzt Voice-Cloning, um die Stimme jedes Sprechers über alle Sprachen hinweg zu übertragen.
- Voice-Cloning reproduziert beliebig viele Stimmen mit hoher Präzision, sodass Markenstimmen, Kreativpersonas oder Charakterstimmen von Markt zu Markt wiederverwendet werden können.
- Text to Speech bietet über 300 natürlich klingende KI-Stimmen sowie unbegrenztes Voice-Cloning und erzeugt aus Skripten realistische Sprache.
- Speech to Text und Speech Separator transkribieren und bereinigen Audio, um genaue Synchronisation und Untertitel vorzubereiten.
- Text-to-Image- und Image-to-Video-Tools erstellen oder passen visuelle Assets innerhalb desselben Produktionsablaufs an.
Wir verwenden ein guthabenbasiertes Preismodell mit übertragbaren Credits, eine kostenlose Stufe zum Testen, kostenpflichtige Tarife für die regelmäßige Produktion und Enterprise-Optionen für größere Teams. Für Entwickler und Agenturen ermöglichen unsere KI-Synchronisations-API und Voice-Cloning-API, dass sich Voice-KI direkt in Produkte oder Pipelines einfügt. Da diese Funktionen eine gemeinsame Umgebung teilen, können Teams von rein englischen Quellinhalten zu mehrsprachigen synchronisierten und untertitelten Versionen wechseln, ohne separate Anbieter zusammenzuflicken – was die operative Reibung reduziert, die eine vollständige Lokalisierung einst nur für Studios erschwinglich machte.
So wählen Sie Ihren Lokalisierungsansatz
Die Entscheidung, wie weit lokalisiert werden soll, läuft auf einige praktische Kriterien hinaus. Wägen Sie diese gegen Ihre Ziele ab, statt standardmäßig die teuerste oder die günstigste Option zu wählen.
Zielgruppen- und Kanalstrategie. Beginnen Sie damit, wen Sie erreichen wollen und wo diese Menschen zuschauen. Wenn das Ziel globale Zugänglichkeit für ein bestehendes Publikum ist, könnten hochwertige Untertitel ausreichen. Wenn Sie aktives Wachstum in bestimmten Märkten anstreben – spanischsprachige Zuschauer, französischsprachige Lernende – kommt muttersprachlichem Audio mehr Bedeutung zu. Bei persönlichkeitsgetriebenen Kanälen wird das Bewahren der Stimme des Kreativen über Sprachen hinweg durch Cloning zu einem echten Alleinstellungsmerkmal.
Inhaltstyp und Format. Erzählfilme, handlungsgetriebene Serien und Podcasts profitieren in der Regel von vollständiger Synchronisation oder sorgfältig gemischten Voiceovers, um die Immersion zu erhalten. Tutorials, Produkterklärungen und Schulungen kombinieren oft lokalisierte Erzählung mit übersetzten Folien und Untertiteln. Interaktives E-Learning und Apps benötigen eine granulare Lokalisierung von UI-Text und Rückmeldungen, wo Transkription, TTS und Synchronisations-APIs ihren Platz finden. Kurzformat-Social benötigt möglicherweise nur lokalisierte Hooks, Untertitel und gelegentlich eine synchronisierte Version eines Top-Clips.
Sprachen und Skalierbarkeit. Eine oder zwei Sprachen mit seltenen Updates rechtfertigen möglicherweise maßgeschneiderte Studioarbeit. Die Abdeckung von Dutzenden von Märkten mit häufigen Veröffentlichungen macht Automatisierung unerlässlich. Die Synchronisation in über 33 Sprachen mit über 300 Stimmen und unbegrenztem Cloning ist für diese Skalierung gemacht, und übertragbare Credits eignen sich für periodische große Vorstöße – die Einführung eines Kurses oder einer Staffel – ohne ungenutzte Kapazität zu verschwenden.
Qualität, Kontrolle und Markenstimme. Filmlokalisierung auf Broadcast-Niveau erfordert oft umfangreiche menschliche Überprüfung und kreative Leitung. Für digitales Marketing, Schulungen und Kreativinhalte können hochwertige synthetische Stimmen und KI-Synchronisation die Erwartungen des Publikums erfüllen und gleichzeitig Kosten und Zeit stark reduzieren. Voice-Cloning fügt eine Kontrolldimension hinzu: Definieren Sie einmal eine markante Stimme und verwenden Sie sie konsistent wieder, statt auf verschiedene Sprecher angewiesen zu sein, die über Kampagnen und Sprachen hinweg variieren.
Budget, Zeit und Workflow-Passung. Menschliche Übersetzung, Studioaufnahmen, Mischung und QA können langsam und kostspielig sein, besonders bei häufigen Veröffentlichungen. KI-gestützte Arbeitsabläufe verkürzen die Bearbeitungszeit und passen zu wöchentlichen oder täglichen Veröffentlichungsplänen. Wenn Sie vorhersehbare Kosten und eine einzige Umgebung für Audio-, Bild- und Synchronisationsaufgaben benötigen, schlägt eine integrierte Plattform in der Regel das Zusammenstellen einmaliger Anbieterprojekte.
Risiken und Verantwortlichkeiten, die Sie einplanen sollten
Selbst mit starken KI-Tools birgt Lokalisierung reale Risiken, die es lohnt zu benennen, bevor Sie beginnen.
Sprachliche und kulturelle Fehltritte können das Vertrauen schädigen oder Anstoß erregen, wenn eine Übersetzung Nuancen verfehlt oder lokale Normen ignoriert. Zu wörtliche Übersetzung verzerrt die Bedeutung; zu starke Anpassung kann das Original falsch wiedergeben oder Markenrichtlinien verletzen. Technische Fehler – schlechte Lippensynchronisation, unpassende Untertitel, falsche Audiopegel – lassen Inhalte unprofessionell wirken. In compliance-sensiblen Bereichen wie Gesundheit, Finanzen oder Mitarbeiterschulung kann eine ungenaue Lokalisierung rechtliche oder regulatorische Risiken schaffen, weshalb dort fallspezifische Überprüfung wichtig ist.
Voice-Cloning fügt ethische Verantwortung hinzu. Kreative und Organisationen benötigen eine klare Einwilligung für jede geklonte Stimme und müssen diese Modelle vor Missbrauch schützen. Unsere Position ist eindeutig: Cloning dient dem Erzählen und Lokalisieren legitimer Arbeit, nicht dem Imitieren von Personen ohne Autorisierung.
Die praktische Absicherung besteht darin, KI mit menschlichem Urteilsvermögen zu kombinieren – lokalisierte Skripte überprüfen, synchronisierte Ausgaben stichprobenartig kontrollieren und Schutzmaßnahmen darüber aufrechterhalten, wer Cloning und Synchronisation auslösen darf. Die Zentralisierung des Workflows in einer Plattform macht es leichter, diese Standards im großen Maßstab einzuhalten, weil Freigaben und Kontrollen direkt neben den Tools sitzen, statt über Anbieter verstreut zu sein.
Häufig gestellte Fragen
Was ist Medienlokalisierung in einem Satz?
Medienlokalisierung ist der Prozess der Anpassung von Audio-, Video- und Multimedia-Inhalten an verschiedene Sprachen und Kulturen, sodass sie sich anfühlen, als seien sie lokal erstellt und nicht nur übersetzt worden.
Wie unterscheidet sich Medienlokalisierung von Übersetzung?
Übersetzung konzentriert sich auf Worte. Medienlokalisierung passt Sprache, Bilder, Timing und kulturelle Referenzen an, um Bedeutung, Emotion und Absicht für jede Zielgruppe zu bewahren.
Brauche ich Synchronisation, oder reichen Untertitel aus?
Untertitel sind oft ausreichend für Barrierefreiheit und globale Reichweite mit geringem Budget. Vollständige Synchronisation oder lokalisierte Voiceovers schneiden in der Regel besser ab, wenn Persönlichkeit, Immersion oder Markenstimme für die Inhalte zentral sind.
Wie hilft KI-Synchronisation mit Voice-Cloning Kreativen und Marken?
Sie ermöglicht es Ihnen, die Stimme eines Kreativen oder einer Marke über Sprachen hinweg zu replizieren, was die mehrsprachige Produktion beschleunigt und zugleich in jedem Markt eine einheitliche Identität wahrt.
Was bieten Sie für die Medienlokalisierung an?
Wir vereinen KI-Synchronisation, Voice-Cloning, Text to Speech, Speech to Text, Sprachtrennung und visuelle Generierung in einer Plattform – mit Unterstützung für Synchronisation aus über 60 Quellsprachen in über 33 Zielsprachen, mit über 300 Stimmen und APIs für die direkte Integration.