Eine KI-Medienerstellungsplattform ist eine einzige Umgebung, in der Sie Medien – Audio, Video, Bilder und Text – mithilfe künstlicher Intelligenz erstellen, vertonen, lokalisieren und exportieren, anstatt separate Tools und manuelle Übergaben zusammenzufügen. Wenn Sie also fragen, was eine KI-Medienerstellungsplattform ist, lautet die kurze Antwort, dass sie einen Flickenteppich aus Transkriptions-Apps, Sprachtools, Übersetzungsdiensten und Editoren durch einen einzigen vernetzten Workflow ersetzt. Bei DubSmart AI haben wir unsere Plattform genau um diese Idee herum aufgebaut: von einem Rohskript oder einem Ausgangsvideo zu vollständig vertontem, mehrsprachigem Content zu gelangen, ohne den Arbeitsbereich jemals zu verlassen.
Diese Konsolidierung ist wichtig, weil der schwierige Teil moderner Content-Arbeit selten eine einzelne Aufgabe ist. Es geht darum, Stimmen konsistent zu halten, das Timing abzustimmen und Dateien sauber zwischen den Schritten zu bewegen. Eine Plattform, die die gesamte Pipeline besitzt, beseitigt die Reibung, die zwischen Aufnahme, Vertonung und Veröffentlichung Stunden verschlingt.
Inhaltsverzeichnis
Was tatsächlich als KI-Medienerstellungsplattform gilt
Das entscheidende Merkmal ist der Workflow, nicht die Anzahl der Funktionen. Eine Sammlung von KI-Fähigkeiten wird erst dann zur Plattform, wenn diese Fähigkeiten eine gemeinsame Umgebung teilen: Sie importieren Medien einmal, transformieren sie durch mehrere KI-Schritte und exportieren ein fertiges Asset, ohne zwischen den Tools zu exportieren und neu zu importieren.
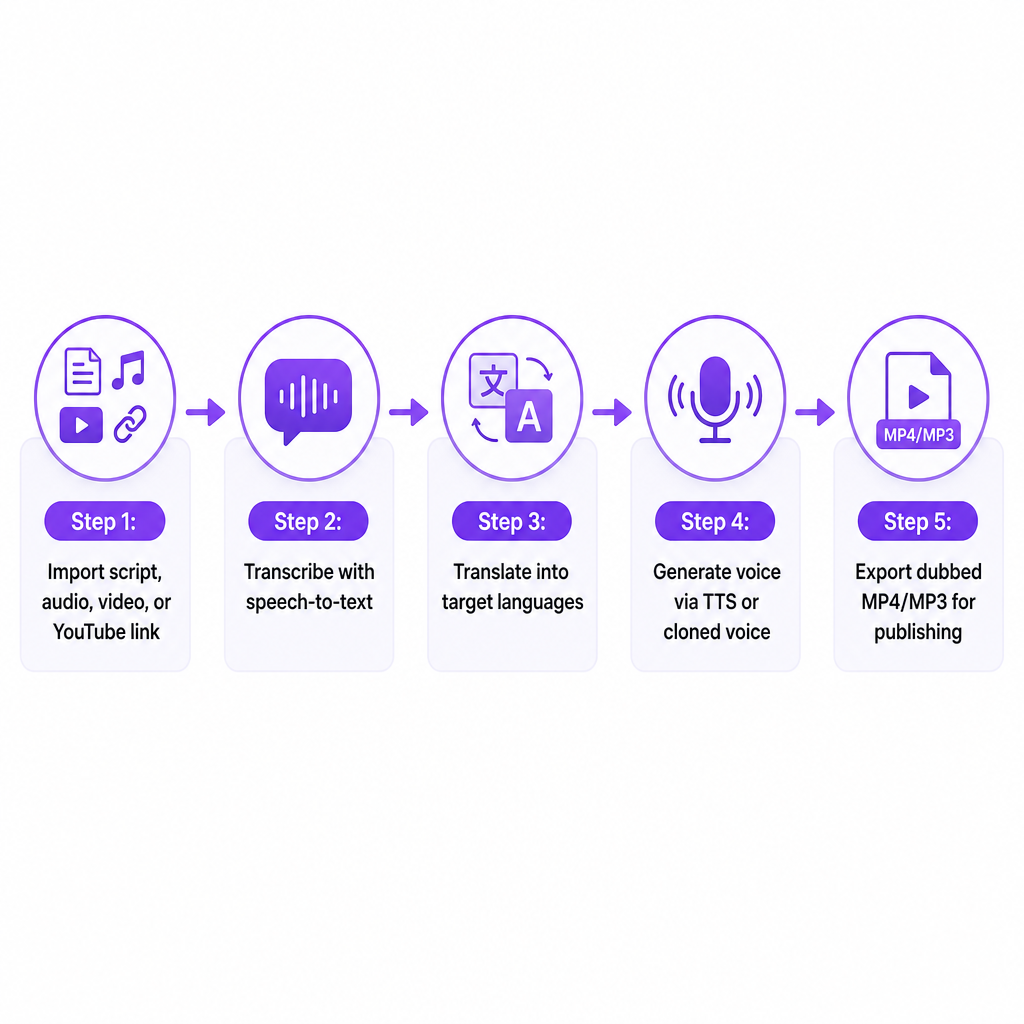
Bei uns bedeutet das, dass Text-to-Speech, Voice Cloning, KI-Vertonung, Speech-to-Text, ein Sprachtrenner, Text-to-Image und Image-to-Video alle am selben Ort leben. Ein YouTube-Creator, ein Marketing-Team oder ein E-Learning-Produzent kann von einem Skript oder einem Ausgangsvideo ausgehen und innerhalb eines Systems mehrsprachigen, vollständig vertonten Output erreichen. Die Aufgabe der Plattform besteht darin, die verbindende Arbeit zu übernehmen – Transkription speist Übersetzung, Übersetzung speist Sprachgenerierung, Sprachgenerierung speist eine getimte Vertonung – sodass kein Schritt zu einer manuellen Dateiverschiebeaufgabe wird.
Das ist die praktische Grenze zwischen einem Einzweck-Tool und einer Plattform. Ein eigenständiger Text-to-Speech-Generator erzeugt Audio und hört dann auf. Eine Plattform behandelt dieses Audio als eine Stufe in einer längeren Pipeline, die mit einer veröffentlichungsfähigen, lokalisierten Datei endet.
Brauchen Sie eine, oder reichen separate Tools
Die eigentliche Entscheidung ist, ob Sie Content und Lokalisierung weiterhin mit verstreuten Anbietern und SaaS-Abonnements verwalten oder diese Arbeit dort zentralisieren, wo Sprach-, Video- und Bildgenerierung direkt miteinander verbunden sind. Für die meisten Teams hängt die Antwort davon ab, wie oft die Frage aufkommt.
Ein paar Szenarien machen die Wahl greifbar:
- Ein YouTube-Kanal, der auf Englisch erfolgreich war, möchte spanische, portugiesische oder Hindi-Versionen, ohne jedes Video neu aufzunehmen.
- Ein kleines Marketing-Team benötigt kosteneffiziente Lokalisierung für Kampagnen, Produktdemos und Erklärvideos in einem wiederkehrenden Zeitplan.
- Eine E-Learning- oder Unternehmensschulungsgruppe muss langformatige Kurse konsistent in mehreren Sprachen für globale Mitarbeiter bereitstellen.
- Ein unabhängiger Filmemacher oder Podcaster möchte mehrsprachige Vertonung, kann aber wiederholte Studiositzungen und Sprecherhonorare nicht rechtfertigen.
- Ein Entwicklungsteam oder eine Agentur benötigt Sprach-KI, die über APIs bereitgestellt wird, um das eigene Produkt oder die Lokalisierungspipeline anzutreiben.
Wenn Ihr aktueller Prozess auf manuelle Aufnahme, externe Studios, mehrere unverbundene Apps oder benutzerdefinierte Skripte angewiesen ist, nur um Dateien zwischen Systemen zu bewegen, geht es bei der Frage nicht mehr darum, ein weiteres Tool hinzuzufügen. Es wird zu einer Frage von Effizienz, Skalierung und Kontrolle. Wenn Sie ein Video pro Jahr lokalisieren, reichen separate Tools. Wenn Sie wöchentlich lokalisieren, sind die Übergaben genau die Stelle, an der Ihre Zeit und Konsistenz verloren gehen.
Wie diese Plattformen im Hintergrund funktionieren
Die Implementierungen unterscheiden sich, aber die meisten KI-Medienerstellungsplattformen teilen eine Handvoll Mechanismen. So passen sie in unseren Workflow zusammen.
Ein zentralisierter Medienarbeitsbereich
Alles beginnt mit dem Import: Skripte, Audio, Videodateien oder ein YouTube-Link. Von dort aus organisieren Sie Projekte nach Sprache, Sprecher und Kanal, wenden KI-Transformationen auf einer gemeinsamen Timeline an und exportieren im Format, das Ihr Zielort benötigt – MP4 oder MP3 für YouTube, bearbeitungsfertige Dateien für die Postproduktion, Audio für ein LMS. Unsere Oberfläche ist so gebaut, dass Sie lokales Video hochladen oder auf Online-Content verlinken, Sprecher und Timings konfigurieren und fertige lokalisierte Projekte aus demselben Arbeitsbereich herunterladen.
Sprachgenerierung und Cloning als Bindegewebe
Die Stimme ist normalerweise das Rückgrat der Pipeline. Wir behandeln Voice Cloning eher als Bindegewebe denn als Spielerei: Sie laden eine saubere Sprachprobe hoch, wir verarbeiten sie in Sekunden zu einer benannten benutzerdefinierten Stimme, und Sie verwenden diese Stimme über Text-to-Speech und Vertonung hinweg wieder. Die Mechanik ist kurz – nehmen Sie mindestens 20 Sekunden sauberer Sprache auf oder stellen Sie sie bereit, laden Sie sie in den Voice-Clone-Bereich hoch und wenden Sie dann das resultierende Profil überall dort an, wo Sie es benötigen. Dieselbe geklonte Stimme kann Intros und Schulungs-Voiceovers in TTS erzeugen und die Identität eines Sprechers über verschiedene Sprachen hinweg in der Vertonung bewahren. Eine Bibliothek mit über 300 natürlich klingenden Basisstimmen deckt Fälle ab, in denen Sie unterschiedliche Stimmen für verschiedene Märkte wünschen.
Text-to-Speech und Speech-to-Speech-Vertonung
Text-to-Speech wandelt Skripte und Untertitel in natürlich klingendes Audio um, und weil es direkt an Vertonung und Untertitelgenerierung anknüpft, kann ein einziges Projekt von Text zu lokalisiertem Video wechseln, ohne den Workflow zu verlassen. Speech-to-Speech-Vertonung funktioniert anders: Sie nimmt eine bestehende aufgenommene Stimme, analysiert Ton, Tonhöhe, Sprechstil und Timing und erstellt dann diese Stimme neu, während sie eine neue Zielsprache spricht. Unsere KI-Vertonungs-Pipeline nutzt dies, um die Eigenschaften des ursprünglichen Sprechers zu bewahren, anstatt generische Erzählung einzufügen – nützlich, wenn Authentizität der Punkt ist. Wenn Sie die tiefere Mechanik wünschen, führt Sie unser Erklärartikel zur Speech-to-Speech-Vertonung durch den Ablauf von der Analyse bis zur Neuerzeugung.
Die mehrsprachige Lokalisierungspipeline
Der Wert einer Plattform hängt stark von der Sprachabdeckung und davon ab, wie die Übersetzung mit der Stimme verbunden ist. Unser Vertonungs-Stack unterstützt die Vertonung von über 60 Ausgangssprachen in 33 Zielsprachen und ermöglicht es Ihnen, Zielsprachen, Sprecher und Stile pro Projekt auszuwählen. In der Praxis: Importieren Sie ein Video oder einen Link, wählen Sie ein oder mehrere Ziele wie Englisch zu Spanisch und Portugiesisch, wählen Sie geklonte oder Standardstimmen pro Sprache, und lassen Sie das System Transkription, Übersetzung, Sprachgenerierung und Neutiming zu einer upload-fertigen Vertonung übernehmen. Da das Cloning integriert ist, kann dieselbe Moderatorenstimme durch jede Sprache getragen werden und hält das Publikum auf vertrautem Boden.
APIs für Entwickler und Agenturen
Wenn Teams ihre eigenen Produkte entwickeln, benötigen sie programmatisch bereitgestellte Fähigkeiten. Wir veröffentlichen eine Voice Cloning API, die den In-App-Ablauf widerspiegelt: Fordern Sie eine vorsignierte Upload-URL an, laden Sie eine Audioprobe hoch (MP3, WAV, AAC, M4A oder FLAC), erstellen Sie eine benutzerdefinierte Stimme, indem Sie den zurückgegebenen Dateischlüssel mit einem Stimmnamen senden, und referenzieren Sie diese Stimme dann in späteren Aufrufen. Mit der AI-Dubbing-API können Entwickler Vertonungsprojekte erstellen, Zielsprachen und Spracheinstellungen festlegen und die Analyse der Stimme des ursprünglichen Sprechers auslösen, bevor sie Sprache generieren, die diese Qualitäten in der neuen Sprache beibehält. Das bedeutet, dass Agenturen Sprach- und Vertonungsfunktionen in ihre eigenen Produkte einbetten können, ohne die zugrunde liegenden Modelle neu aufzubauen.
Drei grundlegende Ansätze zur KI-Medienerstellung
Selbst innerhalb integrierter Plattformen teilt sich der Markt in einige Optionstypen auf, und jeder passt zu einem anderen Käufer.
Creator-orientierte, workflow-getriebene Plattformen betonen eine zugängliche Oberfläche, Projektorganisation und End-to-End-Lokalisierung für Video, Audio und Bilder. Hier ist unsere Web-App angesiedelt, die TTS, Cloning, Vertonung, Speech-to-Text, Sprachtrennung, Text-to-Image und Image-to-Video in einer Benutzeroberfläche umfasst.
API-zentrierte Plattformen richten sich zuerst an Entwickler und konzentrieren sich auf Endpunkte und Payloads statt auf eine nicht-technische Oberfläche. Unsere Voice Cloning-, TTS- und AI-Dubbing-APIs erweitern das creator-orientierte Produkt für Teams, die programmatische Kontrolle benötigen.
Enge Tools mit einer einzigen Fähigkeit tun eine Sache – grundlegendes TTS oder einfache Transkription – ohne die umgebende Pipeline. Sie können für eine sehr fokussierte Aufgabe geeignet sein, aber Sie benötigen zusätzliche Tools, um zu einem fertigen, lokalisierten Asset zu gelangen.
Für die meisten in den USA ansässigen Creator und Unternehmen läuft die Wahl auf eine Workflow-Plattform hinaus, die ein Marketing- oder Content-Team direkt nutzen kann, gegenüber einem API-Ansatz, den Entwickler in bestehende Systeme einbinden. Wir bedienen bewusst beide Enden: ein credit-basiertes Produkt mit UI-Workflows plus APIs für die Integration.
Wie Sie wählen: die entscheidenden Kriterien
Wenn Sie abwägen, ob Sie eine Plattform übernehmen und welche, leistet eine Handvoll Kriterien den Großteil der Arbeit.
| Kriterium | Worauf zu achten ist | Wie wir es angehen |
|---|---|---|
| Workflow-Abdeckung | Reicht sie von Skript oder Ausgangsvideo bis zu fertigen lokalisierten Medien? | TTS, Cloning, Vertonung, Speech-to-Text, Sprachtrenner, Text-to-Image, Image-to-Video in einer Pipeline |
| Sprach- und Stimmqualität | Ausgangs- und Zielabdeckung sowie Stimmrealismus | Über 60 Ausgangssprachen in 33 Ziele, über 300 natürliche Stimmen, Cloning für authentische Identität |
| Geschwindigkeit und Skalierung | Wie schnell aus Input Output wird; Batch-Kapazität | Cloning aus kurzen Proben in Sekunden verarbeitet; Vertonung für wiederkehrende Projekte gebaut |
| Preismodell | Vorhersehbare, flexible Kosten gebunden an Volumen | Credit-basiert mit kostenloser Stufe, übertragbaren Credits und Enterprise-Plänen |
| Integration | APIs zur Verbindung bestehender LMS, CMS oder interner Tools | Voice Cloning-, TTS- und AI-Dubbing-APIs, die Kernfähigkeiten bereitstellen |
Zwei davon verdienen einen genaueren Blick. Bei der Geschwindigkeit funktioniert unser Cloning aus etwa 20 Sekunden Audio und liefert in Sekunden eine nutzbare Stimme, sodass die Bearbeitungszeit nicht von der Aufnahme langer Datensätze abhängt. Bei den Preisen bedeutet ein credit-basiertes Modell mit Übertragung, dass ungenutztes Guthaben übertragen wird und die Kosten sich am Content-Volumen orientieren statt allein an festen Plätzen – was zu Creators und Schulungsteams passt, deren Output steigt und fällt.
Risiken, Einschränkungen und verantwortungsvolle Nutzung
Skalierung bringt Verpflichtungen mit sich, und die ehrliche Version dieser Antwort benennt sie.
- Stimmrechte und Einwilligung. Das Klonen einer Stimme ohne ordnungsgemäße Autorisierung wirft rechtliche und ethische Bedenken auf. Wir fördern saubere, einwilligende Proben und behandeln geklonte Stimmen als professionelle Assets, nicht als Werkzeuge zur Nachahmung. Unser Leitfaden zu Voice-Cloning-Anwendungen für Creators stützt sich auf legitime Fälle wie mehrsprachige Kanäle und Schulungen.
- Authentizität und Offenlegung. Dem Publikum ist möglicherweise wichtig, ob eine Stimme synthetisch ist. Für Marketing, Schulung und Film schützt Transparenz über die KI-Nutzung das Vertrauen – besonders wenn eine vertonte Stimme über Sprachen hinweg fast identisch mit dem ursprünglichen Sprecher klingt.
- Sprachliche und kulturelle Nuancen. Selbst starke Übersetzung und Vertonung profitieren von menschlicher Überprüfung. Lokale Redewendungen, behördliche Formulierungen und kulturelle Empfindlichkeiten bedeuten, dass KI-Output für risikoreichen Content wie Compliance-, medizinische oder finanzielle Botschaften als erster Entwurf behandelt werden sollte.
- Datensicherheit. Audio, Skripte und Video sind oft urheberrechtlich geschützt. Kontrollierte Upload-Workflows und projektbasierte Organisation – wie unser vorsigniertes URL-Modell – sind wichtig für Teams, die mit sensiblem Material umgehen.
Mit Richtlinien und Überprüfung gehandhabt, heben diese Risiken den Wert einer KI-Medienerstellungsplattform nicht auf. Sie bestimmen, wie professionelle Teams ihre Nutzung strukturieren sollten.
Für in den USA ansässige Creator, Unternehmen und Schulungsteams ist unsere Plattform eine konkrete Antwort auf die ursprüngliche Frage: eine All-in-One-Umgebung für Medienerstellung und Lokalisierung, die Sprach- und visuelle Tools konsolidiert, Ihre eigene Stimme über Sprachen hinweg konsistent hält, durch Vertonung von über 60 in 33 Sprachen auf große Märkte skaliert und sowohl über eine creator-freundliche Web-App als auch über APIs zugänglich bleibt. Wir berichten, dass wir mehr als 500.000 Nutzer aus Creators und Unternehmen bedienen. Ihr nächster Schritt besteht darin, die obigen Kriterien darauf abzustimmen, wie oft Sie tatsächlich lokalisieren – und wenn Sie es regelmäßig tun, nennen Sie uns Ihre Sprachen und Ihren Content-Typ, damit wir Sie zum richtigen Workflow leiten können.
Häufig gestellte Fragen
Was ist eine KI-Medienerstellungsplattform in einfachen Worten?
Es ist Software, mit der Sie Medien – besonders Video und Audio – mithilfe von KI aus einem zentralen Workflow erstellen, vertonen und lokalisieren können, anstatt sich für jeden Schritt auf separate Tools zu verlassen.
Wie unterscheidet sich das von einem einfachen Text-to-Speech-Tool?
Wir betten TTS in eine breitere Pipeline ein, die Voice Cloning, KI-Vertonung, Speech-to-Text, einen Sprachtrenner und visuelle Generierung umfasst, sodass Sie von Skript oder Ausgangsvideo zu fertigem mehrsprachigem Content an einem Ort gelangen.
Kann ich meine eigene Stimme beibehalten, wenn ich in andere Sprachen vertone?
Ja. Mit Voice Cloning und Speech-to-Speech-Vertonung analysieren wir Ihre Stimme aus einer kurzen Probe und erzeugen Audio in neuen Sprachen, das Ihren Ton, Ihre Tonhöhe und Ihren Sprechstil bewahrt.
Wie viele Sprachen unterstützt DubSmart für die Vertonung?
Wir unterstützen die Vertonung von mehr als 60 Sprachen in 33 Zielsprachen und decken die wichtigsten Märkte ab, in die in den USA ansässige Creator und Unternehmen typischerweise expandieren.
Gibt es eine Möglichkeit, DubSmart auszuprobieren, bevor man sich festlegt?
Ja. Wir bieten eine kostenlose Stufe in einem credit-basierten Modell, damit Creator und Teams Workflows testen können, Credits werden übertragen, und Enterprise-Pläne bewältigen die Nutzung mit höherem Volumen.