Eine KI-Synchronisations-API ist der Unterschied zwischen dem händischen Synchronisieren eines einzelnen Videos und dem direkten Einbinden der Synchronisation in alles, was Sie ohnehin veröffentlichen. Einfach ausgedrückt ist sie eine Entwicklerschnittstelle, über die eine Anwendung eine Video- oder Audiodatei senden, eine oder mehrere Zielsprachen und Stimmeinstellungen wählen und eine lokalisierte Version über API-Anfragen zurückbekommen kann – statt dass ein Mensch sich durch ein Dashboard klickt. Die eigentliche Frage hinter Was ist eine KI-Synchronisations-API dreht sich also selten nur um Definitionen. Es geht darum, ob Sie ein gelegentliches Synchronisationswerkzeug brauchen oder ob Lokalisierung wiederholt, im großen Maßstab und innerhalb Ihres eigenen Produkts oder Content-Workflows stattfinden muss.
Dieser Leitfaden ist die zentrale Anlaufstelle für die Entwicklerseite dieser Entscheidung: was eine Synchronisations-API tatsächlich leistet, wie ihr Arbeitsablauf aufgebaut ist, wie sie sich von einem reinen Text-to-Speech-Aufruf unterscheidet und wie Sie beurteilen, ob sich die Einbindung in Ihren Stack lohnt. Wo es hilfreich ist, verweisen wir auf unsere ausführlicheren Anleitungen, statt sie hier zu wiederholen.
Inhaltsverzeichnis
Was eine Synchronisations-API tatsächlich leistet
Eine Synchronisations-API bündelt mehrere Schritte der Medienverarbeitung, die sonst separate Werkzeuge erfordern würden. In einer einzigen Pipeline übernimmt sie die Spracherkennung, um die gesprochenen Worte zu erfassen, die Transkription in Text, die Übersetzung in eine gewählte Sprache, die Sprechererkennung und -trennung, die Stimmauswahl oder das Stimmklonen, die Sprachsynthese in der neuen Sprache, das Timing und die Synchronisierung und schließlich das Rendern einer lokalisierten Video- oder Audiodatei zum Download.
Diese Bündelung unterscheidet sie von einer einfachen Text-to-Speech-API. Eine Text-to-Speech-API beginnt mit Text, den Sie bereits haben, und liefert Audio zurück. Eine Synchronisations-API beginnt mit aufgenommenen Medien und übernimmt die gesamte Lokalisierungskette darum herum, sodass Ihre Anwendung niemals selbst Transkription, Übersetzung und Stimmerzeugung zusammenfügen muss. Wenn Sie nur jemals ein fertiges Skript einspeisen, ist ein Text-to-Speech-Aufruf die leichtere Wahl; wenn Sie von vorhandenem Filmmaterial ausgehen, leistet die Synchronisations-API im Hintergrund weitaus mehr.
Die vier Ebenen eines Synchronisations-Workflows
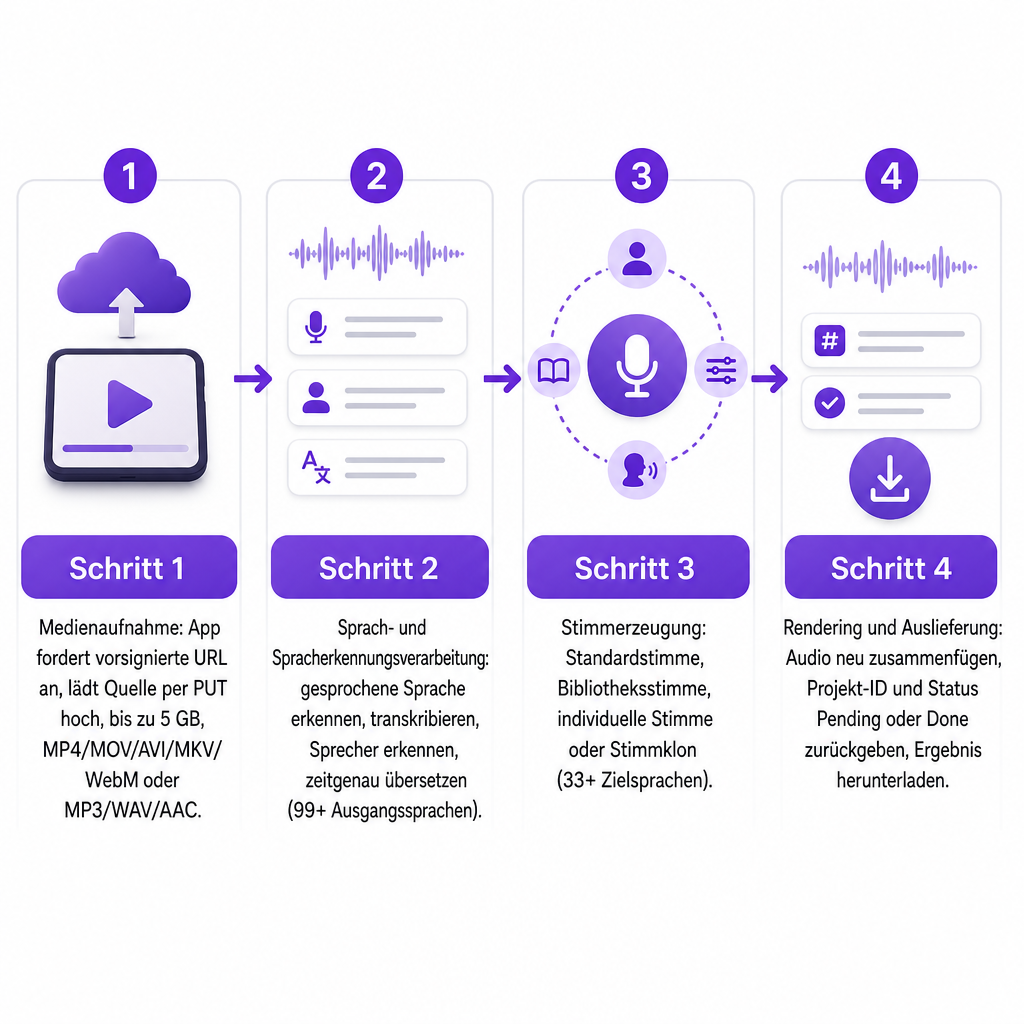
Die Implementierungen unterscheiden sich, aber fast jeder API-basierte Synchronisationsablauf gliedert sich in vier logische Ebenen, und deren Verständnis zeigt Ihnen, wo die Dinge richtig oder falsch laufen können.
Medienaufnahme. Ihre Anwendung sendet die Quelldatei an den Dienst. Einige APIs akzeptieren einen direkten Upload; andere verwenden eine öffentliche Medien-URL oder einen temporären Upload-Link. Unser veröffentlichter Workflow nutzt eine vorab signierte Upload-URL: Die Anwendung fordert die URL an und lädt dann die Datei mit einer PUT-Anfrage hoch. Unsere dokumentierte API akzeptiert gängige Videoformate wie MP4, MOV, AVI, MKV und WebM sowie Audioformate einschließlich MP3, WAV und AAC, bis zu einer maximalen Dateigröße von 5 GB.
Sprach- und Sprachenverarbeitung. Der Dienst ermittelt, was gesagt wurde, welche Sprache gesprochen wurde, wann jede Phrase einsetzt und wer spricht, und übersetzt dann das Transkript so, dass es in das verfügbare Timing passt. Dies ist die Ebene, auf der sich eine menschliche Überprüfung weiterhin lohnt – für Namen, Fachbegriffe, Witze, kulturelle Anspielungen und die Markensprache.
Stimmerzeugung. Der übersetzte Text wird mithilfe einer standardmäßigen synthetischen Stimme, einer Bibliotheksstimme, einer individuellen Stimme oder eines Klons der Originalstimme zu Sprache. Unsere KI-Synchronisations-API unterstützt das Stimmklonen, das Ton, Tonhöhe, Akzent und Sprechstil über mehr als 33 Zielsprachen hinweg bewahren soll, mit Quellsprachenerkennung für über 99 Quellsprachen. Klonen ist nicht automatisch die richtige Wahl: Eine muttersprachliche Zielstimme kann für manche Zielgruppen natürlicher klingen, während eine geklonte Stimme einem wiederkehrenden Moderator oder Dozenten mehr Kontinuität verleiht.
Rendering und Auslieferung. Die API kombiniert die erzeugte Sprache wieder mit den Originalmedien und liefert ein synchronisiertes Video, separates Audio oder einzelne Segmente zurück. Unser Workflow erstellt ein Projekt, gibt eine Projekt-ID und einen Verarbeitungsstatus wie Pending oder Done mit Fortschrittsinformationen zurück und stellt nach Abschluss des Renderns herunterladbare Ergebnis-URLs bereit.
API versus Dashboard-Synchronisationswerkzeug
Ein Online-Synchronisationswerkzeug ist für einen Menschen am Bildschirm gebaut: hochladen, Einstellungen wählen, prüfen, herunterladen. Eine Synchronisations-API ist für Software gebaut, sodass ein Entwickler die Synchronisation an eine Video-Upload-Plattform, ein Content- oder Learning-Management-System, eine Lokalisierungspipeline, einen YouTube-Produktionsworkflow, eine mobile oder Web-App oder das Batch-System einer Agentur anbinden kann. Die zugrunde liegende KI kann identisch sein; die Steuerung und das Erlebnis sind es nicht.
Die Wahl hängt in der Regel von der Häufigkeit ab und davon, wo die Arbeit stattfindet.
| Anwendungsfall | Besserer Ausgangspunkt |
|---|---|
| Gelegentlich ein einzelnes Video synchronisieren | Webbasiertes Synchronisationswerkzeug |
| Jeden neuen Upload lokalisieren | Synchronisations-API oder automatisierte Integration |
| Sprachauswahl innerhalb einer App hinzufügen | Synchronisations-API |
| Einige wenige Schulungsvideos erstellen | Webbasiertes Werkzeug, es sei denn, Automatisierung ist wichtig |
| Viele Dateien oder Sprachen wiederholt verarbeiten | Synchronisations-API |
| Stimmqualität vor dem Aufbau testen | Webbasiertes Werkzeug oder kleiner API-Pilot |
Wenn Ihre Antwort lautet „Ich synchronisiere Videos jetzt hin und wieder von Hand", beginnen Sie im Browser mit KI-Synchronisation und wechseln Sie erst dann zur API, wenn das Volumen den Entwicklungsaufwand rechtfertigt.
Warum Synchronisation ein Job ist, kein sofortiger Aufruf
Transkription, Übersetzung, Synthese, Synchronisierung und Rendering benötigen alle echte Zeit, oft länger, als eine normale Webanfrage wartet. Eine produktive Integration sollte die Synchronisation als asynchronen Job behandeln und nicht als Funktion, die sofort ein fertiges Video zurückgibt.
Das zuverlässige Muster lautet: Medien und Einstellungen übermitteln, eine Projekt- oder Job-ID erhalten, später den Status prüfen oder eine Abschlussbenachrichtigung akzeptieren, falls Webhooks existieren, die fertigen Medien und zugehörigen Dateien abrufen und dann fehlgeschlagene Jobs, Wiederholungen und abgelaufene Download-Links behandeln. Unsere öffentliche API dokumentiert die Projekterstellung, Projektstatus, Fortschrittsverfolgung und Statusabruf anhand der Projekt-ID, und eine einzige Anfrage kann mehrere Zielsprachen tragen und gruppierte Projekte für Sprachen wie Spanisch, Französisch und Deutsch gleichzeitig erstellen.
Wenn Sie Anbieter vergleichen, zählt die als Schlagzeile genannte Anzahl der Sprachen weniger als diese betrieblichen Details. Prüfen Sie auf Polling, Webhooks, Wiederholungshinweise, Idempotenz und klare Fehlerzustände, denn diese sorgen dafür, dass eine Pipeline im Produktivbetrieb stabil bleibt.
Synchronisations-API oder getrennte Sprach-APIs
Eine Synchronisations-API ist ein End-to-End-Lokalisierungsprodukt: Sie übergeben Medien und erhalten mit minimaler Orchestrierung eine andere Sprache zurück. Getrennte APIs sind sinnvoll, wenn Sie mehr von der Kette selbst in der Hand haben wollen. Verwenden Sie einen Speech-to-Text-Schritt, um ohne Übersetzung zu transkribieren, einen Übersetzungsschritt für ein vorhandenes Transkript, einen Text-to-Speech-Schritt, um ein fertiges Skript zu vertonen, eine Voice-Cloning-API, um eine individuelle Stimme zu erstellen und wiederzuverwenden, oder einen Speech Separator, um Sprache vor der Verarbeitung von Musik zu trennen.
Die Entscheidungsregel ist einfach. Greifen Sie zur integrierten Synchronisations-API, wenn Geschwindigkeit und Einfachheit zählen. Greifen Sie zu getrennten Diensten, wenn Sie das Transkript, die Übersetzungsspeicher, die Stimmpipeline, das Timing-Modell oder die finale Rendering-Ebene kontrollieren müssen. Viele Teams beginnen integriert und zerlegen die Pipeline erst dann, wenn eine bestimmte Phase, meist die Übersetzungsprüfung oder die Audioabmischung, zum Engpass wird.
Was Sie über die API steuern können
Die Einstellungen, die eine Synchronisations-API bereitstellt, entscheiden darüber, wie viel Feinschliff Sie erreichen können, ohne die Pipeline zu verlassen. Nützliche Steuerungen auf API-Ebene umfassen Quellsprache oder automatische Erkennung, eine oder mehrere Zielsprachen, Stimmauswahl und Stimmklonen, Sprecheranzahl und Zuordnung von Sprecher zu Stimme, Hintergrundlautstärke, bearbeitbaren Übersetzungstext, Segment-Timing, Untertitelerzeugung, Neuerzeugung ausgewählter Segmente sowie Ausgabeformat und Download-Optionen.
Unsere veröffentlichten Beispiele umfassen den Stimmabruf gefiltert nach Sprache, Geschlecht und Akzent; den Abruf individueller Stimmen; die Sprecherverwaltung; die Segmentbearbeitung; die Anpassung der Hintergrundlautstärke; sowie die Neuerzeugung eines gesamten Projekts oder nur ausgewählter Segmente. Diese letzte Fähigkeit macht sich bezahlt: Wenn ein einzelner Name, ein Satz, eine Aussprache oder eine Übersetzung falsch ist, können Sie mit der Neuerzeugung auf Segmentebene genau diesen Ausschnitt korrigieren, statt das ganze Video neu zu rendern. Ohne sie kann eine Korrektur von einem Wort Sie ein vollständiges Rendern kosten.
Wie Sie eine Synchronisations-API vor der Entwicklung bewerten
Ein Proof of Concept, der einen sauberen Clip synchronisiert, sagt Ihnen fast nichts über die Produktionszuverlässigkeit. Prüfen Sie sieben Bereiche unter Belastung, bevor Sie Entwicklungszeit investieren.
Sprachabdeckung. Ignorieren Sie die reine Gesamtzahl und prüfen Sie die genauen Sprachen und regionalen Varianten, die Ihr Publikum benötigt. Kann sie die Quellsprache erkennen? Werden Dialekte und das erforderliche Schriftsystem unterstützt? Sind in jeder Zielsprache Stimmen verfügbar, und sind die Fähigkeiten für geklonte und Standardstimmen identisch? Wir bewerben öffentlich über 33 Zielsprachen und über 99 Quellsprachen, darunter Englisch, Spanisch, Portugiesisch, Französisch, Deutsch, Chinesisch, Japanisch, Koreanisch, Russisch, Arabisch und Hindi; bestätigen Sie die aktuelle Liste und die Stimmverfügbarkeit, bevor Sie sich darauf verlassen.
Stimmqualität und Identität. Eine perfekte Übersetzung scheitert trotzdem, wenn die Stimme flach klingt. Testen Sie kurze und lange Sätze, Fragen, schnelles Sprechen, Pausen, mehrere Sprecher, emotionale Darbietung, Eigennamen und denselben Sprecher über mehrere Videos hinweg. Wenn Sie eine Stimme klonen, stellen Sie sicher, dass Sie eine dokumentierte Erlaubnis haben, sie zu klonen und zu verbreiten, insbesondere bei kommerzieller Arbeit und bei bekannten Personen.
Übersetzungs- und Bearbeitungssteuerung. Achten Sie auf eine Möglichkeit, das übersetzte Skript vor dem finalen Rendern zu prüfen und zu korrigieren, mit Bearbeitung auf Segmentebene, sodass sich ein Satz oder ein Zeitbereich ohne vollständige Neuerzeugung ändern lässt.
Eingabe- und Ausgabegrenzen. Prüfen Sie die maximale Dateigröße und Dauer, unterstützte Formate, URL- versus Datei-Upload, Ausgabeformate, Ablauf von Download-Links, Aufbewahrungsrichtlinien und Batch-Grenzen. Unsere veröffentlichte Seite nennt eine maximale Dateigröße von 5 GB und unterstützt gängige Video- und Audioformate.
Integrationsdesign. Eine brauchbare API ist mehr als ein einzelner Endpunkt. Prüfen Sie Authentifizierung, Upload-Handling, Projekterstellung, Statusabruf, Fehlerzustände, Wiederholungen, Paginierung, Stimmauffindung, Segmentbearbeitung, Ergebnis-Downloads, Nutzungsberichte sowie Webhooks oder einen anderen Abschlussmechanismus. Bewahren Sie Zugangsdaten auf Ihrem Server auf, niemals im Browser- oder Mobile-App-Code.
Kostenmodell. Die tatsächlichen Kosten hängen von der Quelldauer, der Anzahl der Zielsprachen, der Sprecheranzahl, dem Klonen, dem erneuten Rendern, der Speicherung, der Transkriptionsnutzung, den API-Aufrufen und der priorisierten Verarbeitung ab. Gehen Sie nicht davon aus, dass eine synchronisierte Minute einem vollständigen Lokalisierungsprojekt entspricht; schätzen Sie die Anzahl der gerenderten Sprachversionen einschließlich Überarbeitungen. Unsere öffentliche API-Seite beschreibt den Funktionsumfang, veröffentlicht dort aber keine API-Preise, fordern Sie also aktuelle kommerzielle Konditionen an, bevor Sie Ihr Budget planen.
Datenschutz, Rechte und Sicherheit. Bevor Sie Medien an einen Dritten senden, klären Sie Aufbewahrungsfristen, ob Dateien Modelle trainieren, wo Daten verarbeitet werden, wie die Löschung funktioniert, wem das erzeugte Audio gehört, welche Rechte für geklonte Stimmen gelten, ob die kommerzielle Nutzung erlaubt ist und ob Unternehmenssteuerungen vorhanden sind. Eine API kann eine unbefugte Aufnahme, ein Skript, eine Darbietung oder eine Stimme nicht rechtlich nutzbar machen; Sie brauchen die Rechte von vornherein.
Risiken und wann eine API die falsche Wahl ist
Automatisierung skaliert Fehler ebenso effizient wie sie den Output skaliert, kennen Sie also die Fehlermodi. KI-Übersetzung kann Kontext, Humor, Redewendungen oder kulturelle Anspielungen verfehlen und trotzdem flüssig klingen. Übersetzte Sprache ist oft länger oder kürzer als das Original, was unnatürliche Pausen, hastige Darbietung oder Überlappungen erzeugt. Geklonte Stimmen können emotionale Feinheiten oder Aussprache verlieren und bei verrauschtem Audio, überlappenden Sprechern, Musik oder sehr kurzen Samples an Qualität einbüßen. Musik und Effekte verringern die Genauigkeit von Transkription und Sprechertrennung, sauberes Quellaudio liefert also bessere Ergebnisse. Klonen ohne Einwilligung schafft ein echtes Risiko der Identitätsnachahmung, weshalb dokumentierte Autorisierung und eingeschränkter Zugriff auf individuelle Stimmen wichtig sind.
Eine API ist die falsche Wahl, wenn Sie nur ein einziges kurzes Video benötigen, wenn der Inhalt nuancierte schauspielerische Leistung erfordert, wenn die Quellaufnahme verrauscht oder schlecht getrennt ist, wenn Sie einen Dialekt benötigen, den die API nicht unterstützt, wenn Ihre Organisation keine Medien an einen externen Verarbeiter senden darf oder wenn jede Zeile eine professionelle sprachliche und darstellerische Überprüfung erfordert. Das verlässlichste Setup ist in der Regel hybrid: Automatisieren Sie Transkription, Übersetzung, Stimmerzeugung und Rendering, setzen Sie dann einen Menschen an das Skript und das finale Audio, bevor etwas veröffentlicht wird, und machen Sie diesen Prüfpunkt für Bildungs-, Werbe-, Gesundheits-, Finanz- und Rechtsinhalte verbindlich.
Wo die DubSmart KI-Synchronisations-API passt
Unsere KI-Synchronisations-API ist für Teams gebaut, die Medien oft genug lokalisieren, um eine Integration statt manueller Synchronisation zu rechtfertigen. Die veröffentlichte API deckt über 33 Zielsprachen, Erkennung und Verarbeitung für über 99 Quellsprachen, Stimmklonen zur Bewahrung der Sprechermerkmale, mehrere Zielsprachen in einer Projektanfrage, vorab signierte Datei-Uploads, Bearer-Token-Authentifizierung, Projekterstellung und Statusabruf, Sprecher- und Segmentbearbeitung, selektive Neuerzeugung, Video- und Audio-Downloads, Unterstützung gängiger Formate, eine maximale Dateigröße von 5 GB und kommerzielle Nutzung über alle Tarife hinweg ab.
Wenn Sie dies an der breiteren API-Landschaft ausrichten, umreißt unser Beitrag „Was ist eine Voice-AI-API? Ein Leitfaden für Einsteiger" die fünf API-Typen, und „Was ist eine Text-to-Speech-API und wie funktioniert sie?" behandelt den reinen Erzählfall. Wenn Sie bereit sind, sie anzuschließen, führt die Seite zur KI-Synchronisations-API die aktuellen Beispiele und Fähigkeiten. Für ein Schnellstart-Muster bei einem benachbarten Dienst zeigt unsere Anleitung zur Integration einer Voice-Cloning-API den Rhythmus von Upload-Erstellen-Generieren, den Sie auch bei der Synchronisation wiedererkennen werden.
Häufig gestellte Fragen
Was ist eine KI-Synchronisations-API?
Es handelt sich um eine Softwareschnittstelle, die gesprochene Medien übersetzt und automatisch synchronisiertes Audio oder Video erzeugt, wobei sie in der Regel Transkription, Übersetzung, Sprachsynthese, Synchronisierung und Medien-Rendering in einem Workflow kombiniert.
Ist eine KI-Synchronisations-API dasselbe wie Text-to-Speech?
Nein. Text-to-Speech wandelt bereitgestellten Text in Audio um. Eine Synchronisations-API beginnt mit aufgenommenem Video oder Audio und verwaltet Transkription, Übersetzung, Stimmerzeugung und Synchronisierung darum herum.
Kann eine KI-Synchronisations-API die Stimme des Originalsprechers klonen?
Einige können das. Unsere veröffentlichte KI-Synchronisations-API umfasst Stimmklonen, das die Merkmale des Originalsprechers in der Zielsprache bewahren soll, vorbehaltlich dokumentierter Einwilligung.
Kann ich ein Video gleichzeitig in mehrere Sprachen synchronisieren?
Einige APIs unterstützen mehrere Zielsprachen in einer einzigen Projektanfrage. Unser veröffentlichter Workflow zeigt eine Anfrage, die gruppierte Projekte für Spanisch, Französisch und Deutsch erstellt.
Was erhält eine Anwendung nach dem Übermitteln eines Synchronisationsjobs?
Typischerweise zunächst eine Projekt- oder Job-Kennung. Die Anwendung überwacht dann die Verarbeitung und ruft das fertige Video, Audio, Transkript, die Untertitel oder Segmente ab, sobald sie bereit sind.