Eine Voice-Cloning-API ist eine Entwicklerschnittstelle, die eine freigegebene Audioprobe in eine wiederverwendbare synthetische Stimme verwandelt, sodass eine Anwendung Text senden – oder einen automatisierten Synchronisationsauftrag ausführen – und neue Sprache zurückerhalten kann, die dem ursprünglichen Sprecher ähnelt. Statt eine feste Stimme aus einem Katalog auszuwählen, erstellt Ihr Code eine Stimmidentität, die an eine eindeutige ID gebunden ist, und verwendet sie dann über Skripte, Produkte und Sprachen hinweg wieder. Genau dieser Wechsel – vom Auswählen einer Stimme zum programmatischen Besitzen einer eigenen – macht diese Technologie für Kreative, Marken und Entwickler interessant, die in großem Maßstab arbeiten.
Die kurze Antwort auf die Frage was ist eine Voice-Cloning-API lautet: Sie stellt drei zusammenhängende Funktionen – Audio-Upload, Stimmerstellung und Stimmgenerierung – als Endpunkte bereit, die Ihre Software aufrufen kann. Zu verstehen, wie diese Teile zusammenpassen, ist das, was eine reibungslose Produktionspipeline von einer frustrierenden unterscheidet. Deshalb geht der Rest dieser Erklärung auf den Mechanismus, die Kompromisse und die Rechtsfragen ein, die Sie klären müssen, bevor eine einzige Datei online geht.
Inhaltsverzeichnis
Was eine Voice-Cloning-API tatsächlich tut
Eine Voice-Cloning-API stellt das Klonen als programmierbaren Dienst bereit, anstatt als manuelle Funktion, die in einem Audioeditor oder einem Web-Dashboard vergraben ist. Ihre Anwendung lädt eine Probe hoch, der Anbieter wandelt sie in eine benutzerdefinierte Stimme mit eigener ID um, und von da an wird diese ID zum Handle, das Sie in Text-to-Speech- oder Synchronisationsanfragen übergeben.
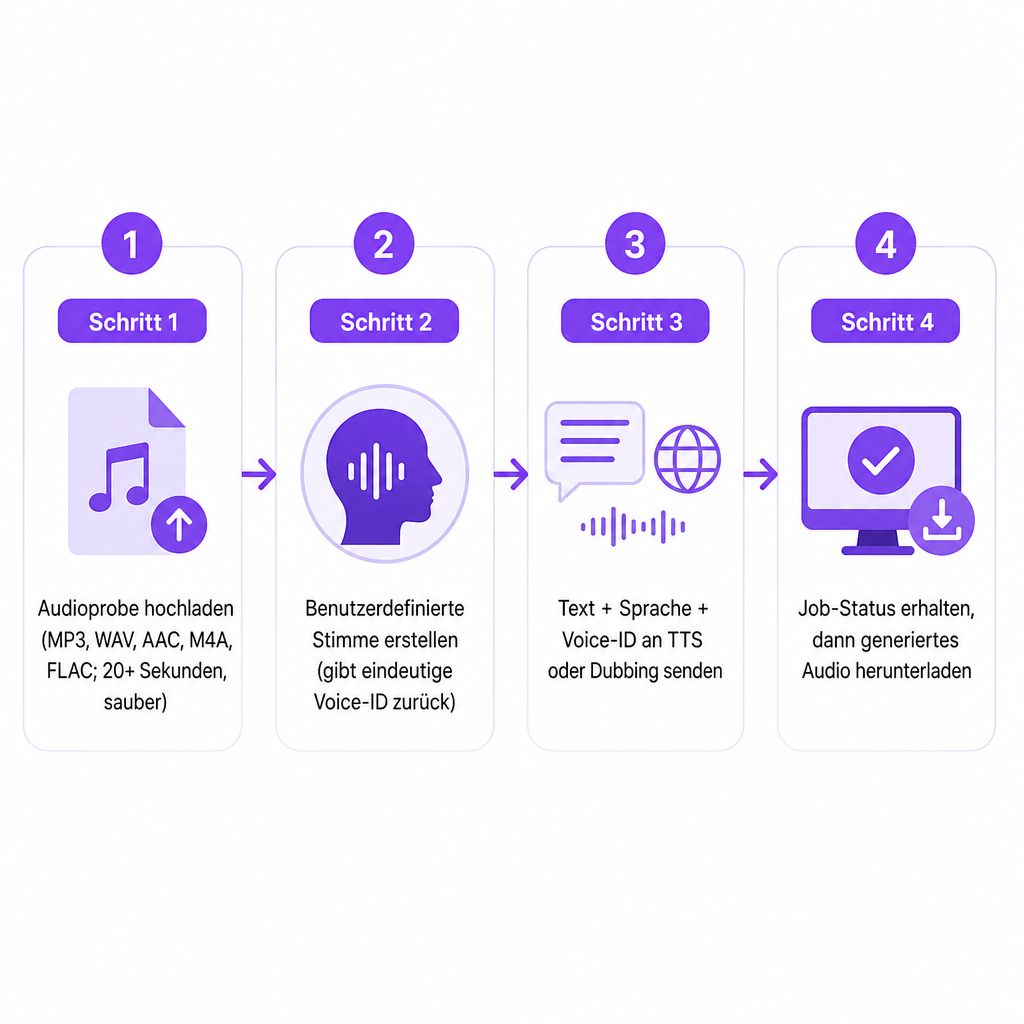
Das Muster ist bei allen Anbietern einheitlich: Aus einer Audioprobe wird eine benutzerdefinierte Stimm-ID, daraus wird neue Sprache aus Text oder einem übersetzten Skript, daraus wird eine fertige Audiodatei. Die Arbeit des maschinellen Lernens – die Analyse von Tonfall, Aussprachemustern, Tonhöhenbereich, Rhythmus und Klangfarbe – geschieht hinter dem Endpunkt, und das resultierende Stimmmodell kann ein völlig neues Skript sprechen und dabei die erkennbaren Eigenschaften des Referenzsprechers bewahren.
Eine Unterscheidung ist wichtiger als jede andere. Die API gibt nicht die ursprüngliche Aufnahme wieder; sie synthetisiert frische Sprache. Eine geklonte Stimme kann Wörter sagen, die nie in der Quellprobe vorkamen, was genau der Grund dafür ist, dass sie leistungsstark ist und warum sie Verantwortung mit sich bringt.
Wie Voice Cloning hinter der API funktioniert
Anbieter implementieren das Modell unterschiedlich, aber die meisten Systeme teilen dieselben groben Phasen, und sie zu kennen, hilft Ihnen beim Entwerfen einer zuverlässigen Integration.
Zunächst empfängt das System eine Stimmprobe. Entwickler laden sie häufig über eine vorsignierte Upload-URL hoch, die es der Anwendung ermöglicht, die Datei direkt an den Speicher zu senden, anstatt eine große Audio-Nutzlast in die Stimmerstellungsanfrage zu stopfen. Saubere Quellaudiodateien sind hier wichtig, denn das Modell kann unerwünschte Geräusche zusammen mit dem Sprecher lernen: Musik, Raumhall, mehrere überlappende Sprecher, Verzerrung und aggressive Rauschunterdrückung verringern alle die Konsistenz des Klons. Unsere Voice-Cloning-API dokumentiert Unterstützung für MP3, WAV, AAC, M4A und FLAC und empfiehlt für das beste Ergebnis mindestens 20 Sekunden Audio ohne Hintergrundgeräusche.
Zweitens erstellt der Anbieter eine benutzerdefinierte Stimme. Nach dem Upload übermittelt die Anwendung den Speicherort der gespeicherten Datei und einen Namen, und der Dienst gibt ein Stimmobjekt mit einer Kennung zurück. Diese Kennung ist der Schlüssel zu allem, was folgt – Ihre Anwendung speichert sie neben einem Benutzer-, Projekt-, Charakter- oder Markendatensatz in ihrer eigenen Datenbank. Unsere Dokumentation folgt diesem Muster mit einem Erstellungsendpunkt sowie Endpunkten zum Auflisten benutzerdefinierter Stimmen mit Paginierung und zum Löschen einer benutzerdefinierten Stimme per ID.
Drittens generiert die Anwendung neue Sprache. Sobald die benutzerdefinierte Stimme existiert, sendet Ihr Code Text, eine Sprache und die benutzerdefinierte Stimm-ID an einen Text-to-Speech-Endpunkt. Der Dienst gibt eine Projekt- oder Auftragskennung zurück; die Anwendung fragt dann den Auftragsstatus ab, bis die Verarbeitung abgeschlossen ist, und ruft die resultierende Audio-URL ab. Unsere TTS-API dokumentiert projektbasierte Generierung mit den Status „pending“, „processing“, „completed“ und „failed“ und stellt Werte für Stimme, Sprache, Geschwindigkeit und Tonhöhe auf der Ebene einzelner Segmente bereit.
Wenn Sie die tiefere Funktionsweise der Generierungsseite verstehen möchten, erklärt unser Beitrag über was eine Text-to-Speech-API ist und wie sie funktioniert die Synthesepipeline, die eine geklonte Stimme letztlich antreibt.
Voice-Cloning-API im Vergleich zu Text-to-Speech- und Synchronisations-APIs
Diese drei APIs sind miteinander verwandt, lösen aber unterschiedliche Probleme, und sie zu verwechseln führt zur falschen Architektur.
| API-Typ | Haupteingabe | Hauptausgabe | Am besten geeignet für |
|---|---|---|---|
| Text-to-Speech-API | Text plus eine ausgewählte Stimme | Synthetische Sprache | Erzählung, Benachrichtigungen, Assistenten, skriptbasiertes Audio |
| Voice-Cloning-API | Audioprobe | Benutzerdefinierte Stimm-ID | Erstellung einer wiederverwendbaren Stimmidentität |
| KI-Synchronisations-API | Video oder Audio plus Spracheinstellungen | Übersetzte, synchronisierte Medien | Mehrsprachige Video- und Audiolokalisierung |
In der Praxis funktioniert eine Voice-Cloning-API selten allein. Der Klon-Endpunkt erstellt die Stimme; ein Text-to-Speech-Endpunkt verwendet diese Stimm-ID, um neuen Text zu sprechen. Dieselbe Stimm-ID kann auch in einen Synchronisations-Workflow einfließen, bei dem das System den Originaldialog übersetzt und die übersetzte Darbietung in der gewählten benutzerdefinierten Stimme generiert. Wir beschreiben unsere benutzerdefinierten Stimmen als verwendbar sowohl in TTS- als auch in KI-Synchronisationsprojekten, was es ermöglicht, dass eine 20-sekündige Probe Erzählung und Lokalisierung aus derselben Identität bedient. Für die synchronisationsspezifische Architektur siehe unseren begleitenden Beitrag über was eine KI-Synchronisations-API ist, und für die breitere Familie der Stimm-Endpunkte unseren Leitfaden zu was eine Voice-AI-API ist.
Was Sie damit entwickeln können
Eine Voice-Cloning-API verdient ihren Platz, wenn dieselbe Stimme wiederholt über viele Skripte, Produkte oder Sprachen hinweg generiert werden muss. Einige konkrete Muster zeigen, wo sie passt.
Ein YouTube-Creator kann eine Stimmprobe aufnehmen und die resultierende Stimme für lokalisierte Versionen von Videos wiederverwenden, um Erzählungen für verschiedene Sprachmärkte zu generieren, ohne jedes Skript neu aufzunehmen. Der Klon macht die Notwendigkeit einer Übersetzungsprüfung nicht überflüssig – Namen, Redewendungen, Witze und kulturelle Bezüge brauchen weiterhin eine menschliche Kontrolle –, aber er beseitigt den Aufnahmeengpass.
Ein Unternehmen kann einen konsistenten Erzähler für Produkterklärungen, Onboarding-Videos, Werbeanzeigen und Hilfeinhalte erstellen, anstatt jeder Kampagne eine andere Stimme zuzuweisen. Der praktische Schritt vor der Produktion ist eine Stimmnutzungsrichtlinie: Welche Abteilungen dürfen die Stimme verwenden, welche Inhalte benötigen eine Freigabe, und ob synthetische Erzählung offengelegt werden muss.
Schulungsteams gewinnen die Möglichkeit, Lektionen schnell zu aktualisieren, wenn sich eine Richtlinie, ein Produktdetail oder ein Verfahren ändert, und bewahren so die Kontinuität über eine große Kursbibliothek hinweg. Bei sensiblen Themen bleibt die menschliche Prüfung unerlässlich, denn eine generierte Stimme klingt selbstbewusst, selbst wenn das Skript falsch ist. Podcast-Produzenten können eine konsistente Moderator- oder Charakterstimme für Intros, Korrekturen, Zusammenfassungen oder Ausgaben in anderen Sprachen beibehalten, was nützlich ist, wenn eine kleine Bearbeitung andernfalls eine ganz neue Session erfordern würde. Und Entwickler, die Spiele, Lern-Apps, Barrierefreiheitswerkzeuge oder geführte Erlebnisse entwickeln, können die Stimme Teil eines bestehenden Workflows machen, anstatt für jede Antwort manuell Audio zu exportieren.
Wie man eine Voice-Cloning-API bewertet
Der richtige Anbieter hängt von Ihren Produktionsanforderungen ab, nicht davon, wie ausgefeilt eine einzelne Demo klingt. Arbeiten Sie die folgenden Dimensionen durch, bevor Sie sich festlegen.
Audio-Eingabeanforderungen. Bestätigen Sie die unterstützten Dateiformate, die minimale oder empfohlene Probenlänge, ob mehrere Sprecher abgelehnt werden, wie Hintergrundgeräusche behandelt werden, ob Uploads direkt akzeptiert werden und ob Referenzdateien nach dem Klonen gelöscht werden können. Wir führen MP3, WAV, AAC, M4A und FLAC als unterstützte Formate auf und empfehlen eine saubere Probe von mindestens 20 Sekunden.
Stimmqualität und Konsistenz. Testen Sie die Stimme mit mehr als einem Satz. Nehmen Sie kurze und lange Sätze, Zahlen und Daten, Eigennamen, Fragen und Ausrufe, Fachvokabular und schwer auszusprechende Wörter auf. Ein Klon, der in einer kurzen Demo bezaubert, kann in einer langen Erzählung oder einer unbekannten Sprache abschweifen.
Sprach- und Lokalisierungsunterstützung. Wenn mehrsprachige Ausgabe das Ziel ist, überprüfen Sie die unterstützten Quell- und Zielsprachen, ob die benutzerdefinierte Stimme jede davon sprechen kann, das Akzent- und Ausspracheverhalten sowie ob die Stimme über Sprachen hinweg erkennbar bleibt. Unsere TTS-API gibt öffentlich mehr als 300 KI-Stimmen in über 33 Sprachen und Dialekten an, darunter Englisch, Portugiesisch, Spanisch, Französisch, Deutsch, Chinesisch und Japanisch. Wir veröffentlichen auf dieser Seite keinen vollständigen Sprachkatalog, prüfen Sie daher die genaue Stimm-und-Sprach-Kombination, bevor Sie einen Produktions-Workflow festlegen.
API-Architektur. Eine produktionsreife API sollte eine vorhersehbare Handhabung für Authentifizierung, Uploads, Stimmerstellung, Auflistung, Löschung, Projektstatus, erneute Versuche, Validierungsfehler, Paginierung, Audioabruf und Nutzungsüberwachung bieten. Wir zeigen in unseren Beispielen die Bearer-Token-Authentifizierung und dokumentieren sowohl Endpunkte zur Stimmverwaltung als auch die projektbasierte TTS-Verarbeitung.
Synchrone versus asynchrone Generierung. Kurze Anfragen können schnell zurückkehren, aber längere Inhalte werden besser als Auftrag behandelt: Anfrage senden, eine Auftrags-ID erhalten, Status abfragen oder empfangen und dann Audio herunterladen. Ein asynchrones Design verhindert, dass eine Webanfrage ein Timeout erhält, während eine lange Erzählung oder ein großer Stapel von Segmenten gerendert wird. Unsere TTS-Dokumentation verwendet Projektstatus und Fortschrittswerte, und das abgeschlossene Projekt gibt eine Audio-URL zusammen mit Audio-URLs pro Segment zurück.
Ausgabe- und Bearbeitungssteuerung. Überprüfen Sie das Ausgabeformat und die Qualität, ob die Abtastrate konfigurierbar ist, ob Geschwindigkeit und Tonhöhe angepasst werden können, ob einzelne Segmente heruntergeladen werden können, ob ein fehlgeschlagenes Segment neu generiert werden kann, ohne das gesamte Projekt erneut auszuführen, und ob Audio-URLs temporär oder dauerhaft sind. Wir dokumentieren MP3-Ausgabe bei 22 kHz für die TTS-API und stellen Geschwindigkeits- und Tonhöhensteuerungen auf Segmentebene bereit.
Löschung und Datenkontrollen. Ein Anbieter sollte Ihnen ermöglichen, das hochgeladene Referenzaudio, die generierte benutzerdefinierte Stimme, generierte Audiodateien und zugehörige Projektdaten zu entfernen. Unsere Voice-Cloning-API enthält einen Löschendpunkt für benutzerdefinierte Stimmen und gibt an, dass Benutzer benutzerdefinierte Stimmen und zugehöriges Audio löschen können. Prüfen Sie die aktuellen Datenschutzbestimmungen und Aufbewahrungszusagen, bevor Sie vertrauliche oder geschäftlich sensible Aufnahmen hochladen.
Rechte, Identitätsmissbrauch und verantwortungsvolle Nutzung
Das Klonen einer Stimme ist ebenso sehr eine Entscheidung über Rechte, Datenschutz und Identitätsmissbrauch wie eine technische, und sie nur als Code zu behandeln, ist der Weg, auf dem Teams in Schwierigkeiten geraten.
Beginnen Sie mit der Erlaubnis. Verwenden Sie eine Aufnahme nur, wenn Sie das Recht haben, die Stimme dieses Sprechers zu klonen und zu nutzen. Für einen geschäftlichen Workflow sollte eine schriftliche Einwilligung die Erstellung einer synthetischen Stimme, die kommerzielle Nutzung, Sprachen und Gebiete, die Lizenzdauer, Werbe- und politische Inhalte, Schulungs- und Kundendienstnutzungen, ob die Stimme unterlizenziert werden darf und wie sie gelöscht oder außer Dienst gestellt wird, abdecken. Eine Aufnahme online zu finden, verleiht Ihnen nicht das Recht, sie zu klonen.
Schützen Sie sich vor Identitätsmissbrauch, denn eine synthetische Stimme kann eine betrügerische Anfrage glaubwürdig klingen lassen. Die FTC hat gewarnt, dass Betrüger die Stimme eines Verwandten oder einer Führungskraft klonen könnten, um Menschen unter Druck zu setzen, Geld zu senden oder Informationen zu teilen. Sinnvolle Schutzmaßnahmen umfassen die Beschränkung, wer eine benutzerdefinierte Stimme erstellen oder darauf zugreifen kann, die Anforderung einer Freigabe vor der Veröffentlichung generierten Audios, die Protokollierung von Generierungsaktivitäten, die Trennung von Entwicklungs- und Produktionsanmeldedaten, die Anwendung von Ratenbegrenzungen, das Blockieren risikoreicher Inhaltskategorien und die Anforderung eines zweiten Verifizierungskanals für finanzielle Anfragen.
Für US-Zielgruppen verleiht ausgehendes Anrufen zusätzliches rechtliches Gewicht. Die FCC erklärt, dass KI-generierte Stimmen unter die Beschränkungen des Telephone Consumer Protection Act für künstliche oder vorab aufgezeichnete Stimmen fallen, und solche Anrufe erfordern in der Regel eine vorherige ausdrückliche Einwilligung, sofern keine Ausnahme gilt. Eine Voice-Cloning-API ist keine Lizenz zur Automatisierung von Telemarketing, Inkasso, politischen Anrufen oder identitätssensiblen Kommunikationen. Sie können die Entscheidung der FCC zu KI-generierten Robocall-Stimmen und die Verbraucherwarnung der FTC zum Voice Cloning direkt lesen.
Schließlich verändert das Klonen die Übermittlung, nicht die Wahrheit. Eine realistische Stimme lässt eine ungenaue Aussage maßgeblich klingen, überprüfen Sie daher Namen und Zahlen, Übersetzungen, alle medizinischen, finanziellen oder rechtlichen Aussagen, Produktanweisungen, Aussprache, Timing und Bildschirmtext vor der Veröffentlichung. Prüfen Sie bei mehrsprachigem Video sowohl das übersetzte Skript als auch das endgültige Audio – ein guter Klon kann eine Fehlübersetzung nicht retten.
Ist eine Voice-Cloning-API das Richtige für Ihr Projekt?
Eine Voice-Cloning-API passt gut, wenn Sie dieselbe Stimme über viele Dateien hinweg benötigen, Sie bereits über eine zuverlässige Text-, Übersetzungs- oder Medienpipeline verfügen, Sie programmatische Generierung statt gelegentlicher manueller Exporte wünschen, Sie eine dokumentierte Erlaubnis zur Nutzung der Referenzstimme besitzen, Sie lokalisierte oder personalisierte Inhalte in großem Maßstab produzieren und Sie generiertes Audio vor der Veröffentlichung testen und prüfen können.
Eine voreingestellte TTS-Stimme kann Ihnen besser dienen, wenn Geschwindigkeit, Einfachheit und geringes rechtliches Risiko die Markenkontinuität überwiegen. Ein professioneller Sprecher ist oft die richtige Wahl für Flaggschiff-Kampagnen, nuancierte Darbietungen, sensible Themen oder Arbeiten, die eine vollständige menschliche Regie benötigen. Für Teams, die sowohl benutzerdefinierte Stimmen als auch Lokalisierung an einem Ort benötigen, präsentieren wir Klonen, TTS und KI-Synchronisation als verbundene API-Funktionen: Unsere Voice-Cloning-API erstellt eine benutzerdefinierte Stimme aus einer Probe, und unsere TTS-API verwendet Stimm-IDs, um Sprache innerhalb eines Projekt-Workflows zu generieren. Wenn Sie bereit sind, es einzurichten, behandelt unsere Anleitung zu wie man eine Voice-Cloning-API integriert die Schritte Upload-Erstellen-Generieren im Detail.
Die nützlichste Bewertung ist ein kontrollierter Test: Verwenden Sie eine saubere, genehmigte Probe, generieren Sie dasselbe Skript in Ihren beabsichtigten Sprachen, prüfen Sie Qualität und Latenz, überprüfen Sie die Lebenszyklus- und Löschsteuerungen der API und verlangen Sie eine menschliche Freigabe, bevor etwas veröffentlicht wird.
Häufig gestellte Fragen
Ist eine Voice-Cloning-API dasselbe wie ein KI-Stimmgenerator?
Nein. Ein KI-Stimmgenerator lässt Sie in der Regel eine vorhandene synthetische Stimme auswählen und Sprache aus Text generieren. Eine Voice-Cloning-API erstellt eine benutzerdefinierte Stimme aus einer Audioprobe, die Sie dann zur Generierung wiederverwenden können.
Wie viel Audio wird benötigt, um eine Stimme zu klonen?
Die Anforderungen variieren je nach Anbieter und Modell. Wir empfehlen mindestens 20 Sekunden sauberes Audio und unterstützen die Eingabeformate MP3, WAV, AAC, M4A und FLAC.
Kann eine geklonte Stimme eine andere Sprache sprechen?
Manchmal. Das hängt vom Modell des Anbieters, seinen unterstützten Sprachen und der Fähigkeit der Stimme ab, über Sprachen hinweg zu übertragen. Überprüfen Sie die genaue Stimm-Sprach-Kombination, anstatt davon auszugehen, dass jeder Klon überall gleich gut funktioniert.
Kann ich eine geklonte Stimme für KI-Synchronisation verwenden?
Ja, wenn der Anbieter Klonen mit Synchronisation verbindet. Wir erlauben die Verwendung benutzerdefinierter Stimmen in KI-Synchronisationsprojekten durch Verweis auf die Stimm-ID.
Ist Voice Cloning legal?
Die Technologie selbst ist nicht automatisch illegal, aber die Nutzung der Stimme einer Person ohne Genehmigung kann Probleme in Bezug auf Datenschutz, Persönlichkeitsrechte, Verträge, Betrug und Verbraucherschutz verursachen. Holen Sie eine Erlaubnis ein, befolgen Sie die geltenden Gesetze und vermeiden Sie täuschenden Identitätsmissbrauch.