Ein Sprachseparator wird verwendet, um eine gesprochene Stimme aus einer unordentlichen Aufnahme herauszulösen – weg von Verkehr, Musik, Raumhall oder einer zweiten sprechenden Person –, sodass am Ende eine sauberere Stimmspur entsteht, die man transkribieren, bearbeiten, synchronisieren oder wiederverwenden kann. Diese eine Aufgabe steckt hinter einer überraschend großen Zahl alltäglicher Produktionsaufgaben. Ein YouTuber entfernt Straßenlärm aus einem Interview. Ein Podcast-Produzent rettet Dialoge, die in einem belebten Café aufgenommen wurden. Ein Marketingteam bereitet eine saubere Probe vor, bevor es eine Stimme klont. Das Tool macht eine Sache gut, und genau zu verstehen, was diese Sache ist, bewahrt dich davor, es für Aufgaben einzusetzen, für die es nie gebaut wurde.
Betrachte es als eine Bereinigungsebene und nicht als eine Erstellungsebene. Es übersetzt nicht, es generiert keine neue Erzählung und es verschleiert keinen Sprecher. Es nimmt Audio, das bereits Sprache enthält, und liefert dir diese Sprache mit weniger Störungen drumherum. Alles Folgende geht durch, wo das tatsächlich hilft, wie das zugrunde liegende Modell das Problem angeht und wann du stattdessen zu einem anderen Tool greifen solltest.
Inhaltsverzeichnis
Wie ein Sprachseparator tatsächlich funktioniert
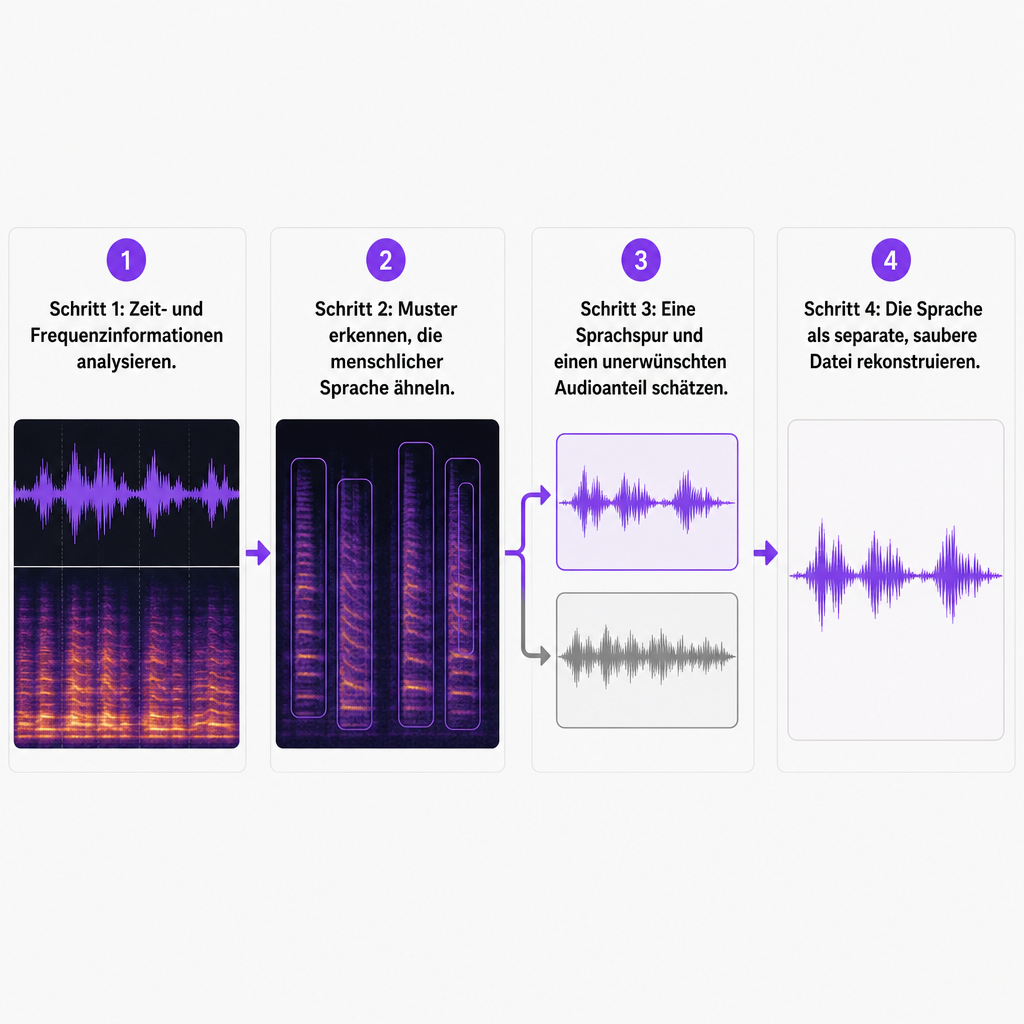
Hinter dem Knopf steckt ein KI-Modell, das darauf trainiert ist, die Muster zu erkennen, die menschliche Sprache kennzeichnen, und sie von allem anderen in der Mischung zu unterscheiden. Es liest die Zeit- und Frequenzinformationen der Aufnahme, schätzt, welche Teile des Signals Stimme sind und welche unerwünschter Klang, und rekonstruiert dann die Sprache als separate, saubere Datei. Viele Systeme nutzen einen maskenbasierten Ansatz: Sprachbezogene Anteile des Signals dürfen durchgelassen werden, während andere Elemente reduziert werden. Fortgeschrittenere Pipelines stapeln Rauschunterdrückung, Sprechertrennung und Dereverberation übereinander. Microsoft Research beschreibt Echtzeit-Einkanalsysteme, die diese Stufen kombinieren, um mehrere Sprecher aus Rauschen und Nachhall herauszulösen.
Der wichtige Vorbehalt steckt im Wort rekonstruieren. Die Ausgabe ist nicht die originale saubere Aufnahme, die du dir gewünscht hättest aufzunehmen. Sie ist eine KI-Schätzung dessen, wie die Sprache ohne die Störung klingen sollte, sodass komplexe Mischungen Artefakte erzeugen können – metallische Töne, verschluckte Konsonanten, Flattern oder unnatürliche Übergänge. Die Leistung sinkt außerdem unter realistischen Fernfeld- und Nachhallbedingungen, wie Forschung zur Sprachseparation an realen Aufnahmen dokumentiert. Je weiter das Mikrofon vom Sprecher entfernt war und je mehr der Raum hallte, desto schwieriger wird die Aufgabe des Modells.
Separation versus Rauschentfernung: warum die Bezeichnung wichtig ist
Diese Begriffe werden austauschbar verwendet, aber die Aufgabe, die du tatsächlich brauchst, ändert, welches Tool passt. Rauschentfernung senkt unerwünschten Hintergrundklang. Sprachverbesserung macht eine vorhandene Stimme leichter verständlich. Sprachseparation löst die Stimme aus einem wirklich gemischten Signal heraus. Sprechertrennung geht einen Schritt weiter und versucht, getrennte Spuren zu erzeugen, wenn zwei Menschen gleichzeitig sprechen. Und die Vokalseparation trennt musikalische Stems, was eine andere Disziplin ist, die auf Songs statt auf Dialoge abzielt.
| Aufgabe | Hauptzweck | Beispiel |
|---|---|---|
| Rauschentfernung | Unerwünschten Hintergrundklang reduzieren | Verkehrslärm oder Klimaanlagenbrummen senken |
| Sprachverbesserung | Sprachverständlichkeit verbessern | Ein leises Interview besser hörbar machen |
| Sprachseparation | Sprache aus einem gemischten Signal extrahieren | Dialog von Musik oder Umgebungsgeräuschen isolieren |
| Sprechertrennung | Jedem Sprecher eine eigene Spur geben | Zwei durcheinander redende Personen aufteilen |
| Vokalseparation | Musikalische Elemente in Stems aufteilen | Gesang aus einem Instrumental extrahieren |
Unser Sprachseparator befindet sich auf der Seite der Sprachisolierung und Hintergrundrauschentfernung in dieser Tabelle. Seine Aufgabe ist es, dir eine sauberere Stimmspur zu liefern, und die Produktseite nennt Film, Podcasts, Interviews, Voiceovers und Vorbereitung für Voice-Cloning als die Workflows, um die herum es gebaut ist. Es akzeptiert gängige Audioformate wie MP3, WAV und AAC sowie Videodateien. Zu wissen, in welcher Spalte du dich befindest, bewahrt dich davor, Pro-Sprecher-Stems von einem Tool zu erwarten, das auf Stimme-aus-Rauschen-Bereinigung abgestimmt ist.
Die acht Aufgaben, für die Menschen einen Sprachseparator einsetzen
Die Anwendungsfälle überschneiden sich, aber jeder löst ein etwas anderes Problem. Sie als unterschiedliche Aufgaben zu lesen, hilft dir zu entscheiden, ob Separation der richtige erste Schritt ist oder ob ein anderes Tool früher in die Kette gehört.
Bereinigen von Interviewaufnahmen. Interviews finden selten in akustisch behandelten Räumen statt. Büros, Straßen, Veranstaltungen und Wohnungen lassen alle Klänge in die Aufnahme einsickern. Separation reduziert diese Ablenkung und macht die befragte Person leichter hörbar, bevor du bearbeitest, untertitelst oder synchronisierst. Was es nicht kann, ist Sprache zu erfinden, die nie aufgenommen wurde – wenn das Mikrofon zu weit weg war oder eine laute Band die Stimme verschüttet hat, gibt es möglicherweise nichts Sauberes zu retten.
Verbessern von Podcast-Audio. Tastaturgeklapper, Ventilatoren, Rauschen und Raumhall überfüllen alle ein Gespräch. Eine sauberere Spur erleichtert die spätere Arbeit: Pausen kürzen, Sprecher ausbalancieren, Clips schneiden und Shownotes schreiben. Wenn mehrere Personen gleichzeitig sprechen, hängen die Ergebnisse stark vom Ausmaß der Überlappung ab, und auf überlappende Sprecher abgestimmte Modelle können eigene Verarbeitungsartefakte einführen.
Vorbereiten von Audio für Speech-to-Text. Transkriptions-Engines leisten ihre beste Arbeit, wenn Wörter klar sind und Störungen gering. Separation zuerst laufen zu lassen, verbessert oft einen Transkript-, Untertitel- oder Beschriftungsdurchlauf. Unser Speech-to-Text-Tool transkribiert Audio und Video und erzeugt Untertitel über Sprachen hinweg, und seine Genauigkeit verschiebt sich dennoch mit Audioqualität, Akzenten und Aufnahmebedingungen. Behandle Separation als Vorbereitungsschritt, nicht als Garantie: In manchen Fällen können Verbesserungsartefakte die Erkennungsgenauigkeit tatsächlich verringern, daher lohnt es sich, bei allem Wichtigen die bereinigte und die originale Spur zu vergleichen.
Bereinigen von Dialogen für die Video-Postproduktion. Editoren kämpfen regelmäßig mit Wind, Verkehr, Brummen, Mikrofonhandhabung und Übersprechen aus Hintergrundmusik. Eine brauchbare Dialogspur kann dann mit Effekten oder einem Ersatz-Voiceover neu abgemischt werden, und das Ergebnis sagt dir oft, ob eine Szene in der Postproduktion zu retten ist oder eine frische Aufnahme braucht. Aggressive Verarbeitung kann den natürlichen Raumton entfernen, daher verdienen professionelle Veröffentlichungen weiterhin das Ohr eines Editors.
Verbessern der Eingabe für Voice-Cloning. Ein Cloning-Modell lernt die Eigenschaften eines Sprechers aus einer Probe, und Rauschen, Musik und Hall erschweren das. Sauberere Eingabe führt tendenziell zu einem besseren Ergebnis, weshalb wir Separation auf der Sprachseparator-Seite als Vorbereitungsschritt für Cloning präsentieren. Das ist am wichtigsten, wenn deine einzige Probe aus einem musikunterlegten Video, einer Telefonaufnahme oder einem Livestream stammt. Die Probe muss rechtlich und ethisch nutzbar sein: Lade nur Audio hoch, das dir gehört oder das du verarbeiten darfst, und hole die Einwilligung des Sprechers ein, bevor du einen Klon erstellst oder einsetzt.
Erstellen klarerer Voiceovers. Wenn eine Neuaufnahme unpraktisch ist, eine Erzählaufnahme aber mäßiges Rauschen enthält, kann Separation sie so weit bereinigen, dass man sie über Video legen, mit Musik kombinieren oder in Kurzformate schneiden kann. Sie wird keine neue Erzählung generieren – wenn die Aufnahme wirklich unbrauchbar ist, passt ein Text-to-Speech- oder Voice-Cloning-Weg besser.
Unterstützen von Lokalisierung und Synchronisation. Bevor du ein Video übersetzt, willst du oft eine saubere Dialogspur, damit du transkribieren, untertiteln und synchronisieren kannst, während du den Hintergrund bewahrst oder neu abmischst. Wir bieten außerdem KI-Synchronisation zum Lokalisieren von Inhalten an, aber Separation und Synchronisation erledigen unterschiedliche Aufgaben: Separation bereinigt das Quellaudio, während Synchronisation Sprache in einer anderen Sprache generiert.
Rückgewinnung von Sprache aus verrauschten Archiven. Altes Filmmaterial, Webinare, aufgezeichnete Meetings und nutzergenerierte Clips werden manchmal verständlich genug für das Verstehen oder ein grobes Transkript. Prüfe bei rechtlichem, medizinischem, finanziellem oder compliance-sensiblem Material die Ausgabe gegen das Original, denn KI-Verarbeitung kann Wörter verändern oder verlieren.
Wann man einen einsetzt und wann man neu aufnimmt
Separation verdient ihren Platz, wenn die Stimme vorhanden, aber von mäßigen Störungen verdeckt ist, wenn du eine sauberere Dialogspur zum Bearbeiten brauchst, wenn du die Eingabe vor Transkription oder Cloning verbesserst oder wenn eine Neuaufnahme schlicht nicht praktikabel ist. Der gemeinsame Faden ist, dass in der Datei wiederherstellbare Sprache existiert.
Sie hat Schwierigkeiten, wenn die Stimme extrem leise oder unverständlich ist, wenn mehrere Menschen fortlaufend durcheinander reden, wenn Musik die Stimme vollständig verdeckt oder wenn die Aufnahme starken Hall oder Verzerrung trägt. Sie ist auch das falsche Tool, wenn du forensische oder sendefähige Restaurierung brauchst oder wenn exakte wortwörtliche Genauigkeit unerlässlich ist und niemand das Ergebnis überprüfen wird. Je schwerer die Störung, desto größer die Chance auf hörbare Artefakte – und reale Faktoren wie Mikrofonabstand, Nachhall und mehrere Sprecher verringern alle die Separationsleistung. Wenn die ursprüngliche Aufnahme verzerrt oder vergraben ist, klingt eine frische Aufnahme meist natürlicher als alles, was du retten kannst.
Wie man einen Sprachseparator bewertet, bevor man sich festlegt
Wähle das Tool anhand der konkreten Aufnahme aus, die du reparieren musst, nicht anhand eines sauberen Demo-Clips. Ein paar Kriterien trennen eine gute Passung von einer frustrierenden.
- Art der Separation. Entscheide, ob du Sprache aus Rauschen, Dialog aus Musik, einen Sprecher von einem anderen oder Gesang aus einem Instrumental brauchst. Ein für Sprachisolierung gebautes Tool erzeugt möglicherweise keine separate Spur für jede Stimme in einem Gespräch.
- Eingabeformate und Grenzen. Bestätige, dass das Tool deine Quelldatei akzeptiert. Unser Sprachseparator unterstützt MP3, WAV, AAC und Videodateien; prüfe dennoch die maximale Dateigröße und Exportformate vor einem großen Projekt.
- Audioqualität unter realen Bedingungen. Teste eine Probe, die den schlimmsten Hintergrund in deinem Projekt enthält, damit du das Tool an deinem schwierigsten Fall beurteilst und nicht an deinem einfachsten.
- Ausgabeartefakte. Achte auf metallische Töne, fehlende Konsonanten, abgehackte Silben, Musikübersprechen und Flattern bei überlappender Sprache. Vergleiche bei wichtigen Inhalten die verarbeitete Ausgabe mit dem Original und überprüfe das Transkript von Hand.
- Workflow-Kompatibilität. Prüfe, was der nächste Schritt braucht. Wenn Transkription folgt, stelle sicher, dass sich die Ausgabe in einem nutzbaren Format herunterladen lässt; wenn Cloning oder Synchronisation folgt, bestätige, dass die Dateien ohne sinnlose Konvertierung übergehen.
- Datenschutz und Einwilligung. Audio kann personenbezogene Daten oder identifizierbare Stimmen enthalten. Bestätige, dass du die Erlaubnis hast, es hochzuladen und zu verarbeiten, und behandle Cloning-Proben mit besonderer Sorgfalt, da eine bereinigte Probe eine Stimme leichter reproduzierbar macht.
Wie Separation in einen DubSmart-Lokalisierungs-Workflow passt
Separation arbeitet selten allein. Sie ist die Bereinigungsebene am Anfang einer längeren Kette, und die umgebenden Tools entscheiden, wie viel Wert sie hinzufügt. Für einen Creator, der ein Interview lokalisiert, sieht eine sinnvolle Abfolge so aus:
- Lass den Sprachseparator laufen, um den Dialog zu isolieren und zu bereinigen.
- Sende das bereinigte Audio an Speech-to-Text für ein bearbeitbares Transkript.
- Überprüfe Namen, Fachbegriffe, Zahlen und alle unklaren Abschnitte.
- Übersetze oder adaptiere den freigegebenen Text.
- Generiere das synchronisierte oder erzählte Audio über den richtigen Stimm-Workflow.
- Vergleiche das finale Audio mit dem Original hinsichtlich Bedeutung, Ton und Timing.
Dieses Muster eignet sich gleichermaßen für YouTube-Kanäle, Podcasts, Online-Kurse, Marketingvideos und unabhängige Filme. Der Separator erledigt die eine Aufgabe, in der er gut ist; er ersetzt nicht Transkription, Übersetzung, Bearbeitung oder Einwilligungsmanagement. Wenn du diese Rollen getrennt hältst, bekommt jedes Tool eine faire Eingabe und das fertige Ergebnis hält stand.
Häufig gestellte Fragen
Kann ein Sprachseparator Hintergrundmusik entfernen?
Er kann Sprache aus Hintergrundmusik reduzieren oder isolieren, aber das Ergebnis hängt davon ab, wie laut, komplex und stimmähnlich die Musik ist. Achte stets auf Musikübersprechen und Sprachartefakte, bevor du dich auf die Ausgabe verlässt.
Kann Sprachseparation die Transkription verbessern?
Meistens ja – das Bereinigen von Störungen macht Sprache für eine Transkriptions-Engine leichter lesbar. Aber Verbesserung kann gelegentlich Artefakte einführen, die der Genauigkeit schaden, daher brauchen wichtige Transkripte weiterhin einen menschlichen Überprüfungsdurchlauf.
Kann ich einen Sprachseparator vor dem Voice-Cloning verwenden?
Ja. Eine sauberere Probe gibt einem Cloning-Modell eine bessere Eingabe. Verwende nur Audio, das dir gehört oder das du verarbeiten darfst, und hole die Einwilligung des Sprechers ein, bevor du einen Klon erstellst oder einsetzt.
Trennt er zwei gleichzeitig sprechende Personen?
Einige Sprachseparationssysteme versuchen dies, aber überlappende Sprecher sind weitaus schwieriger als gewöhnliche Rauschentfernung. Die Ergebnisse variieren je nach Mikrofonqualität, Sprecherähnlichkeit, Raumhall und dem Ausmaß der Stimmüberlappung.
Ist ein Sprachseparator dasselbe wie ein Stimmverzerrer?
Nein. Ein Separator bereinigt oder isoliert Sprache, die bereits existiert. Ein Stimmverzerrer verwandelt die stimmliche Identität eines Sprechers. Separation unterscheidet sich auch von Speech-to-Text, Text-to-Speech, Voice-Cloning und KI-Synchronisation – verwandte Tools, die unterschiedliche Probleme lösen.