Wenn Ihr Mikrofon Straßenlärm, Café-Geplauder oder eine Musikuntermalung einfängt, die direkt über dem Dialog liegt, lautet die Frage nicht, ob die Aufnahme brauchbar ist – sondern wie man die Stimme sauber wieder herausholt. Genau das leistet ein Speech Separator. Einfach ausgedrückt ist ein Speech Separator ein KI-gestütztes Audiotool, das menschliche Sprache von allem anderen in einer Aufnahme isoliert – Hintergrundgeräuschen, Musik und anderen Klängen – sodass Ihnen eine saubere Sprachspur bleibt, die Sie transkribieren, dubben, klonen oder remixen können. Für jeden, der mehrsprachige Inhalte produziert, macht diese saubere Spur den Unterschied zwischen einer Synchronisation, die professionell klingt, und einer, die nur „gut genug“ klingt.
Dieser Leitfaden erklärt, was ein Speech Separator wirklich ist, wie er unter der Haube funktioniert, wann Sie ihn tatsächlich brauchen und was Sie abwägen sollten, bevor Sie sich für ein Tool entscheiden. Wir integrieren den Speech Separator genau deshalb in den DubSmart AI-Workflow, weil saubere Sprache das Fundament ist, auf dem alles andere steht.
Inhaltsverzeichnis
Was ein Speech Separator wirklich ist
In der Audioforschung wird Speech Separation als die Aufgabe definiert, Zielsprache von Hintergrundstörungen in einer gemischten Aufnahme zu trennen. Fortschrittlichere Systeme gehen noch weiter und trennen mehrere Sprecher voneinander, wodurch für jede Stimme eine isolierte Spur entsteht.
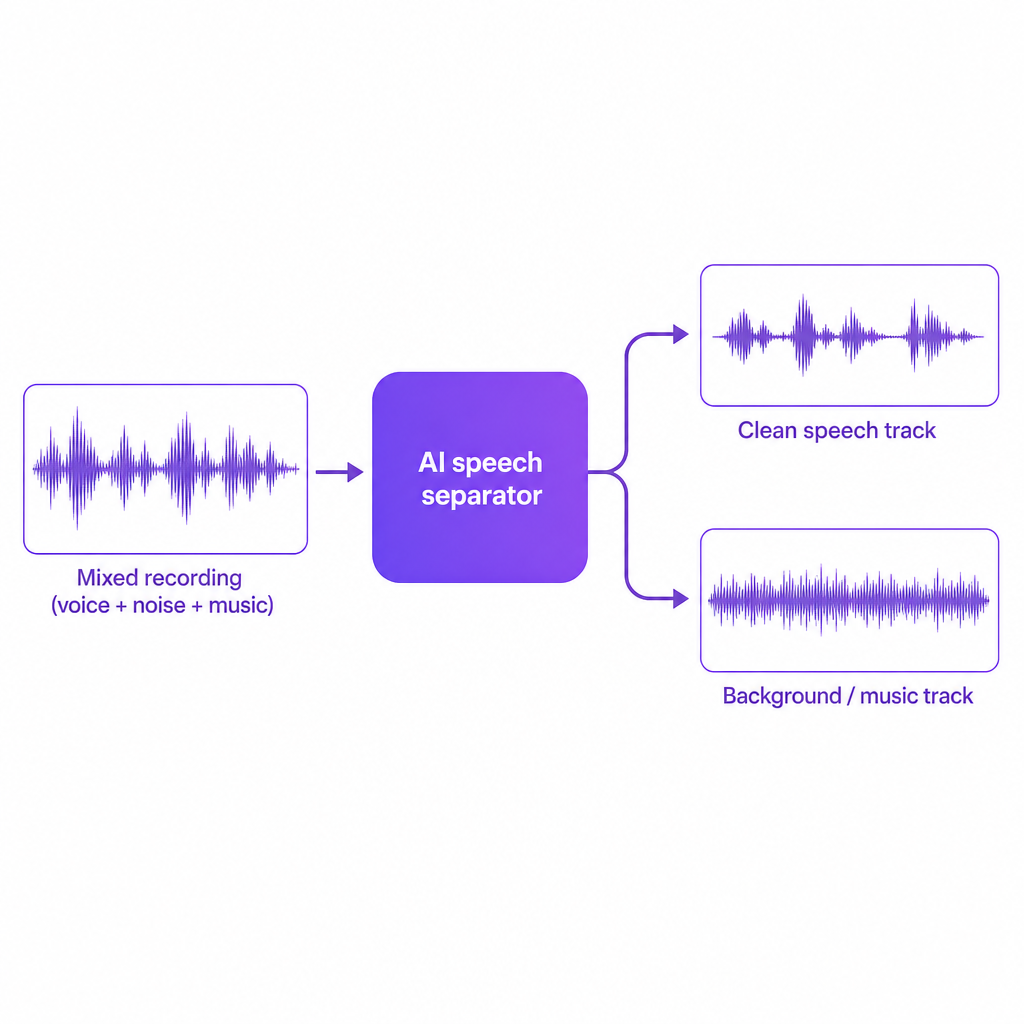
Übertragen auf die alltägliche Produktionsarbeit nimmt ein Speech Separator eine gemischte Audiodatei – Dialog plus Rauschen oder Musik – und gibt eine oder mehrere Spuren aus, die nur Sprache enthalten, sowie eine optionale Spur mit dem verbleibenden Hintergrundaudio. Unser Speech Separator wurde entwickelt, um Hintergrundgeräusche zu entfernen und Sprache aus jeder Aufnahme zu isolieren, was ihn gut für die Postproduktion von Filmen, Podcasts und Interviews geeignet macht. Er funktioniert sowohl mit Audio- als auch mit Videodateien: Er kann Aufnahmen aus lauten Umgebungen entrauschen und Gesang von einer Begleitspur trennen, sodass Sie am Ende separate Stimm- und Hintergrund-Stems erhalten.
Hier stolpern viele über ein häufiges Missverständnis. Ein Speech Separator ist nicht dasselbe wie herkömmliche Rauschunterdrückung. Rauschunterdrückung senkt die Lautstärke unerwünschter Geräusche. Ein Speech Separator erkennt aktiv, wo im Signal Sprache vorhanden ist, und rekonstruiert sie als separaten, saubereren Stream. Dieser Unterschied ist der Grund, warum ein Separator eine unter Musik verborgene Stimme retten kann, während ein Noise-Gate meist nur die gesamte Aufnahme leiser macht.
Brauchen Sie ihn wirklich?
Die eigentliche Entscheidung ist, ob Ihre Arbeit auf zuverlässiges, sauberes Sprachaudio angewiesen ist, statt auf das, was das Mikrofon zufällig eingefangen hat. Wenn das der Fall ist, hört ein dedizierter Separator auf, ein Nice-to-have zu sein, und wird zu einem grundlegenden Schritt.
Mehrere Situationen machen dieses Upgrade offensichtlich. YouTube-Ersteller und kleine Unternehmen verwenden oft älteres Filmmaterial wieder, das in hallenden Räumen, Cafés oder auf der Straße aufgenommen wurde, wo Lärm die Sprache schwer verständlich und schwer transkribierbar macht. E-Learning- und Trainingsteams erstellen mehrsprachige Kurse aus Live-Webinaren und Vorlesungen, wobei jedes nachgelagerte Transkript und jede Synchronisation die Qualität der Originalsprache erbt. Filmemacher und Podcast-Produzenten müssen häufig eine großartige Darbietung retten, die unter unvollkommenen Bedingungen aufgenommen wurde, bevor sie wieder mit Musik und Sounddesign gemischt wird. Und Entwickler oder Agenturen, die Nutzeraudio in Transkriptions-, Voice-Cloning- oder Synchronisations-Pipelines einspeisen, wissen, dass verrauschte Eingaben die Modellgenauigkeit direkt verschlechtern.
Einige konkrete Auslöser signalisieren, dass sich die Einführung eines Separators lohnt:
- Sie lokalisieren in mehrere Sprachen und wünschen sich eine konsistente, klare Synchronisation und Untertitel. Saubere Sprache speist unsere AI Dubbing- und Speech to Text-Engines weitaus zuverlässiger als ein verrauschter Mix.
- Sie verlassen sich auf Voice Cloning für eine Marken- oder Charakterstimme und wünschen sich die bestmöglichen Ergebnisse durch das Training mit entrauschten, artefaktfreien Samples.
- Sie erhalten regelmäßig nutzergenerierte oder Feldaufnahmen, die Sie nicht kontrolliert haben, und müssen sie dennoch sendefertig machen. Ein Separator bietet Ihnen eine wiederholbare Aufbereitungsphase, statt jede Datei von Hand zu justieren.
Die ehrliche Ausnahme: Wenn Ihr Audio bereits in einem akustisch behandelten Studio aufgenommen wurde, mit separaten Stems für Dialog und Musik, ist ein Separator eher eine Annehmlichkeit als eine Notwendigkeit. Für alle anderen, die mit realem Klang arbeiten, verdient er einen dauerhaften Platz in der Pipeline.
Wie Speech Separation unter der Haube funktioniert
Moderne Speech Separation basiert auf Deep Learning und Source-Separation-Forschung, nicht auf einfachem EQ und Filtern. Die zugrunde liegende Aufgabe lässt sich leicht formulieren, aber schwer lösen: Aus einem gemischten Signal, das mehrere Quellen enthält, die einzelnen Sprachsignale wiederherzustellen, ohne sie im Voraus zu kennen.
Die meisten aktuellen Systeme folgen einer Encoder-Separator-Estimator-Decoder-Pipeline. Der Encoder bildet die rohe Wellenform oder das Spektrogramm in einen hochdimensionalen Merkmalsraum ab, in dem sprachrelevante Muster wie Formanten und Harmonische leichter zu erkennen sind. Der Separator – ein neuronales Netz – verarbeitet diese Merkmale und lernt, Informationen zu entkoppeln, die zu verschiedenen Klangquellen gehören, sei es Sprache versus Rauschen oder ein Sprecher versus ein anderer. Die Schätzstufe sagt dann entweder Masken voraus, die Nicht-Sprach-Komponenten herausfiltern, oder schätzt direkt die Merkmalsrepräsentation jeder Quelle. Schließlich wandelt der Decoder diese getrennten Repräsentationen zurück in Audio im Zeitbereich um und erzeugt eine oder mehrere saubere Sprachspuren und optional eine Rest-Hintergrundspur.
Diese Modelle werden mit großen Datensätzen voller Mischungen aus Sprache und Rauschen trainiert und lernen aus beschrifteten Beispielen die unterscheidenden Muster von Sprache, Sprechern und Störungen. Neuere Forschung konditioniert den Separator auf Sprecher-Embeddings oder Prompts, wodurch es möglich wird, die Separation auf eine bestimmte Stimme innerhalb überfüllten Audios auszurichten.
Die praktische Erkenntnis für Kreative ist, dass ein moderner Separator kein aufgehübschtes Noise-Gate ist. Es ist ein Modell, das gelernt hat, wie Sprache unter vielen Bedingungen aussieht und klingt, und es kann eine Stimme rekonstruieren, selbst wenn sie unter Musik, Menschenlärm oder Raumhall verborgen ist.
Die zwei wichtigsten Separationsaufgaben
In der Praxis begegnen Ihnen zwei Ausprägungen der Speech Separation, und Plattformen kombinieren sie oft.
Die erste ist Einzelsprecher-Sprache versus Hintergrund: das Extrahieren einer kohärenten Sprachspur aus Rauschen, Musik oder Ambiente. Auf diese Aufgabe konzentriert sich unser Speech Separator für Filme, Podcasts und Interviews, weil sie direkt dem entspricht, was die meisten Kreativen im Alltag brauchen.
Die zweite ist die Mehrsprecher-Separation, bei der das System für jeden Sprecher in einem Gespräch eine separate Spur erzeugt. Das ist besonders nützlich für Diarisierung und Analysen in langformatigen Meetings oder Podiumsdiskussionen, wo es ebenso wichtig ist zu wissen, wer was gesagt hat, wie das, was gesagt wurde.
Verbrauchertools verpacken diese Funktionen tendenziell in einfachen Oberflächen – laden Sie einen Song hoch, um separate Gesangs- und Instrumentalspuren zu erhalten, oder isolieren Sie den Dialog in einem Video zur Bearbeitung. Unsere Umsetzung legt den Schwerpunkt auf die Sprache-versus-Hintergrund-Separation, weil sie die unmittelbar wertvollste Aufgabe für Synchronisations-, Transkriptions- und Cloning-Workflows ist.
Was Sie vor der Wahl eines Separators abwägen sollten
Wenn Sie bewerten, ob ein Separator professionellen Anforderungen gerecht wird, zählen eine Handvoll Kriterien mehr als Marketingtexte.
Beginnen Sie mit Sprachqualität und Artefakten. Ein guter Separator bewahrt den natürlichen Klang einer Stimme, statt sie metallisch, wie unter Wasser oder phasenverschoben klingen zu lassen, und er vermeidet die Einführung von musikalischem Rauschen oder harten Verzerrungen, wenn er starke Hintergrundelemente wie Musik herausfiltert. Wissenschaftliche Übersichtsarbeiten benennen Reststörungen und Artefakte als die größten Herausforderungen, besonders bei nicht-stationärem Rauschen. Der zuverlässigste Test ist nach wie vor, Beispielausgaben mit Ihrem eigenen Material zu prüfen.
Robustheit gegenüber realem Rauschen kommt als Nächstes. Modelle, die mit sauberen Labordaten trainiert wurden, können mit Verkehr, Wind, Menschengemurmel, halligen Räumen und Inhalten kämpfen, in denen sich Sprache mit lauter Musik oder Effekten überlagert. Modernste Arbeiten zielen genau auf diese komplexen Mischungen ab, aber die Leistung variiert weiterhin je nach Aufnahmebedingungen – testen Sie daher über die Umgebungen hinweg, in denen Sie tatsächlich aufnehmen, von Büros über Straßen bis hin zu Heimstudios.
Der Umgang mit Musik und gemischten Inhalten ist ein häufiger, spezifischer Bedarf. Das Entfernen eines Soundtracks zum Neusynchronisieren oder das Isolieren eines Sprechers von B-Roll-Material erfordert ein Tool, das die Musik-und-Stimme-Trennung ausdrücklich unterstützt und zwei brauchbare Dateien ausgibt, statt eines einzigen dumpfen Ergebnisses. Unsere Separations-Pipeline erkennt Stimmfrequenzen, isoliert sie von der Musik und erzeugt separate hochwertige Dateien: eine mit sauberem Gesang und eine mit der Musikuntermalung. Das ist besonders nützlich, wenn Sie planen, in andere Sprachen zu remixen, neu zu vertonen oder neu zu synchronisieren.
Die Integration mit nachgelagerten Tools entscheidet darüber, wie viel Zeit der Separator tatsächlich einspart. Separation steht selten für sich allein – sie speist Transkriptionsmodelle, bei denen sauberere Eingaben die Wortfehlerraten senken, Voice-Cloning-Engines, die rauschfreie Samples belohnen, und Synchronisationssysteme, die Originalsprache mit übersetzten Spuren abstimmen. Unsere Plattform ist um einen einheitlichen Workflow herum aufgebaut, der Speech Separator, Speech to Text, Text to Speech, Voice Cloning und AI Dubbing an einem Ort vereint, sodass eine einzige bereinigte Aufnahme zu mehrsprachigen, klonstimmigen, vollständig lokalisierten Inhalten werden kann, ohne jedes Mal eine Pipeline neu aufzubauen.
Latenz, Skalierung und Automatisierung sind für jeden mit einem Rückstau wichtig. Langformatige Podcasts, Kurse und Archive benötigen Stapelverarbeitung, die mehrstündige Dateien bewältigt, angemessene Verarbeitungszeiten pro Datei und Automatisierungs-Hooks, bei denen die Separation innerhalb Ihrer eigenen Systeme sitzt. Wir bieten Text to Speech-, Voice-Cloning- und AI-Dubbing-APIs, damit Entwickler die Sprachverarbeitung in End-to-End-Pipelines einbinden können.
Schließlich verschwinden Datenschutz und Compliance nicht, sobald das Audio sauber ist. Das Trennen von Sprache und Hintergrund entbindet Sie nicht von Ihrer Verantwortung für Aufnahmen, die sensible Gespräche enthalten könnten, oder von der Wahrung von Rechten, wenn Sie Stimmen aus lizenziertem Material extrahieren und wiederverwenden. Unternehmensteams sollten klare Richtlinien zur Datenspeicherung und -nutzung bestätigen und jeden Separations-Workflow mit internen Compliance-Richtlinien abstimmen.
Wo er an seine Grenzen stößt
Ein Speech Separator kann eine Aufnahme verwandeln, aber er ist keine Zauberei, und etwas anderes vorzugeben führt zu schlechten Entscheidungen.
Über-Entrauschen ist die häufigste Falle. Aggressive Separation kann subtile Sprachhinweise entfernen – weiche Konsonanten, natürliche Raumtöne – und eine Stimme unnatürlich oder ermüdend zum Anhören machen. Restartefakte sind die Kehrseite: Unter schwierigen Bedingungen kann ein Modell Spuren von Musik oder Rauschen in der Sprachspur belassen oder musikalisches Rauschen erzeugen, besonders wenn die Störung stark und ständig wechselnd ist.
Es gibt außerdem Sprecher- und Sprach-Bias zu berücksichtigen. Modelle, die überwiegend mit bestimmten Sprachen, Akzenten oder Sprechweisen trainiert wurden, können bei unterrepräsentierten Stimmen schlechter abschneiden. Und eine sauber aussehende Wellenform kann ein falsches Sicherheitsgefühl erzeugen: Sie garantiert nicht, dass das Audio für kritische Aufgaben wie forensische Analysen oder strenge Compliance-Kontexte geeignet ist.
Für kreative und Lokalisierungsarbeiten sind diese Einschränkungen handhabbar, aber sie sind ein starkes Argument dafür, mit repräsentativen Samples Ihres eigenen Materials zu testen, statt Anbieter-Demos zu vertrauen.
Der Speech Separator in unserem Workflow
Wir betrachten den Speech Separator als eine praktische, kreativenfreundliche Umsetzung dieser Technologie, eng in den Rest der DubSmart AI-Plattform integriert, statt aufgesetzt.
Im Einsatz entfernt er Hintergrundgeräusche und isoliert Sprache aus jeder Aufnahme und erzeugt saubere Stimmen, die sich für die Postproduktion von Filmen, Podcasts und Interviews eignen. Er extrahiert klaren Gesang aus gemischten Spuren und erzeugt separate hochwertige Dateien für Sprache und Hintergrundmusik, sodass Sie bearbeiten, neu synchronisieren oder remixen können, ohne gegen den Originalmix ankämpfen zu müssen. Er funktioniert sowohl mit Audio- als auch mit Videoquellen – Sie laden Dateien hoch oder verwenden Links, lassen sie durch die Pipeline laufen und laden die fertigen Spuren herunter. Und entscheidend: Diese Ausgaben sind darauf optimiert, unsere anderen Tools zu speisen, sodass eine bereinigte Aufnahme in mehrsprachige, klonstimmige, vollständig lokalisierte Inhalte verwandelt werden kann.
Für YouTube-Ersteller, kleine Unternehmen, Trainer, Filmemacher, Podcaster und Entwicklerteams verändert diese Integration die Rolle der Separation selbst. Sie hört auf, eine isolierte „Audio reparieren“-Aufgabe zu sein, und wird zum ersten standardisierten Schritt in einem größeren, automatisierten Lebenszyklus der Content-Erstellung und Lokalisierung. Wenn Sie einen mehrsprachigen Kanal oder eine Kursbibliothek aufbauen, ist genau dort, wo sich die echte Zeitersparnis summiert.
Häufig gestellte Fragen
Was ist ein Speech Separator, einfach ausgedrückt?
Es ist ein KI-Tool, das eine verrauschte, gemischte Aufnahme nimmt und eine Spur ausgibt, in der Sie überwiegend nur die menschliche Stimme hören, plus optionale Hintergrundspuren, die Sie behalten oder verwerfen können.
Ist ein Speech Separator dasselbe wie Rauschunterdrückung?
Nein. Rauschunterdrückung senkt lediglich unerwünschte Geräusche. Speech Separation identifiziert und rekonstruiert Sprache ausdrücklich als eigenständige Quelle, in der Regel mit höherer Klarheit und mehr Kontrolle über das Ergebnis.
Kann ein Speech Separator mehr als einen Sprecher verarbeiten?
Viele Systeme auf Forschungsniveau und einige Produkte können mehrere Sprecher in einzelne Spuren trennen, wobei die Qualität je nach Überlappung und Aufnahmebedingungen variiert. Unser Speech Separator konzentriert sich in erster Linie darauf, Sprache vom Hintergrund für gängige Kreativ-Workflows zu isolieren.
Verbessert die Verwendung eines Speech Separators meine Synchronisations- und Voice-Cloning-Ergebnisse?
Ja. Saubereres Eingabeaudio verbessert im Allgemeinen die Spracherkennung, die Ausrichtung und die Voice-Cloning-Qualität, was mehrsprachige Synchronisation und geklonte Stimmen natürlicher und konsistenter macht.
Funktioniert Speech Separation unabhängig von der Sprache?
Die meisten Separator-Modelle arbeiten mit akustischen Mustern statt mit Text, sodass sie viele Sprachen verarbeiten können. Die Leistung hängt dennoch von den Trainingsdaten und davon ab, wie gut Ihr Akzent repräsentiert ist.