Diese flache, leicht roboterhafte Erzählstimme, die Untertitel über einen Clip vorliest, ist zu einem der wiedererkennbarsten Klänge in Kurzvideos geworden. In dem Moment, in dem Menschen sie hören, wissen sie genau, welche Art von Inhalt sie sich ansehen. Wenn Sie nach einer zuverlässigen Möglichkeit gesucht haben, diesen TikTok-Voice-Text-to-Speech-Effekt in Videos zu bringen, die Sie überall sonst posten, ist die gute Nachricht, dass Sie nicht im Editor einer einzigen App eingeschlossen bleiben müssen, um ihn zu erhalten. Mit unserem Text-to-Speech-Tool schreiben Sie das Skript, wählen eine Stimme, die zum gewünschten Ton passt, generieren das Audio und synchronisieren es mit Ihrem Filmmaterial für TikTok, YouTube Shorts, Reels oder wo auch immer Sie veröffentlichen.
Der Grund, warum das wichtig ist, geht über das bloße Kopieren eines Trends hinaus. Eine unverwechselbare Erzählstimme ist ein Teil der Identität Ihres Kanals. Sobald sie wiedererkennbar ist, verbinden Zuschauer sie plattformübergreifend mit Ihnen. Das Problem, sich ausschließlich auf den integrierten Erzähler einer App zu verlassen, ist, dass Sie auf diese App, ihre kurze Stimmenliste und ihre Regeln beschränkt sind. Wir haben unseren Workflow so gestaltet, dass die gleiche Stimme, die Sie lieben, Ihren Inhalten überallhin folgen kann und, wenn Sie bereit sind, auch in andere Sprachen.
Inhaltsverzeichnis
- Warum die TikTok-Erzählstimme zu einem Storytelling-Werkzeug wurde
- Den Effekt mit unserem Text-to-Speech-Tool nachbilden
- Mit Voice Cloning über Standardstimmen hinausgehen
- Eine Stimme über Sprachen und Formate hinweg übertragen
- TikTok-artige Erzählung mit unseren APIs automatisieren
- Ihren Weg wählen: Standardstimme, geklonte Stimme oder API
- Häufig gestellte Fragen
Warum die TikTok-Erzählstimme zu einem Storytelling-Werkzeug wurde
Der integrierte Erzähler begann als Komfortfunktion. Sie fügen einem Clip Text hinzu, tippen, um ihn in Sprache umzuwandeln, wählen aus einer Handvoll Stimmen, und die App liest Ihre Untertitel laut vor. Anleitungen im Internet führen Anfänger durch genau das: Text hinzufügen, lange darauf drücken oder auf das Stimmen-Symbol tippen und dann einen Erzähler wählen. Weil der Prozess so einfach ist, haben Creator ihn für komödiantische Beiträge, Schritt-für-Schritt-Erklärungen, Storytime-Posts und Produktvorstellungen übernommen.
Was ein Hilfsmittel zu einem Trend machte, ist Wiederholung. Wenn Millionen von Clips dieselbe neutrale, gleichmäßig getaktete Erzählung verwenden, wird dieser Klang zum Sinnbild für einen bestimmten Inhaltsstil. Zuschauer hören ihn nicht mehr als Maschine, sondern als die Stimme des Kurzvideo-Storytellings. Diese Vertrautheit ist der Grund, warum so viele Creator jetzt denselben Effekt auf jeder Plattform wollen, auf der sie veröffentlichen, und mehr Kontrolle wünschen, als eine feste Stimmenliste erlaubt.
Die praktische Einschränkung ist leicht zu erreichen. Der integrierte Erzähler einer App bietet Ihnen ein kurzes Menü von Stimmen und hält alles innerhalb dieser einen App. Wenn Sie ein Video für eine andere Plattform wiederverwenden, verlieren Sie entweder die Erzählung oder nehmen sie neu auf. Wenn Sie eine Stimme möchten, die nicht auf der Liste steht, stecken Sie fest. Und wenn Sie dieselbe Idee in einer anderen Sprache veröffentlichen möchten, überträgt das integrierte Tool Ihren Erzähler nicht für Sie. Genau an diesen Lücken verdient sich ein dedizierter Text-to-Speech-Workflow seinen Platz, indem er Sie Erzählungen einmal generieren und überall wiederverwenden lässt, wo Sie posten.
Den Effekt mit unserem Text-to-Speech-Tool nachbilden
Unser Text-to-Speech-Tool ist der Baustein, der den Bildschirm-Erzähler-Effekt direkt nachbildet. Anstatt Untertitel in eine App zu tippen und zu hoffen, dass ihr Erzähler passt, fügen Sie Ihr Skript ein, wählen aus einer Bibliothek von mehr als 300 natürlich klingenden Stimmen und generieren sauberes Audio, das Sie in jedes Video einfügen können. Das Ergebnis ist eine herunterladbare Datei, die also zu Ihrem Projekt gehört und nicht zum Editor einer einzelnen Plattform.
Die Web-App folgt vier unkomplizierten Schritten. Erstens wählen Sie Text-to-Speech. Zweitens erstellen Sie Sprache, indem Sie Ihren Text eingeben und einen Sprecher auswählen. Drittens bearbeiten Sie das Projekt, wo Sie weitere Sprecher hinzufügen oder den Text anpassen können. Viertens laden Sie das fertige Projekt im gewünschten Format herunter. Es gibt nichts Technisches daran, und das ist der Punkt: Sie sollten Ihre Energie auf das Skript und den Schnitt verwenden, nicht auf das Ringen mit Software.
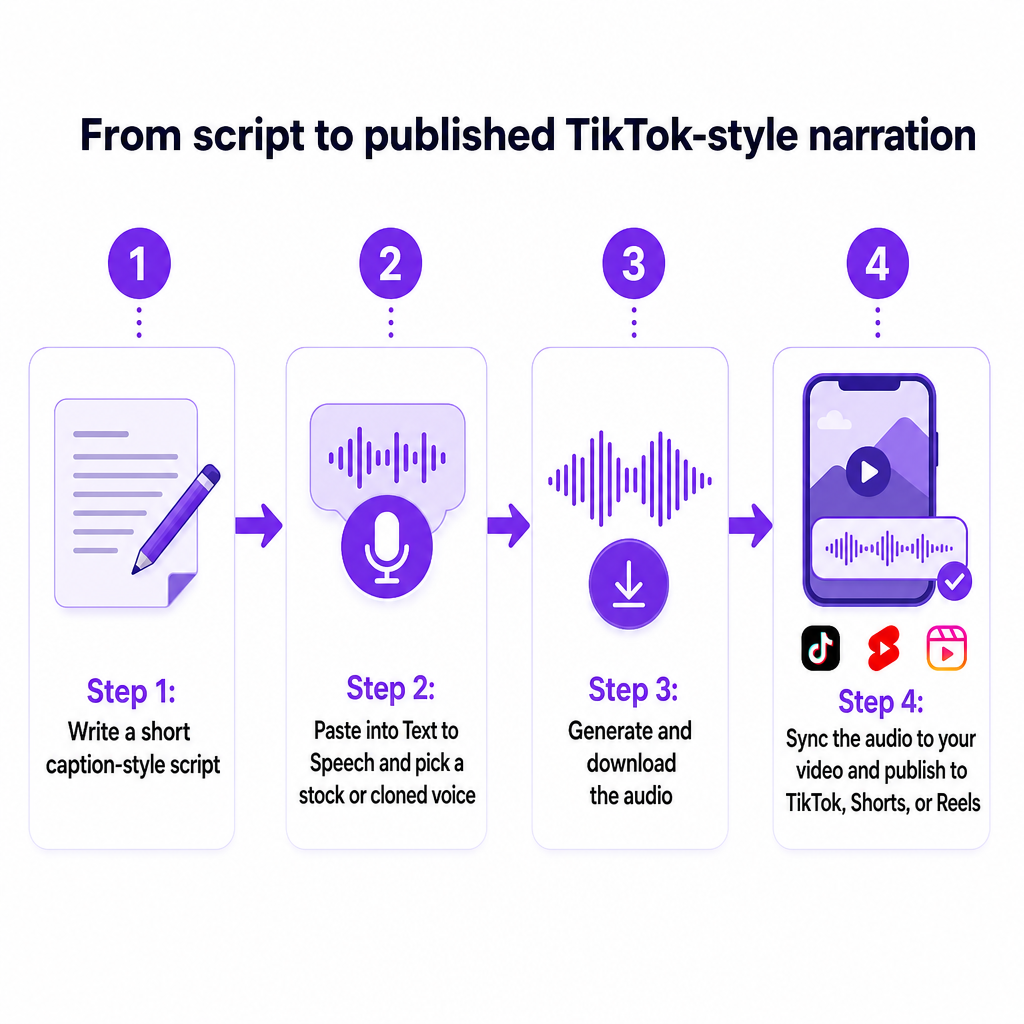
Auf Kurzvideos angewendet wird der Ablauf noch konkreter. Beginnen Sie damit, ein kurzes, untertitelartiges Skript zu schreiben, genau die Worte, die über Ihrem Clip vorgelesen werden sollen. Halten Sie es prägnant; der Erzähler-Effekt funktioniert am besten mit knappen, rhythmischen Zeilen. Fügen Sie dieses Skript in Text-to-Speech ein und wählen Sie eine Stimme, deren Ton zur gewünschten Stimmung passt, ob das nun trocken, schwungvoll oder sachlich ist. Generieren Sie das Audio, bringen Sie es dann in den Editor Ihrer Wahl und richten Sie es an den Bildern aus, bevor Sie auf TikTok, Shorts oder Reels veröffentlichen.
Weil Sie die Erzählung außerhalb einer einzelnen App generieren, funktioniert dieselbe Audiodatei auf jeder Plattform in Ihrer Posting-Rotation. Einmal aufnehmen, überall wiederverwenden. Allein das löst die größte Frustration mit dem integrierten Erzähler einer App: Sie erstellen nicht mehr dieselbe Sprachaufnahme dreimal für drei Ziele neu.
Skripte schreiben, die zum Erzählerstil passen
Die Stimme leistet viel Arbeit, aber das Skript gibt das Tempo vor. Kurze Aussagesätze lesen sich sauber und landen mit der knackigen Kadenz, die Zuschauer mit dem Trend verbinden. Zahlen, Listen und klare Wendungen wie „zuerst", „dann" und „schließlich" übersetzen sich gut in synthetisierte Sprache, weil sie der Stimme natürliche Pausenpunkte geben. Wenn eine Zeile ungeschickt klingt, wenn Sie sie laut vorlesen, wird sie auch ungeschickt klingen, wenn die Stimme sie liest, daher spart ein schneller gesprochener Durchgang, bevor Sie generieren, später viel Neugenerierung.
Mit Voice Cloning über Standardstimmen hinausgehen
Aus einer Bibliothek zu wählen ist der schnelle Weg, und für viele Creator ist eine gut gewählte Standardstimme alles, was sie brauchen. Aber es gibt eine Grenze, wie jeder andere zu klingen. Wenn Ihr Ziel ein Erzähler ist, der unverwechselbar Ihrer ist, verwandelt unser Voice Cloning Ihre eigene Stimme oder eine mit Zustimmung verwendete Markenstimme in ein wiederverwendbares Modell, das Sie per Text steuern können.
Der Unterschied ist wichtig. Generisches Text-to-Speech bedeutet, aus vorgegebenen Erzählern auszuwählen. Voice Cloning erstellt ein synthetisches Modell eines bestimmten Sprechers, sodass neue Sprache in dieser Stimme aus jedem Text generiert werden kann, den Sie eingeben. In der Web-App laden Sie eine Audiodatei mit mindestens 20 Sekunden sauberer Sprache und minimalen Hintergrundgeräuschen in den Voice-Clone-Bereich hoch. Aus diesem kurzen, ruhigen Sample erstellen wir eine benutzerdefinierte Stimme, die Sie wie jede andere in Ihren Text-to-Speech-Projekten verwenden können.
Zwanzig Sekunden sauberes Audio sind eine niedrige Hürde für den Produktionsaufwand. Ein ruhiger Raum, ein Handy oder ein einfaches Mikrofon und ein kurzer Text reichen aus, um einen charakteristischen Erzähler zu generieren, den Sie unbegrenzt wiederverwenden können. Sobald er existiert, wählen Sie nicht mehr zwischen anonymen Standardstimmen; Sie haben eine Stimme, die Ihre Identität in jeden Clip trägt, und sie bleibt konsistent, ob Sie heute oder in sechs Monaten veröffentlichen.
Hier wird ein wiedererkennbarer Erzähler zu einem Markenwert statt zu einem einmaligen Effekt. Eine geklonte Stimme liest Skripte, die Sie nie tatsächlich aufgenommen haben, behält ihren Charakter über einen ganzen Content-Kalender bei und braucht nie eine Neuaufnahme, weil Sie Ihr Setup geändert haben. Für Creator, die eine langfristige Kanalidentität aufbauen, ist diese Konsistenz das echte Upgrade gegenüber einem wechselnden Menü von App-Stimmen.
Eine Stimme über Sprachen und Formate hinweg übertragen
Eine Erzählstimme, die nur in einer Sprache funktioniert, begrenzt Ihre Reichweite in dem Moment, in dem Sie international wachsen wollen. Unsere Plattform unterstützt mehrsprachige Synchronisation über 33 Zielsprachen und kann Sprache aus Text in der von Ihnen gewählten Sprache generieren, sodass derselbe Trend, der auf Englisch funktioniert, für Zielgruppen anderswo nachgebildet werden kann.
So passen die Teile zusammen. Text-to-Speech liefert Ihnen die Erzählung. Voice Cloning lässt diese Erzählung in einer einzigen wiedererkennbaren Stimme bleiben. Unser KI-Dubbing erweitert denselben Inhalt in andere Sprachen, indem es Video und Audio über Text-to-Speech, Speech-to-Text und Voice Cloning innerhalb eines Workflows verarbeitet. Anstatt separate Erzähler für jeden Markt anzuheuern, behalten Sie eine Stimmidentität bei und lassen die Plattform sie über Versionen hinweg übertragen.
Der Workflow skaliert auch über kurze Clips hinaus. Für längere Inhalte können Sie ganze Videos oder Audiodateien hochladen, Sprechereinstellungen anpassen, Sprachen wählen und bevorzugte Stimmen innerhalb eines Projekts auswählen, bevor Sie exportieren. So gilt derselbe Ansatz, mit dem Sie einem fünfzehnsekündigen Clip einen viralen Erzähler hinzufügen, auch für einen Erklärfilm, eine Lektion oder eine ganze Episode. Kurzform ist der Ort, an dem der Trend lebt, aber die zugrunde liegenden Tools hören nicht bei der Kurzform auf.
Für Creator, die globales Wachstum planen, ändert dies die Ökonomie der Lokalisierung. Aus einem einzigen Skript wird ein englischer Short, eine spanische Version und weitere Sprachversionen, alle in einer konsistenten Stimme erzählt, ohne dass Sie Ihr Audio jedes Mal von Grund auf neu aufbauen müssen. Der Effekt des wiedererkennbaren Erzählers wird zu etwas, das Sie als wiederholbares System betreiben können statt als glücklichen Einzelfall.
TikTok-artige Erzählung mit unseren APIs automatisieren
Einzelne Creator können alles oben Genannte im Browser erledigen. Agenturen, größere Kanäle und Teams mit Backkatalogen brauchen in der Regel das gleiche Ergebnis in großem Umfang, und hier kommen unsere APIs ins Spiel. Die Text-to-Speech-API ist ein RESTful-Dienst, der Text in natürlich klingende Sprache umwandelt: Sie senden eine POST-Anfrage mit Ihrem Text und Ihren Stimmpräferenzen und erhalten im Gegenzug eine gebrauchsfertige Audiodatei. Sie unterstützt dieselben mehr als 300 Stimmen und das Voice Cloning, die in der App verfügbar sind.
Um einen benutzerdefinierten Erzähler programmatisch zu machen, folgt unsere Voice-Cloning-API einem kompakten dreistufigen Muster. Erstens laden Sie eine Audiodatei hoch und erhalten einen Dateischlüssel. Zweitens erstellen Sie eine benutzerdefinierte Stimme, indem Sie einen Namen und diesen Dateischlüssel angeben. Drittens verwenden Sie die resultierende geklonte Stimme in Text-to-Speech-Projekten über die TTS-Projekt-Endpunkte der Plattform. Sobald eine Stimme existiert, wird sie zu einem wiederverwendbaren Asset, das Ihre Anwendungen aufrufen können, und nicht zu einem einmaligen Export.
Zusammengenommen lässt dies ein Team den Effekt industrialisieren. Stellen Sie sich eine Agentur vor, die mehrere Kundenkanäle verwaltet: Sie kann pro Kunde eine geklonte Markenstimme pflegen, Skripte durch die API einspeisen und erzähltes Audio für Dutzende von Videos generieren, ohne dass eine Person jedes Mal manuell Text in ein Tool einfügt. Dasselbe Muster unterstützt Lernsysteme und Lokalisierungs-Pipelines, in denen geklonte Stimmen bei Bedarf abgerufen werden, während Inhalte produziert werden.
Für Teams, die auch Bilder generieren oder kurze Videos rund um Standbilder erstellen möchten, befindet sich unser Image-to-Video-Tooling im selben Ökosystem, sodass Audio- und Bildproduktion an einem Ort leben statt über getrennte Apps verstreut. Das Ziel ist ein einziger Workflow: eine Plattform zum Schreiben, Vertonen, Lokalisieren und Zusammenstellen.
Eine Anmerkung zu den Erwartungen: Wir beschreiben diese APIs in funktionalen Begriffen, weil davon der Workflow abhängt. Wenn Sie Details zu Ratenlimits, Durchsatz oder plan-spezifischen Setups wünschen, teilen Sie uns Ihr erwartetes Volumen und Ihren Anwendungsfall mit, damit wir eine Empfehlung vorbereiten können, die zu Ihrer Arbeitslast passt.
Ihren Weg wählen: Standardstimme, geklonte Stimme oder API
Die meisten Leser kommen mit einem von drei Bedürfnissen, und der richtige Ausgangspunkt hängt davon ab, welches Sie beschreibt. Die Tabelle unten ordnet jede Situation dem schnellsten nützlichen ersten Schritt zu.
| Ihre Situation | Bester Ausgangspunkt | Warum es passt |
|---|---|---|
| Den Effekt schnell testen | Standardstimme in Text-to-Speech | Aus über 300 Stimmen wählen, Audio in Minuten generieren, keine Aufnahme erforderlich |
| Eine charakteristische Kanalstimme aufbauen | Voice Cloning | Ein sauberes 20-Sekunden-Sample in einen wiederverwendbaren benutzerdefinierten Erzähler verwandeln |
| In großem Umfang oder über Kunden hinweg produzieren | TTS- und Voice-Cloning-APIs | Erzählung über viele Videos und mehrsprachige Versionen automatisieren |
Wenn Sie sich unsicher sind, fangen Sie einfach an. Entwerfen Sie ein kurzes untertitelartiges Skript für Ihren nächsten Beitrag, öffnen Sie Text-to-Speech im Browser und generieren Sie es mit einer Standardstimme, die zu Ihrem Ton passt. Wenn Ihnen der Effekt gefällt, Sie aber möchten, dass er wie Sie klingt, laden Sie ein sauberes 20-Sekunden-Sample hoch und klonen Sie Ihre Stimme, dann vergleichen Sie die beiden am selben Clip. Dieser eine Vergleich klärt normalerweise die Frage, ob Sie künftig einen viralen Standard-Erzähler oder eine einzigartige Markenstimme wollen.
Teams und Entwickler, die mehrere Kanäle oder einen großen Backkatalog betreiben, werden mehr Nutzen aus dem API-Zugang ziehen, da der manuelle Browser-Ablauf nicht auf Hunderte von Assets skaliert. Was auch immer zu Ihrem Volumen passt, die zugrunde liegende Fähigkeit ist dieselbe: ein wiedererkennbarer Erzähler, zu Ihren Bedingungen, auf jeder Plattform, auf der Sie veröffentlichen. Wenn Sie Hilfe dabei möchten, Ihren Kanalplan, Ihre Katalog-Größe und Ihre Sprachziele dem richtigen Ansatz zuzuordnen, teilen Sie uns diese Details mit, und wir schlagen ein passendes Setup vor.
Eine praktische Warnung, die man im Auge behalten sollte: Wenn Sie eine Stimme klonen, verwenden Sie Ihre eigene oder eine, für die Sie eine klare Erlaubnis haben, und befolgen Sie die Posting-Regeln der jeweiligen Plattform, auf der Sie veröffentlichen. Das hält Ihre Strategie mit einem wiedererkennbaren Erzähler nachhaltig statt riskant.
Häufig gestellte Fragen
Hat DubSmart AI eine Voreinstellung mit der Bezeichnung „TikTok-Stimme"?
Unser Fokus liegt darauf, den Effekt nachzubilden, statt eine bestimmte proprietäre Voreinstellung nachzuahmen. Sie erhalten dieses vertraute Bildschirm-Erzähler-Gefühl, indem Sie Audio in Text-to-Speech aus einer Bibliothek von über 300 Stimmen generieren und dann eine wählen, deren Ton zum gewünschten Stil passt. Sie können auch eine benutzerdefinierte Stimme klonen für einen Erzähler, der einzigartig Ihrer ist. Wenn Sie einen bestimmten Ton oder eine Markenstimme im Sinn haben, sagen Sie es uns, und wir schlagen einen passenden Ansatz vor.
Wie füge ich den Erzähler-Effekt zu Videos außerhalb von TikTok hinzu?
Schreiben Sie ein kurzes untertitelartiges Skript, fügen Sie es in unser Text-to-Speech-Tool ein, wählen Sie einen Sprecher und generieren Sie das Audio. Laden Sie die Datei herunter und richten Sie sie in einem beliebigen Editor an Ihrem Filmmaterial aus, veröffentlichen Sie dann auf Shorts, Reels oder wo auch immer. Weil das Audio eine eigenständige Datei ist, funktioniert eine Erzählung auf jeder Plattform, auf der Sie posten.
Was brauche ich, um meine eigene Stimme zu klonen?
Laden Sie eine Audiodatei mit mindestens 20 Sekunden sauberer Sprache und minimalen Hintergrundgeräuschen in den Voice-Clone-Bereich hoch. Aus diesem kurzen, ruhigen Sample erstellen wir ein benutzerdefiniertes Stimmmodell, das Sie dann in Ihren Text-to-Speech-Projekten wie jede andere Stimme verwenden können.
Kann ich dieselbe Stimme in verschiedenen Sprachen verwenden?
Ja. Unsere Plattform unterstützt mehrsprachige Synchronisation über 33 Zielsprachen, und durch die Kombination von Text-to-Speech, Voice Cloning und KI-Dubbing können Sie eine wiedererkennbare Stimme über Versionen desselben Inhalts hinweg beibehalten, sodass ein englischer Short und seine Versionen in anderen Sprachen einen konsistenten Erzähler teilen.
Gibt es eine Möglichkeit, dies für viele Videos auf einmal zu automatisieren?
Entwickler und Agenturen können unsere Text-to-Speech-API verwenden, um Text programmatisch in Audio umzuwandeln, und die Voice-Cloning-API, um ein Sample hochzuladen, eine benannte benutzerdefinierte Stimme zu erstellen und sie innerhalb von TTS-Projekten aufzurufen. Das lässt Sie Erzählungen über große Kataloge und mehrere Kanäle hinweg generieren, ohne manuelle Arbeit pro Video.
Sollte ich eine Standardstimme wählen oder meine eigene klonen?
Eine Standardstimme ist der schnellste Weg, den Effekt zu testen, und funktioniert für viele Creator gut. Klonen ist die bessere Wahl, wenn Sie einen Erzähler wollen, der unverwechselbar mit Ihrer Marke verbunden ist und über die Zeit konsistent bleibt. Beides am selben Clip auszuprobieren ist der schnellste Weg, um zu entscheiden, was Sie bevorzugen.