Die Skalierung der Content-Produktion mit KI bedeutet, jedes Skript, jedes Video und jede Aufnahme in zahlreiche fertige, mehrsprachige Assets zu verwandeln, ohne dass Ihr Team im gleichen Tempo wächst. Die praktische Antwort auf die Frage, wie man die Content-Produktion mit KI skaliert, besteht nicht darin, immer mehr Tools übereinanderzustapeln – sondern darin, Stimme, Vertonung, Transkription und Visuals in einem einzigen Workflow zu bündeln, in dem jedes Asset von Anfang an darauf ausgelegt ist, vervielfältigt zu werden. Bei DubSmart AI haben wir unsere Plattform genau um diesen Wandel herum aufgebaut, sodass ein Master-Content zu Dutzenden lokalisierten, wiederverwendeten Versionen werden kann – ohne einen proportionalen Anstieg bei Personal oder Budget.
Die eigentliche Entscheidung lautet nicht, ob KI Medien generieren kann. Sie lautet, ob Sie jedes Video, jede Episode und jeden Kurs weiterhin als Einzelproduktion behandeln oder sich auf einen KI-first-Workflow standardisieren, in dem Content so aufgebaut ist, dass er über Sprachen, Formate und Kanäle hinweg skaliert.
Inhaltsverzeichnis
Was Sie eigentlich skalieren möchten
Bevor Sie sich für ein Tool entscheiden, hilft es, zu benennen, was Skalierung für Ihren Kanal oder Ihre Organisation bedeutet, denn die drei gängigen Varianten ziehen in unterschiedliche Richtungen:
- Mehr Versionen desselben Contents — zusätzliche Sprachen, Formate und Längen aus einem Master.
- Mehr Content insgesamt — mehr Episoden, Lektionen oder Kampagnen, die jeden Monat veröffentlicht werden.
- Mehr Kanäle — YouTube, TikTok, Podcasts, Lernplattformen und interne Portale aus demselben Ausgangsmaterial.
Die meisten Creator und Teams benötigen irgendwann alle drei gleichzeitig, weshalb wir DubSmart als einen einzigen Ort konzipiert haben, um Medien – Stimme, Video und Bilder – zu erstellen, zu lokalisieren und zu skalieren, anstatt als Generator für einen einzigen Zweck.
Für die Zielgruppen, die wir bedienen, nimmt Skalierung tendenziell eine wiedererkennbare Form an. Ein YouTube-Creator verwandelt ein Flaggschiff-Video in synchronisierte Versionen für mehrere Märkte, plus Shorts und Promos. Ein kleines Unternehmen wandelt eine Handvoll englischer Erklärvideos in vollständige mehrsprachige Funnels aus Landing-Videos, Werbemitteln und How-to-Clips um. Ein E-Learning-Team macht aus einem Kurs eine konsistente Vertonung und lokalisierte Editionen über Regionen hinweg. Filmemacher und Podcaster verwenden Master für internationale Veröffentlichungen und barrierefreie Versionen wieder. Entwickler und Agenturen binden Stimme und Vertonung über unsere APIs direkt in ihre eigenen Produkte ein.
Die Entscheidung, die all dem zugrunde liegt, ist dieselbe: Hören Sie auf, jedes Asset als neues Projekt zu produzieren, und beginnen Sie, Master zu produzieren, die Sie zu vervielfältigen beabsichtigen.
Von der manuellen Produktion zu einem KI-beschleunigten Workflow
Eine manuelle Pipeline wiederholt für jedes Asset dieselben kostspieligen Schritte: Skript schreiben, menschliche Sprecher buchen und aufnehmen, bearbeiten, mischen, mastern, dann für jede Sprache übersetzen und neu aufnehmen, bevor für jede Überarbeitung exportiert und erneut exportiert wird. Jede neue Sprache oder jedes neue Format startet den Großteil dieser Kette von vorn.
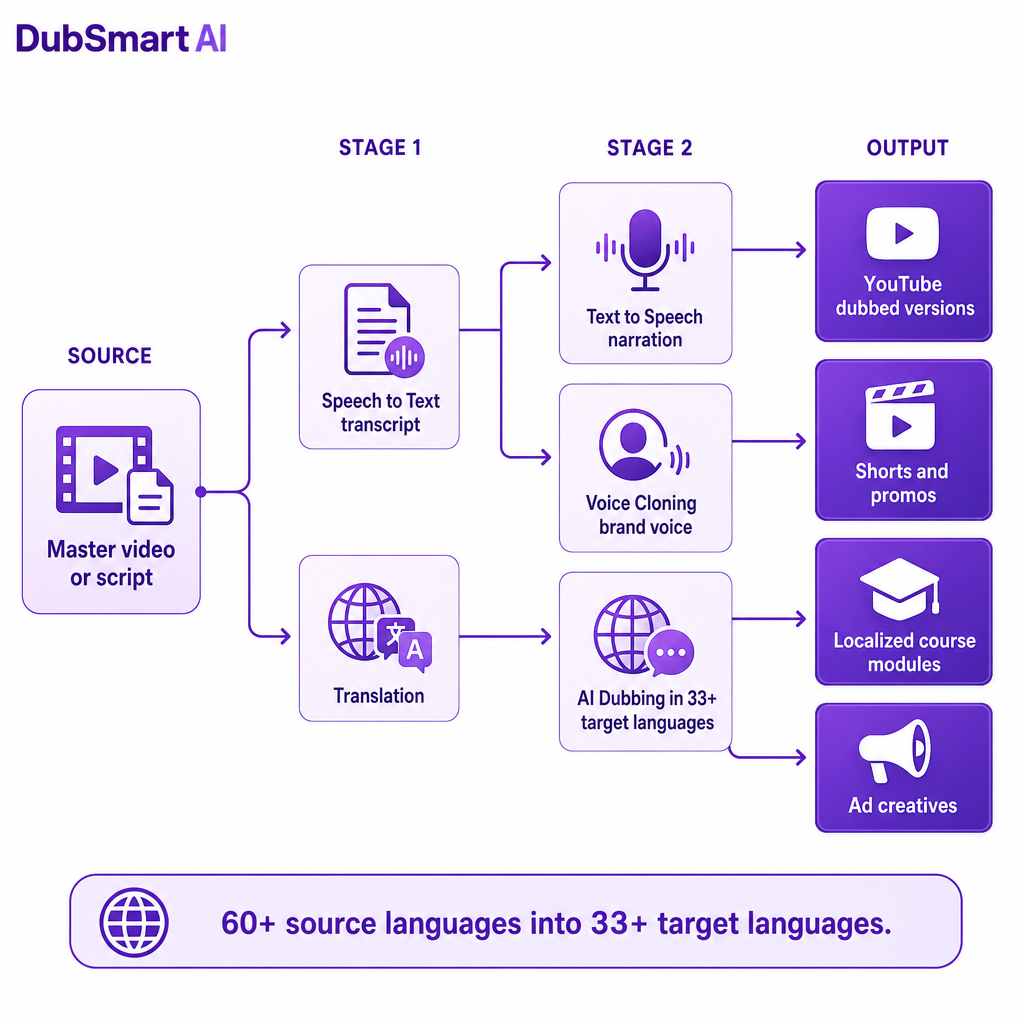
Ein KI-beschleunigter Workflow behält die kreativen Entscheidungen bei und automatisiert die wiederholbare Produktion. In unserer Plattform leben die Schritte, die früher separate Planung, Software und Dienstleister erforderten, in einem einzigen Browser-Arbeitsbereich:
- Text to Speech wandelt ein geschriebenes Skript in Sekundenschnelle in natürlich klingende Erzählung um und greift dabei auf eine Bibliothek mit über 300 Stimmen in vielen Sprachen zurück.
- Voice Cloning rekonstruiert eine Stimme aus einer kurzen Probe, sodass eine Marken- oder Creator-Persona über jedes Projekt und jede Sprache hinweg konsistent bleibt.
- AI Dubbing nimmt ein Quellvideo oder -audio, transkribiert es, übersetzt es und generiert lokalisierte Stimmspuren in über 33 Zielsprachen aus über 60 Ausgangssprachen.
- Speech to Text und Speech Separator bereinigen und transkribieren bestehende Aufnahmen und machen Archive durchsuchbar und bereit zur erneuten Bearbeitung.
- Text to Image und Image to Video generieren Visuals aus Prompts und verwandeln Standbilder in Bewegung, sodass Sie Kampagnen ausliefern können, ohne mit Filmmaterial zu beginnen.
Der Mechanismus, der tatsächlich Skalierung erzeugt, ist keine dieser Funktionen allein. Es ist die Bündelung: Die Ausgabe eines Schritts fließt im selben System in den nächsten ein, sodass aus einem Skript eine Erzählung wird, aus der Erzählung ein synchronisierter Katalog und aus einem Transkript neue geschriebene und visuelle Assets – ohne dass zwischen getrennten Apps exportiert werden muss.
Die Kernmechanismen, die Ihre Ausgabe vervielfachen
Erzählung, ohne mehr Talente zu buchen
Mit unserem Text-to-Speech-Tool können Sie ein Skript einfügen, aus Hunderten männlicher, weiblicher und neutraler Stimmen wählen und sofort eine Erzählung generieren. Das verändert Ihre Planung: Sie können zuerst das Skript schreiben und das Audio später generieren, mehrere Tonlagen testen, bevor Sie sich festlegen, und konsistente Serien produzieren – Kursmodule, Podcast-Segmente, Onboarding-Abläufe – ohne Sprachaufnahme-Sessions zu koordinieren.
Voice Cloning erweitert dies, indem es Ihnen ermöglicht, aus einer kurzen Probe eine wiederverwendbare, individuelle Stimme zu erstellen und diese sowohl bei der Erzählung als auch bei der Vertonung anzuwenden. Für eine Marke bedeutet das eine wiedererkennbare Host-Stimme in jeder Sprache, selbst wenn das ursprüngliche Talent nicht im Raum ist, plus Spielraum für bewusste Varianten – eine ruhigere Stimme für interne Schulungen neben einer prägnanteren für das Marketing – und dabei markenkonform zu bleiben.
Ein Master, viele Sprachen
Vertonung ist der primäre Hebel, um aus einem einzigen Content-Stück einen globalen Katalog zu machen. In der Praxis laden Sie ein Video hoch oder fügen einen Link ein, unsere Plattform erkennt Sprecher, transkribiert und übersetzt die Sprache und generiert lokalisierte Spuren mit derselben Stimm-Engine. Anschließend passen Sie im Editor Timings, Sprecher und Textsegmente an, bevor Sie Ihr gewähltes Format exportieren.
Die Funktionen, die dies skalieren lassen statt lediglich übersetzen, sind die Erkennung mehrerer Sprecher – unverzichtbar für Interviews, Panels und Drehbuch-Dialoge – eine breite Sprachabdeckung und eine enge Integration mit Voice Cloning, sodass jede synchronisierte Version die Identität des ursprünglichen Sprechers behalten oder eine konsistente Markenstimme tragen kann. Für die schrittweisen Taktiken behandelt unser Leitfaden zu wie man einen mehrsprachigen YouTube-Kanal erstellt den operativen Workflow; dieser Erklärartikel konzentriert sich darauf, warum Sie ihn einsetzen.
Archive in neuen Content verwandeln
Skalierung bedeutet nicht nur neue Produktion. Ein großer Anteil ungenutzter Ausgabe liegt bereits in Ihren Aufnahmen. Speech to Text erstellt präzise Transkripte und Untertitel, wodurch altes Audio und Video durchsuchbar, bearbeitbar und bereit zur Wiederverwendung werden. Speech Separator isoliert Stimme von Musik und Hintergrundgeräuschen, sodass Sie eine Spur bereinigen, remixen oder wiederverwenden können, ohne neu aufzunehmen.
Gemeinsam erschließen diese Podcast-Back-Kataloge, die zu Blogbeiträgen, Shorts und synchronisierten Episoden werden; aufgezeichnete Schulungen, die zu strukturierten Modulen mit sauberer Erzählung und Untertiteln werden; und Rohmaterial, das zu hochwertigeren Veröffentlichungen verfeinert werden kann. Wenn Sie den praktischen Prozess möchten, deckt unsere Anleitung, wie man Audio in Text transkribiert, dies direkt ab.
Visuals im Content-Tempo
Teams stoßen oft bei Design und Video an die Skalierungsgrenze, nicht beim Audio. Unser KI-Bildgenerator erstellt markenkonforme Bilder aus Prompts für Thumbnails, Social-Posts und Folien, während Image to Video Standbilder in Bewegung umwandelt, die für Erklärvideos, Werbung und Intros geeignet sind. Kombiniert mit Erzählung und Vertonung ermöglicht Ihnen dies, vom Skript über KI-Stimme und KI-Visuals bis hin zum lokalisierten Dub innerhalb eines Systems zu gelangen, anstatt für jede Phase separate Apps zusammenzufügen.
Wie verschiedene Teams ihre Skalierungsstrategie aufbauen
Da die Plattform diese Tools bündelt, hängt die richtige Strategie davon ab, wo Sie starten.
YouTube-Creator und unabhängige Filmemacher setzen auf Vertonung, um jedes Flaggschiff-Video mit Unterstützung mehrerer Sprecher und konsistenten geklonten Stimmen in mehrere Sprachversionen zu verwandeln, und kombinieren dies dann mit kurzen Promos, die per Text to Speech vertont werden, um den Kalender ohne zusätzliche Drehs zu füllen.
Kleine Unternehmen und Marketing-Teams behandeln die Plattform als Content-Multiplikator: Sie schreiben oder nehmen ein zentrales Erklärvideo auf, lokalisieren es dann und erstellen daraus Produkt-Walkthroughs und Werbemittel mit passenden Bildern und kurzen Videos, sodass ein Launch über mehrere Regionen kein proportionales Design-Budget erfordert.
E-Learning- und Corporate-Training-Produzenten generieren klare, konsistente Erzählung für Module, lokalisieren dann Kurse durch Vertonung und fügen mit Speech to Text präzise Untertitel hinzu – so bleibt ein großer Katalog kohärent und unterstützt gleichzeitig mehrsprachige Teams.
Podcaster und Audio-first-Creator bereinigen Dialoge mit Speech Separator, transkribieren für die Bearbeitung und Untertitel und verwenden diese Assets in synchronisierten oder zusammengefassten Episoden wieder. Wenn eine Veröffentlichung kinematografischen oder sendefähigen Feinschliff mit menschlicher Aufsicht erfordert, fügt unsere professionelle Dubbing-Studio-Ebene diese Supervision hinzu.
Entwickler und Agenturen integrieren unsere AI-Dubbing-API zusammen mit unseren Text-to-Speech- und Voice-Cloning-APIs, um skalierbare Stimme und Lokalisierung in ihre eigenen Produkte einzubetten – passend für Lernplattformen, OTT-Apps und Social-Video-Tools, die automatisierte Vertonung in großem Umfang benötigen.
Wann KI-first-Produktion die richtige Wahl ist
Fünf Faktoren entscheiden in der Regel darüber, ob sich ein KI-first-Stack gegenüber dem Einsatz weiterer Freelancer und Einzeltools lohnt.
| Entscheidungsfaktor | KI-first-Produktion passt, wenn | Was unsere Plattform beiträgt |
|---|---|---|
| Volumen und Frequenz | Sie veröffentlichen wöchentliche Serien, Formate mit mehreren Episoden oder Kurse mit mehreren Modulen | Ein Arbeitsbereich, der für Creator und Unternehmen mit hohem Volumen gebaut wurde |
| Sprach- und Marktabdeckung | Internationale Reichweite oder Barrierefreiheit hat Priorität | Vertonung von über 60 Ausgangs- in über 33 Zielsprachen, mit integrierter Transkription und Übersetzung |
| Budget und Kostenstruktur | Kosten pro Session für menschliche Sprecher sind unvorhersehbar | Ein kreditbasiertes Modell mit übertragbaren Credits und einem kostenlosen Tarif zur Verteilung auf die Tools |
| Markenstimme und Qualität | Sie benötigen konsistente Host-, Charakter- oder Markenstimmen | Voice Cloning plus eine Bibliothek mit über 300 Stimmen, mit einer menschlich beaufsichtigten Studio-Option für kritische Schnitte |
| Workflow und Kontrolle | Sie wollen redaktionelle Kontrolle, keine Blackbox-Ausgabe | Browserbasierte Projekt-Editoren, Steuerungen für mehrere Sprecher und APIs |
Wenn mehrere Zeilen Ihre Situation beschreiben, ist die Zentralisierung auf eine Plattform in der Regel nachhaltiger als die Erweiterung eines Flickenteppichs aus Dienstleistern und Einzweck-Apps. Wenn nur eine zutrifft, kann es sich lohnen, zunächst ein einziges Tool einzuführen und den Stack zu skalieren, während Ihr Katalog wächst.
Risiken, die vor der Skalierung gemanagt werden sollten
Die Skalierung mit KI birgt echte Risiken, und einige verdienen einen Plan statt eines Achselzuckens.
Roboterhaftes oder wenig vertrauenswürdiges Audio. Dünne synthetische Sprache untergräbt die Glaubwürdigkeit. Die Auswahl von Stimmen nach Anwendungsfall – unterschiedliche Entscheidungen für Werbung, Schulung und Podcasts – und das Testen vor der Veröffentlichung hält die Qualität über eine große Stimmbibliothek hinweg hoch.
Fragmentierter Markenklang. Das Verteilen der Arbeit auf viele Tools und Freelancer zersplittert Ihre Identität. Wiederverwendbare geklonte Stimmprofile, die über Vertonung und Erzählung hinweg angewendet werden, bewahren einen wiedererkennbaren Klang.
Übersetzung und kulturelle Nuancen. Automatische Übersetzung ist schnell, kann aber Idiome und Tonfall verfehlen. Bei besonders kritischem Content wie Film, Rundfunk oder sensiblen Schulungen sollten Sie eine menschliche Überprüfung einbauen – unser professioneller Studio-Service existiert genau für solche Fälle.
Rechte und Einwilligung für synthetische Stimmen. Voice Cloning wirft Lizenz- und Einwilligungsfragen auf. Behandeln Sie geklonte Stimmen als Assets, die eine dokumentierte Genehmigung benötigen, und halten Sie die Nutzung innerhalb eines verwalteten Arbeitsbereichs statt anonymer Generatoren. Für jurisdiktionsspezifische Verpflichtungen prüfen Sie die Anforderungen für Ihre eigene Situation.
Missbrauch und Deepfakes. Jede leistungsfähige Stimm-Engine kann missbraucht werden, wenn die Governance schwach ist. Projekte innerhalb einer Plattform, unter klaren organisatorischen Richtlinien, nachverfolgbar zu halten, macht synthetische Stimme weitaus leichter kontrollierbar als verstreute Ad-hoc-Tools.
Wenn Sie noch zwischen KI-Erzählung und der Aufnahme von Talenten abwägen, kann unser Vergleich von Vertonung versus Untertitel für Video Ihnen helfen zu entscheiden, wie weit Sie lokalisieren sollten, bevor Sie sich auf einen gesamten Katalog festlegen.
Häufig gestellte Fragen
Was unterscheidet eine All-in-One-Plattform von einem einzelnen Text-to-Speech-Tool?
Ein einzelnes Tool löst einen Schritt. Wir kombinieren Text to Speech, Voice Cloning, AI Dubbing, Speech to Text, Speech Separator, Text to Image und Image to Video in einem Arbeitsbereich, sodass Sie vom Skript oder Quellvideo zu vollständig lokalisiertem, multimodalem Content gelangen, ohne zwischen Apps zu wechseln oder zwischen ihnen neu zu exportieren.
Wie viele Sprachen kann ich realistisch unterstützen?
Unser AI Dubbing unterstützt die Vertonung von über 60 Ausgangssprachen in über 33 Zielsprachen, gestützt durch eine Bibliothek mit über 300 Stimmen und Voice Cloning. Diese Abdeckung macht es für ein kleines Team praktikabel, wirklich globale Kanäle zu betreiben.
Ist dies nur für Solo-Creator, oder können Teams es nutzen?
Beides. Wir bedienen einzelne Creator und Unternehmen, einschließlich professioneller Dubbing-Workflows mit menschlicher Aufsicht und APIs für Entwickler – sodass dieselbe Plattform sowohl zu einem Solo-YouTuber als auch zu einem Unternehmens-Schulungsteam passt.
Kann ich es in meine eigene App oder meinen Automatisierungs-Stack integrieren?
Ja. Unsere AI-Dubbing-, Text-to-Speech- und Voice-Cloning-APIs ermöglichen es Entwicklern und Agenturen, skalierbare Stimme und Lokalisierung direkt in ihre Produkte und Pipelines einzubetten.
Wie schnell kann ich von einer Sprache zu einer mehrsprachigen Präsenz gelangen?
Die Zeitpläne hängen von Ihrer Kataloggröße und Ihrem Überprüfungsprozess ab. Da Transkription, Übersetzung, Stimmgenerierung und Projektbearbeitung an einem Ort liegen, kann ein kleines Team einige Kern-Assets in Tagen oder Wochen statt Monaten in zahlreiche lokalisierte Versionen verwandeln. Für eine maßgeschneiderte Schätzung teilen Sie uns Ihre Kataloggröße, Zielsprachen und Überprüfungsanforderungen mit, und wir können einen realistischen Plan erstellen.