Ein KI-Voiceover für YouTube folgt einem einfachen Ablauf: Du verwandelst ein geschriebenes Skript mit Text-to-Speech in gesprochene Audiodatei, überprüfst das Ergebnis, fügst diese Audiodatei dann in einen Videoeditor ein und exportierst eine YouTube-fertige Datei. Zu lernen, wie man ein KI-Voiceover für YouTube erstellt, hat weniger damit zu tun, eine magische Stimme zu finden, sondern vielmehr damit, die richtige Methode zu deinem Kanal passend zu machen und dann Aussprache, Tempo und die finale Abmischung zu kontrollieren. Wir haben DubSmart AI entwickelt, um diesen gesamten Ablauf an einem Ort zu bewältigen – mit einer Kombination aus Text to Speech, Voice Cloning, Audiobereinigung und mehrsprachiger Vertonung, damit du nicht vier voneinander getrennte Tools zusammenflicken musst.
Die Entscheidung, die alles Weitere bestimmt, ist die Wahl der Stimmmethode: eine vorgefertigte KI-Stimme, ein Klon deiner eigenen Stimme oder ein übersetztes Voiceover für ein anderes Publikum. Jede davon verändert deine Produktionsgeschwindigkeit, deine Kanalidentität und die Rechte, die du absichern musst. Im Folgenden definieren wir die Methoden, zeigen, wie die Mechanik funktioniert, und geben dir klare Kriterien an die Hand, damit du dich mit Zuversicht für einen Weg entscheiden kannst.
Inhaltsverzeichnis
Was ein KI-Voiceover eigentlich ist
Ein KI-Voiceover ist eine synthetische Sprachaufnahme, die aus geschriebenem Text generiert wird. Statt jede Zeile selbst aufzunehmen oder einen Sprecher zu buchen, übergibst du ein Skript an ein Text-to-Speech-System, wählst eine Stimme aus und erzeugst eine Audiospur, die du bearbeiten und wiederverwenden kannst.
Für YouTube passt diese Flexibilität zu einer überraschend großen Bandbreite an Formaten: Erklärvideos, Tutorials und Bildschirmaufnahmen, gesichtslose Kanäle, Bildungsreihen, Produktvorführungen, Shorts, die Videoversion eines Podcasts und mehrsprachige Ausgaben von Inhalten, die du bereits veröffentlicht hast. Besonders nützlich ist es für alles, was häufige Skriptänderungen erfordert, denn du generierst eine Zeile einfach neu, statt eine Aufnahmesitzung neu zu buchen.
Was ein professionelles Ergebnis von einem offensichtlich roboterhaften unterscheidet, ist selten allein das Stimmmodell. Skriptstruktur, Umgang mit der Aussprache, Tempo, emotionale Ausrichtung, Musikpegel und die Synchronisation mit dem Bildmaterial beeinflussen alle den finalen Eindruck. Ein starker Sprechvortrag über einer schlampigen Abmischung klingt trotzdem amateurhaft – das Handwerk liegt also darin, wie du vorbereitest und zusammensetzt, nicht nur in der Wahl der Stimme.
Drei Methoden und wann sich welche lohnt
Es gibt drei praktische Wege, die Sprachaufnahme zu erstellen, und eine bewusste Entscheidung spart dir später Stunden.
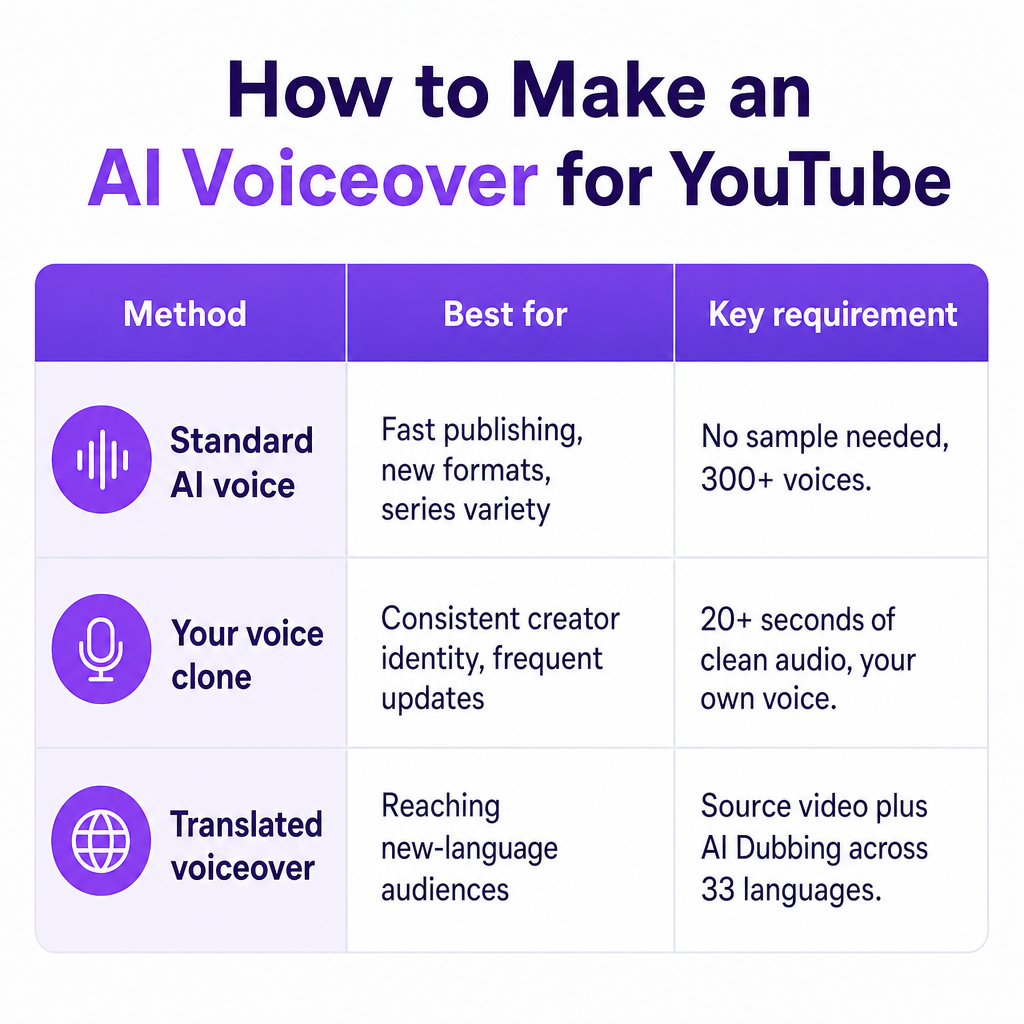
Eine Standard-KI-Stimme ist der schnellste Weg. Du wählst eine Stimme, die zu Thema, Publikum und Tonalität passt: klar und ruhig für ein Tutorial, selbstbewusst und energiegeladen für ein Tech-Review, bedacht und autoritär für einen Finanz-Erklärfilm, ausdrucksstark und locker für Gaming, heller und nachdrücklicher für Kurzformate, warm und lebendig für Kinderinhalte innerhalb angemessener Sicherheitsgrenzen. Unser Text-to-Speech-Tool bietet über 300 Stimmen mit männlichen, weiblichen und neutralen Optionen, die für Sprachaufnahmen, Werbung, Kurse und Podcasts entwickelt wurden.
Das Klonen deiner eigenen Stimme verschafft dir die Bequemlichkeit von KI, ohne deine stimmliche Identität aufzugeben – wichtig, wenn du über eine große Bibliothek hinweg eine konsistente Sprachaufnahme möchtest. Ein DubSmart-Klon lässt sich aus einer Audiodatei von mindestens 20 Sekunden erstellen, und die Aufnahme sollte sauber und frei von Hintergrundgeräuschen sein. Einmal erstellt, funktioniert diese Stimme über Text to Speech und AI Dubbing hinweg, einschließlich mehrsprachiger Ausgabe. Die unverhandelbare Regel: Klone nur deine eigene Stimme oder eine, für die du eine klare Erlaubnis hast. Jemand anderen ohne Zustimmung zu imitieren, schafft rechtliche, Reputations- und Vertrauensprobleme, die ein natürlich klingender Clip nicht entschuldigt.
Ein übersetztes Voiceover ist die bessere Wahl, wenn dein Ziel ein neuer Markt und nicht ein frischer englischer Vortrag ist. Dieser Workflow umfasst Transkription, Übersetzung, Stimmgenerierung, Timing und Abmischung – genau das, wofür unser AI Dubbing für mehrsprachige Videos in 33 Sprachen gebaut ist. Wenn du zuerst die verfügbaren Sprecherstimmen vergleichen möchtest, zeigt unsere Übersicht der besten Text-to-Speech-Stimmen für YouTube die Vor- und Nachteile nach Kanaltyp auf.
Was du vorbereiten solltest, bevor du eine einzige Zeile generierst
Mit einem halbfertigen Skript in einen Stimmgenerator zu stürzen, ist der häufigste Weg, Credits zu verschwenden und dieselbe Audiodatei dreimal neu zu generieren. Fünf Vorbereitungsschritte beseitigen fast all diese Reibung.
Beginne mit einem für die Sprachaufnahme vorbereiteten Skript, das der Struktur des Videos entspricht und von Notizen, Regieanweisungen, doppelten Sätzen und Text befreit ist, der nur auf dem Bildschirm erscheinen soll. Ergänze es durch eine Ausspracheliste, die Namen, Fachbegriffe, Akronyme, Produktnamen, URLs, Abkürzungen und Fremdwörter kennzeichnet, die Modelle häufig verstümmeln. Füge eine visuelle Zeitleiste hinzu, die markiert, wo jeder Abschnitt beginnt und endet, damit die Sprachaufnahme mit Bildschirmaufnahmen, Vorführungen, B-Roll oder Animationen übereinstimmt.
Schreibe dann ein kurzes Stimmregie-Briefing, das Tempo, Tonalität, Publikum und Energie definiert. „Freundlich und klar“ steuert einen Vortrag weitaus besser als der vage Instinkt, einfach etwas „Natürliches“ auszuwählen. Bestätige schließlich deine Rechte und Genehmigungen für Skript, Musik, Filmmaterial, Bilder und Stimme, was in dem Moment entscheidend wird, in dem Voice Cloning oder Material von Dritten ins Projekt einfließt.
Wie wir aus einem Skript eine fertige Sprachaufnahme machen
Die Kernabfolge ist kurz: Skript vorbereiten, Sprachaufnahme generieren, Audio überprüfen und ins Video einfügen. Die Qualität entsteht dadurch, wie du jeden Schritt ausführst.
Schreibe für das Sprechen, nicht für das Lesen. Kurze Sätze, natürliche Übergänge und klare Interpunktion schlagen jedes Mal dichte Absätze. Statt eines nebensatzlastigen Satzes wie „Unsere Plattform, die mehrere KI-Tools umfasst und mehrsprachige Produktion unterstützt, ermöglicht es Creatorn, effizienter zu arbeiten“, teile ihn in zwei gesprochene Zeilen: „DubSmart vereint mehrere KI-Medientools in einem Workflow. Das hilft Creatorn, Videos schneller zu produzieren und zu lokalisieren.“ Setze Kommas und Punkte dort, wo du Pausen möchtest, schreibe Zahlen aus, die das System falsch ausspricht, und teste jeden Markennamen mit ungewöhnlicher Aussprache, bevor du das vollständige Skript festlegst.
Wenn du eine Stimme auswählst, höre über den Demo-Glanz hinaus. Prüfe die Klarheit bei normaler Wiedergabegeschwindigkeit, natürliche Pausen, ein passendes stimmliches Alter und eine passende Tonalität, die korrekte Aussprache deiner Branchenbegriffe, eine Ausdruckskraft, die nicht ins Theatralische kippt, und Konsistenz über mehrere Absätze hinweg. Der einzige verlässliche Test ist dein eigener Satzstil, nicht ein Beispielsatz des Anbieters.
Generiere einen kurzen Test, bevor du etwas Längeres produzierst. Eine gute Probe packt einen Satz mit einer Zahl, einen Produkt- oder Personennamen, eine Frage, einen kommalastigen Satz, einen Fachbegriff, einen Abschnittsübergang und die emotionale Tonalität, die du durchgehend erwartest, hinein. Dieser eine Clip bringt Aussprache-, Tempo- und Tonprobleme ans Licht, solange ihre Behebung noch günstig ist.
Passe Tempo und Vortrag mit Zurückhaltung an. Unsere Text-to-Speech-Steuerungen umfassen die Sprechgeschwindigkeit, und beschreibende Formulierungen wie „sagte er fröhlich“ oder „rief sie wütend“ können Emotionen lenken, während als Wörter geschriebene Zahlen hartnäckige Fehlaussprachen beheben. Übertriebenes Tempo schadet dem Verständnis und übertriebene Emotion lässt einen Erklärfilm künstlich klingen, weshalb ein ruhiger, etwas langsamerer Vortrag Tutorials meist am besten dient.
Sobald die Probe stimmt, generiere das vollständige Skript in Abschnitten statt als einen riesigen Block, aufgeteilt nach Kapitel, Szene oder großem Übergang. Diese Struktur ermöglicht es dir, einen einzelnen fehlerhaften Absatz zu ersetzen, einen Abschnitt nach einer Bearbeitung neu zu timen, eine Aussprache zu korrigieren oder alternative Vorträge zu vergleichen, ohne alles neu zu generieren. Der dokumentierte DubSmart-Weg ist: Text to Speech öffnen, deinen Text eingeben, einen Sprecher auswählen, die Sprache generieren, das Projekt bearbeiten und das Ergebnis herunterladen.
Bearbeite das Voiceover schließlich parallel zum Video. Richte die Sprachaufnahme an der visuellen Zeitleiste aus und halte die Sprache über Musik und Effekten verständlich: senke die Hintergrundmusik, wenn die Sprachaufnahme beginnt, halte Soundeffekte von wichtigen Wörtern fern, lasse kurze Lücken zwischen zentralen Gedanken, schneide tote Stille heraus, ohne natürlichen Atemraum zu entfernen, und prüfe die Abmischung über Kopfhörer, Laptop-Lautsprecher und ein Smartphone. Sauberes KI-Audio kann sich trotzdem roboterhaft anfühlen, wenn jede Zeile gegen den nächsten Schnitt gequetscht ist – lass daher wichtige Gedanken atmen.
Eine harte Regel beim Export: YouTube akzeptiert keinen reinen Audio-Upload. Deine Spur braucht eine visuelle Ebene, sei es Filmmaterial, eine Bildschirmaufnahme, Animation, ein Standbild oder eine Wellenform. Exportiere das fertige Projekt als Videodatei; die Encoding-Empfehlungen von YouTube verweisen auf einen MP4-Container, H.264-Video, AAC-LC- oder Opus-Audio und eine Audio-Abtastrate von 48 kHz.
Wie KI-Sprachaufnahmen wirklich menschlich klingen
Das Stimmmodell erledigt nur die halbe Arbeit. Das Skript und der Schnitt tragen den Rest, und ein paar Gewohnheiten heben das Ergebnis zuverlässig an.
Schreibe umgangssprachlich. Zusammenziehungen und leichte Übergänge wie „so funktioniert es“, „schauen wir uns jetzt ein Beispiel an“ und „das ist wichtig, weil“ lesen sich weitaus natürlicher als förmliche Prosa. Widerstehe dem Drang, jede Sekunde mit Worten zu füllen; eine bewusste Pause hilft Zuschauern, einen komplexen Punkt aufzunehmen, und lässt die Sprachaufnahme überlegt statt gehetzt wirken.
Halte eine Stimme über einen Kanal hinweg konsistent, damit Zuschauer sie wiedererkennen lernen. Die Stimme bei jedem Video zu wechseln, zersplittert deine Identität, es sei denn, das Format setzt absichtlich mehrere Moderatoren ein. Ein Klon eignet sich für eine wiederkehrende Creator-Identität; eine Standardstimme passt zu einmaligen Kampagnen oder experimentellen Formaten.
Passe die Stimme an das an, was die Zuschauer sehen. Die Sprachaufnahme sollte erklären oder Kontext hinzufügen, statt den Bildschirmtext Wort für Wort vorzulesen, außer Barrierefreiheit oder didaktische Klarheit erfordern es. Lasse bei Bildschirmaufnahmen Zeit, Schaltflächen zu finden und mitzumachen; bevorzuge bei Shorts knappe Zeilen gegenüber dichten Erklärungen.
Überprüfe die Aussprache gezielt mit dem Gehör. Achte auf Akronyme, die als Wörter gelesen werden, falsch ausgesprochene Namen, Dezimalzahlen und Prozentsätze, Daten und Währungen, Fachvokabular, URLs und E-Mail-Adressen, Wörter mit mehreren Aussprachen und fremdsprachige Phrasen. Wenn etwas schiefgeht, schreibe den Begriff phonetisch um und generiere nur diesen Abschnitt neu.
Rechte, Offenlegung und die Risiken, die man im Blick behalten sollte
Die technischen Schritte sind der einfache Teil. Die Risiken, die einen Kanal tatsächlich bedrohen, betreffen Rechte, Transparenz und Wert.
Beginne mit Stimmrechten und Einwilligung. Klone niemals eine Berühmtheit, einen Kunden, Mitarbeiter, Sprecher oder sonst jemanden ohne Erlaubnis, und sorge dafür, dass diese Einwilligung sowohl das Erstellen des Klons als auch dessen Nutzung abdeckt, einschließlich kommerzieller Veröffentlichung, Werbung, Lokalisierung und künftiger Wiederverwendung. Wir behandeln Einwilligung und verantwortungsvolle Nutzung als Teil unseres Voice-Cloning-Ansatzes, aber unsere öffentlichen Seiten sind kein juristischer Freigabedienst – bewahre daher deine eigenen Genehmigungsnachweise auf und prüfe die für dein Projekt geltenden Gesetze und Verträge.
Zur Offenlegung: YouTube verlangt sie, wenn KI-generierte oder veränderte Inhalte realistisch aussehen und Zuschauer in die Irre führen könnten, etwa indem eine reale Person etwas zu sagen scheint, was sie nicht gesagt hat. YouTube führt das Klonen deiner eigenen Stimme für Voiceovers oder Vertonungen ausdrücklich als Beispiel auf, das keine Offenlegung erfordert, während eine realistische synthetische Stimme, die jemand anderen imitiert, dies erfordern kann. Beim Upload legst du dies in YouTube Studio im Bereich „Attribute“ fest, indem du „Ja“ oder „Nein“ zur KI-Nutzung auswählst. Wenn du wirklich unsicher bist, ist die Offenlegung die sicherere Wahl: YouTube erklärt, dass die Offenlegung selbst weder die Reichweite noch die Einnahmeberechtigung einschränkt, während wiederholtes Versäumnis der Offenlegung Kennzeichnungen oder Strafen auslösen kann, einschließlich der Entfernung oder des Ausschlusses aus dem Partnerprogramm.
KI befreit dich auch nicht von der Originalitätshürde. Die Nutzung einer KI-Stimme verhindert keine Monetarisierung, aber das fertige Video braucht dennoch echten Wert durch Recherche, Kommentierung, Bildung, Storytelling, Schnitt oder Analyse. Ein Kanal, der aus automatisch generierten Skripten, generischen Sprachaufnahmen, wiederverwendetem Filmmaterial und minimalem Schnitt zusammengesetzt ist, kann als minderwertig gelten, selbst wenn die Stimme makellos klingt. Die Stimme sollte dein Konzept verstärken, nicht ersetzen, dass du überhaupt eines hast.
Schütze zuletzt die Audio- und faktische Qualität. Eine KI-Stimme wird einen Begriff selbstbewusst falsch aussprechen oder ein ungenaues Skript vorlesen, ohne mit der Wimper zu zucken – überprüfe daher jede finale Datei auf sachliche Fehler, fehlende Wörter, falsche Betonung, unbeholfene Pausen, Übersteuerung, Timing-Drift und Übersetzungsfehler in vertonten Versionen.
Für eine direkte Gegenüberstellung, wo jede Methode hinpasst, ordnet dieses Framework Prioritäten einem Ausgangspunkt zu.
| Deine Priorität | Beste Ausgangsoption |
|---|---|
| Schnelle Sprachaufnahme für einen neuen Kanal | Standard-KI-Stimme |
| Konsistente Creator-Identität | Dein eigener Stimmklon |
| Mehrere Sprachversionen | AI Dubbing oder mehrsprachiges TTS |
| Maximale menschliche Nuance | Menschlicher Sprecher |
| Häufige Skriptänderungen | KI-Stimme oder genehmigter Stimmklon |
| Technische Tutorials | Klare Stimme mit moderatem Tempo |
| Kurzform-Unterhaltung | Ausdrucksstarke Stimme, bei schnellerem Tempo getestet |
| Enterprise- oder Kundenarbeit | Stimme mit dokumentierten Rechten und Genehmigungsnachweisen |
Wenn dein eigentliches Ziel die Übersetzung eines bestehenden Videos ist und nicht das Verfassen eines neuen englischen Vortrags, beginne mit DubSmart AI Dubbing, statt Sprachaufnahmen von Grund auf zu generieren.
Häufig gestellte Fragen
Kann ich ein KI-Voiceover auf einem monetarisierten YouTube-Kanal verwenden?
Ja. Die KI-Nutzung allein verhindert keine Monetarisierung. Das Video muss weiterhin die Monetarisierungs-, Community-Richtlinien- und Originalitätsanforderungen von YouTube erfüllen.
Erfordert jedes KI-Voiceover eine KI-Offenlegung?
Nein. YouTube verlangt eine Offenlegung für realistische KI-generierte oder veränderte Inhalte, die Zuschauer in die Irre führen könnten, und führt das Klonen deiner eigenen Stimme für Voiceovers oder Vertonungen ausdrücklich als Beispiel auf, das keine Offenlegung erfordert.
Kann ich ein KI-Voiceover als MP3 auf YouTube hochladen?
Nein. YouTube benötigt einen Video-Upload, kombiniere das Voiceover also vor der Veröffentlichung mit Filmmaterial, einem Bild, einer Animation oder einer anderen visuellen Spur.
Wie lang muss eine Voice-Cloning-Probe in DubSmart sein?
Unser Voice-Cloning-Tool erstellt einen Klon aus einer Audiodatei von mindestens 20 Sekunden, und die Aufnahme sollte sauber und frei von Hintergrundgeräuschen sein.
Kann ich meine geklonte Stimme für mehrsprachige YouTube-Videos verwenden?
Ja. Eine geklonte Stimme funktioniert mit unserem Text to Speech und AI Dubbing in 33 Sprachen. Überprüfe jede übersetzte Version vor der Veröffentlichung auf Aussprache, Timing und kulturelle Passung.