Ein KI-Voiceover für Schulungsvideos entsteht, wenn Sie ein geschriebenes Skript mit einer KI-Stimmen-Engine kombinieren, optional die Stimme Ihres Trainers klonen und Erzählungen in einer oder mehreren Sprachen von einer einzigen Plattform aus generieren. Das ist die kurze Antwort auf die Frage, wie man ein KI-Voiceover für Schulungsvideos erstellt, und sie gilt, ob Sie einen zweiminütigen Onboarding-Clip produzieren oder eine komplette Compliance-Bibliothek lokalisieren. Die größere Frage ist, welcher Workflow zu Ihren Inhalten, Ihrem Publikum und der Häufigkeit passt, mit der Sie das Material aktualisieren möchten.
Mit DubSmart AI wählen Schulungsteams in der Regel einen von zwei Ausgangspunkten. Sie generieren entweder frische Erzählungen aus Text oder Sie laden vorhandene Videos hoch und lassen die Plattform sie durchgängig synchronisieren, indem sie Transkription, Übersetzung und Stimmengenerierung übernimmt. Beide Wege liegen innerhalb eines kreditbasierten Workflows, sodass Sie selten eine separate Transkriptions-App, einen Übersetzungsdienst oder ein Stimmen-Tool benötigen, um einen Kurs fertigzustellen.
Inhaltsverzeichnis
Welche Entscheidung treffen Sie eigentlich?
Die eigentliche Wahl besteht nicht nur darin, welchen Knopf man drückt. Es geht darum, welche Art von Voiceover-Workflow zu Ihren Schulungsinhalten und den Menschen passt, die sie ansehen. Mit DubSmart AI fällt diese Entscheidung meist in drei Kategorien, und jede davon prägt, wie konsistent sich Ihr Lernerlebnis anfühlt und wie schnell Sie Kurse später überarbeiten können.
- Verwenden Sie Standard-KI-Erzähler aus einer Bibliothek von über 300 natürlich klingenden Stimmen in mehr als 33 Sprachen, wenn Sie einfach schnelle, professionelle Schulungserzählungen benötigen.
- Klonen Sie eine bestimmte Trainer- oder Markenstimme, damit Lernende einen vertrauten Sprecher hören, selbst wenn Kurse in mehrere Sprachen lokalisiert werden.
- Automatisieren Sie die Voiceover-Produktion über unsere APIs, wenn Sie Kurstexte aus einem LMS oder einer App direkt in die Audiogenerierung im großen Maßstab einspeisen müssen.
Jeder Weg beeinflusst drei Dinge gleichzeitig: wie einheitlich das Lernerlebnis klingt, wie schnell Sie Updates ausrollen können und wie einfach Sie in mehrsprachige Schulungen expandieren, ohne alles neu aufnehmen zu müssen. Ein Team, das fünf ausgefeilte Kurse pro Jahr produziert, wird diese Faktoren anders gewichten als eines, das ein paar hundert rollenbasierte Module pflegt. Deshalb hilft es, Ihr Volumen und Ihren Update-Rhythmus zu benennen, bevor Sie ein Tool auswählen.
Wie DubSmart AI Voiceovers für Schulungsvideos erstellt
DubSmart ist eine All-in-One-Plattform für KI-Medienerstellung und -Lokalisierung, die Text to Speech, Voice Cloning, KI-Synchronisation, Speech to Text, Speech Separator, Text to Image und Image to Video in einem einzigen kreditbasierten Workflow zusammenführt. Für Schulungsteams ist genau diese Konsolidierung der entscheidende Punkt: Sie können vom Rohskript zu einem fertigen, lokalisierten Schulungsvideo gelangen, ohne unterwegs den Anbieter zu wechseln.
Text-to-Speech-Erzählung aus Ihrem Skript
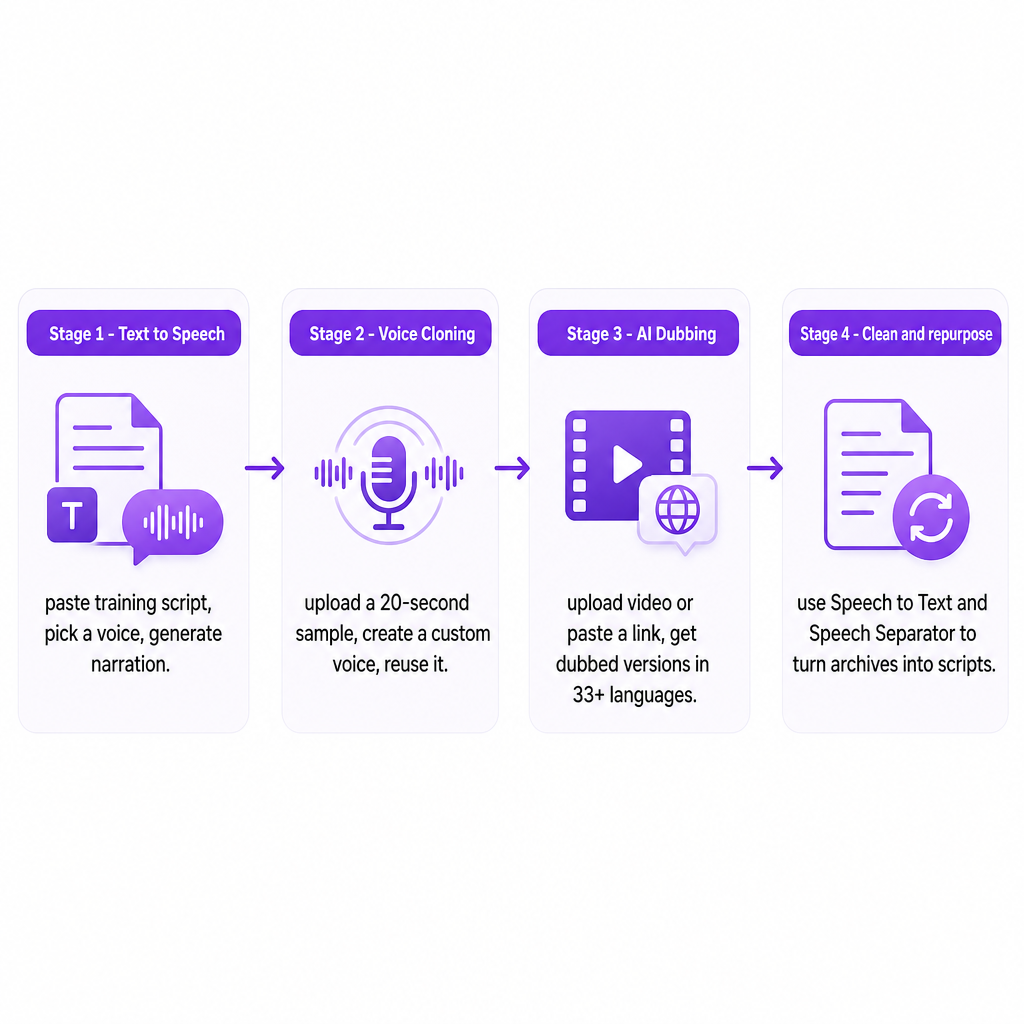
Bei den meisten Kursen ist der Ausgangspunkt ein Skript: Onboarding-Module, Sicherheitsverfahren, Compliance-Erklärungen oder Software-Anleitungen. Unser Text-to-Speech-Tool wandelt diesen Text in natürliche, menschenähnliche Sprache in jeder unterstützten Sprache um. Innerhalb der Web-App bleibt der Ablauf für nicht-technische Ersteller zugänglich. Sie öffnen das Tool, fügen Ihr Skript ein oder tippen es, wählen einen Sprecher aus der Stimmbibliothek und generieren das Audio. Sobald es richtig klingt, können Sie Sprecher hinzufügen oder ändern, einzelne Segmente überarbeiten und die fertige Datei im gewünschten Format herunterladen, um sie in Ihren Videoeditor einzufügen.
Teams mit einer Lernplattform oder einer eigenen App können dieselbe Funktion über unsere Text to Speech API nutzen. Sie senden eine Anfrage mit dem Kurstext und den Stimmpräferenzen, und die API gibt hochwertiges Audio zurück, das Sie programmatisch an Lektionen oder dynamisch generierte Inhalte anhängen können.
Klonen der Stimme Ihres Trainers oder Ihrer Marke
Wenn Sie möchten, dass Schulungen wie eine bestimmte Person klingen, erstellt Voice Cloning ein synthetisches Modell dieser Stimme, sodass neue Sprache aus Text im selben Tonfall generiert werden kann. Dies unterscheidet sich von generischem Text-to-Speech, bei dem Sie aus vorgefertigten Erzählern auswählen, anstatt Ihren eigenen Sprecher bereitzustellen. Im ersteller-freundlichen Weg sammeln Sie eine kurze, saubere Probe, typischerweise mindestens 20 Sekunden, und laden sie in den Voice-Clone-Bereich hoch. Das System verwandelt sie in eine benannte benutzerdefinierte Stimme, die dann sowohl in Text-to-Speech- als auch in KI-Synchronisationsprojekten erscheint. Von dort aus fügen Sie Skripte ein und lassen sie in der geklonten Stimme vorlesen – für Intros, detaillierte Erklärungen oder Compliance-Segmente – ohne den Trainer für jedes Update zurückzuholen. Wenn Sie die zugrunde liegende Funktionsweise verstehen möchten, erklärt unser Beitrag darüber, wie KI jede Stimme nachbildet, das Modell in einfachen Worten.
Entwickler und Agenturen können dies über die Voice Cloning API als dreistufiges Muster formalisieren. Erstens fordern Sie eine vorsignierte URL an und laden eine Audiodatei in einem unterstützten Format wie MP3, WAV, AAC, M4A oder FLAC hoch. Zweitens erstellen Sie eine benutzerdefinierte Stimme, indem Sie einen Namen und den Dateischlüssel aus diesem Upload senden. Drittens verweisen Sie auf die geklonte Stimmen-ID innerhalb von Text-to-Speech- oder KI-Synchronisationsprojekten, sodass jeder Schulungstext oder jedes Video automatisch diese Stimme verwendet.
Mehrsprachige Synchronisation für globale Zielgruppen
Wenn Sie bereits aufgezeichnete Anleitungen, von Trainern geleitete Sitzungen oder Live-Präsentationen haben, ist es oft besser, diese direkt zu synchronisieren, als von Grund auf neu aufzubauen. Unsere KI-Synchronisations-API und das Web-Tool sind für Speech-to-Speech-Workflows konzipiert: Sie laden ein Quellvideo oder eine Audiodatei hoch oder fügen einen Link ein und erhalten synchronisierte Versionen in Ihren Zielsprachen, während die Plattform Transkription, Übersetzung und Stimmengenerierung übernimmt. Sie können Sprecher hinzufügen, Timings anpassen und die generierten Textsegmente bearbeiten, damit Terminologie und Tempo Ihren Schulungsstandards entsprechen, bevor Sie herunterladen. Da die Synchronisation in mehr als 33 Sprachen funktioniert und Voice Cloning integriert, können Sie dieselbe Trainerstimme für jede Region beibehalten oder Erzähler wechseln, wo es sinnvoll ist – alles von einem Konto aus. Für große Kataloge spiegelt die API diesen Ablauf programmatisch wider und liefert synchronisierte Tonspuren, die Sie in eine bestehende Veröffentlichungs-Pipeline einfügen können.
Bereinigung und Wiederverwendung vorhandener Audiodaten
Viele Organisationen besitzen bereits Bibliotheken aufgezeichneter Webinare und Workshops, die zu strukturierten Modulen werden könnten. Da DubSmart neben Cloning und Synchronisation auch Speech to Text und einen Speech Separator umfasst, können diese Archive in wiederverwendbare Assets verwandelt werden. Speech to Text konvertiert gesprochene Inhalte in Transkripte, die Sie zu sauberen Skripten bearbeiten können, und ein Speech Separator hilft dabei, Stimmen aus gemischten Audiodaten zu isolieren, sodass Sie sauberere Proben für das Klonen oder eine bessere Eingabe für die Transkription erhalten. Diese Kombination reduziert Neuaufnahmen und ermöglicht es Ihnen, Altinhalte mit konsistenter Erzählung zu modernisieren.
Wichtige Entscheidungskriterien für Schulungs- und E-Learning-Teams
Sobald Sie die Mechanismen verstanden haben, kommt die Wahl auf eine Handvoll praktischer Faktoren an. Die folgende Tabelle ordnet gängige Prioritäten dem Weg zu, der in der Regel passt, und die Anmerkungen danach fügen die Nuancen hinzu, die eine Tabelle nicht erfassen kann.
| Priorität | Am besten geeigneter Weg | Warum es passt |
|---|---|---|
| Wiedererkennbare Trainerstimme | Voice Cloning | Eine geklonte Stimme über TTS-, Synchronisations- und API-Workflows wiederverwenden |
| Geschwindigkeit vor Identität | Vorgefertigte TTS-Stimmen | Über 300 Stile ohne Einrichtung bereit |
| Große oder häufig aktualisierte Kataloge | TTS- oder Synchronisations-APIs | Generierung in Veröffentlichungs-Flows automatisieren |
| Globale Belegschaft | KI-Synchronisation + Cloning | In über 33 Sprachen synchronisieren, Originalgefühl bewahren |
| Technische oder regulierte Inhalte | Bearbeitbare Synchronisationsprojekte | Terminologie vor der Fertigstellung überprüfen |
Die Konsistenz des Lernerlebnisses ist oft der entscheidende Faktor. Wenn Ihre Strategie auf einem wiedererkennbaren Trainer oder einer Unternehmensstimme beruht, bewahrt das Klonen diese Identität über Module und Sprachen hinweg, und dieselbe geklonte Stimme kann in Kursen erscheinen, die Monate auseinander erstellt wurden. Wenn Geschwindigkeit wichtiger ist als eine einzelne Identität, können Sie mit den über 300 vorgefertigten Stimmen den Tonfall an den Inhaltstyp anpassen, zum Beispiel eine ruhigere Stimme für Compliance und eine leichtere für Onboarding.
Volumen und Aktualisierungshäufigkeit verschieben die Rechnung in Richtung Automatisierung. Ein Team, das eine Handvoll Kurse produziert, kann bequem in der Web-App arbeiten und bei Bedarf Voiceovers und Synchronisationen generieren. Organisationen, die große Kataloge oder rollenbasierte Variationen pflegen, profitieren von den APIs, die Text oder Video automatisch in Audio umwandeln, innerhalb geplanter Veröffentlichungs-Workflows. Wenn Sie häufige Richtlinienänderungen oder Software-Updates erwarten, ermöglichen textbasiertes TTS und Synchronisation eine schnelle Neuerstellung von Erzählungen, ohne Studiozeit buchen zu müssen.
Die Sprachabdeckung ist am wichtigsten für in den USA ansässige Unternehmen, die globale Teams schulen. DubSmart unterstützt die Synchronisation aus mehr als 60 Quellsprachen in mindestens 33 Zielsprachen, gepaart mit Cloning und TTS, sodass jede Region Inhalte in ihrer Hauptsprache erhalten kann, während das Erscheinungsbild und die Anmutung des Originals erhalten bleiben. Für leichtere Anforderungen, wie US-Englisch mit gelegentlichen spanischen Modulen, reichen vorgefertigte TTS-Stimmen möglicherweise aus und reduzieren den Einrichtungsaufwand.
Technische und regulatorische Inhalte verdienen besondere Sorgfalt. Fachjargon, Produktnamen und juristische Formulierungen müssen korrekt ausgesprochen und übersetzt werden, sodass die Möglichkeit, Transkripte und generierte Segmente in Synchronisationsprojekten zu überprüfen und zu bearbeiten, Fachexperten echte Kontrolle gibt. Bei der Verwendung von APIs können Sie bevorzugte Terminologie in Ihre Skripte oder Vorverarbeitungslogik einbetten, sodass das, was TTS oder Synchronisation erhält, bereits geprüft ist.
Daten, Einwilligung und Governance schließen die Liste ab. Das Klonen erfordert Sprachproben des Zielsprechers, also sichern Sie die Einwilligung und dokumentieren Sie, wie die geklonte Stimme verwendet wird. Da unser Klonprozess kurze, saubere Aufnahmen akzeptiert, sammeln Sie weniger Daten und erstellen dennoch ein nutzbares Modell. Die Zentralisierung von Cloning, TTS und Synchronisation in einer Plattform vereinfacht auch Prüfpfade im Vergleich zum Jonglieren mit separaten Tools, und ein kreditbasiertes Modell mit APIs ermöglicht es Schulungsverantwortlichen, die Nutzung über eine einzige Kontostruktur zu steuern.
Risiken und Schutzmaßnahmen beim Einsatz von KI-Voiceovers in Schulungen
KI-Erzählung ist schnell, aber ein paar Fehlermodi verdienen Aufmerksamkeit, bevor Sie skalieren.
Die Fehlausrichtung mit Marken- oder Lehrstil ist am häufigsten. KI-Stimmen, einschließlich geklonter, können in unterschiedlichen Geschwindigkeiten und Intensitäten generiert werden, die möglicherweise nicht zu Ihrem Hausstil passen. Hören Sie sich Beispielausgaben an, passen Sie Vortragsparameter an, wo verfügbar, und standardisieren Sie Stimmenauswahlen pro Kurstyp, bevor Sie breit ausrollen.
Aussprache- und Übersetzungsnuancen kommen als Nächstes. Automatisierte Erzählung kann über Namen oder Fachbegriffe stolpern, und maschinelle Übersetzung kann Formulierungen erzeugen, die zwar korrekt, aber pädagogisch ungeschickt sind. Die Möglichkeit, Textsegmente in Synchronisationsprojekten zu bearbeiten und Audio neu zu generieren, hilft, ersetzt aber nicht die menschliche Überprüfung für kritische Compliance- oder Sicherheitsmodule.
Übermäßiges Vertrauen auf Automatisierung ist ein subtileres Risiko. Bei sensiblen Themen wie Verhalten am Arbeitsplatz, psychischer Gesundheit oder rechtlichen Verpflichtungen können sich Tonfehler einschleichen, selbst wenn die Fakten stimmen. Die Kombination von KI-Voiceovers mit menschlicher Überprüfung und gelegentlich einem von Menschen aufgenommenen Segment für die wichtigsten Botschaften findet tendenziell eine bessere Balance.
Der verantwortungsvolle Umgang mit geklonten Stimmen rundet dies ab. Eine geklonte Stimme ist ein wiederverwendbares Asset, was Fragen zu Umfang und Lebenszyklus aufwirft. Legen Sie interne Richtlinien dafür fest, wer die Generierung mit einer bestimmten Stimme auslösen kann, wie lange Proben aufbewahrt werden und wie der Zugriff widerrufen wird, wenn ein Trainer ausscheidet. Diese Leitplanken halten die Technologie ethisch und vorhersehbar.
Wenn Sie abwägen, wo KI-Erzählung passt und wo ein Mensch im Spiel bleiben sollte, beginnen Sie damit, Ihr Kursvolumen, Ihre Sprachen und die Häufigkeit von Inhaltsänderungen zu benennen. Teilen Sie uns diese Details mit, und wir können Ihnen helfen, die richtige Mischung aus Text to Speech, Voice Cloning und Synchronisation für Ihr Programm zu finden.
Häufig gestellte Fragen
Kann ich die Stimme meines Trainers beibehalten und Kurse trotzdem in mehrere Sprachen lokalisieren?
Ja. Sie können die Stimme Ihres Trainers klonen und diese geklonte Stimme dann sowohl in Text-to-Speech- als auch in KI-Synchronisationsprojekten verwenden, einschließlich synchronisierter Versionen in anderen Sprachen.
Wie viel Audio benötige ich, um eine Stimme für Schulungserzählungen zu klonen?
Das Klonen funktioniert mit kurzen, sauberen Proben, typischerweise mindestens 20 Sekunden Sprache. Viele Ersteller verwenden 20 bis 60 Sekunden für ein robusteres Modell.
Welche Audioformate kann ich beim Hochladen von Proben für das Voice Cloning verwenden?
Die Voice Cloning API akzeptiert gängige Formate wie MP3, WAV, AAC, M4A und FLAC, die über eine vorsignierte URL hochgeladen werden, bevor die Probe zu einer benutzerdefinierten KI-Stimme wird.
Können Entwickler Voiceovers aus LMS- oder App-Inhalten automatisieren?
Ja. Die Text to Speech API und die KI-Synchronisations-API ermöglichen es Backend-Systemen, Schulungstext oder -video zu senden und gebrauchsfertiges Audio oder synchronisierte Tonspuren für automatisierte Veröffentlichungs-Flows zu erhalten.
Ist DubSmart für Compliance- und Regulierungsschulungen geeignet?
Unsere Kombination aus TTS, Voice Cloning, KI-Synchronisation und Bearbeitungskontrollen unterstützt strukturierte, wiederholbare Workflows, aber Teams sollten dennoch menschliche Überprüfung und Governance für sensible oder regulierte Themen anwenden.