Der schnellste Weg, eine Text-to-Speech-API zu integrieren, besteht darin, sie als REST-Dienst zu behandeln: Sie authentifizieren sich mit einem API-Schlüssel, senden Ihren Text zusammen mit den Stimmeinstellungen als JSON, lassen den Dienst die Sprache im Hintergrund rendern und rufen anschließend die resultierenden Audiodateien ab und speichern sie für die Wiedergabe überall dort, wo Ihre Nutzer sie benötigen. Unsere Text-to-Speech-API folgt genau diesem Muster und bietet dabei über 300 natürliche Stimmen sowie unbegrenztes Voice Cloning, sodass Sie lebensechte Sprache in Websites, Apps, Video-Pipelines und Lernplattformen einbinden können. Dieser Leitfaden erklärt, was Sie tatsächlich anbinden, wie unsere Engine funktioniert und welche Entscheidungen darüber bestimmen, ob die Integration zu Ihrem Produkt passt.
Inhaltsverzeichnis
Was eine Text-to-Speech-API in DubSmart leistet
Eine Text-to-Speech-API wandelt strukturierten Text bei Bedarf in gesprochene Audioinhalte um, sodass Ihr Code Erzählung oder Dialog genau in dem Moment anfordern kann, in dem ein Skript fertig ist, statt auf manuelle Aufnahmen zu warten. Unsere Text-to-Speech-Engine treibt sowohl das browserbasierte Text-to-Speech-Tool als auch die API an und bietet Zugriff auf mehr als 300 KI-Stimmen über Sprachen, Geschlechter und Stile hinweg, mit einer für Erzählung, Erklärvideos und Dialoge abgestimmten Prosodie.
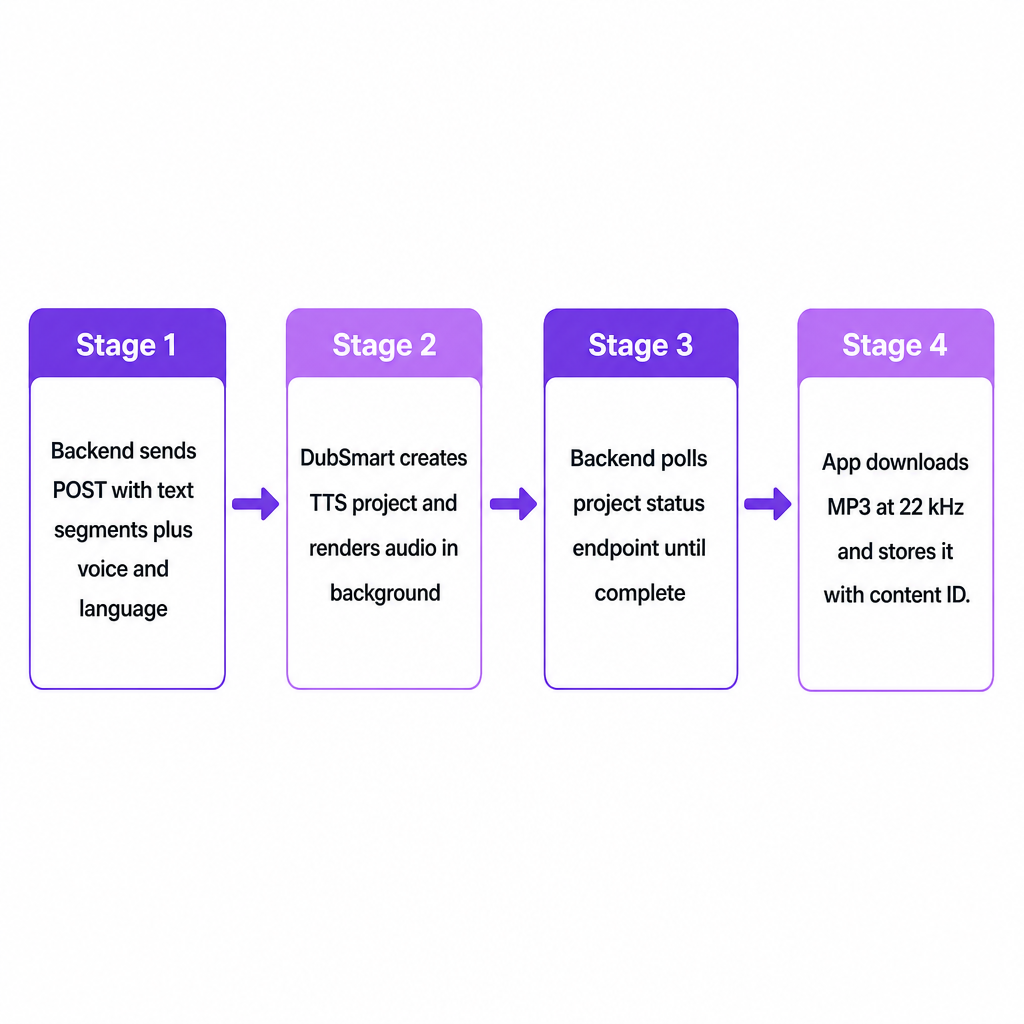
Auf der API-Ebene stellen wir diese Engine als RESTful-Dienst bereit: Ihr Backend sendet eine POST-Anfrage mit Textsegmenten und Stimmparametern, und der Dienst gibt ein Projektobjekt zurück, dessen Status Sie abfragen können, bis das Audio zum Download bereitsteht. Die Ausgabe wird als hochwertige Audiodateien geliefert, in der Regel als MP3 mit 22 kHz, die sich ohne zusätzliche Konvertierung direkt in Videoeditoren, Podcast-Workflows oder Webplayern verwenden lassen.
Für die Kreativen und Teams, die wir betreuen – YouTuber, kleine Unternehmen, E-Learning-Produzenten, Filmemacher und Entwickleragenturen – verbindet die API Content-Planung und Veröffentlichung. Sobald ein Skript in ein CMS oder eine Lernplattform gelangt, kann das Backend automatisch Voiceovers generieren, was den Engpass wiederholter manueller Aufnahmen beseitigt.
Die Integrationsentscheidung: Was binden Sie eigentlich an?
„Eine Text-to-Speech-API integrieren“ klingt allgemein, aber in der Praxis entscheiden Sie über drei Dinge: an welcher Stelle Ihres Workflows Sprache generiert werden soll, welche Stimmen und Sprachen Ihre Marke repräsentieren und wie stark Sie die Generierung und den Abruf von Audio automatisieren.
Für einen YouTube-Creator, der in mehrsprachige Inhalte expandiert, bedeutet Integration oft, unsere API mit einem Video-Planungstool oder einer Skriptdatenbank zu verbinden, sodass jedes fertiggestellte Skript in der richtigen Sprache und im richtigen Stil zu einem Voiceover wird. Für kleine Unternehmen und Marketingteams sitzt die API typischerweise hinter einem CMS oder einer Marketing-Automatisierungsplattform und verwandelt Blogbeiträge, Produkterklärungen und Social-Media-Texte in wiederverwendbare Audio-Assets. E-Learning- und Unternehmensschulungsanbieter binden die API in der Regel in Autorentools ein, sodass Lektionsmodule pro Folie oder pro Thema Erzählung anfordern und diese sofort neu generieren können, wenn sich Material aktualisiert.
Entwickler und Agenturen, die Sprach-KI tiefer integrieren, wählen üblicherweise zwischen zwei Mustern. Ein Batch-Modell sammelt Skripte und verarbeitet sie über geplante Jobs. Ein transaktionales Modell löst jedes Mal eine sofortige Anfrage aus, wenn neuer Inhalt oder eine Nutzeraktion eintrifft. Unsere projektbasierte API funktioniert sauber für beide, da jedes TTS-Projekt Text, Stimmauswahl, Sprache und das resultierende Audio so kapselt, dass es sich auf Ihre eigenen Content-Einheiten abbilden lässt – Videos, Lektionen oder Podcast-Episoden. Wenn Sie das Konzept selbst noch abwägen, behandelt unser begleitender Erklärartikel darüber, was eine Text-to-Speech-API ist und wie sie funktioniert, die Grundlagen, bevor Sie sich auf ein Design festlegen.
Wie unsere Text-to-Speech-API im Detail funktioniert
Unsere Text-to-Speech-API ist um Projekte und Segmente herum aufgebaut, was sie flexibler macht als einen einzelnen „Text rein, Audio raus“-Endpunkt. Ein TTS-Projekt gruppiert ein oder mehrere Textsegmente unter einem Titel und einer gemeinsamen Konfiguration wie Sprache und Standardstimme. Jedes Segment trägt seinen eigenen Text, seine eigene Stimmkennung und seinen eigenen Sprach-Tag, wodurch Sie innerhalb einer einzigen Ausgabe Erzählstile oder Sprachen mischen können.
Eine typische JSON-Nutzlast an den TTS-Projektendpunkt enthält einen menschenlesbaren Projekttitel für Ihre Dashboards und Logs sowie ein Array von Segmenten. Jedes Segment legt text (das zu sprechende Skript oder den Satz), voice (entweder eine integrierte Stimm-ID oder eine über die Voice-Cloning-API erstellte benutzerdefinierte Stimm-ID) und language (ein Code, der die Sprache des Segments angibt) fest.
Wenn Ihr Backend diese Nutzlast mit einem gültigen API-Schlüssel im Authorization-Header an den TTS-Endpunkt sendet, erstellen wir das Projekt und beginnen im Hintergrund mit dem Rendern des Audios. Die API stellt einen Projektstatus-Endpunkt bereit, der meldet, ob die Verarbeitung noch läuft oder abgeschlossen ist, zusammen mit Verweisen auf die generierten Audiodateien, sobald diese bereit sind. Dieses asynchrone Design hält Ihre eigenen Anfragen schnell: Protokollieren Sie die Projekt-ID, geben Sie dem Nutzer die Kontrolle zurück und lassen Sie einen Hintergrundprozess auf die Fertigstellung prüfen und das Audio herunterladen, sobald es verfügbar ist.
Generierte Sprache kommt als herunterladbare Dateien in Standardformaten an, insbesondere als MP3 mit 22 kHz, das sich leicht in Webplayer, mobile Apps und Videoschnitt-Timelines einfügt. Da dieselbe Engine unser browserbasiertes Tool antreibt, können Entwickler Stimmen und Skripte interaktiv prototypisieren und dann die erfolgreichsten Kombinationen in automatisierte API-Aufrufe übertragen. Die vollständige Endpunkt-Referenz finden Sie auf der Seite Text-to-Speech-API.
Voice Cloning und KI-Synchronisation mit Text-to-Speech verbinden
Unser prägendes Merkmal ist, dass Text-to-Speech, Voice Cloning und KI-Synchronisation eine einzige zugrunde liegende Stimm-Engine und einen einzigen Workflow teilen. Das bedeutet, dass die TTS-API nicht isoliert ist – sie ist der Kern einer umfassenderen Lokalisierungs-Pipeline.
Mit der Voice-Cloning-API können Sie Audioproben eines Sprechers hochladen, eine benutzerdefinierte KI-Stimme erstellen und diese Stimme in TTS-Projekten referenzieren. Sobald eine benutzerdefinierte Stimme existiert, wird ihre Kennung zum voice-Feld in Ihren Text-to-Speech-Segmenten, sodass die Erzählung in der geklonten Stimme statt in einer generischen Standardstimme abgespielt wird. Diese Kontinuität ist wichtig für Moderatoren, Podcaster und Markensprecher, die eine konsistente akustische Identität über Sprachen und Formate hinweg wünschen. Wenn Sie planen, Cloning hinzuzufügen, behandelt unser Leitfaden zur Integration einer Voice-Cloning-API in Ihre App die Einzelheiten.
Die KI-Synchronisations-API erweitert dies noch weiter, indem sie Transkription, Übersetzung und Text-to-Speech in einer einzigen Pipeline kombiniert, die Videos in mehr als 33 Zielsprachen synchronisiert. Hier wandelt die TTS-Engine übersetzte Skripte mit derselben Bibliothek von über 300 Stimmen oder Ihrer geklonten Stimme in Sprache um, sodass synchronisierte Versionen Ton und Timing bewahren. Für mehrsprachige Kreative und Unternehmen wird die Text-to-Speech-API zum Baustein sowohl für einsprachige Voiceovers als auch für vollständig lokalisierte synchronisierte Inhalte. Unser Überblick darüber, wie KI-Lokalisierung funktioniert, zeigt, wie diese Teile durchgängig zusammenpassen.
Wichtige Entscheidungskriterien bei der Integration unserer TTS-API
„Irgendeine“ TTS-API zu integrieren, reicht nicht aus; die Entscheidungen rund um die Implementierung bestimmen, wie gut sie zu Ihrer Produktion, Ihrer Marke und Ihrem technischen Stack passt.
Skalierungs- und Automatisierungsbedarf. Wenn das Inhaltsvolumen gering und sporadisch ist, kann das browserbasierte Tool ausreichen. Sobald Skripte regelmäßig generiert oder an Content-Kalender, Learning-Management-Systeme oder Marketing-Automatisierung gekoppelt werden, wird die API zur richtigen Ebene, da sie programmatisch ausgelöst und mit Ihrem Backend skaliert werden kann.
Stimm- und Sprachstrategie. Unsere Plattform unterstützt die Synchronisation aus über 60 Ausgangssprachen in 33 Zielsprachen, angetrieben von derselben Stimm-Engine, die die TTS-API nutzt. Wenn Ihre Marke eine unverwechselbare Sprecherstimme benötigt, hält die Kombination der Voice-Cloning-API mit TTS diese Stimme über Sprachen und Kanäle hinweg konsistent. Wenn Sie Geschwindigkeit über Personalisierung stellen, halten integrierte Stimmen die Implementierung einfacher.
Integrationspunkt in Ihrem Stack. Für YouTube-Kanäle ist ein natürlicher Ort die Video-Pipeline: Skripte, die in einem Planungstool gespeichert, bei Fertigstellung an die TTS-API übergeben und als für Editoren bereites Audio zurückgegeben werden. E-Learning-Plattformen können auf Lektions- oder Folienebene integrieren, wo jeder Inhaltsblock einem Segment entspricht und Projekte ganze Kurse repräsentieren. Marketingteams integrieren oft auf CMS-Ebene, sodass jeder Artikel oder jede Produktseite eine Audioversion für Barrierefreiheit anfordern kann.
Governance, Compliance und Risiko. Da Voice Cloning erkennbare Stimmen replizieren kann, sind Einwilligung, Lizenzierung und Nutzungsrichtlinien von Bedeutung. Geklonte Stimmen werden durch IDs identifiziert und können mit Metadaten getaggt werden, was die Durchsetzung interner Regeln darüber erleichtert, wo bestimmte Stimmen verwendet werden dürfen. Entscheiden Sie im Vorfeld, welche Umgebungen geklonte Stimmen im Vergleich zu generischen Stimmen auslösen dürfen, und fügen Sie in Ihren eigenen Systemen Protokollierung hinzu.
Erwartungen an Latenz und Nutzererfahrung. Asynchrone Verarbeitung bietet Flexibilität, fügt aber einen zeitlichen Aspekt hinzu. Für Workflows, in denen Nutzer eine sofortige Wiedergabe erwarten – etwa ein Skripteditor mit Sofortvorschau – erstellen Sie kleinere Projekte oder Segmente und zeigen Sie Fortschrittsanzeigen an, während das Audio gerendert wird. Für Batch-Lokalisierung über ganze Bibliotheken hinweg spielt die Latenz eine geringere Rolle, und Jobs können nach Zeitplan laufen, wobei das fertiggestellte Audio anschließend an Content-Datensätze angehängt wird.
| Entscheidungsbereich | Batch-Modell | Transaktionales Modell |
|---|---|---|
| Auslöser | Geplante Jobs | Pro Content-Element oder Nutzeraktion |
| Latenztoleranz | Hoch | Niedrig |
| Beste Eignung | Kurskataloge, Videobibliotheken | Skripteditoren, Live-Vorschauen |
| Stimmstrategie | Freigegebene Stimme pro Sprache | Freigegebene Stimme pro Sprache |
Risiken und praktische Schutzmaßnahmen
Die Integration einer Text-to-Speech-API bringt einige vorhersehbare Risiken mit sich, die durchdachtes Design mindern kann.
Stimmen ohne Tests auszuwählen, kann Sprache erzeugen, die für eine Marke oder einen Moderator untypisch wirkt. Testen Sie Stimmen zuerst in der interaktiven Oberfläche und pflegen Sie einen Katalog freigegebener Stimmen innerhalb Ihrer eigenen Systeme, organisiert nach Sprache und Content-Typ, bevor Sie Stimm-IDs in API-Aufrufen festlegen.
Übermäßige Automatisierung sensibler Inhalte ist eine weitere Falle. Sprache automatisch für Compliance-, medizinisches oder juristisches Material zu generieren, ist möglicherweise nicht angebracht. Da unsere API mit einzelnen Projekten und Segmenten arbeitet, können Sie Routing-Regeln aufrechterhalten, die nur freigegebene Kategorien an TTS senden, während sensible Inhalte in Workflows mit menschlichen Aufnahmen verbleiben.
Betriebsfehler – fehlgeschlagene Projekte oder fehlende Downloads – treten auf, wenn Netzwerkprobleme oder ungültige Nutzlasten die Verarbeitung unterbrechen. Die Projektstatus-Endpunkte und strukturierten Antworten ermöglichen es Ihnen, zu bestätigen, dass ein Projekt abgeschlossen ist und seine Ausgaben verfügbar sind, bevor Sie veröffentlichen. Verknüpfen Sie jede TTS-Projekt-ID mit Ihrer eigenen Content-ID und implementieren Sie Wiederholungen oder Fallbacks, wenn Statusprüfungen Fehler melden.
Der Missbrauch geklonter Stimmen verdient explizite Kontrollen. Benutzerdefinierte Stimmen müssen über spezielle Endpunkte erstellt und dann per ID in TTS-Projekten referenziert werden, was Ihnen eine klare technische Grenze zum Überwachen gibt. Beschränken Sie, wer geklonte Stimm-IDs erstellen oder zuweisen darf, und protokollieren Sie, wo sie verwendet werden.
Ein praktischer Einstiegsweg besteht darin, TTS zunächst für Standard-Voiceovers zu integrieren, Stimmen und Fehlerbehandlung in der Produktion zu validieren und dann Voice Cloning und KI-Synchronisation hinzuzufügen, sobald die Kernintegration stabil ist. Teilen Sie uns Ihr Inhaltsvolumen, Ihre Zielsprachen und mit, wo die API in Ihrem Stack sitzen soll, und wir können Ihnen die richtigen Endpunkte und einen Plan für Ihren Workflow empfehlen.
Häufig gestellte Fragen
Wie unterscheidet sich die Text-to-Speech-API vom Browser-Tool?
Das Browser-Tool ist eine visuelle Oberfläche, in die Sie Text einfügen, eine Stimme auswählen und Audio manuell herunterladen. Die API stellt dieselbe Engine über REST-Endpunkte bereit, sodass Ihr Backend als Reaktion auf Skripte, Zeitpläne oder Nutzeraktionen automatisch Audio generieren und abrufen kann.
Kann die API in meiner eigenen Stimme sprechen, nicht nur mit Standardstimmen?
Ja. Durch die Integration der Voice-Cloning-API laden Sie Audioproben eines Sprechers hoch, erstellen eine benutzerdefinierte KI-Stimme und referenzieren dann die ID dieser Stimme in Ihren Text-to-Speech-Segmenten, sodass alle generierte Sprache in der geklonten Stimme abgespielt wird.
Wie hilft dies bei mehrsprachigen YouTube-Kanälen oder Podcasts?
Unsere Plattform wandelt Sprache oder Skripte aus über 60 Ausgangssprachen in synchronisierte Ausgaben über 33 Zielsprachen um, wobei TTS das finale Audio mit über 300 Stimmen oder Ihrer geklonten Stimme generiert. Die Einbindung der TTS- und KI-Synchronisations-APIs in Ihre Veröffentlichungs-Pipeline ermöglicht es, dass neue Videos oder Episoden Voiceovers oder vollständige Synchronisationen erhalten, sobald Skripte oder Ausgangsaudio bereit sind.
Welche Audioformate erhält meine App oder mein Editor?
Die TTS-API liefert hochwertige Audiodateien, einschließlich MP3 mit 22 kHz, die für die meisten Web-, Mobil- und Videoschnittumgebungen ohne zusätzliche Konvertierung geeignet sind.
Kann ich Text-to-Speech jetzt integrieren und KI-Synchronisation später hinzufügen?
Ja. Text-to-Speech, Voice Cloning und KI-Synchronisation teilen ein gemeinsames API-Ökosystem, sodass Sie mit TTS für Voiceovers beginnen und später Voice Cloning und KI-Synchronisation hinzufügen können, um mehrsprachige Synchronisation zu automatisieren, ohne Ihre Kernintegration neu aufbauen zu müssen.