Wenn Sie fragen, wie KI-Voiceovers erstellt werden, fragen Sie eigentlich, wie aus einem geschriebenen Skript Sprache wird, ohne dass jemand ins Tonstudio muss. Die kurze Antwort: Ein neuronales Text-to-Speech-Modell wandelt Ihr Skript in synthetisches Audio um, eine optionale geklonte Stimme lässt dieses Audio wie eine bestimmte Person klingen, und eine Dubbing-Ebene stimmt alles über verschiedene Sprachen hinweg mit Ihrem Video ab. Bei DubSmart AI läuft diese gesamte Kette innerhalb eines Arbeitsbereichs ab, sodass Sie von einem Textabsatz zu einem fertigen, mehrsprachigen Voiceover gelangen, ohne die Tools zu wechseln oder Studiozeit zu buchen.
Wie dieser Prozess für Sie aussieht, hängt von einer Entscheidung ab, und der Rest dieses Leitfadens führt durch die Mechanismen, die Optionen und die Wahl.
Inhaltsverzeichnis
Die Entscheidung hinter der Erstellung von KI-Voiceovers
Bevor Audio generiert wird, treffen Sie zwei Entscheidungen, die alles Nachfolgende prägen. Die erste ist, ob Sie eine vorgefertigte Stimme aus einer Bibliothek oder einen Klon Ihrer eigenen Stimme möchten. Die zweite ist, ob Sie ein Voiceover in einer einzigen Sprache oder eine vollständig lokalisierte Version in vielen Sprachen benötigen.
Für einen YouTube-Creator oder ein kleines Unternehmen entscheidet sich das meist schnell: Wählen Sie eine Standardstimme für Schnelligkeit, klonen Sie eine Stimme, wenn Markenkonsistenz wichtig ist, und greifen Sie nur dann zum Dubbing, wenn Sie mehrsprachig gehen. Für Entwickler und Agenturen wird dieselbe Weggabelung zu einer Architekturfrage – rufen Sie einen Text-to-Speech-Endpunkt für einmaliges Audio auf, oder verdrahten Sie Voice Cloning und Dubbing zu einer Pipeline, die eigenständig läuft?
Wir haben DubSmart genau um diese Weggabelungen herum entwickelt. Text to Speech, Voice Cloning, Speech to Text, Speech Separator, Text to Image, Image to Video und AI Dubbing befinden sich alle auf einer Plattform, sodass Sie den Grad der Automatisierung und Personalisierung nach oben oder unten regulieren können, ohne separate Anbieter zusammenzufügen.
Die Mechanismen: Wie KI-Voiceovers tatsächlich erstellt werden
Text to Speech: Vom Skript zum Klang
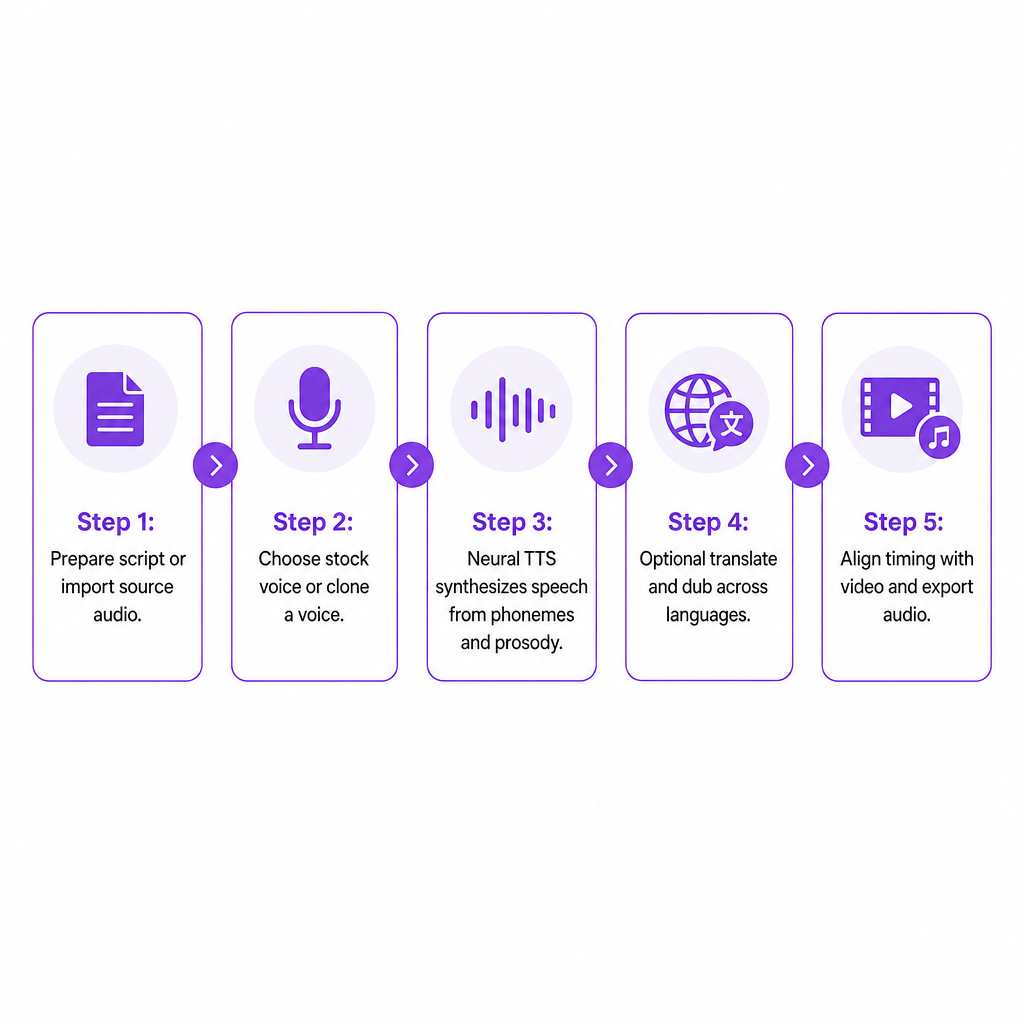
Text-to-Speech (TTS) steht im Zentrum jedes KI-Voiceovers. Die Engine analysiert zunächst Ihr Skript – zerlegt Text in Phoneme, liest Interpunktion und Struktur und leitet die Prosodie ab, also den Rhythmus, die Betonung und die Intonation, die Sprache davor bewahren, flach zu klingen. Neuronale Modelle synthetisieren diese Phoneme dann in Audio und wenden die Prosodiemuster an, die die Wiedergabe flüssig statt roboterhaft klingen lassen.
Unsere Text to Speech-Engine ermöglicht es Ihnen, Text in einer beliebigen Sprache einzufügen, eine Stimme aus einer Bibliothek von mehr als 300 auszuwählen und in Sekunden realistische Sprache zu generieren. Die Stimmen klingen natürlich und menschlich und sind nach Sprache, Geschlecht und Stil kategorisiert, sodass Sie den Ton dessen, was Sie produzieren, treffen können. Für Entwickler wird dieselbe Engine über eine RESTful Text to Speech API bereitgestellt: Senden Sie eine POST-Anfrage mit Ihrem Text und Ihren Stimmparametern und erhalten Sie gebrauchsfertige Audiodateien zurück. Strukturierter Text hinein, lebensechtes Audio heraus, ohne manuelle Aufnahme.
Stimmmodelle und Stimmbibliotheken
KI-Voiceovers beruhen auf trainierten Stimmmodellen – neuronalen Netzwerken, die lernen, wie eine bestimmte Stimme über verschiedene Wörter, Sprachen und Emotionen hinweg klingen sollte. Eine Stimmbibliothek ist einfach ein Katalog dieser Modelle. Wir pflegen eine Bibliothek von mehr als 300 natürlich klingenden Stimmen, die mehrere Geschlechter, Akzente und Sprechstile über viele Sprachen hinweg abdecken, und sie ist sowohl in der Web-App als auch über die API verfügbar, sodass interne Tools auf Abruf Sprache generieren können.
Voice Cloning: Die KI so klingen lassen wie Sie
Das Klonen ist der Mechanismus, der ein Voiceover wie eine bestimmte Person statt wie einen generischen Sprecher klingen lässt. Das System analysiert eine Beispielaufnahme, lernt die Klangfarbe, den Tonhöhenbereich und die Aussprachemuster des Sprechers und wendet diese Merkmale dann auf neue synthetische Sprache an.
In der Praxis laden Sie eine Audiodatei von mindestens 20 Sekunden zu Voice Cloning hoch – idealerweise sauber und frei von Hintergrundgeräuschen. Wir verarbeiten dieses Beispiel zu einem individuellen Stimmprofil, das Sie benennen und wiederverwenden können, wobei das Klonen in der Regel nur wenige Sekunden dauert. Nach der Erstellung wird die geklonte Stimme in Text to Speech und AI Dubbing verfügbar, sodass Sie Skripte oder synchronisierte Versionen in Ihrer eigenen Stimme generieren können. Programmatisch spiegelt die Voice Cloning API dies wider: Beziehen Sie eine Upload-URL, senden Sie Ihr Audio in einem unterstützten Format, erstellen Sie eine individuelle Stimme aus dem resultierenden Dateischlüssel und verwenden Sie sie dann in TTS- oder Dubbing-Projekten.
Dubbing und mehrsprachige Voiceovers
Der Übergang von einem einsprachigen Voiceover zu mehrsprachigem Content fügt Lokalisierung zusätzlich zum grundlegenden TTS hinzu. Das allgemeine Muster ist konsistent:
- Erfassen oder importieren Sie die Originalsprache.
- Transkribieren Sie sie in Text.
- Übersetzen Sie diesen Text.
- Generieren Sie neue Sprache in der Zielsprache.
- Stimmen Sie das Timing mit dem Originalvideo oder -audio ab.
Unser AI Dubbing-Workflow folgt genau diesem Muster und kombiniert Speech-to-Text, maschinelle Übersetzung und Text-to-Speech, wobei optional eine geklonte Stimme wiederverwendet wird, sodass die synchronisierte Tonspur zum Originalsprecher passt. Es verwandelt gesprochene Inhalte aus mehr als 60 Ausgangssprachen in synchronisierte Versionen über 33 Zielsprachen hinweg. Speech-to-Speech-Dubbing zielt darauf ab, Ton und Timing nah an der ursprünglichen Darbietung zu halten, was am wichtigsten für E-Learning, Schulungen und Filminhalte ist, bei denen Lippensynchronität und Tempo das Erlebnis tragen.
APIs und automatisierte Workflows
Für Teams, die Voiceovers im großen Maßstab produzieren, sind APIs das, was die Stimmerstellung in bestehende Systeme integriert. Die TTS API übernimmt Text-hinein, Audio-heraus; die Voice Cloning API ergänzt die programmatische Erstellung und Verwaltung individueller Stimmen; und die AI Dubbing API erweitert beide um automatische Übersetzung und Synchronisation über mehr als 33 Sprachen hinweg mit Zugriff auf geklonte Stimmen. Zusammen ermöglichen sie Ihnen den Aufbau von Pipelines, in denen Skripte, Untertitel oder Transkripte, die aus einem Content-System gezogen werden, automatisch zu Voiceovers oder synchronisierten Tonspuren werden, ohne manuelle Dateiverarbeitung.
Ihre drei Wege, KI-Voiceovers in DubSmart zu erstellen
Innerhalb unserer Plattform lässt sich die Frage auf drei praktische Ausgangspunkte reduzieren.
Starten Sie von einem Skript mit Text to Speech. Fügen Sie Ihren Text ein, wählen Sie eine Standard- oder geklonte Stimme, stellen Sie die Sprache und grundlegende Steuerelemente ein und generieren Sie Sprache, die Sie in Standardformaten herunterladen können. Das passt zu Schulungsvideos, Erklärinhalten, Marketing-Spots und Podcast-Intros, bei denen Ihnen das Skript von Anfang an gehört.
Starten Sie von bestehenden Medien mit AI Dubbing. Laden Sie eine Quellvideo- oder Audiodatei hoch, lassen Sie das System transkribieren und übersetzen und generieren Sie dann synchronisierte Tonspuren in Ihren gewählten Sprachen – unter Wiederverwendung geklonter Stimmen, um den Klang konsistent zu halten. Dies ist der Weg für Kanäle, die in mehrsprachige Zielgruppen expandieren, und für Unternehmen, die Webinare oder Produktdemos wiederverwenden.
Starten Sie von Ihren eigenen Systemen mit API-basierter Generierung. Ihre App sendet Text- und Stimmparameter an die TTS API, verknüpft Inhalte optional über die Voice Cloning API mit einer bestimmten Stimme und ruft Audio ab, das bereit ist, an Videos oder E-Learning-Voiceovers für Schulungsmodule angehängt zu werden. Dies eignet sich für Entwickler, Agenturen und LMS-Anbieter, die konsistente, programmatische Ausgabe benötigen.
Entscheidungskriterien: Die Wahl Ihres KI-Voiceover-Setups
Natürlichkeit und Audioqualität
Natürlichkeit ist nicht verhandelbar. Starke Engines modellieren Prosodie und Artikulation, sodass Sprache mit angemessenen Pausen und Betonungen fließt. Da die Generierung schnell ist, können Sie an einem Skript iterieren und Audio neu generieren, bis die Wiedergabe stimmt, anstatt sich mit dem ersten Versuch zufrieden zu geben.
Sprachabdeckung und Lokalisierungstiefe
Wenn mehrsprachige Kanäle oder internationale Schulungen auf Ihrer Roadmap stehen, entscheidet die Abdeckung, wie weit Sie reichen können. Inhalte aus mehr als 60 Ausgangssprachen aus einem Workflow in 33 Zielsprachen zu verwandeln, definiert die Märkte, die Sie bedienen können, und Speech-to-Speech-Dubbing hilft, Ton und Timing über jede Version hinweg konsistent zu halten.
Voice-Branding und Klonfähigkeit
Eine wiedererkennbare Stimme ist für Unternehmen, Creator und Podcasts wichtig. Das Klonen ermöglicht es Ihnen, dieselbe Stimme über Sprachen und Kanäle hinweg zu tragen. Die Möglichkeit, aus etwa 20 Sekunden sauberem Audio zu klonen und dieses Profil in Text to Speech und AI Dubbing wiederzuverwenden, macht einen unverwechselbaren Klang praktikabel zu etablieren und zu erhalten.
Workflow-Einfachheit versus technische Integration
Creator möchten oft, dass Upload, Bearbeitung und Download an einem Ort abgewickelt werden. Technische Teams benötigen oft APIs. Wir bieten beides: benutzerorientierte Tools in einer einheitlichen App und Entwickler-APIs, die dieselben Engines bereitstellen. Die Wahl läuft darauf hinaus, ob Ihr Team hauptsächlich in einem Browser arbeitet oder auf internen Systemen aufbaut.
Geschwindigkeit, Skalierbarkeit und Konsistenz
Ein Voiceover-Tool sollte die Produktion verkürzen und skalieren, ohne dass die Qualität nachlässt. Nahezu sofortige TTS-Generierung und Klonen, das in Sekunden abgeschlossen ist, ermöglichen schnelle Iteration und Massenausgabe, während APIs Tausende von Skripten oder Segmenten automatisch mit konsistenten Stimmen und Einstellungen verarbeiten lassen.
Budgetstruktur und Kontrolle
Anstelle von Studiogebühren pro Sitzung verwenden KI-Voiceover-Tools im Allgemeinen nutzungsbasierte Preise. Unser kreditbasiertes Modell gibt Ihnen unter einem Konto Zugriff auf AI Dubbing, Text to Speech, Voice Cloning, Speech to Text, Speech Separator, Text to Image und Image to Video, mit einem kostenlosen Tarif und Enterprise-Plänen. Credits bieten vorhersehbare Nutzungsobergrenzen, während Übertragung und Skalierung verfügbar bleiben, wenn das Volumen steigt. Wenn Sie Credits gegen die Laufzeit dimensionieren möchten, führt Sie unsere Aufschlüsselung der KI-Dubbing-Kosten pro Minute durch die Berechnung.
Compliance, Einwilligung und Datenverarbeitung
Klonen und synthetische Sprache tragen ethisches und rechtliches Gewicht. Wir verlangen, dass Sie Audio hochladen, an dem Sie die Rechte besitzen, und empfehlen saubere Aufnahmen für die besten Ergebnisse, was Einwilligung und Kontrolle in den Mittelpunkt stellt. Unsere API-Dokumentation verwendet sichere, vorsignierte Upload-URLs und Standard-Audioformate und bietet Entwicklern ein klares Muster für konforme Nutzung innerhalb von Anwendungen.
Risiken, die eine Planung wert sind
Selbst mit leistungsfähigen Tools sind einige Fehlermodi der Antizipation wert.
Unnatürliches oder roboterhaftes Audio lässt sich in der Regel auf schlecht interpunktierte Skripte oder eine Stimme zurückführen, die nicht zum Inhalt passt. Die Wahl aus einer Bibliothek natürlicher Stimmen und die erneute Generierung, bis die Wiedergabe passt, ist die praktische Lösung, und die schnelle Generierung macht dieses Experimentieren günstig.
Falsche Aussprache tritt häufig bei Namen, Fachbegriffen und lokalisierten Inhalten auf. Eine Pipeline, die Transkription, Übersetzung und Überprüfung durchläuft – anstatt einer blinden Audio-zu-Audio-Konvertierung – fängt mehr dieser Fehler ab, bevor sie ausgeliefert werden.
Timing-Abweichungen zwischen synthetisierter Sprache und Bildschirminhalten schaden dem Zuschauererlebnis. Speech-to-Speech-Dubbing, das nah am ursprünglichen Ton und Timing bleibt, gepaart mit der Bearbeitung innerhalb der Projektumgebung, gibt Ihnen bessere Kontrolle über die Abstimmung.
Ethisch gesehen lädt das Klonen einer Stimme ohne entsprechende Rechte zu ernsthaften Problemen ein. Ein sauberes Beispiel unter Ihrer Kontrolle zu verlangen und das Klonen als Werkzeug für Creator und Unternehmen statt als anonyme Identitätsvortäuschung zu positionieren, hält die Praxis verantwortungsvoll. Wenn Sie bestehendes Filmmaterial lokalisieren, zeigt Ihnen unser Leitfaden, wie man die Sprache einer Stimme in einem Video ändert, den überprüfungsfreundlichen Weg.
Wie verschiedene Creator dies in die Praxis umsetzen
Ein YouTube-Creator, der ins Ausland expandiert, kann ein englisches Video mit AI Dubbing und einer geklonten Stimme in spanische, portugiesische und deutsche Versionen verwandeln, sodass der Moderator über jeden Markt hinweg wiedererkennbar bleibt – alles innerhalb der Pipeline mit über 60 Ausgangs- und 33 Zielsprachen.
Ein kleines Unternehmen oder Marketing-Team kann ein Produkt-Erklärvideo oder ein Werbeskript in einem Dokument verfassen, es mit Text to Speech in Audio umwandeln und eine Stimme wählen, die zum Markenton passt – energiegeladen, förmlich oder gesprächig. Dieselben Skripte können später über AI Dubbing unter Verwendung einer geklonten Markenstimme lokalisiert werden.
Ein E-Learning- oder Firmenschulungsproduzent kann die Erzählung für Folienpräsentationen und SCORM-Pakete automatisieren, indem er Lektionstext durch die TTS API sendet und das zurückgegebene Audio an jedes Modul anhängt, wobei das Klonen die Stimme des Ausbilders auch über regionale Versionen hinweg konsistent hält.
Ein unabhängiger Filmemacher oder Podcast-Creator kann Trailer, Promos oder übersetzte Dialoge produzieren, ohne in jeder Sprache ein Studio zu buchen, indem er Speech to Text, AI Dubbing und geklonte Stimmen kombiniert, um die Charakteridentität stabil zu halten.
Entwickler und Agenturen können die TTS-, Voice-Cloning- und AI-Dubbing-APIs in interne Tools oder Kundenplattformen einbetten und alles automatisieren, von Kurzform-Social-Voiceovers bis hin zu interaktiven Sprachagenten.
Häufig gestellte Fragen
Wie unterscheiden sich KI-Voiceovers von traditionell aufgenommenen Voiceovers?
Traditionelle Voiceovers benötigen einen menschlichen Sprecher, Studiozeit und mehrere Sitzungen. KI-Voiceovers werden von Text-to-Speech- und Voice-Cloning-Engines generiert, die Skripte direkt in Audio umwandeln, indem sie trainierte neuronale Modelle anstelle einer Live-Darbietung verwenden.
Kann ein KI-Voiceover wie eine bestimmte Person klingen?
Ja. Voice Cloning analysiert ein kurzes Beispiel der Stimme einer Person und erstellt ein individuelles Modell, das jedes Skript in dieser Stimme sprechen kann, verfügbar in unserem Voice-Cloning-Tool und der API.
Wie viel Audio wird benötigt, um eine Stimme zu klonen?
Wir bitten um mindestens 20 Sekunden sauberes Audio, frei von Hintergrundgeräuschen, um ein zuverlässiges geklontes Stimmprofil zu erstellen, wobei das Klonen in der Regel in Sekunden abgeschlossen ist.
Kann ich aus einem Quellvideo Voiceovers in mehreren Sprachen erstellen?
Ja. Wir kombinieren Speech-to-Text, Übersetzung und Text-to-Speech, um Inhalte aus mehr als 60 Ausgangssprachen in synchronisierte Ausgaben über 33 Zielsprachen hinweg zu verwandeln, sodass ein Originalvideo viele lokalisierte Voiceovers erzeugen kann.
Gibt es eine Möglichkeit, die Voiceover-Erstellung zu automatisieren, anstatt die Benutzeroberfläche zu verwenden?
Unsere TTS API und Voice Cloning API ermöglichen es Apps und internen Tools, Text- und Audiobeispiele zu senden, individuelle Stimmen zu erstellen und synthetische Sprache programmatisch zu empfangen, sodass Voiceovers automatisch im großen Maßstab generiert werden können.