تحوّل ترجمة الكلام إلى كلام الكلمات المنطوقة بلغة ما إلى كلام مسموع بلغة أخرى، فيسمع جمهورك الترجمة بدلاً من قراءتها. تخيّل مدرّبًا سجّل درسًا بالإنجليزية ويحتاج الآن إلى نسخة بالإسبانية دون إعادة تسجيل أي شيء: يقوم النظام بتفريغ الإنجليزية، ويترجم المعنى، ويولّد صوتًا بالإسبانية مكانه. ذلك التحوّل من القراءة إلى الاستماع هو الهدف كله، وهو يغيّر طريقة تخطيطك ومراجعتك ونشرك للمحتوى متعدد اللغات.
السؤال الحقيقي نادرًا ما يكون ما إذا كانت التقنية تعمل. بل أي نسخة منها تحتاجها: ترجمة مسجّلة للفيديوهات والدورات والبودكاست؛ أو ترجمة شبه فورية للاجتماعات والفعاليات؛ أو مخرجات تحافظ على الصوت وتبقي على هوية المتحدث الأصلي؛ أو واجهة برمجية (API) يمكنك دمجها في تطبيقك الخاص. يحمل كل مسار من هذه المسارات مقايضات مختلفة في الجودة وزمن الاستجابة وجهد المراجعة، ويرسم هذا الدليل خريطتها كي تختار بوعي كامل.
جدول المحتويات
كيف تعمل ترجمة الكلام إلى كلام
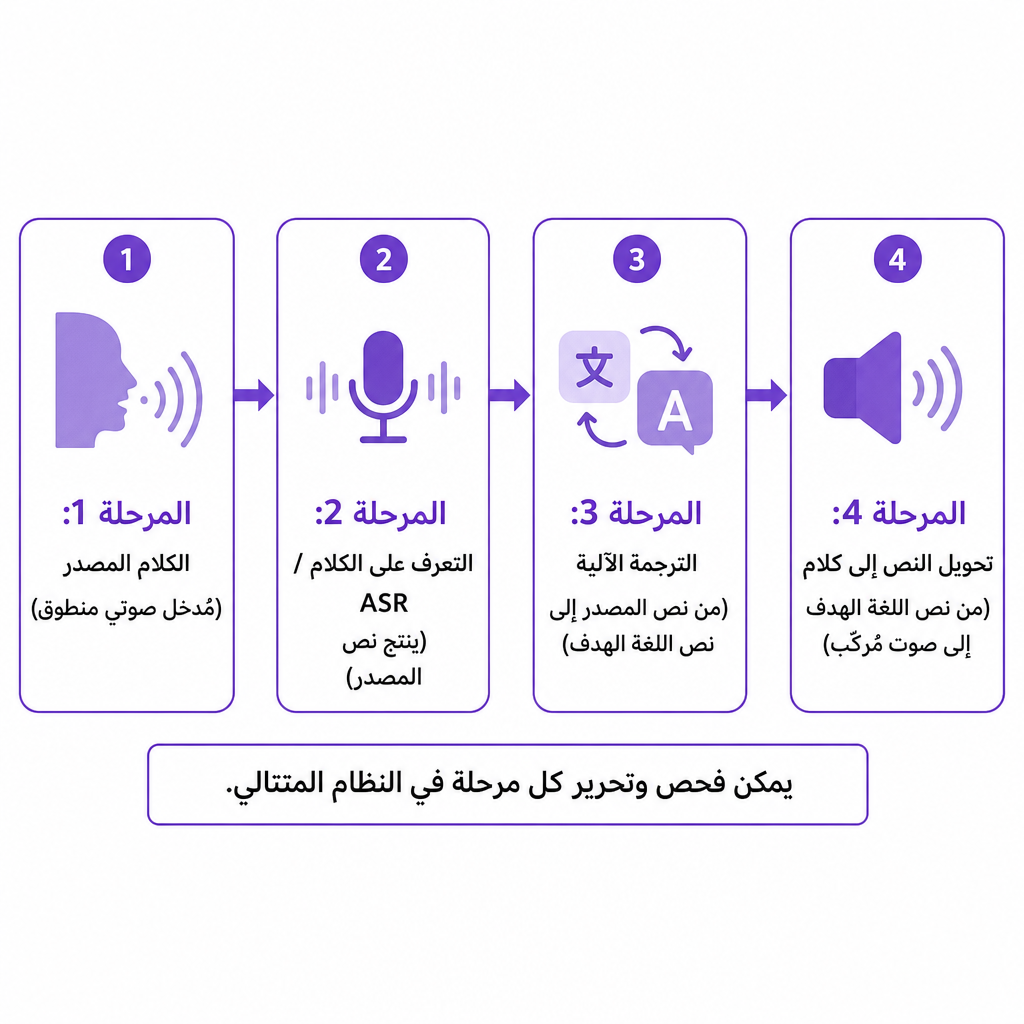
تعمل معظم الأنظمة عبر خط إنتاج مترابط من ثلاث تقنيات. أولاً، يحلّل التعرّف التلقائي على الكلام (ASR) الصوت المصدر وينتج نصًا مفرّغًا. ثم تحوّل الترجمة الآلية ذلك النص باللغة المصدر إلى اللغة الهدف. وأخيرًا، يحوّل تحويل النص إلى كلام النصَّ المترجَم إلى صوت منطوق. يسير التدفّق بوضوح من كلام المصدر، ثم التعرّف، ثم النص المترجَم، ثم الكلام المركّب.
كلام المصدر ← التعرّف على الكلام ← النص المترجَم ← الكلام المركّب
يُسمّى هذا التصميم الطبقي ترجمة الكلام إلى كلام المتسلسلة، ويصف منشور NIST حول تقييم ترجمة الكلام البنية نفسها: يبني التعرّف على الكلام النص المفرّغ المصدر، وتنتج الترجمة الآلية نصًا باللغة الهدف، ويولّد تحويل النص إلى كلام المخرجات المنطوقة. ميزة التسلسل أن كل مرحلة قابلة للفحص، فيمكنك تصحيح نص مفرّغ أو ترجمة قبل توليد الصوت أصلًا.
يدرّب نهج أحدث نموذجًا متكاملًا من البداية إلى النهاية لتحويل الصوت المصدر مباشرة إلى صوت باللغة الهدف دون إظهار مراحل تفريغ وتركيب منفصلة. تؤطّر الأبحاث المنشورة عبر التقرير التقني لـ DTIC حول الترجمة المباشرة للكلام هذا باعتباره وسيلة لتقليل التأخير والحفاظ على المزيد من صوت المتحدث الأصلي، مع الإشارة إلى أنه لا يزال يقايض السرعة والسياق والتغطية اللغوية وجودة المخرجات. عمليًا، يمنحك التسلسل تحكّمًا تحريريًا أكبر؛ بينما يسعى النهج المتكامل إلى زمن استجابة أقل واستمرارية للصوت.
ترجمة الكلام إلى كلام مقابل المهام ذات الصلة
كثيرًا ما يخلط الناس بين ترجمة الكلام إلى كلام والتفريغ وترجمة النصوص والدبلجة، لكن كلًا منها ينتهي بمخرج مختلف. تتوقف ترجمة النصوص عند المخرج المكتوب. وتنتهي ترجمة الكلام إلى كلام بمخرج منطوق، رغم أن النظام المتسلسل لا يزال يستخدم النص داخليًا كتمثيل وسيط. إن فرز المدخلات والمخرجات يجنّبك اختيار الأداة الخاطئة للمهمة.
| التقنية | المدخل | المخرج | الاستخدام المعتاد |
|---|---|---|---|
| الكلام إلى نص | صوت منطوق | نص مفرّغ مكتوب | التسميات التوضيحية، الملاحظات، المحتوى القابل للبحث |
| ترجمة النصوص | نص مكتوب | نص مترجَم | المستندات، الترجمات النصية، صفحات الويب |
| النص إلى كلام | نص مكتوب | كلام اصطناعي | السرد، إمكانية الوصول، الواجهات الصوتية |
| ترجمة الكلام إلى كلام | صوت منطوق | كلام مترجَم | المحادثات، الدبلجة، الوسائط متعددة اللغات |
تستحق الدبلجة تمييزها الخاص. تركّز ترجمة الكلام إلى كلام بشكل ضيّق على تغيير اللغة المنطوقة. أما الدبلجة فهي سير عمل أوسع لتوطين الوسائط يلتفّ حولها: ترجمة الحوار، وتعيين المتحدثين، وتوليد أصوات جديدة، وضبط التوقيت، ومزج الأصوات المترجَمة مع الموسيقى والصوت الخلفي، وتصدير مشروع نهائي. بالنسبة لفيديو YouTube مسجّل، أو دورة عبر الإنترنت، أو بودكاست، أو فيلم، تكون الدبلجة عادةً الصيغة الأكثر عملية لأنها تضيف تلك الضوابط التحريرية فوق الترجمة. إذا كنت توازن بين الصوت والنص على الشاشة، فإن شرحنا حول الدبلجة مقابل الترجمة النصية للفيديو يتناول هذا الخيار المحدد، وتوجد الآليات الأوسع في دليلنا حول ما هي الدبلجة بالذكاء الاصطناعي وكيف تعمل.
المكوّنات الثلاثة التي تحدد الجودة
جودة المخرجات ليست رقمًا واحدًا. إنها حصيلة ثلاث مراحل، لكل منها أنماط فشلها الخاصة، لذا يُفضّل تقييمها بشكل منفصل بدلاً من الوثوق بانطباع عام.
يحدد التعرّف التلقائي على الكلام الكلمات في التسجيل المصدر، وتنخفض دقّته مع الموسيقى الخلفية والمتحدثين المتداخلين واللهجات القوية والكلام السريع أو غير المكتمل والمصطلحات الخاصة بمجال معيّن والميكروفونات الرديئة والتبديل اللغوي بين اللغات. من المقاييس الشائعة هنا معدل خطأ الكلمات (WER)، الذي يقارن نصًا مفرّغًا آليًا بمرجع بشري عبر عدّ عمليات الاستبدال والحذف والإدراج. يستخدم منشور NIST نفسه معدل خطأ الكلمات كمعيار للتعرّف، رغم أن انخفاض معدل خطأ الكلمات لا يؤكد أن الترجمة اللاحقة حافظت على المعنى أو النبرة. إذا كان الصوت المصدر مشوّشًا، فإن عزل الكلام النظيف أولًا بأداة مثل فاصل الكلام لدينا يمكن أن يرفع دقة التعرّف حتى قبل بدء الترجمة.
على الترجمة الآلية أن تفسّر أكثر من الكلمات المفردة. فهي تتعامل مع بنية الجملة والسياق والضمائر والجنس والتعابير الاصطلاحية والفكاهة والرسمية والمراجع الثقافية والمصطلحات التقنية واختلافات ترتيب الكلمات. قد تكون الترجمة الحرفية صحيحة نحويًا لكنها تبدو غير طبيعية أو تغيّر المعنى المقصود بهدوء، وهو أمر محفوف بالمخاطر خصوصًا في الادعاءات الإعلانية والتعليمات القانونية والمعلومات الطبية والمحتوى المالي والمواد التعليمية.
يولّد تركيب الكلام الصوت النهائي باللغة الهدف، متحكّمًا في النطق والوقفات ومعدل الكلام والتنغيم والتشديد والنبرة العاطفية وهوية الصوت واللهجة أو متغيّر اللغة. يوفّر منتج تحويل النص إلى كلام لدينا أكثر من 300 صوت بالذكاء الاصطناعي، وتوليدًا متعدد اللغات، واستنساخًا للصوت عبر 33 لغة، مع ضوابط لمعدل الكلام والتشديد وقراءة الأرقام والأداء العاطفي. قد تبقى الترجمة الدقيقة تقنيًا غير موفّقة إذا لم يناسب الأداء العلامة التجارية أو الدورة أو الفيلم الوثائقي الذي تنتمي إليه.
استنساخ الصوت في الكلام المترجَم
استنساخ الصوت اختياري، لكنه ما يجعل المحتوى المترجَم يبدو كأنه من المبدع نفسه بدلاً من شخص غريب يقرأ نصًا. فبدلاً من تعيين صوت جاهز غير ذي صلة لكل لغة، يمكن للنظام أن يبني أداءً باللغة الهدف مبنيًا على الهوية الصوتية للمتحدث الأصلي. تلك الاستمرارية مهمة لقناة ترغب في صوت واحد مميّز عبر اللغات، أو شركة لها مقدّم معروف، أو دورة طويلة بقيادة مدرّب، أو صانع أفلام يحتاج إلى اتساق عبر النسخ المدبلجة، أو مقدّم بودكاست يبقي على صوت مألوف في الحلقات المترجَمة.
وهذا ليس ضمانة. يحافظ الاستنساخ على الهوية الصوتية، لكن العاطفة والفكاهة والإيقاع والنطق والسياق الثقافي لا تزال تحتاج إلى مراجعة بشرية قبل النشر. ولا يقل أهمية عنها التفويض: يؤكد سير العمل المسؤول أن من زوّد بالتسجيل قد وافق على الاستنساخ وأن الصوت الناتج يجوز استخدامه للتوزيع التجاري أو العام أو الجغرافي المقصود. إذا كنت فضوليًا بشأن الآليات وراء ذلك، فإن نظرتنا العامة حول كيف يعمل استنساخ الصوت تتعمق أكثر، وتُظهر أداة استنساخ الصوت الجانب الإنتاجي.
الترجمة المسجّلة مقابل الترجمة الفورية
هذا هو القرار الذي تواجهه معظم الفرق فعلًا، ولا ينبغي الحكم على الوضعين بالمقياس نفسه.
تكون الترجمة المسجّلة عادةً الأنسب لإنتاج الوسائط لأنها تمنحك وقتًا للعمل. يمكنك تصحيح النص المفرّغ، وتحرير المصطلحات، ومراجعة الترجمة، وتحديد المتحدثين، وضبط التوقيت، وإعادة توليد الأصوات، ومزج الصوت الخلفي، وإجراء ضمان جودة بشري قبل إطلاق أي شيء. هذا يجعلها مناسبة تمامًا لقنوات YouTube والتعلّم الإلكتروني والتدريب المؤسسي والبودكاست وفيديوهات المنتجات والأفلام المستقلة.
تعمل الترجمة الفورية تحت قيد أصعب: يجب أن تبدأ في إنتاج المخرجات قبل أن ينهي المتحدث جملته. يحسّن المزيد من السياق جودة الترجمة لكنه يضيف تأخيرًا، بينما تفرض التأخيرات الأقصر تنبؤات أو ترجمات جزئية، ويصعب التراجع عن الأخطاء بعد أن يكون الصوت قد تم تشغيله بالفعل. يشير تقرير DTIC إلى أن الأنظمة المتسلسلة الأقدم كثيرًا ما كانت تعمل بتأخيرات من أربع إلى خمس ثوانٍ، وتُراكِم الأخطاء عبر المراحل، وتحدّ من التخصيص، وأن زيادة مدى تطلّع النموذج إلى الأمام يمكن أن يرفع الجودة بينما يجعل التفاعل يبدو أقل فورية. فميزة مؤتمر مباشر ودبلجة متعددة اللغات مصقولة يحلّان مشكلتين مختلفتين، لذا احكم عليهما بمعايير مختلفة.
كيفية تقييم سير عمل ترجمة الكلام إلى كلام
اختبر بعيّنة تمثيلية، لا بجملة عرض تجريبي أنيقة. تعكس قائمة التحقق أدناه الظروف الحقيقية التي سيواجهها محتواك، وتبقي التقييم أمينًا.
- تغطية اللغات واللهجات: قد لا تعني "تدعم الإسبانية" اللهجة أو المفردات أو التفضيلات الإقليمية التي يتوقعها جمهورك. تأكد من متغيّرات المصدر والهدف، بما في ذلك الإنجليزية الأمريكية مقابل غيرها، والإسبانية في أمريكا اللاتينية مقابل الأوروبية، والفرنسية الكندية مقابل الأوروبية.
- دقة النص المفرّغ: لا يمكن للترجمة أن تصلح بشكل موثوق نصًا مفرّغًا يشوّه الأسماء أو الأرقام أو مصطلحات المنتج. تحقق مما إذا كان بإمكانك فحص النص المفرّغ وتحريره قبل توليد الصوت.
- المعنى والسياق: اختبر عمدًا التعابير الاصطلاحية والنكات ودعوات اتخاذ الإجراء وادعاءات المنتج ومصطلحات الصناعة. الطلاقة ليست دقّة.
- التعامل مع المتحدثين: بالنسبة للمقابلات والحلقات النقاشية والأفلام، تحقق من قدرة الأداة على تحديد متحدثين متعددين وإبقاء أصواتهم متسقة، بما في ذلك عندما يقاطع الناس بعضهم.
- التوقيت والمزامنة: نادرًا ما تطابق الجمل المترجَمة المدة الأصلية. ابحث عن ضوابط للتوقيت أو معدل الكلام، إضافة إلى تحرير الحوار والحفاظ على الصوت الخلفي وضبط مستوى الصوت وإعادة توليد المقاطع والمحاذاة البصرية عند الحاجة.
- طبيعية الصوت: استمع للنطق والوقفات والتشديد والمدى العاطفي والإيقاع غير الطبيعي.
- زمن الاستجابة: للاستخدام المباشر، قِس تأخير المتحدث إلى الصوت. وللاستخدام المسجّل، أعطِ الأولوية لمرونة التحرير على سرعة المعالجة الخام.
- ضوابط المراجعة والتصدير: تتيح لك الأداة الجاهزة للإنتاج تصحيح النص، وإعادة توليد مقاطع فردية، وضبط التوقيت، والتصدير بصيغة يقبلها سير عمل النشر لديك.
مرّر هذه العيّنات عبر قائمتك المختصرة وقارن دقة النص المفرّغ، ومعنى الترجمة، والنطق، وطبيعية الصوت، واتساق المتحدثين، والتوقيت، وجودة الصوت الخلفي، وجهد المراجعة، والتكلفة الإجمالية عند حجمك المتوقع. النظام الأقوى ليس ذا أكثر الأصوات أو اللغات. بل هو الذي ينتج نتائج مقبولة لمحتواك المحدد بعبء مراجعة يمكن لفريقك تحمّله فعلًا.
المخاطر والقيود التي يجدر التخطيط لها
تُدخِل كل مرحلة نوعها الخاص من الأخطاء، ويمكن لصوت طبيعي أن يخفيها جميعًا. قد يسيء الذكاء الاصطناعي ترجمة التعابير الغامضة والأسماء والتعابير الاصطلاحية والمصطلحات المتخصصة، لذا تبقى المراجعة البشرية أساسية حيثما تحمل الدقّة وزنًا قانونيًا أو أمنيًا أو ماليًا أو متعلقًا بالسمعة. تضاعف أخطاء التعرّف المشكلة: يمكن للتشويش والتداخل الصوتي واللهجات والتسجيلات الرديئة أن تجعل النظام يسيء سماع المصدر، ولهذا فإن مراجعة النص المفرّغ قبل اعتماد الترجمة أمر غير قابل للتفاوض.
يسهل فقدان المعنى الثقافي. قد تُسقط الترجمة المباشرة الفكاهة أو التأدّب أو المراجع التي لا تنجو إلا بإعادة صياغة بدلاً من نقل كلمة بكلمة. يضيف استنساخ الصوت مخاطر الموافقة وانتحال الهوية، لذا وثّق من فوّض الصوت ونطاق الاستخدام والإقليم والمدة وما إذا كان يجوز ظهوره في الإعلانات أو التصريحات العامة الاصطناعية. وهناك أيضًا بُعد ثقة الجمهور: يصف تقرير DTIC كيف تُعلِم إحدى تجارب الترجمة المستخدمين بأن الصوت المترجَم مولّد اصطناعيًا، وهو توقّع معقول يجدر التخطيط له في إفصاحاتك الخاصة.
يختتم القائمة خطران أهدأ. تهمّ الخصوصية كلما احتوى الصوت على معلومات شخصية أو مناقشات سرية أو بيانات عملاء أو محتوى غير منشور، لذا راجع شروط مزوّد الخدمة في التعامل مع البيانات والاحتفاظ بها والوصول إليها وحذفها قبل الرفع. والثقة الزائفة هي أخبث الإخفاقات جميعًا: يجعل الصوت المصقول الترجمة الخاطئة تبدو موثوقة، لذا لا تعامل الطلاقة أبدًا كدليل على الدقّة الوقائعية.
أين يناسب DubSmart
نحن الأكثر صلة مباشرة بترجمة الكلام إلى كلام المسجّلة من خلال الدبلجة بالذكاء الاصطناعي، وليس من خلال أي ادعاء بترجمة محادثة مباشرة شاملة. يقبل سير عمل الدبلجة لدينا رفع ملفات الصوت والفيديو وروابط YouTube، ويدعم أكثر من 60 لغة مصدر و33 لغة هدف، ويستنسخ صوت كل متحدث للنسخة المترجَمة، ويتيح لك تحرير النص والمتحدثين والتوقيتات، وإعادة توليد المقاطع، وضبط مستوى الصوت الخلفي، وتنزيل المشروع النهائي. تلك الطبقة التحريرية هي بالضبط ما يحتاجه إنتاج الوسائط المسجّلة.
للفرق التي تبني خطوط إنتاجها الخاصة، نقدّم أيضًا واجهات برمجية لـ الدبلجة بالذكاء الاصطناعي وتحويل النص إلى كلام واستنساخ الصوت، وهي تناسب الوكالات وسير عمل الوسائط والتطبيقات التي تحتاج إلى أتمتة إنتاج الصوت متعدد اللغات. يتوقف الاختيار الصحيح على ما إذا كان مشروعك يريد محرّر وسائط جاهزًا، أو خط إنتاج مدفوعًا بواجهة برمجية، أو كليهما. بالنسبة لرسالة قصيرة عالية المخاطر، قد تظل الترجمة والتسجيل البشري الاحترافي هما الفائز؛ أما لمكتبة محتوى كبيرة ومتكررة التحديث، فإن سير عمل الذكاء الاصطناعي يتوسّع بشكل أفضل مع مراجعة بشرية تركّز على المواد الأعلى مخاطرة.
الأسئلة الشائعة
هل ترجمة الكلام إلى كلام هي نفسها الترجمة الفورية؟
لا. تعتمد الترجمة الفورية البشرية على شخص مدرّب يستمع ويفهم وينقل المعنى في اللحظة. أما ترجمة الكلام إلى كلام فهي مؤتمتة: سريعة وقابلة للتوسّع، لكنها قد تتطلب مراجعة ويمكن أن تتعثّر في الفروق الدقيقة التي يتعامل معها المترجم الفوري المحترف بشكل طبيعي.
هل تعمل دائمًا في الوقت الفعلي؟
لا. تعالج بعض الأنظمة الصوت المسجّل بتحكّم تحريري كامل، بينما توفّر أخرى مخرجات مباشرة أو شبه فورية. توازن الأنظمة المباشرة باستمرار بين سياق الترجمة وزمن الاستجابة والدقّة.
هل يمكنها الحفاظ على صوت المتحدث الأصلي؟
أحيانًا. يمكن للأنظمة التي تستخدم استنساخ الصوت أو التركيب المحافظ على الصوت أن تنمذج هوية المتحدث الأصلي، لكن النتيجة تعتمد على التقنية وزوج اللغات وجودة الصوت والتفويض باستخدام ذلك الصوت.
هل الدبلجة بالذكاء الاصطناعي شكل من أشكال ترجمة الكلام إلى كلام؟
نعم. الدبلجة بالذكاء الاصطناعي هي تطبيق على الوسائط المسجّلة لترجمة الكلام إلى كلام يضيف ميزات التحرير وإدارة المتحدثين والتوقيت والمزج والتصدير فوق الترجمة الأساسية.
ما مدى دقّتها؟
تتفاوت الدقّة بحسب اللغة وجودة التسجيل والمصطلحات والمتحدث والنظام. قيّم النص المفرّغ والترجمة والصوت المولّد بشكل منفصل بدلاً من الوثوق بنسبة دقّة واحدة.