منصة إنشاء الوسائط بالذكاء الاصطناعي هي بيئة واحدة تقوم فيها بإنشاء وتصويت وتوطين وتصدير الوسائط—الصوت والفيديو والصور والنصوص—باستخدام الذكاء الاصطناعي، بدلاً من دمج أدوات منفصلة وعمليات نقل يدوية. لذا عندما تسأل ما هي منصة إنشاء الوسائط بالذكاء الاصطناعي، فإن الإجابة المختصرة هي أنها تستبدل مجموعة متفرقة من تطبيقات النسخ وأدوات الصوت وخدمات الترجمة والمحررات بسير عمل واحد مترابط. في DubSmart AI، بنينا منصتنا حول هذه الفكرة بالضبط: الانتقال من نص خام أو فيديو مصدري إلى محتوى متعدد اللغات مُصوَّت بالكامل دون مغادرة مساحة العمل أبداً.
يهم هذا التوحيد لأن الجزء الصعب في العمل الحديث على المحتوى نادراً ما يكون مهمة واحدة. إنه الحفاظ على اتساق الأصوات، ومحاذاة التوقيت، ونقل الملفات بسلاسة بين الخطوات. المنصة التي تمتلك خط الإنتاج بأكمله تزيل الاحتكاك الذي يلتهم الساعات بين التسجيل والدبلجة والنشر.
جدول المحتويات
ما الذي يُحسب فعلاً كمنصة لإنشاء الوسائط بالذكاء الاصطناعي
السمة المميزة هي سير العمل، وليس عدد الميزات. لا تصبح مجموعة من قدرات الذكاء الاصطناعي منصة إلا عندما تتشارك هذه القدرات بيئة واحدة: تستورد الوسائط مرة واحدة، وتحوّلها عبر عدة خطوات بالذكاء الاصطناعي، وتصدّر أصلاً نهائياً دون التصدير وإعادة الاستيراد بين الأدوات.
بالنسبة لنا، يعني ذلك أن تحويل النص إلى كلام، واستنساخ الصوت، والدبلجة بالذكاء الاصطناعي، وتحويل الكلام إلى نص، وفاصل الكلام، وتحويل النص إلى صورة، وتحويل الصورة إلى فيديو، جميعها موجودة في المكان نفسه. يمكن لمنشئ محتوى على YouTube، أو فريق تسويق، أو منتج للتعلم الإلكتروني، البدء من نص أو فيديو مصدري والوصول إلى مخرجات متعددة اللغات ومُصوَّتة بالكامل داخل نظام واحد. مهمة المنصة هي التعامل مع العمل الرابط—النسخ يغذي الترجمة، الترجمة تغذي توليد الصوت، توليد الصوت يغذي دبلجة موقوتة—بحيث لا تصبح أي خطوة عملية يدوية لخلط الملفات.
هذا هو الخط العملي بين أداة أحادية الغرض ومنصة. مولّد تحويل النص إلى كلام المستقل ينتج صوتاً ثم يتوقف. المنصة تعامل هذا الصوت كمرحلة واحدة في خط إنتاج أطول ينتهي بملف قابل للنشر ومُوطَّن.
هل تحتاج إلى واحدة، أم أن الأدوات المنفصلة كافية
القرار الحقيقي هو ما إذا كنت ستواصل إدارة المحتوى والتوطين مع بائعين متفرقين واشتراكات SaaS، أم ستُركّز هذا العمل حيث يتصل توليد الصوت والفيديو والصورة مباشرةً. بالنسبة لمعظم الفرق، تعتمد الإجابة على عدد المرات التي تطرأ فيها المسألة.
بعض السيناريوهات تجعل الاختيار ملموساً:
- قناة YouTube نجحت بالإنجليزية وتريد نسخاً بالإسبانية أو البرتغالية أو الهندية دون إعادة تسجيل كل فيديو.
- فريق تسويق صغير يحتاج إلى توطين فعّال من حيث التكلفة للحملات وعروض المنتجات والشروحات على جدول متكرر.
- مجموعة تعلم إلكتروني أو تدريب مؤسسي يجب أن تقدّم دورات طويلة باتساق عبر عدة لغات للموظفين حول العالم.
- صانع أفلام مستقل أو مقدّم بودكاست يريد دبلجة متعددة اللغات لكن لا يمكنه تبرير جلسات الاستوديو المتكررة وأتعاب المواهب الصوتية.
- فريق تطوير أو وكالة يحتاج إلى ذكاء صوتي مكشوف عبر واجهات برمجة التطبيقات لتشغيل منتجه الخاص أو خط التوطين لديه.
إذا كانت عمليتك الحالية تعتمد على التسجيل اليدوي، أو الاستوديوهات الخارجية، أو عدة تطبيقات غير مترابطة، أو نصوص برمجية مخصصة لمجرد نقل الملفات بين الأنظمة، فإن المسألة لم تعد تتعلق بإضافة أداة أخرى. تصبح مسألة كفاءة ونطاق وتحكّم. إذا كنت توطّن فيديو واحداً في السنة، فالأدوات المنفصلة كافية. إذا كنت توطّن أسبوعياً، فإن عمليات النقل هي المكان الذي يتسرب منه وقتك واتساقك.
كيف تعمل هذه المنصات خلف الكواليس
تختلف التطبيقات، لكن معظم منصات إنشاء الوسائط بالذكاء الاصطناعي تتشارك مجموعة قليلة من الآليات. إليك كيف تتكامل معاً في سير عملنا.
مساحة عمل مركزية للوسائط
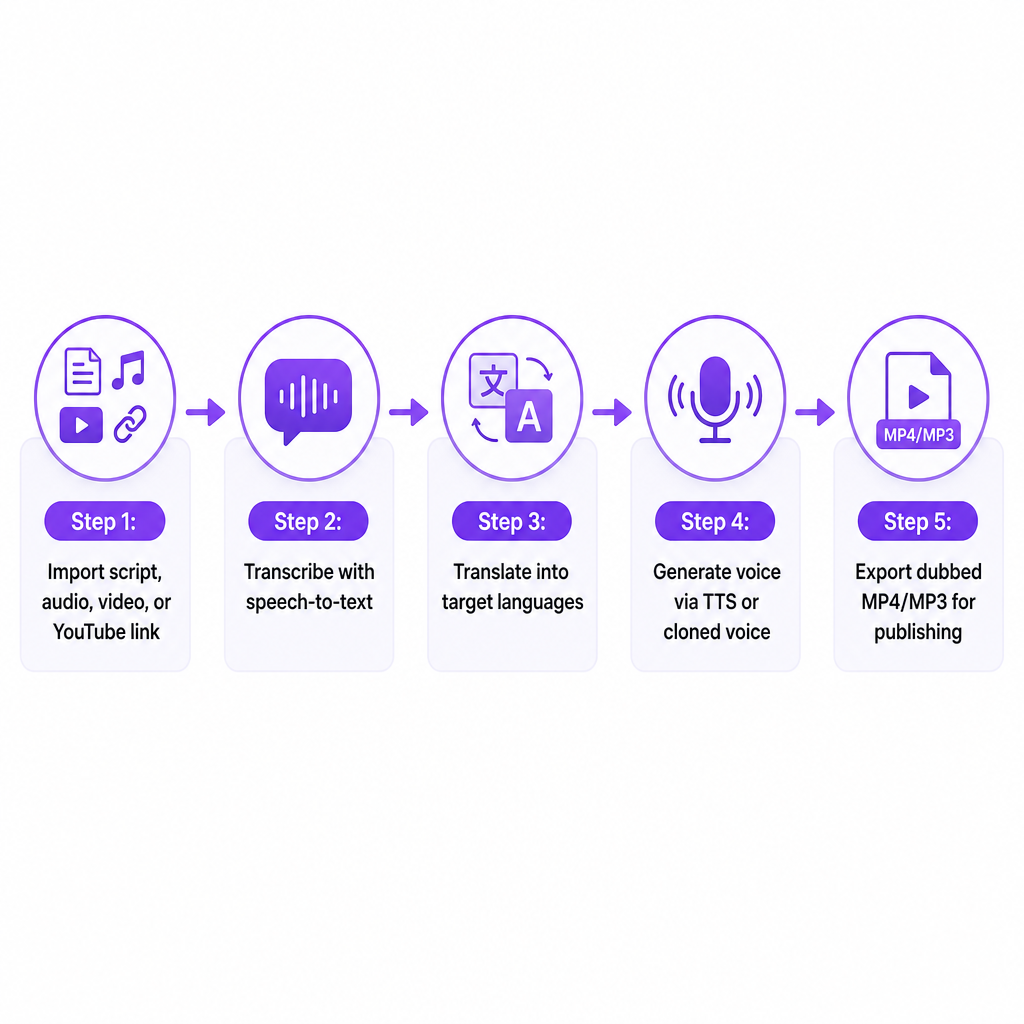
يبدأ كل شيء بالاستيراد: النصوص، الصوت، ملفات الفيديو، أو رابط YouTube. من هناك تنظّم المشاريع حسب اللغة والمتحدث والقناة، وتطبّق تحويلات الذكاء الاصطناعي على خط زمني مشترك، وتصدّر بالصيغة التي تحتاجها وجهتك—MP4 أو MP3 لـ YouTube، ملفات جاهزة للتحرير لمرحلة ما بعد الإنتاج، صوت لنظام إدارة التعلم. واجهتنا مبنية بحيث ترفع فيديو محلياً أو تربط بمحتوى عبر الإنترنت، وتضبط المتحدثين والتوقيتات، وتنزّل المشاريع الموطّنة النهائية من مساحة العمل نفسها.
إنشاء الصوت واستنساخه كنسيج رابط
الصوت عادةً هو العمود الفقري لخط الإنتاج. نعامل استنساخ الصوت كنسيج رابط وليس كطرافة: ترفع عينة كلام نظيفة، فنعالجها إلى صوت مخصص مُسمّى في ثوانٍ، وتعيد استخدام ذلك الصوت عبر تحويل النص إلى كلام والدبلجة. الآلية قصيرة—سجّل أو قدّم ما لا يقل عن 20 ثانية من الكلام النظيف، ارفعه إلى قسم استنساخ الصوت، ثم طبّق الملف الناتج حيثما تحتاجه. يمكن لذلك الصوت المستنسخ نفسه أن يولّد المقدمات والتعليقات الصوتية التدريبية في تحويل النص إلى كلام، ويحافظ على هوية المتحدث عبر اللغات في الدبلجة. مكتبة من أكثر من 300 صوت أساسي طبيعي الصوت تغطي الحالات التي تريد فيها أصواتاً مختلفة لأسواق مختلفة.
تحويل النص إلى كلام والدبلجة من كلام إلى كلام
يحوّل تحويل النص إلى كلام النصوص والتعليقات إلى صوت طبيعي، ولأنه يتصل مباشرةً بالدبلجة وتوليد الترجمات، يمكن لمشروع واحد الانتقال من النص إلى فيديو موطّن دون مغادرة سير العمل. تعمل الدبلجة من كلام إلى كلام بشكل مختلف: تأخذ صوتاً مسجّلاً موجوداً، وتحلّل النبرة والطبقة وأسلوب التحدث والتوقيت، ثم تعيد إنشاء ذلك الصوت وهو يتحدث بلغة مستهدفة جديدة. يستخدم خط الدبلجة بالذكاء الاصطناعي لدينا هذا للحفاظ على خصائص المتحدث الأصلي بدلاً من إدراج تعليق صوتي عام—مفيد عندما تكون الأصالة هي الهدف. إذا أردت الآليات الأعمق، شرحنا حول الدبلجة من كلام إلى كلام يستعرض تدفق التحليل إلى إعادة التوليد.
خط التوطين متعدد اللغات
تعتمد قيمة المنصة بشكل كبير على تغطية اللغات وكيفية اتصال الترجمة بالصوت. تدعم منظومة الدبلجة لدينا الدبلجة من أكثر من 60 لغة مصدرية إلى 33 لغة مستهدفة، مما يتيح لك اختيار اللغات المستهدفة والمتحدثين والأنماط لكل مشروع. عملياً: استورد فيديو أو رابطاً، واختر هدفاً واحداً أو أكثر مثل من الإنجليزية إلى الإسبانية والبرتغالية، وحدّد أصواتاً مستنسخة أو جاهزة لكل لغة، ودع النظام يتولى النسخ والترجمة وتوليد الصوت وإعادة التوقيت إلى دبلجة جاهزة للتحميل. ولأن الاستنساخ مدمج، يمكن للصوت المضيف نفسه أن يحمل عبر كل لغة، ما يبقي الجمهور على أرض مألوفة.
واجهات برمجة التطبيقات للمطورين والوكالات
عندما تبني الفرق منتجاتها الخاصة، فإنها تحتاج إلى قدرات مكشوفة برمجياً. ننشر واجهة برمجة تطبيقات استنساخ الصوت التي تعكس التدفق داخل التطبيق: اطلب عنوان URL للرفع موقّع مسبقاً، وارفع عينة صوتية (MP3 أو WAV أو AAC أو M4A أو FLAC)، وأنشئ صوتاً مخصصاً بإرسال مفتاح الملف المُعاد مع اسم الصوت، ثم أشِر إلى ذلك الصوت في الاستدعاءات اللاحقة. تتيح واجهة برمجة تطبيقات الدبلجة بالذكاء الاصطناعي للمطورين إنشاء مشاريع دبلجة، وضبط اللغات المستهدفة وإعدادات الصوت، وتفعيل تحليل صوت المتحدث الأصلي قبل توليد كلام يحافظ على تلك الخصائص في اللغة الجديدة. هذا يعني أن الوكالات يمكنها تضمين الصوت والدبلجة داخل منتجاتها الخاصة دون إعادة بناء النماذج الأساسية.
ثلاثة أساليب عامة لإنشاء الوسائط بالذكاء الاصطناعي
حتى ضمن المنصات المتكاملة، ينقسم السوق إلى بضعة أنواع من الخيارات، ويناسب كل منها مشترياً مختلفاً.
المنصات التي تعطي الأولوية للمنشئين والمدفوعة بسير العمل تركّز على واجهة سهلة الوصول، وتنظيم المشاريع، والتوطين من البداية إلى النهاية للفيديو والصوت والصور. هنا يقع تطبيق الويب لدينا، ممتداً عبر تحويل النص إلى كلام والاستنساخ والدبلجة وتحويل الكلام إلى نص وفصل الكلام وتحويل النص إلى صورة وتحويل الصورة إلى فيديو في واجهة واحدة.
المنصات المتمحورة حول واجهات برمجة التطبيقات تستهدف المطورين أولاً، مركّزةً على نقاط النهاية والحمولات بدلاً من واجهة غير تقنية. تُوسّع واجهات برمجة تطبيقات استنساخ الصوت وتحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي لدينا المنتج الذي يعطي الأولوية للمنشئين لصالح الفرق التي تحتاج إلى تحكم برمجي.
الأدوات الضيقة أحادية القدرة تقوم بشيء واحد—تحويل نص إلى كلام أساسي أو نسخ بسيط—دون خط الإنتاج المحيط. يمكن أن تناسب مهمة مركّزة جداً، لكنك ستحتاج إلى أدوات إضافية للوصول إلى أصل نهائي موطّن.
بالنسبة لمعظم المنشئين والشركات في الولايات المتحدة، يتلخص الاختيار في منصة سير عمل يمكن لفريق التسويق أو المحتوى استخدامها مباشرةً، مقابل نهج واجهة برمجة التطبيقات الذي يربطه المطورون بالأنظمة الحالية. نتناول الطرفين عمداً: منتج قائم على الأرصدة مع سير عمل بواجهة إضافة إلى واجهات برمجة تطبيقات للتكامل.
كيفية الاختيار: المعايير التي تهم
عندما توازن ما إذا كنت ستتبنى منصة، وأيها، تقوم مجموعة قليلة من المعايير بمعظم العمل.
| المعيار | ما الذي يجب التحقق منه | كيف نتناوله |
|---|---|---|
| تغطية سير العمل | هل يمتد من النص أو الفيديو المصدري إلى وسائط موطّنة نهائية؟ | تحويل النص إلى كلام، الاستنساخ، الدبلجة، تحويل الكلام إلى نص، فاصل الكلام، تحويل النص إلى صورة، تحويل الصورة إلى فيديو في خط إنتاج واحد |
| اللغة وجودة الصوت | تغطية المصدر والهدف بالإضافة إلى واقعية الصوت | أكثر من 60 لغة مصدرية إلى 33 هدفاً، أكثر من 300 صوت طبيعي، استنساخ للهوية الأصيلة |
| السرعة والنطاق | مدى سرعة تحوّل المدخلات إلى مخرجات؛ سعة المعالجة الدفعية | استنساخ من عينات قصيرة تُعالج في ثوانٍ؛ دبلجة مصممة للمشاريع المتكررة |
| نموذج التسعير | تكلفة قابلة للتنبؤ ومرنة مرتبطة بالحجم | قائم على الأرصدة مع طبقة مجانية، وأرصدة قابلة للترحيل، وخطط للمؤسسات |
| التكامل | واجهات برمجة تطبيقات لربط نظام إدارة التعلم أو نظام إدارة المحتوى أو الأدوات الداخلية الحالية | واجهات برمجة تطبيقات استنساخ الصوت وتحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي التي تكشف القدرات الأساسية |
اثنان من هذه تستحق نظرة أقرب. فيما يخص السرعة، يعمل استنساخنا من حوالي 20 ثانية من الصوت ويعيد صوتاً قابلاً للاستخدام في ثوانٍ، لذا لا يعتمد وقت الإنجاز على تسجيل مجموعات بيانات طويلة. فيما يخص التسعير، يعني النموذج القائم على الأرصدة مع الترحيل أن الرصيد غير المستخدم يُنقل إلى الأمام وأن التكلفة تتماشى مع حجم المحتوى بدلاً من المقاعد الثابتة وحدها—وهو ما يناسب المنشئين وفرق التدريب الذين ترتفع مخرجاتهم وتنخفض.
المخاطر والقيود والاستخدام المسؤول
يأتي النطاق مع التزامات، والنسخة الصادقة من هذه الإجابة تسميها.
- حقوق الصوت والموافقة. يثير استنساخ صوت دون تفويض مناسب مخاوف قانونية وأخلاقية. نشجّع على عينات نظيفة وموافق عليها ونعامل الأصوات المستنسخة كأصول احترافية، وليست أدوات انتحال. دليلنا لاستخدامات استنساخ الصوت للمنشئين يستند إلى حالات مشروعة مثل القنوات متعددة اللغات والتدريب.
- الأصالة والإفصاح. قد يهتم الجمهور بما إذا كان الصوت اصطناعياً. بالنسبة للتسويق والتدريب والأفلام، فإن الشفافية بشأن استخدام الذكاء الاصطناعي تحمي الثقة—خاصة عندما يبدو صوت مدبلج متطابقاً تقريباً مع المتحدث الأصلي عبر اللغات.
- الفروق اللغوية والثقافية. حتى الترجمة والدبلجة القوية تستفيد من المراجعة البشرية. المصطلحات المحلية والصياغة التنظيمية والحساسيات الثقافية تعني أن مخرجات الذكاء الاصطناعي يجب أن تُعامل كمسودة أولى للمحتوى عالي المخاطر مثل الرسائل المتعلقة بالامتثال أو الطب أو المالية.
- أمن البيانات. غالباً ما يكون الصوت والنصوص والفيديو ملكية خاصة. تدفقات الرفع المُتحكَّم بها والتنظيم القائم على المشاريع—مثل نموذج عنوان URL الموقّع مسبقاً لدينا—تهم للفرق التي تتعامل مع مواد حساسة.
مع التعامل معها بسياسة ومراجعة، لا تلغي هذه المخاطر قيمة منصة إنشاء الوسائط بالذكاء الاصطناعي. إنها تحدد كيف ينبغي للفرق الاحترافية أن تنظّم استخدامها لواحدة.
بالنسبة للمنشئين والشركات وفرق التدريب في الولايات المتحدة، منصتنا هي إجابة ملموسة للسؤال الأصلي: بيئة شاملة لإنشاء الوسائط وتوطينها تُوحّد أدوات الصوت والمرئيات، وتبقي صوتك الخاص متسقاً عبر اللغات، وتتوسع إلى الأسواق الكبرى عبر دبلجة من أكثر من 60 إلى 33 لغة، وتبقى سهلة الوصول عبر كل من تطبيق ويب صديق للمنشئين وواجهات برمجة التطبيقات. نُفيد بخدمة أكثر من 500,000 مستخدم عبر المنشئين والشركات. خطوتك التالية هي مطابقة المعايير أعلاه مع عدد مرات توطينك الفعلي—وإذا كنت تفعل ذلك بانتظام، أخبرنا بلغاتك ونوع محتواك حتى نتمكن من توجيهك إلى سير العمل الصحيح.
الأسئلة الشائعة
ما هي منصة إنشاء الوسائط بالذكاء الاصطناعي بمصطلحات بسيطة؟
إنها برنامج يتيح لك إنشاء الوسائط وتصويتها وتوطينها—خاصة الفيديو والصوت—باستخدام الذكاء الاصطناعي من سير عمل مركزي واحد، بدلاً من الاعتماد على أدوات منفصلة لكل خطوة.
كيف يختلف هذا عن أداة أساسية لتحويل النص إلى كلام؟
ندمج تحويل النص إلى كلام داخل خط إنتاج أوسع يشمل استنساخ الصوت والدبلجة بالذكاء الاصطناعي وتحويل الكلام إلى نص وفاصل الكلام والتوليد المرئي، حتى تنتقل من النص أو الفيديو المصدري إلى محتوى نهائي متعدد اللغات في مكان واحد.
هل يمكنني الاحتفاظ بصوتي الخاص عند الدبلجة إلى لغات أخرى؟
نعم. مع استنساخ الصوت والدبلجة من كلام إلى كلام، نحلّل صوتك من عينة قصيرة ونولّد صوتاً بلغات جديدة يحافظ على نبرتك وطبقتك وأسلوب تحدثك.
كم عدد اللغات التي يدعمها DubSmart للدبلجة؟
ندعم الدبلجة من أكثر من 60 لغة إلى 33 لغة مستهدفة، تغطي الأسواق الرئيسية التي يتوسع إليها عادةً المنشئون والشركات في الولايات المتحدة.
هل هناك طريقة لتجربة DubSmart قبل الالتزام؟
نعم. نقدّم طبقة مجانية على نموذج قائم على الأرصدة حتى يتمكن المنشئون والفرق من اختبار سير العمل، وتُرحّل الأرصدة، وتتعامل خطط المؤسسات مع الاستخدام الأكبر حجماً.