إذا التقط الميكروفون ضجيج المرور أو ثرثرة المقهى أو خلفية موسيقية تقع مباشرة فوق الحوار، فإن السؤال ليس ما إذا كان التسجيل قابلاً للاستخدام—بل كيفية استخراج الصوت بشكل نظيف. وهذا بالضبط ما يفعله فاصل الكلام. بعبارة بسيطة، فاصل الكلام هو أداة صوتية مدعومة بالذكاء الاصطناعي تعزل الكلام البشري عن كل شيء آخر في التسجيل—ضجيج الخلفية، والموسيقى، والأصوات الأخرى—بحيث يتبقى لديك مسار صوتي نظيف يمكنك تفريغه أو دبلجته أو استنساخه أو إعادة مزجه. بالنسبة لأي شخص ينتج محتوى متعدد اللغات، فإن هذا المسار النظيف هو الفرق بين دبلجة تبدو احترافية ودبلجة تبدو "جيدة بما فيه الكفاية".
يشرح هذا الدليل ما هو فاصل الكلام فعلاً، وكيف يعمل من الداخل، ومتى تحتاجه حقاً، وما الذي ينبغي أن تزنه قبل الالتزام بأداة. لقد بنينا فاصل الكلام ضمن سير عمل DubSmart AI تحديداً لأن الكلام النظيف هو الأساس الذي يقوم عليه كل شيء آخر.
جدول المحتويات
ما هو فاصل الكلام حقاً
في أبحاث الصوت، يُعرَّف فصل الكلام بأنه مهمة فصل الكلام المستهدف عن التداخل الخلفي في تسجيل مختلط. وتذهب الأنظمة الأكثر تطوراً إلى أبعد من ذلك فتفصل عدة متحدثين عن بعضهم البعض، منتجةً مساراً معزولاً لكل صوت.
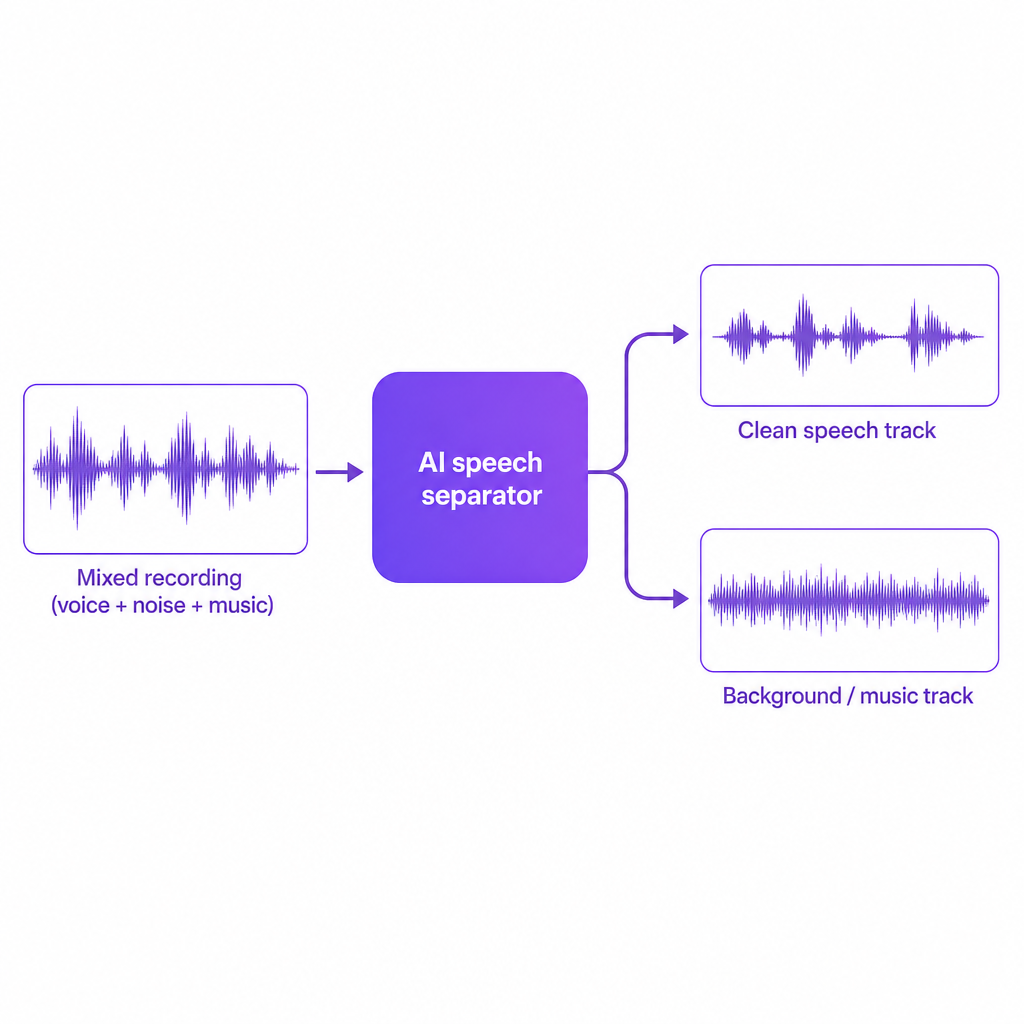
وترجمةً إلى العمل الإنتاجي اليومي، يأخذ فاصل الكلام ملفاً صوتياً مختلطاً—حوار مع ضجيج أو موسيقى—ويُخرج مساراً واحداً أو أكثر يحتوي على الكلام فقط، بالإضافة إلى مسار اختياري يحمل صوت الخلفية المتبقي. لقد صُمم فاصل الكلام لدينا لإزالة ضجيج الخلفية وعزل الكلام من أي تسجيل، مما يجعله ملائماً تماماً لمرحلة ما بعد إنتاج الأفلام والبودكاست والمقابلات. وهو يعمل على كل من ملفات الصوت والفيديو: إذ يمكنه إزالة الضجيج من التسجيلات في البيئات الصاخبة وفصل الغناء عن الموسيقى المصاحبة بحيث ينتهي بك الأمر إلى مسارات منفصلة للصوت والخلفية.
وهنا يقع الناس في مفهوم خاطئ شائع. فاصل الكلام ليس نفس الشيء الذي هو تقليص الضجيج التقليدي. تقليص الضجيج يخفض مستوى صوت الأصوات غير المرغوب فيها. أما فاصل الكلام فيحدد بنشاط أين يوجد الكلام في الإشارة ويعيد بناءه كتيار منفصل وأنظف. وهذا التمييز هو السبب في أن الفاصل يمكنه إنقاذ صوت مدفون تحت الموسيقى، بينما بوابة الضجيج في الغالب لا تفعل سوى جعل التسجيل بأكمله أكثر هدوءاً.
هل تحتاجه فعلاً؟
القرار الحقيقي هو ما إذا كان عملك يعتمد على صوت كلام موثوق ونظيف بدلاً من أي شيء صادف الميكروفون التقاطه. وإذا كان كذلك، فإن الفاصل المخصص يتوقف عن كونه ميزة إضافية لطيفة ويصبح خطوة أساسية.
هناك عدة مواقف تجعل هذا الترقية بديهية. غالباً ما يعيد صانعو محتوى يوتيوب والشركات الصغيرة استخدام لقطات قديمة سُجلت في غرف مليئة بالصدى أو في المقاهي أو في الشارع، حيث يجعل الضجيج فهم الكلام صعباً وتفريغه صعباً. وتبني فرق التعليم الإلكتروني والتدريب دورات متعددة اللغات من الندوات والمحاضرات الحية، حيث يرث كل تفريغ ودبلجة لاحقة جودة الكلام الأصلي. وكثيراً ما يحتاج صانعو الأفلام ومنتجو البودكاست إلى إنقاذ أداء رائع التُقط في ظروف غير مثالية قبل مزجه مجدداً مع الموسيقى والتصميم الصوتي. ويعرف المطورون أو الوكالات الذين يغذّون صوت المستخدمين في خطوط التفريغ أو استنساخ الصوت أو الدبلجة أن المدخلات الصاخبة تخفض دقة النماذج بشكل مباشر.
هناك بعض المحفزات الملموسة التي تشير إلى أن الفاصل يستحق التبني:
- أنت تُوطّن محتوى إلى لغات متعددة وتريد دبلجة وترجمات واضحة ومتسقة. الكلام النظيف يغذّي محركي الدبلجة بالذكاء الاصطناعي وتحويل الكلام إلى نص لدينا بموثوقية أكبر بكثير من المزيج الصاخب.
- أنت تعتمد على استنساخ الصوت من أجل صوت علامة تجارية أو شخصية وتريد أفضل النتائج الممكنة عبر التدريب على عينات خالية من الضجيج والتشوهات.
- أنت تتلقى بانتظام تسجيلات من إنشاء المستخدمين أو تسجيلات ميدانية لم تتحكم فيها، ولا تزال بحاجة إلى جعلها جاهزة للبث. الفاصل يمنحك مرحلة تنظيف قابلة للتكرار بدلاً من ضبط كل ملف يدوياً.
الاستثناء الصادق: إذا كان صوتك مُسجلاً بالفعل في استوديو معالَج، بمسارات منفصلة للحوار والموسيقى، فإن الفاصل يكون وسيلة راحة أكثر من كونه ضرورة. أما لكل من يعمل مع الصوت الواقعي، فإنه يكسب مكاناً دائماً في خط الإنتاج.
كيف يعمل فصل الكلام من الداخل
يُبنى فصل الكلام الحديث على التعلم العميق وأبحاث فصل المصادر، لا على معادِل الصوت (EQ) والمرشحات البسيطة. المهمة الأساسية سهلة الوصف وصعبة الحل: بالنظر إلى إشارة مختلطة تحتوي على عدة مصادر، استعِد إشارات الكلام الفردية دون معرفتها مسبقاً.
تتبع معظم الأنظمة الحالية خط أنابيب مُشفِّر–فاصل–مُقدِّر–مُفكِّك. يقوم المُشفِّر بتحويل الموجة الخام أو المطياف إلى فضاء ميزات عالي الأبعاد حيث تصبح الأنماط المتعلقة بالكلام مثل الرنينات (formants) والتوافقيات أسهل في الكشف. ثم يعالج الفاصل—وهو شبكة عصبية—تلك الميزات ويتعلم فصل المعلومات التي تنتمي إلى مصادر صوت مختلفة، سواء كان ذلك كلاماً مقابل ضجيج أو متحدثاً مقابل آخر. ثم تقوم مرحلة التقدير إما بالتنبؤ بأقنعة تصفّي المكونات غير الكلامية أو بتقدير التمثيل الميزاتي لكل مصدر مباشرة. وأخيراً، يحوّل المُفكِّك تلك التمثيلات المفصولة مجدداً إلى صوت في المجال الزمني، منتجاً مساراً كلامياً نظيفاً واحداً أو أكثر، واختيارياً مسار خلفية متبقٍّ.
تُدرَّب هذه النماذج على مجموعات بيانات كبيرة مليئة بمزائج الكلام والضجيج، فتتعلم الأنماط التمييزية للكلام والمتحدثين والتداخل من أمثلة موسومة. وتُهيّئ الأبحاث الأحدث الفاصل على تضمينات المتحدث (speaker embeddings) أو المطالبات، مما يجعل من الممكن توجيه الفصل نحو صوت محدد داخل صوت مزدحم.
الخلاصة العملية للمبدعين هي أن الفاصل الحديث ليس بوابة ضجيج متطورة. إنه نموذج تعلّم كيف يبدو الكلام ويُسمع عبر ظروف عديدة، ويمكنه إعادة بناء الصوت حتى عندما يكون مدفوناً تحت الموسيقى أو ضجيج الحشد أو صدى الغرفة.
مهمتا الفصل الرئيسيتان
في الممارسة العملية ستقابل نوعين من فصل الكلام، وغالباً ما تجمع المنصات بينهما.
الأول هو كلام المتحدث الواحد مقابل الخلفية: استخراج مسار صوتي متماسك واحد من الضجيج أو الموسيقى أو الأجواء المحيطة. وهذه هي المهمة التي يتمحور حولها فاصل الكلام لدينا للأفلام والبودكاست والمقابلات، لأنها تنطبق مباشرة على ما يحتاجه معظم المبدعين يومياً.
الثاني هو فصل المتحدثين المتعددين، حيث ينتج النظام مساراً منفصلاً لكل متحدث في محادثة. وهذا مفيد بشكل خاص للتفريغ حسب المتحدث (diarization) والتحليلات في الاجتماعات الطويلة أو حلقات النقاش، حيث تكون معرفة من قال ماذا لا تقل أهمية عما قيل.
تميل أدوات المستهلك إلى تغليف هذه في واجهات بسيطة—ارفع أغنية لتحصل على مسارات غنائية وآلية منفصلة، أو اعزل الحوار في فيديو للتحرير. ويركز تطبيقنا على فصل الكلام عن الخلفية لأنه المهمة الأكثر قيمة على الفور لسير عمل الدبلجة والتفريغ والاستنساخ.
ما الذي ينبغي أن تزنه قبل اختيار فاصل
عندما تُقيّم ما إذا كان الفاصل يلبي الاحتياجات الاحترافية، هناك حفنة من المعايير تهمّ أكثر من نصوص التسويق.
ابدأ بجودة الكلام والتشوهات. الفاصل الجيد يحافظ على الطابع الصوتي الطبيعي للصوت بدلاً من جعله يبدو معدنياً أو كأنه تحت الماء أو ذا طور مختل، ويتجنب إدخال ضجيج موسيقي أو تشوه قاسٍ عند إزالته للعناصر الخلفية القوية مثل الموسيقى. تشير الدراسات الأكاديمية إلى التداخل المتبقي والتشوهات باعتبارها التحديات الأساسية، خاصة في الضجيج غير الثابت. ويظل الاختبار الأكثر موثوقية هو فحص عينات المخرجات على موادك الخاصة.
يأتي بعد ذلك المتانة أمام ضجيج العالم الحقيقي. النماذج المدربة على بيانات معملية نظيفة قد تعاني مع المرور والرياح وهمهمة الحشد والغرف ذات الصدى والمحتوى الذي يتداخل فيه الكلام مع موسيقى أو مؤثرات صاخبة. تستهدف الأعمال المتقدمة هذه المزائج المعقدة تحديداً، لكن الأداء لا يزال يتفاوت حسب ظروف التسجيل—لذا اختبر عبر البيئات التي تسجّل فيها فعلاً، من المكاتب إلى الشوارع إلى الاستوديوهات المنزلية.
التعامل مع الموسيقى والمحتوى المختلط حاجة متكررة ومحددة. إزالة موسيقى تصويرية لإعادة الدبلجة، أو عزل السرد عن اللقطات التكميلية (B-roll)، يتطلب أداة تدعم صراحةً فصل الموسيقى عن الصوت وتُخرج ملفين قابلين للاستخدام بدلاً من نتيجة واحدة مكتومة. يكتشف خط الفصل لدينا الترددات الغنائية، ويعزلها عن الموسيقى، ويُنتج ملفات منفصلة عالية الجودة: واحد بغناء نظيف وآخر بخلفية الموسيقى. وهذا مفيد بشكل خاص عندما تخطط لإعادة المزج أو إعادة التلحين أو إعادة الدبلجة إلى لغات أخرى.
يقرر التكامل مع الأدوات اللاحقة مقدار الوقت الذي يوفّره الفاصل فعلاً. نادراً ما يعيش الفصل وحده—فهو يغذّي نماذج التفريغ حيث تخفض المدخلات الأنظف معدلات الخطأ في الكلمات، ومحركات استنساخ الصوت التي تكافئ العينات الخالية من الضجيج، وأنظمة الدبلجة التي تحاذي الكلام الأصلي مع المسارات المترجمة. تُبنى منصتنا حول سير عمل موحد يبقي فاصل الكلام، وتحويل الكلام إلى نص، وتحويل النص إلى كلام، واستنساخ الصوت، والدبلجة بالذكاء الاصطناعي في مكان واحد، بحيث يمكن لتسجيل نظيف واحد أن يصبح محتوى متعدد اللغات، بصوت مستنسخ، ومُوطَّناً بالكامل دون إعادة بناء خط الإنتاج في كل مرة.
الكمون والحجم والأتمتة أمور مهمة لأي شخص لديه تراكم عمل. تحتاج البودكاست الطويلة والدورات والأرشيفات إلى معالجة دفعية تتعامل مع ملفات متعددة الساعات، وأوقات معالجة معقولة لكل ملف، وخطافات أتمتة حيث يجلس الفصل داخل أنظمتك الخاصة. نحن نوفّر واجهات برمجية (APIs) لـتحويل النص إلى كلام واستنساخ الصوت والدبلجة بالذكاء الاصطناعي حتى يتمكن المطورون من ربط معالجة الكلام في خطوط أنابيب متكاملة من البداية إلى النهاية.
وأخيراً، لا تختفي الخصوصية والامتثال بمجرد أن يصبح الصوت نظيفاً. فصل الكلام عن الخلفية لا يزيل مسؤوليتك عن التسجيلات التي قد تحتوي على محادثات حساسة، أو عن احترام الحقوق عندما تستخرج وتعيد استخدام أصوات من مواد مرخصة. ينبغي لفرق المؤسسات التأكد من وجود سياسات واضحة حول الاحتفاظ بالبيانات واستخدامها ومواءمة أي سير عمل للفصل مع إرشادات الامتثال الداخلية.
أين يقصّر
يمكن لفاصل الكلام أن يُحوّل تسجيلاً، لكنه ليس سحراً، والتظاهر بغير ذلك يؤدي إلى قرارات سيئة.
الإفراط في إزالة الضجيج هو الفخ الأكثر شيوعاً. الفصل العدواني قد ينتزع إشارات كلامية خفية—الحروف الساكنة الناعمة، نبرة الغرفة الطبيعية—ويترك الصوت يبدو غير طبيعي أو مُرهقاً للاستماع. والتشوهات المتبقية هي الوجه الآخر: في الظروف الصعبة قد يترك النموذج آثاراً من الموسيقى أو الضجيج في مسار الكلام، أو يولّد ضجيجاً موسيقياً، خاصة عندما يكون التداخل قوياً ومتغيراً باستمرار.
هناك أيضاً تحيّز المتحدث واللغة الذي يجب أخذه في الحسبان. النماذج المدربة في الغالب على لغات أو لهجات أو أساليب حديث معينة قد تؤدي أداءً أسوأ على الأصوات الممثَّلة تمثيلاً ناقصاً. كما أن الموجة التي تبدو نظيفة يمكن أن تخلق شعوراً زائفاً بالأمان: فهي لا تضمن أن الصوت مناسب للمهام الحرجة مثل التحليل الجنائي أو سياقات الامتثال الصارمة.
بالنسبة للعمل الإبداعي وأعمال التوطين، تكون هذه القيود قابلة للإدارة، لكنها حجة قوية للاختبار بعينات تمثيلية من موادك الخاصة بدلاً من الوثوق بعروض البائعين التوضيحية.
فاصل الكلام داخل سير عملنا
نتعامل مع فاصل الكلام باعتباره تطبيقاً عملياً وصديقاً للمبدعين لهذه التقنية، مُدمَجاً بإحكام مع بقية منصة DubSmart AI بدلاً من إضافته على العجل.
عند الاستخدام، يزيل ضجيج الخلفية ويعزل الكلام من أي تسجيل، منتجاً صوتاً نظيفاً مناسباً لمرحلة ما بعد الإنتاج في الأفلام والبودكاست والمقابلات. يستخرج غناءً واضحاً من المسارات المختلطة ويولّد ملفات منفصلة عالية الجودة للكلام وموسيقى الخلفية، بحيث يمكنك التحرير أو إعادة الدبلجة أو إعادة المزج دون مصارعة المزيج الأصلي. وهو يعمل على مصادر الصوت والفيديو معاً—ترفع الملفات أو تستخدم الروابط، وتُمررها عبر خط الأنابيب، وتنزّل المسارات الجاهزة. والأهم، أن هذه المخرجات مُحسّنة لتغذية أدواتنا الأخرى، بحيث يمكن تحويل تسجيل نظيف واحد إلى محتوى متعدد اللغات، بصوت مستنسخ، ومُوطَّن بالكامل.
بالنسبة لصانعي محتوى يوتيوب والشركات الصغيرة والمدربين وصانعي الأفلام ومنتجي البودكاست وفرق المطورين، يغيّر هذا التكامل دور الفصل نفسه. فهو يتوقف عن كونه مهمة معزولة "لإصلاح الصوت" ويصبح الخطوة الأولى الموحدة في دورة حياة أوسع ومؤتمتة لإنشاء المحتوى وتوطينه. إذا كنت تبني قناة أو مكتبة دورات متعددة اللغات، فهناك حيث يتراكم التوفير الحقيقي في الوقت.
الأسئلة الشائعة
ما هو فاصل الكلام، بعبارات بسيطة؟
إنه أداة ذكاء اصطناعي تأخذ تسجيلاً صاخباً ومختلطاً وتُخرج مساراً تسمع فيه في الغالب الصوت البشري فقط، بالإضافة إلى مسارات خلفية اختيارية يمكنك الاحتفاظ بها أو التخلص منها.
هل فاصل الكلام هو نفسه تقليص الضجيج؟
لا. تقليص الضجيج يخفض ببساطة الأصوات غير المرغوب فيها. أما فصل الكلام فيحدد ويعيد بناء الكلام صراحةً كمصدر متميز، عادةً بوضوح أعلى وتحكم أكبر في النتيجة.
هل يمكن لفاصل الكلام التعامل مع أكثر من متحدث؟
يمكن للعديد من الأنظمة البحثية المستوى وبعض المنتجات فصل عدة متحدثين إلى مسارات فردية، رغم أن الجودة تتفاوت مع التداخل وظروف التسجيل. يركز فاصل الكلام لدينا بشكل أساسي على عزل الكلام عن الخلفية لسير عمل المبدعين الشائع.
هل سيؤدي استخدام فاصل الكلام إلى تحسين نتائج الدبلجة واستنساخ الصوت لدي؟
نعم. عادةً ما يحسّن صوت المدخلات الأنظف من التعرف على الكلام والمحاذاة وجودة استنساخ الصوت، مما يجعل الدبلجة متعددة اللغات والأصوات المستنسخة أكثر طبيعية واتساقاً.
هل يعمل فصل الكلام بغض النظر عن اللغة؟
تعمل معظم نماذج الفصل على الأنماط الصوتية وليس على النص، لذا يمكنها التعامل مع العديد من اللغات. لا يزال الأداء يعتمد على بيانات التدريب ومدى تمثيل لهجتك.