يُبنى التعليق الصوتي بالذكاء الاصطناعي ليوتيوب على مسار بسيط: تحوّل نصًا مكتوبًا إلى صوت منطوق باستخدام تحويل النص إلى كلام، ثم تراجع النتيجة، ثم تضع ذلك الصوت في محرر فيديو وتصدّر ملفًا جاهزًا ليوتيوب. تعلّم كيفية إنشاء تعليق صوتي بالذكاء الاصطناعي ليوتيوب لا يتعلق كثيرًا بإيجاد صوت سحري بقدر ما يتعلق بمطابقة الطريقة الصحيحة لقناتك، ثم التحكم في النطق والإيقاع والمزج النهائي. لقد بنينا DubSmart AI للتعامل مع هذا المسار بأكمله في مكان واحد، بالجمع بين تحويل النص إلى كلام، واستنساخ الصوت، وتنظيف الصوت، والدبلجة متعددة اللغات حتى لا تضطر إلى ربط أربع أدوات منفصلة معًا.
القرار الذي يشكّل كل ما يأتي بعده هو أي طريقة صوتية تستخدم: صوت ذكاء اصطناعي جاهز، أو نسخة مستنسخة من صوتك الخاص، أو تعليق صوتي مترجم لجمهور آخر. كل خيار يغيّر سرعة إنتاجك، وهوية قناتك، والحقوق التي تحتاج إلى تأمينها. فيما يلي نعرّف الطرق، ونوضح كيف تعمل الآليات، ونمنحك معايير واضحة حتى تتمكن من الالتزام بمسار واحد بثقة.
جدول المحتويات
ما هو التعليق الصوتي بالذكاء الاصطناعي فعليًا
التعليق الصوتي بالذكاء الاصطناعي هو سرد اصطناعي مُولّد من نص مكتوب. بدلًا من تسجيل كل سطر بنفسك أو حجز ممثل صوتي، تقدّم نصًا إلى نظام تحويل النص إلى كلام، وتختار صوتًا، وتولّد مقطعًا صوتيًا يمكنك تحريره وإعادة استخدامه.
بالنسبة ليوتيوب، تناسب هذه المرونة مجموعة مدهشة من الصيغ: مقاطع الفيديو التفسيرية، والدروس التعليمية وتسجيلات الشاشة، والقنوات بدون وجه، والسلاسل التعليمية، وعروض المنتجات، ومقاطع Shorts، والنسخة المرئية من البودكاست، والإصدارات متعددة اللغات من محتوى سبق أن نشرته. وهو مفيد بشكل خاص لأي شيء يحتاج إلى تحديثات متكررة للنص، لأنك تعيد توليد سطر بدلًا من إعادة حجز جلسة.
ما يفصل النتيجة الاحترافية عن النتيجة الآلية الواضحة نادرًا ما يكون نموذج الصوت وحده. فبنية النص، والتعامل مع النطق، والإيقاع، والتوجيه العاطفي، ومستويات الموسيقى، والتزامن مع العناصر المرئية، كلها تؤثر في الانطباع النهائي. فالقراءة الصوتية القوية فوق مزج رديء ما زالت تبدو هاوية، لذا تكمن الحرفة في كيفية التحضير والتجميع، وليس فقط في أي صوت تختاره.
ثلاث طرق، ومتى تتفوق كل واحدة منها
هناك ثلاث طرق عملية لإنتاج السرد، والاختيار المدروس يوفّر ساعات لاحقًا.
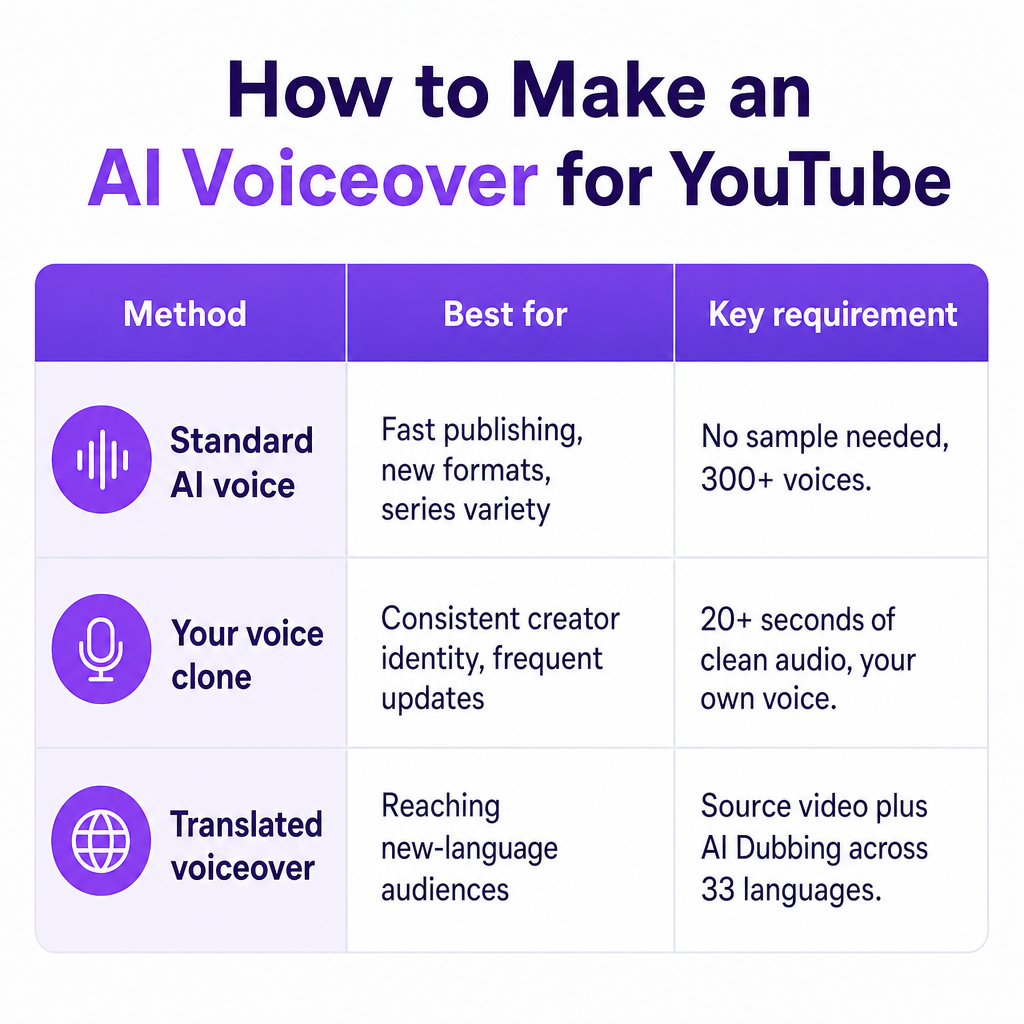
الصوت القياسي بالذكاء الاصطناعي هو المسار الأسرع. تختار صوتًا يتناسب مع الموضوع والجمهور والنبرة: واضح وهادئ للدرس التعليمي، واثق ومفعم بالطاقة لمراجعة تقنية، متزن وموثوق لشرح مالي، معبّر ومحادثي للألعاب، أكثر إشراقًا وتوكيدًا للمحتوى القصير، دافئ وحيوي لمحتوى الأطفال ضمن حدود السلامة المناسبة. تقدّم أداة تحويل النص إلى كلام لدينا أكثر من 300 صوت تشمل خيارات ذكورية وأنثوية ومحايدة، مُصممة للسرد والإعلانات والدورات والبودكاست.
استنساخ صوتك الخاص يمنحك راحة الذكاء الاصطناعي دون التخلي عن هويتك الصوتية، وهو أمر مهم عندما تريد سردًا متسقًا عبر مكتبة كبيرة. يمكن إنشاء نسخة DubSmart من عينة صوتية لا تقل عن 20 ثانية، ويجب أن يكون التسجيل نظيفًا وخاليًا من الضوضاء الخلفية. وبمجرد إنشائه، يعمل ذلك الصوت عبر تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي، بما في ذلك الإخراج متعدد اللغات. القاعدة غير القابلة للتفاوض: استنسخ فقط صوتك الخاص أو صوتًا لديك إذن واضح باستخدامه. فتقليد شخص آخر دون موافقته يخلق مشكلات قانونية وتتعلق بالسمعة والثقة لن يعذرها مقطع صوتي طبيعي.
التعليق الصوتي المترجم هو الخطوة الأفضل عندما يكون هدفك سوقًا جديدة بدلًا من قراءة إنجليزية جديدة. يمر هذا سير العمل بالنسخ، والترجمة، وتوليد الصوت، والتوقيت، والمزج، وهذا بالضبط ما صُمّمت الدبلجة بالذكاء الاصطناعي للفيديو متعدد اللغات لدينا للتعامل معه عبر 33 لغة. إذا كنت تفضّل مقارنة أصوات السرد المتاحة أولًا، فإن مجموعتنا من أفضل أصوات تحويل النص إلى كلام ليوتيوب تُفصّل المفاضلات حسب نوع القناة.
ما يجب تحضيره قبل أن تولّد سطرًا واحدًا
الاندفاع إلى مولّد الصوت بنص نصف مكتمل هو الطريقة الأكثر شيوعًا لإهدار الأرصدة وإعادة توليد الصوت نفسه ثلاث مرات. خمسة عناصر من التحضير تزيل معظم هذا الاحتكاك.
ابدأ بنص جاهز للسرد يتوافق مع بنية الفيديو، خالٍ من الملاحظات، وتوجيهات الإخراج، والجمل المكررة، والنص الذي سيظهر على الشاشة فقط. اقرنه بـقائمة نطق تحدد الأسماء والمصطلحات التقنية والاختصارات وأسماء المنتجات وعناوين URL والمختصرات والكلمات الأجنبية التي عادةً ما تُشوّهها النماذج. أضف جدولًا زمنيًا مرئيًا يحدد أين يبدأ كل قسم وأين ينتهي، حتى يتماشى السرد مع تسجيلات الشاشة والعروض ولقطات B-roll أو الرسوم المتحركة.
ثم اكتب موجزًا قصيرًا لتوجيه الصوت يحدد الإيقاع والنبرة والجمهور والطاقة. فعبارة "ودود وواضح" توجّه القراءة بشكل أفضل بكثير من الغريزة الغامضة باختيار شيء "طبيعي" فحسب. وأخيرًا، تأكّد من حقوقك وأذوناتك للنص والموسيقى واللقطات والصور والصوت، وهو ما يصبح حاسمًا لحظة دخول استنساخ الصوت أو مواد الطرف الثالث إلى المشروع.
كيف نحوّل النص إلى سرد نهائي
التسلسل الأساسي قصير: حضّر النص، ولّد السرد، راجع الصوت، ثم ضعه في الفيديو. الجودة تأتي من كيفية تنفيذ كل خطوة.
اكتب للكلام، وليس للقراءة. الجمل القصيرة والانتقالات الطبيعية والترقيم الصريح تتفوق على الفقرات الكثيفة في كل مرة. فبدلًا من جملة مثقلة بالعبارات مثل "منصّتنا، التي تتضمن عدة أدوات للذكاء الاصطناعي وتدعم الإنتاج متعدد اللغات، تمكّن المبدعين من العمل بكفاءة أكبر"، قسّمها إلى سطرين منطوقين: "DubSmart يجمع عدة أدوات إعلامية للذكاء الاصطناعي في سير عمل واحد. هذا يساعد المبدعين على إنتاج مقاطع الفيديو وتوطينها بشكل أسرع." أضف الفواصل والنقاط حيث تريد وقفات، واكتب الأرقام التي ينطقها النظام بشكل خاطئ بالحروف، واختبر أي اسم علامة تجارية بنطق غير معتاد قبل الالتزام بالنص الكامل.
عند اختيار صوت، استمع إلى ما وراء لمعان العرض التوضيحي. تحقق من الوضوح بسرعة التشغيل العادية، والوقفات الطبيعية، والعمر والنبرة الصوتية المناسبة، والنطق الصحيح لمصطلحات مجالك، والتعبير الذي يتوقف قبل أن يصبح مسرحيًا، والاتساق عبر عدة فقرات. الاختبار الوحيد الموثوق هو أسلوب جملتك الخاص، وليس جملة عينة من المزوّد.
ولّد اختبارًا قصيرًا قبل إنتاج أي شيء طويل. العينة الجيدة تحشر جملة تحتوي على رقم، واسم منتج أو شخص، وسؤالًا، وجملة مثقلة بالفواصل، ومصطلحًا تقنيًا، وانتقالًا بين الأقسام، والنبرة العاطفية التي تتوقعها طوال الفيديو. فذلك المقطع الواحد يكشف مشكلات النطق والإيقاع والنبرة وهي لا تزال رخيصة الإصلاح.
اضبط الإيقاع والأداء باعتدال. تتضمن عناصر التحكم في تحويل النص إلى كلام لدينا معدل الكلام، ويمكن للصياغة الوصفية مثل "قال بسعادة" أو "صرخت بغضب" أن توجّه العاطفة، بينما تصحح الأرقام المكتوبة بالحروف الأخطاء العنيدة في النطق. السرعة المفرطة تضر بالفهم والعاطفة المفرطة تجعل الفيديو التفسيري يبدو اصطناعيًا، لذا فإن قراءة هادئة وأبطأ قليلًا عادةً ما تخدم الدروس التعليمية بشكل أفضل.
بمجرد أن تصبح العينة صحيحة، ولّد النص الكامل في أقسام بدلًا من كتلة ضخمة واحدة، مقسمة حسب الفصل أو المشهد أو الانتقال الرئيسي. تتيح لك تلك البنية استبدال فقرة واحدة معيبة، أو إعادة توقيت قسم بعد تعديل، أو إصلاح نطق واحد، أو مقارنة أداءات بديلة دون إعادة توليد كل شيء. المسار الموثّق في DubSmart هو فتح تحويل النص إلى كلام، وإدخال نصك، واختيار متحدث، وتوليد الكلام، وتحرير المشروع، وتنزيل النتيجة.
وأخيرًا، حرّر التعليق الصوتي جنبًا إلى جنب مع الفيديو. حاذِ السرد مع الجدول الزمني المرئي وأبقِ الكلام مفهومًا فوق الموسيقى والمؤثرات: اخفض الموسيقى الخلفية عند بدء السرد، وأبقِ المؤثرات الصوتية بعيدة عن الكلمات المهمة، واترك فجوات قصيرة بين الأفكار الرئيسية، واقتطع الصمت الميت دون قطع مجال التنفس الطبيعي، وتحقق من المزج على سماعات الرأس، ومكبرات صوت الكمبيوتر المحمول، والهاتف. يمكن أن يظل الصوت النظيف بالذكاء الاصطناعي يبدو آليًا إذا كان كل سطر محشورًا مع المقطع التالي، لذا دع الأفكار الرئيسية تتنفس.
قاعدة صارمة عند التصدير: لن يقبل يوتيوب تحميلًا صوتيًا فقط. يحتاج مقطعك إلى طبقة مرئية، سواء كانت لقطات، أو تسجيل شاشة، أو رسوم متحركة، أو صورة ثابتة، أو موجة صوتية. صدّر المشروع النهائي كملف فيديو؛ تشير إرشادات الترميز في يوتيوب إلى حاوية MP4، وفيديو H.264، وصوت AAC-LC أو Opus، ومعدل عينات صوتية 48 كيلوهرتز.
جعل السرد بالذكاء الاصطناعي يبدو بشريًا حقًا
نموذج الصوت يؤدي نصف العمل فقط. النص والتحرير يحملان البقية، وبعض العادات ترفع النتيجة بشكل موثوق.
اكتب بأسلوب محادثي. الاختصارات والانتقالات الخفيفة مثل "إليك كيف يعمل"، و"الآن لننظر إلى مثال"، و"هذا مهم لأن" تُقرأ بشكل أكثر طبيعية بكثير من النثر الرسمي. قاوم ملء كل ثانية بالكلمات؛ فالوقفة المتعمدة تساعد المشاهدين على استيعاب نقطة معقدة وتجعل السرد يبدو مدروسًا بدلًا من متعجّل.
أبقِ صوتًا واحدًا متسقًا عبر القناة حتى يتعلم المشاهدون التعرّف عليه. تبديل الأصوات في كل فيديو يُجزّئ هويتك ما لم تستخدم الصيغة عدة مقدّمين عمدًا. النسخة المستنسخة تناسب هوية مبدع متكررة؛ والصوت القياسي يناسب الحملات لمرة واحدة أو الصيغ التجريبية.
طابق الصوت مع ما يراه المشاهدون. يجب أن يشرح السرد أو يضيف سياقًا بدلًا من قراءة النص المعروض على الشاشة كلمة بكلمة، ما لم تستدعِ إمكانية الوصول أو وضوح التعليمات ذلك. في تسجيلات الشاشة، اترك وقتًا لتحديد الأزرار والمتابعة؛ وفي مقاطع Shorts، فضّل الأسطر المحكمة على الشرح الكثيف.
راجع النطق بالأذن، بشكل متعمد. استمع للاختصارات التي تُقرأ ككلمات، والأسماء المنطوقة بشكل خاطئ، والكسور العشرية والنسب المئوية، والتواريخ والعملات، والمفردات المتخصصة، وعناوين URL والبريد الإلكتروني، والكلمات ذات النطق المتعدد، والعبارات الأجنبية. عندما يفشل شيء ما، أعد كتابة المصطلح صوتيًا وأعد توليد ذلك القسم فقط.
الحقوق والإفصاح والمخاطر التي تستحق الإدارة
الخطوات التقنية هي الجزء السهل. المخاطر التي تهدد القناة فعليًا تتعلق بالحقوق والشفافية والقيمة.
ابدأ بـحقوق الصوت والموافقة. لا تستنسخ أبدًا صوت مشهور أو عميل أو موظف أو ممثل صوتي أو أي شخص آخر دون إذن، واجعل تلك الموافقة تغطي كلًا من إنشاء النسخة المستنسخة وكيفية استخدامك لها، بما في ذلك النشر التجاري والإعلانات والتوطين وإعادة الاستخدام المستقبلية. نحن نعامل الموافقة والاستخدام المسؤول كجزء من نهجنا في استنساخ الصوت، لكن صفحاتنا العامة ليست خدمة تصريح قانوني، لذا احتفظ بسجلات الأذونات الخاصة بك وتحقق من القوانين والعقود التي تنطبق على مشروعك.
بخصوص الإفصاح، يتطلبه يوتيوب عندما يبدو المحتوى المُولّد أو المُعدّل بالذكاء الاصطناعي واقعيًا ويمكن أن يُضلل المشاهدين، مثل جعل شخص حقيقي يبدو وكأنه قال شيئًا لم يقله. يُدرج يوتيوب تحديدًا استنساخ صوتك الخاص للتعليقات الصوتية أو الدبلجات كمثال لا يتطلب الإفصاح، بينما قد يتطلبه الصوت الاصطناعي الواقعي الذي ينتحل شخصية شخص آخر. أثناء التحميل، تضبط هذا في YouTube Studio ضمن قسم Attributes باختيار نعم أو لا لاستخدام الذكاء الاصطناعي. وعندما تكون غير متأكد حقًا، فإن الإفصاح هو الخيار الأكثر أمانًا: ينص يوتيوب على أن الإفصاح نفسه لا يحد من الوصول أو أهلية الربح، بينما يمكن أن يؤدي الفشل المتكرر في الإفصاح إلى تسميات أو عقوبات، بما في ذلك الإزالة أو التعليق من برنامج الشركاء.
كما أن الذكاء الاصطناعي لا يعفيك من معيار الأصالة. استخدام صوت ذكاء اصطناعي لن يمنع تحقيق الدخل، لكن الفيديو النهائي لا يزال يحتاج إلى قيمة حقيقية من خلال البحث أو التعليق أو التعليم أو السرد القصصي أو التحرير أو التحليل. فالقناة المجمّعة من نصوص مُولّدة تلقائيًا، وسرد عام، ولقطات معاد استخدامها، وتحرير ضئيل، قد تبدو منخفضة القيمة حتى عندما يبدو الصوت مثاليًا. يجب أن يعزز الصوت فكرتك، لا أن يحل محل امتلاك فكرة.
أخيرًا، احمِ جودة الصوت والدقة الواقعية. سينطق صوت الذكاء الاصطناعي مصطلحًا بشكل خاطئ بثقة أو يقرأ نصًا غير دقيق دون تردد، لذا راجع كل ملف نهائي بحثًا عن الأخطاء الواقعية، والكلمات المفقودة، والتوكيد الخاطئ، والوقفات المحرجة، والقطع، وانحراف التوقيت، وأخطاء الترجمة في النسخ المدبلجة.
للحصول على نظرة جنبًا إلى جنب حول موضع كل طريقة، يربط هذا الإطار الأولويات بنقطة بداية.
| أولويتك | أفضل خيار للبدء |
|---|---|
| سرد سريع لقناة جديدة | صوت قياسي بالذكاء الاصطناعي |
| هوية مبدع متسقة | نسخة مستنسخة من صوتك الخاص |
| إصدارات بلغات متعددة | الدبلجة بالذكاء الاصطناعي أو تحويل النص إلى كلام متعدد اللغات |
| أقصى دقة بشرية | ممثل صوتي بشري |
| تغييرات متكررة في النص | صوت ذكاء اصطناعي أو نسخة صوت مستنسخة معتمدة |
| دروس تقنية | صوت واضح بإيقاع معتدل |
| ترفيه قصير الشكل | صوت معبّر مُختبَر بإيقاع أسرع |
| عمل مؤسسي أو عمل للعملاء | صوت بحقوق موثّقة وسجلات موافقة |
إذا كان هدفك الحقيقي هو ترجمة فيديو موجود بدلًا من كتابة قراءة إنجليزية جديدة، فابدأ بـالدبلجة بالذكاء الاصطناعي من DubSmart بدلًا من توليد السرد من الصفر.
الأسئلة الشائعة
هل يمكنني استخدام تعليق صوتي بالذكاء الاصطناعي على قناة يوتيوب محققة للدخل؟
نعم. استخدام الذكاء الاصطناعي وحده لا يمنع تحقيق الدخل. لا يزال على الفيديو أن يلبّي متطلبات تحقيق الدخل وإرشادات المجتمع والأصالة في يوتيوب.
هل يتطلب كل تعليق صوتي بالذكاء الاصطناعي إفصاحًا عن الذكاء الاصطناعي؟
لا. يتطلب يوتيوب الإفصاح عن المحتوى الواقعي المُولّد أو المُعدّل بالذكاء الاصطناعي الذي يمكن أن يُضلل المشاهدين، ويُدرج تحديدًا استنساخ صوتك الخاص للتعليقات الصوتية أو الدبلجات كمثال لا يتطلب الإفصاح.
هل يمكنني تحميل تعليق صوتي بالذكاء الاصطناعي كملف MP3 إلى يوتيوب؟
لا. يحتاج يوتيوب إلى تحميل فيديو، لذا ادمج التعليق الصوتي مع لقطات أو صورة أو رسوم متحركة أو مسار مرئي آخر قبل النشر.
ما مدة عينة استنساخ الصوت المطلوبة في DubSmart؟
تنشئ أداة استنساخ الصوت لدينا نسخة مستنسخة من عينة صوتية لا تقل عن 20 ثانية، ويجب أن يكون التسجيل نظيفًا وخاليًا من الضوضاء الخلفية.
هل يمكنني استخدام صوتي المستنسخ لمقاطع فيديو يوتيوب متعددة اللغات؟
نعم. يعمل الصوت المستنسخ مع تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي لدينا عبر 33 لغة. راجع كل نسخة مترجمة من حيث النطق والتوقيت والملاءمة الثقافية قبل النشر.