اختيار أفضل أصوات تحويل النص إلى كلام لليوتيوب يتعلق بمطابقة إعداد الصوت المناسب لمجال قناتك وخططك اللغوية وكيفية إنتاجك للفيديوهات فعليًا، أكثر من ملاحقة صوت "مثالي" واحد. على DubSmart AI، يتلخص هذا الخيار في أربعة خيارات عملية داخل مساحة عمل واحدة: مكتبتنا التي تضم أكثر من 300 صوت AI جاهز، وصوت تستنسخه من تسجيلاتك الخاصة، ونفس هذه الأصوات مطبّقة على الدبلجة متعددة اللغات، وأصوات مدعومة بواجهة برمجية (API) لخطوط الإنتاج المؤتمتة. كل خيار يحل مشكلة مختلفة، وعادةً ما يجمع الاختيار الأفضل بين اثنين منها مع نمو قناتك.
يستعرض هذا الدليل ما يبرع فيه كل إعداد صوتي، وأين يناسب، وأين يقصّر، حتى تتمكن من اتخاذ قرارك بثقة بدلًا من التخمين من ترتيب عام.
جدول المحتويات
كيف نختار أفضل أصوات تحويل النص إلى كلام لليوتيوب
نختار الأصوات وإعدادات الصوت التي تصمد على قناة يوتيوب حقيقية، وليس بناءً على تصنيفات سوق مجردة. خمسة معايير تشكّل كل اختيار أدناه.
الطبيعية تأتي أولًا، لأن معظم وقت المشاهدة يحدث على الهواتف بمستوى صوت متغير. يجب أن يبدو الصوت بشريًا وأن يظل واضحًا عبر الصوت المضغوط والضوضاء الخلفية أثناء التنقل. تأتي بعد ذلك تغطية اللغات واللهجات: الصوت مفيد للنمو فقط إذا كان بإمكانك نقله إلى مناطق جديدة دون إعادة تسجيل محتواك السابق. اتساق العلامة التجارية هو المرشّح الثالث، إذ يجب أن يكون نفس الصوت قابلاً لإعادة الاستخدام عبر كل من استوديو تحويل النص إلى كلام الخاص بنا والدبلجة، بما في ذلك صوت مستنسخ يبدو مثلك. ملاءمة سير العمل تقرر ما إذا كان الصوت عمليًا للتوليد والتحرير والتصدير ضمن جدول إنتاج حقيقي. وأخيرًا، تحدد إمكانية الأتمتة ما إذا كان بإمكان المطورين والوكالات استدعاء نفس الأصوات عبر واجهات برمجية للمخرجات ذات القوالب أو واسعة النطاق.
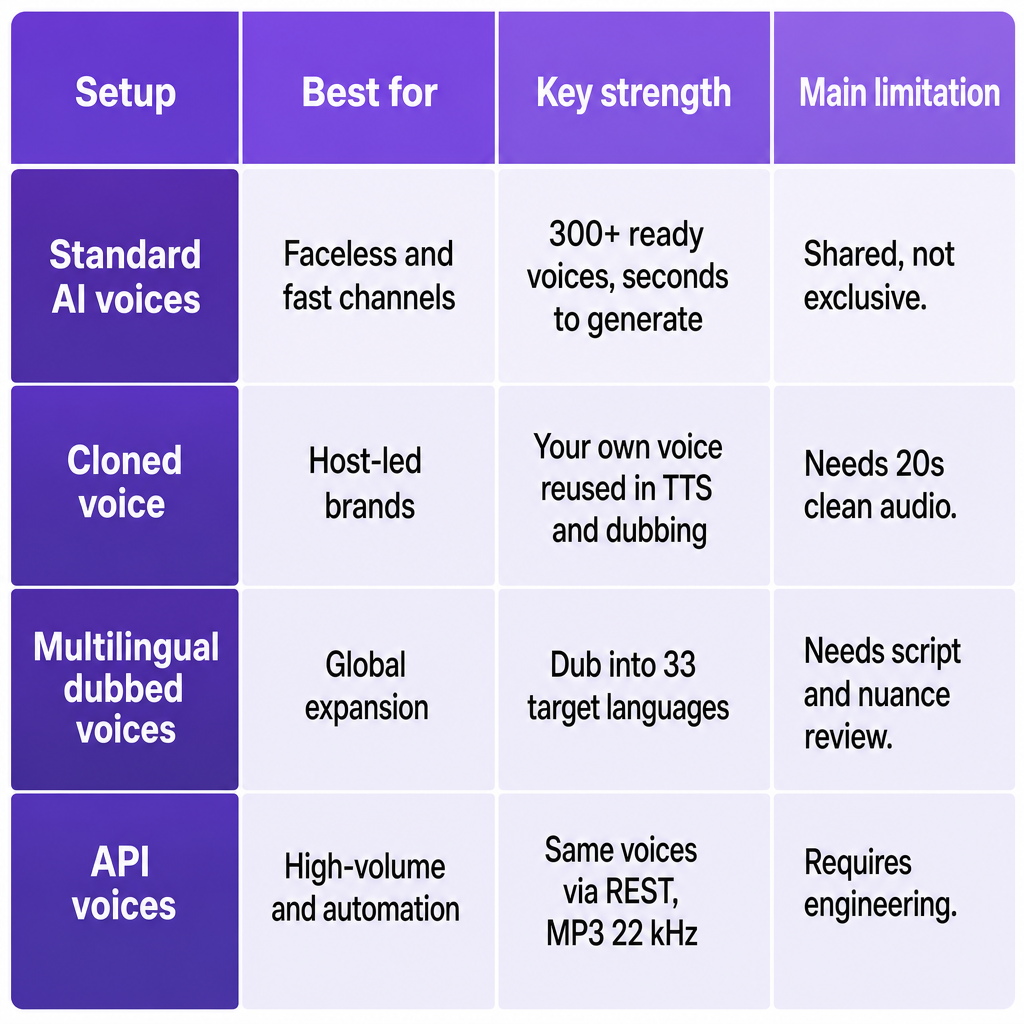
يحصل كل عنصر أدناه على قسم واحد يتناول ما يميزه، وأفضل ملاءمة له على يوتيوب، وقيوده الصادقة، مستمدة من كيفية عمل هذه الأدوات فعليًا داخل منصتنا.
مكتبة أصوات AI القياسية: سرد سريع وجاهز للنشر
أسرع طريق للحصول على تعليق صوتي جاهز هو محرك تحويل النص إلى كلام الخاص بنا: الصق نصًا بلغتك، واختر من بين أكثر من 300 صوت AI، وقم بالمعاينة، وولّد كلامًا واقعيًا في ثوانٍ. يمكنك اختيار متحدث، وضبط الإعدادات الأساسية، وتصدير صوت قياسي تُدخله مباشرة في عملية تحرير فيديو يوتيوب. ويُتاح نفس الكتالوج عبر واجهة TTS البرمجية الخاصة بنا، بحيث يوجد كل صوت جاهز في كل من استوديو الويب وسير العمل البرمجي.
يناسب هذا الإعداد القنوات بلا وجه والقنوات التعليقية التي تقدّر السرعة والاتساق على حساب شخصية واحدة مميزة. يناسب تحليلات الأخبار والقوائم والشروحات والعروض التقديمية التي تحتاج إلى سرد نظيف ضمن جدول ضيق، إضافة إلى قنوات التعلم الإلكتروني والشركات والتسويق التي تفضّل نبرة احترافية محايدة. يمكن لصانع المحتوى لصق نص واختيار صوت وتوليده وتنزيله لمحرر مثل Premiere أو Final Cut دون لمس معدات التسجيل. وبالنسبة للفرق التقنية، تُعيد واجهة تحويل النص إلى كلام البرمجية الخاصة بنا ملفات MP3 بدقة 22 كيلوهرتز بعد طلب بسيط يتضمن النص وتفضيلات الصوت، وهو ما يندرج بسلاسة في خطوط إنتاج الفيديو المعتمدة على القوالب أو البيانات. وإذا أردت الآليات الأعمق، فإن شرحنا حول كيفية عمل تحويل النص إلى كلام العصبي يغطي ما يحدث خلف كل عملية تصيير.
المقايضة هي الحصرية. الأصوات القياسية مشتركة بين المستخدمين، لذا قد ترغب القناة ذات العلامة التجارية القوية والمدفوعة بالشخصية في نهاية المطاف في شيء أكثر تميزًا. يمكنك ضبط اللغة والمتحدث وبعض المعايير، لكنك لن تحصل على التفاصيل الدقيقة لصوتك الخاص دون الاستنساخ. ولأن الكتالوج واسع، فإن العثور على الصوت الذي يطابق جمهورك حقًا لا يزال يتطلب بضع اختبارات استماع بدلًا من اختيار محظوظ واحد.
صوت صانع المحتوى المستنسخ: مُقدّم يمكن التعرف عليه على نطاق واسع
عندما يكون صوتك جزءًا من علامتك التجارية، يغيّر الاستنساخ المعادلة. يبني استنساخ الصوت الخاص بنا صوت AI مخصصًا من عينة قصيرة، ثم يجعل هذا الصوت قابلاً للاختيار في أي مكان تظهر فيه الأصوات القياسية، في كل من تحويل النص إلى كلام والدبلجة. تقوم برفع 20 ثانية على الأقل من الصوت النظيف دون ضوضاء خلفية، وينتج النظام نسخة قابلة لإعادة الاستخدام. نحن ندعم استنساخ أي عدد من الأصوات، لذا لا ترتبط العلامة التجارية بمُقدّم واحد: يمكنك استنساخ عدة متحدثين باسم العلامة أو أصوات شخصيات حسب الحاجة.
الصوت المستنسخ هو الخيار الأقوى للقنوات المدفوعة بالشخصية حيث يشترك المشاهدون من أجل شخص معين. كما يناسب صانعي المحتوى الذين يريدون الحفاظ على أصواتهم الخاصة مع أتمتة أجزاء من الإنتاج، مثل سرد اللقطات الإضافية، أو المسارات بلغات بديلة، أو المقاطع القصيرة المكتوبة. وهو العمود الفقري للقنوات متعددة اللغات التي تريد هوية متحدث متسقة واحدة عبر اللغات عند دمجه مع الدبلجة. وبمجرد الاستنساخ، يصبح صوتك خيارًا عاديًا في الاستوديو، جاهزًا للسرد المكتوب أو لإعادة التعليق الصوتي لفيديوهات كاملة إلى لغات أخرى مع الحفاظ على هويتك.
تعتمد الجودة على مصدر الصوت الخاص بك. تنتج العينة المليئة بالضوضاء أو الصدى نسخة أضعف وقد تُدخل تشوهات، لذا يسجّل العديد من صانعي المحتوى عينة نظيفة مخصصة بدلًا من إعادة استخدام صوت البث المباشر أو الفلوجات. وعبر اللغات، تتبع اللهجة والنبر نموذج التوليف، لذا قد لا يطابق النطق بشكل مثالي متحدثًا أصليًا في كل لغة مستهدفة. كما يضيف الاستنساخ خطوة إعداد قبل أول استخدام، مما يجعله الأفضل للقنوات الملتزمة بالاتساق طويل الأمد بدلًا من اختبار لمرة واحدة.
أصوات الدبلجة متعددة اللغات: تحويل قناة واحدة إلى قنوات عديدة
الطريق الأكثر مباشرة نحو قناة عالمية هو الدبلجة. مع الدبلجة بالذكاء الاصطناعي الخاصة بنا، ترفع فيديو وتترجمه وتعيد التعليق الصوتي عليه إلى أي من 33 لغة مستهدفة، ويمكنك اختياريًا تطبيق صوت مستنسخ على تلك المسارات المدبلجة. التفصيل الأساسي هو أن الدبلجة تعتمد على نفس كتالوج الأصوات والأصوات المستنسخة المستخدمة في تحويل النص إلى كلام، لذا فإن "أفضل" أصواتك للدبلجة هي ببساطة أصواتك المختارة المُهيأة للنصوص المترجمة. ولأن مساحة العمل تضم أيضًا تحويل الكلام إلى نص، وفاصل الكلام، وأدوات الصور والفيديو، فإنك تتجنب تجميع موردين منفصلين للنسخ والترجمة والتعليق الصوتي والمرئيات.
يناسب هذا القنوات الناجحة بالفعل بلغة واحدة والمستعدة للتوسع دون إعادة التصوير. تبرر الدروس التعليمية ومراجعات المنتجات والأفلام الوثائقية والمحتوى الطويل ذو قيمة إعادة المشاهدة العالية هذا الجهد، وكذلك الشركات ومزودو التعلم الإلكتروني وفرق التسويق التي تحتاج إلى سرد متسق يحمل العلامة التجارية عبر المناطق. يمكنك البدء من فيديوهات موجودة، وتوليد نصوص مترجمة، وتطبيق إما صوت قياسي أو صوتك المستنسخ على الصوت المدبلج، لإنشاء نسخ محلية من قناتك تحتفظ بنفس الشخصية. والاحتفاظ بتحويل النص إلى كلام والدبلجة في مساحة عمل واحدة يسهّل مواءمة أسلوب السرد بين النسخة الأصلية والنسخ المترجمة. وإذا كنت توازن بين صيغ التوطين، فإن تحليلنا لـالدبلجة مقابل الترجمة النصية يساعد في تأطير القرار.
تضيف الدبلجة عملاً لا يتطلبه السرد بلغة واحدة. حتى مع الترجمة والتوليف القويين، لا تزال بحاجة إلى مراجعة النصوص بحثًا عن الفروق الثقافية الدقيقة، وتكييف الأمثلة، وتأكيد أن أسلوب الصوت يناسب الجمهور المستهدف. كما تستهلك المزيد من الأرصدة وإدارة التصدير أكثر من مقطع لمرة واحدة. تحافظ الأصوات المستنسخة على الهوية، لكن قد لا تطابق مزامنة الشفاه والتوقيت بشكل مثالي المرئيات الأصلية في المحتوى سريع الحديث أو المتحرك بكثافة، لذا توقّع بعض التعديلات اليدوية في محرر الفيديو الخاص بك.
الأصوات المدعومة بواجهة برمجية: إنتاج مؤتمت بكميات كبيرة
بالنسبة للفرق التي تنتج بكميات كبيرة، تتوفر نفس الأصوات برمجيًا عبر ثلاث نقاط نهاية. تحوّل واجهة تحويل النص إلى كلام البرمجية الخاصة بنا النص إلى كلام طبيعي باستخدام مجموعة الأصوات الكاملة التي تضم أكثر من 300 صوت وتعيد ملفات MP3 قابلة للتنزيل بدقة 22 كيلوهرتز عند اكتمال المعالجة. تتيح لك واجهة استنساخ الصوت البرمجية الخاصة بنا رفع العينات وإنشاء أصوات مخصصة قابلة للاستخدام في TTS أو الدبلجة. وتتيح واجهة الدبلجة بالذكاء الاصطناعي البرمجية الخاصة بنا للمطورين والوكالات ترجمة الفيديوهات ودبلجتها برمجيًا، ودمج هذه الإمكانيات مباشرة في خطوط إنتاج المحتوى أو في نظام إدارة المحتوى (CMS).
يناسب هذا الإعداد القنوات التي تنتج العديد من الفيديوهات المتشابهة، مثل ملخصات الأخبار المتكررة، أو الملخصات المدفوعة بالبيانات، أو الشروحات ذات القوالب حيث تُولّد النصوص أو تُملأ من بيانات منظمة. يناسب الوكالات التي تدير قنوات عملاء متعددة وتحتاج إلى سير عمل صوتي مؤتمت قابل للتكرار، والمنتجات البرمجية التي تقدّم ميزات النشر التلقائي التي تحتاج إلى تعليقات صوتية عالية الجودة على نطاق واسع. ولأن الأصوات المستنسخة يمكن الإشارة إليها بالمعرّف إلى جانب الأصوات القياسية، فإن الأتمتة لا تكلفك اتساق العلامة التجارية: كل عملية تصيير تستخدم نفس الصوت المقصود عبر الفيديوهات والقنوات.
التكلفة هي الهندسة. تتطلب سير عمل الواجهات البرمجية الإلمام بخدمات RESTful إضافة إلى بنية تحتية لتخزين الصوت ومعالجته لاحقًا وربطه بأصول الفيديو. وعادةً لن يستفيد صانعو المحتوى الأصغر الذين يعملون بالكامل في محرر الويب حتى يصلوا إلى نطاق ذي معنى. كما تحتاج خطوط الإنتاج المؤتمتة إلى ضمانات حول جودة النصوص والتوقيت والامتثال، لأن المدخلات الضعيفة لا تزال تنتج مخرجات ضعيفة مهما كان الصوت جيدًا.
كيف تختار إعداد الصوت المناسب لقناتك
أربعة أسئلة تحسم معظم القرارات. أجب عليها بالترتيب وستقع مجموعة أصواتك في مكانها الصحيح.
الجمهور والصيغة. إذا كانت قناتك بلا وجه أو إخبارية أو مدفوعة بالقوائم، فابدأ بالأصوات القياسية للذكاء الاصطناعي لإنجاز سريع واختبار سهل للنبرة. إذا كان المشاهدون يشتركون بسببك تحديدًا، فاستثمر في استنساخ صوتك واستخدامه عبر كل من تحويل النص إلى كلام والدبلجة.
استراتيجية اللغة. إذا كنت تنشر بلغة واحدة، فابحث عن صوت أو صوتين يطابقان نبرتك والتزم بهما للحفاظ على الاتساق. إذا كنت تخطط للانتشار عالميًا، فصمم حول الدبلجة: اختر صوتًا مستنسخًا أساسيًا واربطه بالمسارات المدبلجة عبر ما يصل إلى 33 لغة مستهدفة.
حجم الإنتاج. بالنسبة للتحميلات الأسبوعية أو السلاسل العرضية، فإن أدوات تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي المعتمدة على الويب كافية. أما بالنسبة للمحتوى الكبير الحجم أو المدفوع بالبيانات، فخطط لسير عمل يعتمد على الواجهة البرمجية أولاً حيث تُطلق النصوص والأصول الجديدة توليد الصوت تلقائيًا.
التحكم بالعلامة التجارية والمخاطر. استخدم الأصوات القياسية للتجارب منخفضة المخاطر والقنوات التي لا تكون فيها هوية الصوت محورية. استخدم الأصوات المستنسخة مع قواعد داخلية واضحة حول من يمكنه إطلاقها وأين يمكن أن تظهر، وهو أمر مهم للغاية للقنوات المؤسسية أو ذات العلامة التجارية.
مطابقة أصواتك لتوقعات الجمهور والخطط اللغوية وسير العمل هي الطريقة التي تتجنب بها الإخفاقات الشائعة: السرد غير المتسق، والتغييرات المفاجئة للصوت بين الفيديوهات، وخطوط الإنتاج المفرطة الهندسة التي يصعب صيانتها. المسار العملي هو اختبار بضعة أصوات قياسية أولاً، وإضافة صوت مستنسخ بمجرد أن تصبح هويتك مهمة، وإدخال الواجهات البرمجية والدبلجة متعددة اللغات عندما تتجاوز عمليتك التصيير اليدوي.
الأسئلة الشائعة
هل يمكنني استخدام أصوات DubSmart للذكاء الاصطناعي في فيديوهات يوتيوب الخاصة بي؟
بُنيت أدوات تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي الخاصة بنا لصانعي المحتوى والشركات لإنتاج تعليقات صوتية للمحتوى العام، بما في ذلك يوتيوب، ضمن نموذج استخدام قائم على الأرصدة. تبقى مسؤولاً عن اتباع شروط يوتيوب وسياسات الإعلانات واللوائح المحلية، لكن منصتنا مصممة للاستخدام الإعلامي التجاري.
كم من الصوت أحتاج لاستنساخ صوتي؟
تحتاج إلى 20 ثانية على الأقل من الكلام النظيف دون ضوضاء خلفية لإنشاء صوت مستنسخ قابل للاستخدام. وكلما كان التسجيل أنظف، كانت النتيجة أكثر دقة وطبيعية، لذا فإن عينة هادئة مخصصة تتفوق على صوت ضوضائي معاد استخدامه.
هل سيعمل صوتي المستنسخ بعدة لغات؟
نعم. الصوت المستنسخ قابل للاستخدام في كل من تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي، اللتين تدعمان العديد من اللغات و33 لغة مستهدفة للدبلجة. تحافظ على نفس هوية الصوت عبر النصوص بلغات مختلفة، رغم أن النطق واللهجة يتبعان نموذج التوليف بدلاً من الكلام البشري الأصلي في كل حالة.
هل يمكنني التبديل من الأصوات القياسية إلى صوت مستنسخ لاحقًا؟
نعم. نحن نتعامل مع الأصوات المستنسخة كأصوات قابلة لإعادة الاستخدام في نفس الكتالوج مع الأصوات القياسية للذكاء الاصطناعي، لذا يمكنك البدء بالأصوات القياسية ثم تبديل المشاريع لاحقًا إلى صوت مستنسخ باستخدام نفس واجهات تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي أو الواجهات البرمجية، دون إعادة بناء سير عملك.
كيف تساعد الواجهات البرمجية في إنتاج يوتيوب؟
تتيح لك واجهات تحويل النص إلى كلام واستنساخ الصوت والدبلجة بالذكاء الاصطناعي البرمجية الخاصة بنا تحويل النصوص إلى كلام، واستنساخ الأصوات، ودبلجة الفيديوهات عبر نقاط نهاية RESTful. وهذا يجعل من العملي أتمتة الصيغ المتكررة، وإدخال التعليقات الصوتية في نظام إدارة محتوى أو خط إنتاج تحرير موجود، والتوسع عبر العديد من القنوات أو اللغات دون إطلاق كل عملية تصيير يدويًا.