يكتمل التعليق الصوتي بالذكاء الاصطناعي لمقاطع الفيديو التدريبية عندما تجمع بين نص مكتوب ومحرك صوت يعمل بالذكاء الاصطناعي، مع خيار استنساخ صوت مدربك، وإنشاء سرد بلغة واحدة أو أكثر من منصة واحدة. هذه هي الإجابة المختصرة عن كيفية إنشاء تعليق صوتي بالذكاء الاصطناعي لمقاطع الفيديو التدريبية، وهي صحيحة سواء كنت تنتج مقطعًا تعريفيًا مدته دقيقتان أو توطّن مكتبة امتثال كاملة. السؤال الأكبر هو أي سير عمل يناسب محتواك وجمهورك ومدى تكرار تحديثك للمواد.
مع DubSmart AI، تبدأ فرق التدريب عادةً من إحدى نقطتين. فإما أن تنشئ سردًا جديدًا من النص، أو تحمّل مقاطع فيديو موجودة وتترك المنصة تدبلجها من البداية إلى النهاية عبر التعامل مع النسخ والترجمة وإنشاء الصوت. كلا المسارين موجودان ضمن سير عمل واحد قائم على الأرصدة، لذا نادرًا ما تحتاج إلى تطبيق نسخ منفصل أو خدمة ترجمة أو أداة صوت لإنهاء دورة.
جدول المحتويات
ما القرار الذي تتخذه فعليًا؟
الخيار الحقيقي ليس مجرد أي زر تضغط عليه. إنه نوع سير عمل التعليق الصوتي الذي يناسب محتواك التدريبي والأشخاص الذين يشاهدونه. مع DubSmart AI، ينقسم هذا القرار عادةً إلى ثلاث فئات، ويشكّل كل منها مدى اتساق تجربة المتعلم لديك ومدى سرعتك في مراجعة الدورات لاحقًا.
- استخدم رواة الذكاء الاصطناعي القياسيين من مكتبة تضم أكثر من 300 صوت طبيعي عبر أكثر من 33 لغة عندما تحتاج ببساطة إلى سرد تدريبي سريع واحترافي.
- استنسخ صوت مدرب معين أو صوت العلامة التجارية حتى يسمع المتعلمون متحدثًا مألوفًا، حتى عندما تُوطَّن الدورات إلى عدة لغات.
- أتمتة إنتاج التعليق الصوتي من خلال واجهات برمجة التطبيقات الخاصة بنا عندما تحتاج إلى نقل نص الدورة من نظام إدارة تعلم أو تطبيق مباشرة إلى إنشاء الصوت على نطاق واسع.
يؤثر كل مسار على ثلاثة أشياء في وقت واحد: مدى تجانس صوت تجربة المتعلم، ومدى سرعتك في دفع التحديثات، ومدى سهولة توسّعك في التدريب متعدد اللغات دون إعادة تسجيل كل شيء. الفريق الذي ينتج خمس دورات مصقولة في السنة سيوازن هذه الأمور بشكل مختلف عن فريق يصون بضع مئات من الوحدات القائمة على الأدوار، لذا من المفيد تحديد حجمك وإيقاع تحديثاتك قبل اختيار أداة.
كيف ينشئ DubSmart AI التعليقات الصوتية لمقاطع الفيديو التدريبية
DubSmart هي منصة شاملة لإنشاء الوسائط وتوطينها بالذكاء الاصطناعي، تدمج تحويل النص إلى كلام واستنساخ الصوت والدبلجة بالذكاء الاصطناعي وتحويل الكلام إلى نص وفاصل الكلام وتحويل النص إلى صورة وتحويل الصورة إلى فيديو ضمن سير عمل واحد قائم على الأرصدة. بالنسبة لفرق التدريب، هذا الدمج هو المقصود: يمكنك الانتقال من نص خام إلى فيديو تدريبي منتهٍ وموطَّن دون تبديل الموردين في منتصف الطريق.
سرد تحويل النص إلى كلام من نصك
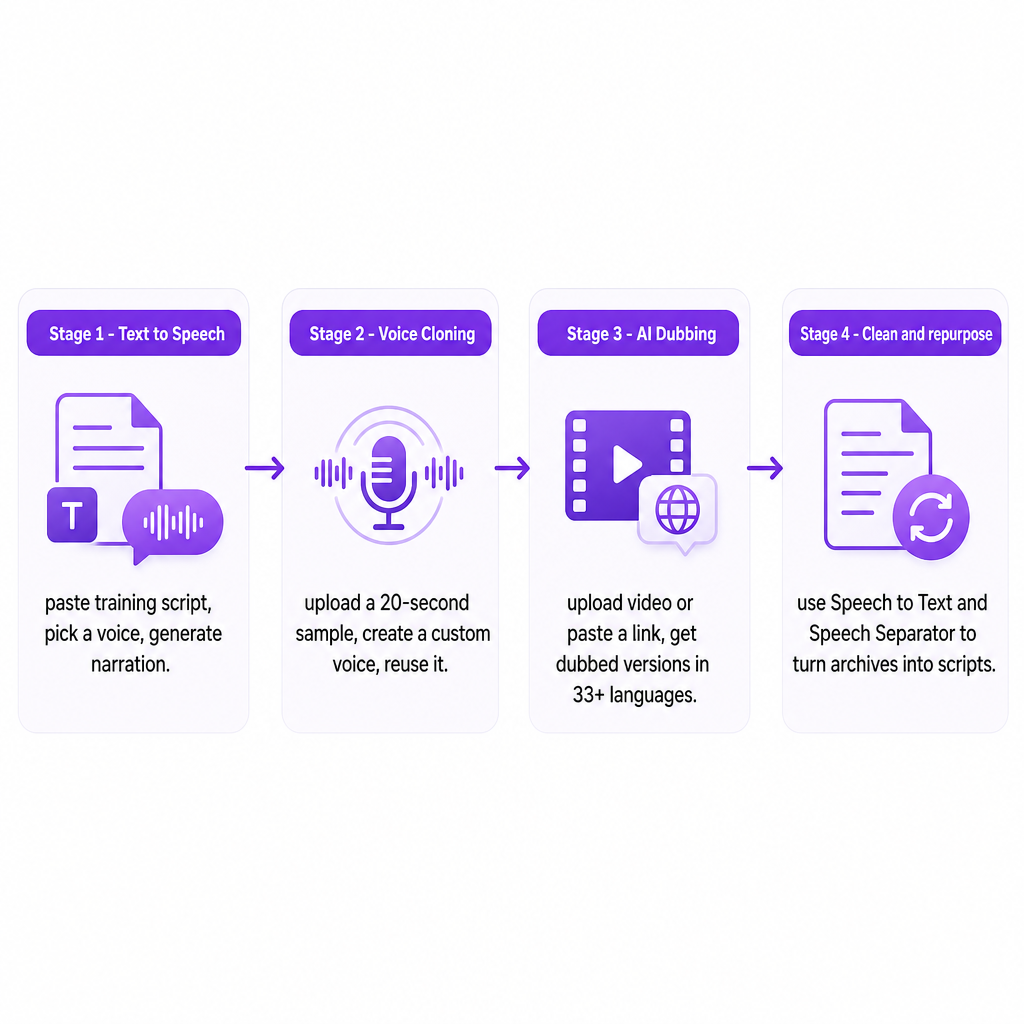
بالنسبة لمعظم الدورات، تكون نقطة البداية نصًا: وحدات تعريفية، أو إجراءات سلامة، أو شروحات امتثال، أو جولات إرشادية للبرامج. تحوّل أداة تحويل النص إلى كلام لدينا ذلك النص إلى كلام طبيعي شبيه بالبشر بأي لغة مدعومة. داخل تطبيق الويب، يظل التدفق سهل الوصول للمبدعين غير التقنيين. تفتح الأداة، وتلصق نصك أو تكتبه، وتختار متحدثًا من مكتبة الأصوات، وتُنشئ الصوت. وبمجرد أن يبدو صحيحًا، يمكنك إضافة أو تغيير المتحدثين، ومراجعة المقاطع الفردية، وتنزيل الملف المنتهي بالتنسيق الذي تفضله لإدراجه في محرر الفيديو الخاص بك.
يمكن للفرق التي لديها منصة تعلم أو تطبيق مخصص الوصول إلى القدرة نفسها من خلال واجهة برمجة تطبيقات تحويل النص إلى كلام لدينا. ترسل طلبًا مع نص الدورة وتفضيلات الصوت، وتعيد واجهة برمجة التطبيقات صوتًا عالي الجودة يمكنك إرفاقه برمجيًا بالدروس أو المحتوى المُنشأ ديناميكيًا.
استنساخ صوت مدربك أو صوت علامتك التجارية
عندما تريد أن يبدو التدريب وكأنه صوت شخص معين، يبني استنساخ الصوت نموذجًا اصطناعيًا لذلك الصوت بحيث يمكن إنشاء كلام جديد من النص بالنبرة نفسها. يختلف هذا عن تحويل النص إلى كلام العام، حيث تختار من رواة جاهزين بدلًا من تقديم متحدثك الخاص. في المسار الملائم للمبدعين، تجمع عينة قصيرة نظيفة، عادةً ما لا يقل عن 20 ثانية، وتحمّلها إلى قسم استنساخ الصوت. يحوّلها النظام إلى صوت مخصص مسمّى يظهر بعد ذلك داخل مشاريع تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي. ومن هناك تلصق النصوص وتجعلها تُقرأ بالصوت المستنسخ للمقدمات أو الشروحات المفصلة أو مقاطع الامتثال، دون إعادة إحضار المدرب لكل تحديث. وإذا كنت تريد الآليات الأساسية، فإن شرحنا حول كيفية إعادة الذكاء الاصطناعي لإنشاء أي صوت يتناول النموذج بعبارات واضحة.
يمكن للمطورين والوكالات إضفاء الطابع الرسمي على ذلك من خلال واجهة برمجة تطبيقات استنساخ الصوت كنمط من ثلاث خطوات. أولًا، اطلب عنوان URL موقّعًا مسبقًا وحمّل ملفًا صوتيًا بتنسيق مدعوم مثل MP3 أو WAV أو AAC أو M4A أو FLAC. ثانيًا، أنشئ صوتًا مخصصًا بإرسال اسم ومفتاح الملف من ذلك التحميل. ثالثًا، أشر إلى معرّف الصوت المستنسخ داخل مشاريع تحويل النص إلى كلام أو الدبلجة بالذكاء الاصطناعي بحيث يستخدم أي نص أو فيديو تدريبي ذلك الصوت تلقائيًا.
الدبلجة متعددة اللغات للجماهير العالمية
عندما يكون لديك بالفعل جولات إرشادية مسجلة، أو جلسات بقيادة مدرب، أو عروض تقديمية حية، فإن دبلجتها مباشرة غالبًا ما تتفوق على إعادة البناء من الصفر. صُممت واجهة برمجة تطبيقات الدبلجة بالذكاء الاصطناعي وأداة الويب لدينا لسير عمل الكلام إلى كلام: تحمّل ملف فيديو أو صوت مصدرًا، أو تلصق رابطًا، وتتلقى نسخًا مدبلجة بلغاتك المستهدفة بينما تتعامل المنصة مع النسخ والترجمة وإنشاء الصوت. يمكنك إضافة متحدثين، وضبط التوقيتات، وتحرير مقاطع النص المُنشأة بحيث تتطابق المصطلحات والإيقاع مع معايير التدريب لديك قبل التنزيل. ولأن الدبلجة تعمل عبر أكثر من 33 لغة وتتكامل مع استنساخ الصوت، يمكنك الاحتفاظ بصوت المدرب نفسه لكل منطقة أو تبديل الرواة حيثما يكون ذلك منطقيًا، كل ذلك من حساب واحد. وبالنسبة للكتالوجات الكبيرة، تعكس واجهة برمجة التطبيقات هذا التدفق برمجيًا وتعيد مسارات صوتية مدبلجة يمكنك إدراجها في خط نشر موجود.
تنظيف الصوت الموجود وإعادة توظيفه
تمتلك العديد من المؤسسات بالفعل مكتبات من الندوات وورش العمل المسجلة التي يمكن أن تصبح وحدات منظمة. ولأن DubSmart يتضمن تحويل الكلام إلى نص وفاصل الكلام إلى جانب الاستنساخ والدبلجة، يمكن تحويل تلك الأرشيفات إلى أصول قابلة لإعادة الاستخدام. يحوّل تحويل الكلام إلى نص المحتوى المنطوق إلى نصوص يمكنك تحريرها لتصبح نصوصًا نظيفة، ويساعد فاصل الكلام في عزل الأصوات من الصوت المختلط بحيث تحصل على عينات أنظف للاستنساخ أو مدخلات أفضل للنسخ. هذا المزيج يقلل من إعادة التسجيل ويتيح لك تحديث المحتوى القديم بسرد متسق.
معايير القرار الرئيسية لفرق التدريب والتعلم الإلكتروني
بمجرد أن تفهم الآليات، يتلخص الخيار في عدد قليل من العوامل العملية. يربط الجدول أدناه الأولويات الشائعة بالمسار الذي يميل إلى أن يناسبها، وتضيف الملاحظات التي تليه الفروق الدقيقة التي لا يمكن للجدول احتواؤها.
| الأولوية | المسار الأنسب | لماذا يناسب |
|---|---|---|
| صوت مدرب معروف | استنساخ الصوت | إعادة استخدام صوت مستنسخ واحد عبر سير عمل تحويل النص إلى كلام والدبلجة وواجهة برمجة التطبيقات |
| السرعة على حساب الهوية | أصوات تحويل النص إلى كلام الجاهزة | أكثر من 300 نمط جاهز دون إعداد |
| كتالوجات كبيرة أو يتم تحديثها بشكل متكرر | واجهات برمجة تطبيقات تحويل النص إلى كلام أو الدبلجة | أتمتة الإنشاء في تدفقات النشر |
| قوى عاملة عالمية | الدبلجة بالذكاء الاصطناعي + الاستنساخ | الدبلجة إلى أكثر من 33 لغة مع الحفاظ على الإحساس الأصلي |
| محتوى تقني أو خاضع للتنظيم | مشاريع دبلجة قابلة للتحرير | مراجعة المصطلحات قبل الإنهاء |
غالبًا ما يكون اتساق تجربة المتعلم هو العامل الحاسم. إذا كانت استراتيجيتك تعتمد على مدرب معروف أو صوت شركة، فإن الاستنساخ يحافظ على تلك الهوية سليمة عبر الوحدات واللغات، ويمكن أن يظهر الصوت المستنسخ نفسه في دورات أُنشئت بفارق أشهر. وإذا كانت السرعة أهم من هوية واحدة، فإن أكثر من 300 صوت جاهز يتيح لك مطابقة النبرة مع نوع المحتوى، على سبيل المثال صوت أكثر ثباتًا للامتثال وصوت أخف للتعريف.
يدفع الحجم وتكرار التحديث الحساب نحو الأتمتة. يمكن لفريق ينتج حفنة من الدورات أن يعمل بشكل مريح في تطبيق الويب، وينشئ التعليقات الصوتية ويقوم بالدبلجة حسب الحاجة. تستفيد المؤسسات التي تصون كتالوجات كبيرة أو تنويعات قائمة على الأدوار من واجهات برمجة التطبيقات، التي تحوّل النص أو الفيديو إلى صوت تلقائيًا داخل سير عمل نشر مجدول. وإذا كنت تتوقع تغييرات متكررة في السياسات أو تحديثات برمجية، فإن تحويل النص إلى كلام القائم على النص والدبلجة يتيحان لك إعادة إنشاء السرد بسرعة دون حجز وقت في الاستوديو.
تُعد تغطية اللغة الأكثر أهمية للشركات التي مقرها الولايات المتحدة والتي تدرّب فرقًا عالمية. يدعم DubSmart الدبلجة من أكثر من 60 لغة مصدر إلى ما لا يقل عن 33 لغة مستهدفة، مقترنة بالاستنساخ وتحويل النص إلى كلام، بحيث يمكن أن تتلقى كل منطقة محتوى بلغتها الأساسية مع الاحتفاظ بمظهر وإحساس النسخة الأصلية. أما بالنسبة للاحتياجات الأخف، مثل الإنجليزية الأمريكية مع وحدات إسبانية عرضية، فقد تكون أصوات تحويل النص إلى كلام الجاهزة كافية وتقلل من عمل الإعداد.
يستحق المحتوى التقني والتنظيمي عناية إضافية. يجب نطق المصطلحات المتخصصة وأسماء المنتجات والصياغة القانونية وترجمتها بشكل صحيح، لذا فإن القدرة على مراجعة وتحرير النصوص والمقاطع المُنشأة في مشاريع الدبلجة تمنح خبراء الموضوع تحكمًا حقيقيًا. عند استخدام واجهات برمجة التطبيقات، يمكنك ترميز المصطلحات المفضلة في نصوصك أو منطق المعالجة المسبقة بحيث يكون ما تتلقاه أداة تحويل النص إلى كلام أو الدبلجة قد تم التحقق منه بالفعل.
تُختتم القائمة بالبيانات والموافقة والحوكمة. يتطلب الاستنساخ عينات كلام من المتحدث المستهدف، لذا احرص على الموافقة الآمنة ووثّق كيفية استخدام الصوت المستنسخ. ولأن عملية الاستنساخ لدينا تقبل تسجيلات قصيرة ونظيفة، فإنك تجمع بيانات أقل مع الاستمرار في إنتاج نموذج قابل للاستخدام. كما أن مركزية الاستنساخ وتحويل النص إلى كلام والدبلجة في منصة واحدة تبسّط سجلات التدقيق مقارنة بالتلاعب بأدوات منفصلة، ويتيح النموذج القائم على الأرصدة مع واجهات برمجة التطبيقات لقادة التدريب التحكم في الاستخدام من بنية حساب واحدة.
المخاطر والضمانات عند استخدام التعليقات الصوتية بالذكاء الاصطناعي في التدريب
السرد بالذكاء الاصطناعي سريع، لكن هناك بعض أنماط الفشل التي تستحق الانتباه قبل التوسع.
عدم التوافق مع العلامة التجارية أو الأسلوب التعليمي هو الأكثر شيوعًا. يمكن إنشاء أصوات الذكاء الاصطناعي، بما في ذلك المستنسخة، بسرعات وشدات مختلفة قد لا تتطابق مع أسلوب مؤسستك. استمع إلى نماذج المخرجات، واضبط معلمات الأداء حيثما كانت متاحة، ووحّد اختيارات الصوت لكل نوع دورة قبل الطرح على نطاق واسع.
تأتي الفروق الدقيقة في النطق والترجمة بعد ذلك. يمكن أن يتعثر السرد الآلي في الأسماء أو المصطلحات المتخصصة، ويمكن أن تنتج الترجمة الآلية صياغة دقيقة ولكنها غير سلسة تعليميًا. تساعد القدرة على تحرير مقاطع النص في مشاريع الدبلجة وإعادة إنشاء الصوت، لكنها لا تحل محل المراجعة البشرية لوحدات الامتثال أو السلامة الحرجة.
الاعتماد المفرط على الأتمتة خطر أكثر دقة. بالنسبة للمواضيع الحساسة مثل السلوك في مكان العمل، أو الصحة النفسية، أو الالتزامات القانونية، يمكن أن تتسلل أخطاء في النبرة حتى عندما تكون الحقائق صحيحة. اقتران التعليقات الصوتية بالذكاء الاصطناعي بمراجعة بشرية، وأحيانًا مقطع مسجل بشريًا للرسائل الأكثر أهمية، يميل إلى تحقيق توازن أفضل.
تكتمل هذه القائمة بإدارة الأصوات المستنسخة بمسؤولية. الصوت المستنسخ أصل قابل لإعادة الاستخدام، مما يثير أسئلة حول النطاق ودورة الحياة. ضع سياسات داخلية بشأن من يمكنه تشغيل الإنشاء بصوت معين، ومدة الاحتفاظ بالعينات، وكيفية إلغاء الوصول إذا غادر مدرب. تحافظ هذه الضوابط على أخلاقية التكنولوجيا وقابليتها للتنبؤ.
إذا كنت توازن أين يناسب السرد بالذكاء الاصطناعي وأين يجب أن يبقى الإنسان في الحلقة، فابدأ بتحديد حجم دورتك ولغاتها ومدى تكرار تغيّر المحتوى. أخبرنا بتلك التفاصيل ويمكننا مساعدتك في رسم المزيج الصحيح من تحويل النص إلى كلام واستنساخ الصوت والدبلجة لبرنامجك.
الأسئلة الشائعة
هل يمكنني الاحتفاظ بصوت مدربي وتوطين الدورات إلى لغات متعددة في الوقت نفسه؟
نعم. يمكنك استنساخ صوت مدربك ثم استخدام ذلك الصوت المستنسخ في مشاريع تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي، بما في ذلك النسخ المدبلجة بلغات أخرى.
كم من الصوت أحتاج لاستنساخ صوت للسرد التدريبي؟
يعمل الاستنساخ من عينات قصيرة ونظيفة، عادةً ما لا يقل عن 20 ثانية من الكلام. يستخدم العديد من المبدعين من 20 إلى 60 ثانية للحصول على نموذج أكثر قوة.
ما تنسيقات الصوت التي يمكنني استخدامها عند تحميل عينات لاستنساخ الصوت؟
تقبل واجهة برمجة تطبيقات استنساخ الصوت التنسيقات الشائعة مثل MP3 وWAV وAAC وM4A وFLAC، المحمّلة عبر عنوان URL موقّع مسبقًا قبل أن تصبح العينة صوت ذكاء اصطناعي مخصصًا.
هل يمكن للمطورين أتمتة التعليقات الصوتية من محتوى نظام إدارة التعلم أو التطبيق؟
نعم. تتيح واجهة برمجة تطبيقات تحويل النص إلى كلام وواجهة برمجة تطبيقات الدبلجة بالذكاء الاصطناعي للأنظمة الخلفية إرسال نص أو فيديو تدريبي وتلقي صوت جاهز للاستخدام أو مسارات مدبلجة لتدفقات النشر الآلية.
هل DubSmart مناسب للتدريب على الامتثال والتنظيم؟
يدعم مزيجنا من تحويل النص إلى كلام واستنساخ الصوت والدبلجة بالذكاء الاصطناعي وأدوات التحرير سير عمل منظمًا وقابلًا للتكرار، لكن يجب على الفرق مع ذلك تطبيق المراجعة البشرية والحوكمة للمواضيع الحساسة أو الخاضعة للتنظيم.