أسرع طريقة لدمج واجهة برمجة تطبيقات تحويل النص إلى كلام هي التعامل معها كخدمة REST: قم بالمصادقة باستخدام مفتاح API، وأرسل النص الخاص بك بالإضافة إلى إعدادات الصوت بصيغة JSON، ودع الخدمة تُنتج الكلام في الخلفية، ثم قم بجلب وتخزين ملفات الصوت الناتجة للتشغيل أينما احتاج مستخدموك إليها. تتبع واجهة برمجة تطبيقات تحويل النص إلى كلام الخاصة بنا هذا النمط بالضبط مع توفير أكثر من 300 صوت طبيعي واستنساخ صوتي غير محدود، حتى تتمكن من إضافة كلام واقعي إلى المواقع الإلكترونية والتطبيقات وخطوط إنتاج الفيديو ومنصات التعلم. يشرح هذا الدليل ما تقوم بربطه فعليًا، وكيف يعمل محركنا، والقرارات التي تحدد ما إذا كان الدمج يناسب منتجك.
جدول المحتويات
ما الذي تفعله واجهة برمجة تطبيقات تحويل النص إلى كلام في DubSmart
تحوّل واجهة برمجة تطبيقات تحويل النص إلى كلام النص المنظم إلى صوت منطوق عند الطلب، بحيث يمكن لشيفرتك طلب السرد أو الحوار في اللحظة التي يصبح فيها النص جاهزًا بدلاً من انتظار التسجيل اليدوي. يشغّل محرك تحويل النص إلى كلام الخاص بنا كلاً من أداة تحويل النص إلى كلام المستندة إلى المتصفح وواجهة برمجة التطبيقات، مما يتيح الوصول إلى أكثر من 300 صوت بالذكاء الاصطناعي عبر لغات وأجناس وأنماط مختلفة، مع نبرة مضبوطة للسرد والشرح والحوار.
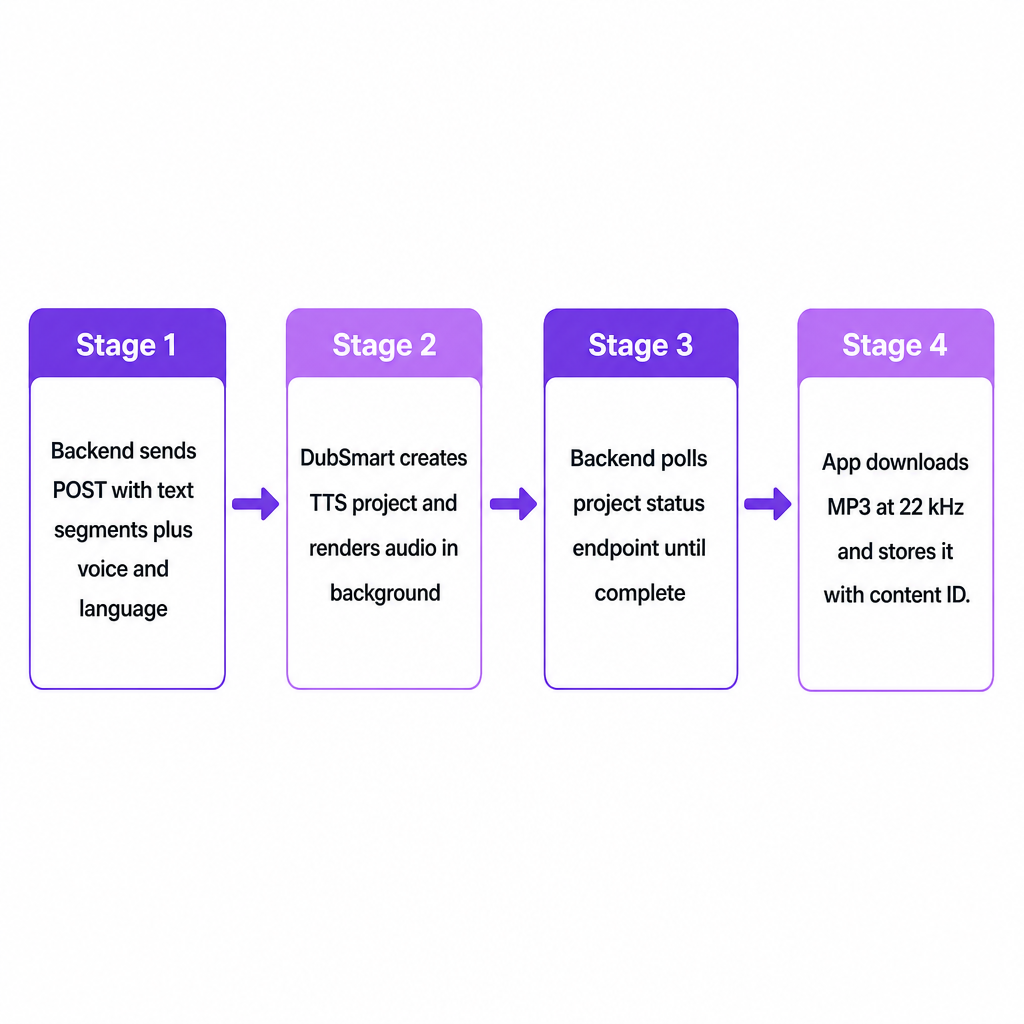
في طبقة واجهة برمجة التطبيقات، نعرض هذا المحرك كخدمة RESTful: تُرسل الواجهة الخلفية الخاصة بك طلب POST يحتوي على مقاطع نصية ومعاملات صوتية، وتُرجع الخدمة كائن مشروع يمكنك استطلاع حالته حتى يصبح الصوت جاهزًا للتنزيل. يُسلَّم الناتج كملفات صوتية عالية الجودة، عادةً بصيغة MP3 بتردد 22 كيلوهرتز، مناسبة للاستخدام المباشر في برامج تحرير الفيديو أو سير عمل البودكاست أو مشغلات الويب دون تحويل إضافي.
بالنسبة للمبدعين والفرق الذين نخدمهم—صانعي محتوى يوتيوب، والشركات الصغيرة، ومنتجي التعليم الإلكتروني، وصانعي الأفلام، ووكالات المطورين—تربط واجهة برمجة التطبيقات بين تخطيط المحتوى ونشره. بمجرد وصول النص إلى نظام إدارة المحتوى أو منصة التعلم، يمكن للواجهة الخلفية إنشاء التعليقات الصوتية تلقائيًا، مما يزيل عنق الزجاجة الناتج عن التسجيل اليدوي المتكرر.
قرار الدمج: ما الذي تقوم بربطه فعليًا؟
عبارة "دمج واجهة برمجة تطبيقات تحويل النص إلى كلام" تبدو عامة، لكنك عمليًا تقرر ثلاثة أشياء: أين في سير عملك يجب أن يُنشأ الكلام، وأي الأصوات واللغات ستمثل علامتك التجارية، ومدى إحكام أتمتة إنشاء الصوت واسترجاعه.
بالنسبة لصانع محتوى يوتيوب الذي يتوسع في المحتوى متعدد اللغات، غالبًا ما يعني الدمج ربط واجهة برمجة التطبيقات الخاصة بنا بأداة تخطيط الفيديو أو قاعدة بيانات النصوص بحيث يصبح كل نص نهائي تعليقًا صوتيًا باللغة والنمط الصحيحين. بالنسبة للشركات الصغيرة وفرق التسويق، تقع واجهة برمجة التطبيقات عادةً خلف نظام إدارة المحتوى أو منصة أتمتة التسويق، لتحويل مقالات المدونات وشروحات المنتجات ونصوص وسائل التواصل الاجتماعي إلى أصول صوتية قابلة لإعادة الاستخدام. يميل مقدمو التعليم الإلكتروني والتدريب المؤسسي إلى ربط واجهة برمجة التطبيقات بأدوات التأليف بحيث يمكن لوحدات الدروس طلب السرد لكل شريحة أو لكل موضوع وإعادة إنشائه فورًا عند تحديث المادة.
عادةً ما يختار المطورون والوكالات الذين يدمجون الذكاء الاصطناعي الصوتي بعمق أكبر بين نمطين. يجمع النموذج الدُفعي النصوص ويعالجها عبر مهام مجدولة. يُطلق النموذج المعاملاتي طلبًا فوريًا في كل مرة يصل فيها محتوى جديد أو إجراء من المستخدم. تعمل واجهة برمجة التطبيقات القائمة على المشاريع الخاصة بنا بسلاسة مع كلا النمطين، لأن كل مشروع TTS يغلّف النص، واختيار الصوت، واللغة، والصوت الناتج بطريقة تتوافق مع وحدات المحتوى الخاصة بك—مقاطع الفيديو أو الدروس أو حلقات البودكاست. إذا كنت لا تزال تفكر في المفهوم نفسه، فإن الشرح المرافق لدينا حول ما هي واجهة برمجة تطبيقات تحويل النص إلى كلام وكيف تعمل يغطي الأساسيات قبل أن تلتزم بتصميم.
كيف تعمل واجهة برمجة تطبيقات تحويل النص إلى كلام الخاصة بنا خلف الكواليس
تم بناء واجهة برمجة تطبيقات تحويل النص إلى كلام الخاصة بنا حول المشاريع والمقاطع، مما يجعلها أكثر مرونة من نقطة نهاية واحدة "نص يدخل، صوت يخرج". يجمع مشروع TTS مقطعًا نصيًا واحدًا أو أكثر تحت عنوان وتكوين مشترك مثل اللغة والصوت الافتراضي. يحمل كل مقطع نصه الخاص ومعرّف الصوت وعلامة اللغة، مما يتيح لك مزج أنماط السرد أو اللغات داخل ناتج واحد.
تتضمن حمولة JSON نموذجية لنقطة نهاية مشروع TTS عنوان مشروع قابل للقراءة البشرية للوحات المعلومات والسجلات الخاصة بك، بالإضافة إلى مصفوفة من المقاطع. يعيّن كل مقطع text (النص أو الجملة المراد نطقها)، وvoice (إما معرّف صوت مدمج أو معرّف صوت مخصص أُنشئ عبر واجهة برمجة تطبيقات استنساخ الصوت)، وlanguage (رمز يشير إلى لغة المقطع).
عندما تُرسل الواجهة الخلفية الخاصة بك هذه الحمولة إلى نقطة نهاية TTS مع مفتاح API صالح في ترويسة Authorization، ننشئ المشروع ونبدأ في إنتاج الصوت في الخلفية. تعرض واجهة برمجة التطبيقات نقطة نهاية لحالة المشروع تُبلّغ عمّا إذا كانت المعالجة لا تزال جارية أو مكتملة، إلى جانب مراجع لملفات الصوت المُنشأة بمجرد أن تصبح جاهزة. يحافظ هذا التصميم غير المتزامن على سرعة طلباتك: سجّل معرّف المشروع، وأعِد التحكم إلى المستخدم، ودع عاملًا في الخلفية يتحقق من الاكتمال ويسحب الصوت عند توفره.
يصل الكلام المُنشأ كملفات قابلة للتنزيل بصيغ قياسية، لا سيما MP3 بتردد 22 كيلوهرتز، والتي تندمج بسهولة في مشغلات الويب وتطبيقات الهاتف المحمول وخطوط تحرير الفيديو الزمنية. ولأن المحرك نفسه يشغّل أداتنا المستندة إلى المتصفح، يمكن للمطورين تجربة الأصوات والنصوص بشكل تفاعلي ثم نقل التركيبات الفائزة إلى استدعاءات API آلية. يوجد المرجع الكامل لنقاط النهاية في صفحة واجهة برمجة تطبيقات تحويل النص إلى كلام.
ربط استنساخ الصوت والدبلجة بالذكاء الاصطناعي بتحويل النص إلى كلام
الميزة المميزة لدينا هي أن تحويل النص إلى كلام واستنساخ الصوت والدبلجة بالذكاء الاصطناعي تتشارك محرك صوت أساسيًا واحدًا وسير عمل واحدًا. هذا يعني أن واجهة برمجة تطبيقات TTS ليست معزولة—إنها جوهر خط أنابيب توطين أوسع.
تتيح لك واجهة برمجة تطبيقات استنساخ الصوت رفع عينات صوتية لمتحدث، وإنشاء صوت مخصص بالذكاء الاصطناعي، والإشارة إلى هذا الصوت في مشاريع TTS. بمجرد وجود صوت مخصص، يصبح معرّفه هو حقل voice في مقاطع تحويل النص إلى كلام الخاصة بك، بحيث يُشغَّل السرد بالصوت المستنسخ بدلاً من صوت جاهز عام. تلك الاستمرارية مهمة للمقدمين وصانعي البودكاست والمتحدثين الرسميين للعلامات التجارية الذين يريدون هوية صوتية متسقة عبر اللغات والصيغ. إذا كنت تخطط لإضافة الاستنساخ، فإن دليلنا حول دمج واجهة برمجة تطبيقات استنساخ الصوت في تطبيقك يغطي التفاصيل.
توسّع واجهة برمجة تطبيقات الدبلجة بالذكاء الاصطناعي هذا الأمر أكثر من خلال الجمع بين النسخ والترجمة وتحويل النص إلى كلام في خط أنابيب واحد يدبلج مقاطع الفيديو إلى أكثر من 33 لغة مستهدفة. هنا يحوّل محرك TTS النصوص المترجمة إلى كلام باستخدام مكتبة الأصوات نفسها التي تضم أكثر من 300 صوت أو صوتك المستنسخ، بحيث تحافظ النسخ المدبلجة على النبرة والتوقيت. بالنسبة للمبدعين والشركات متعددي اللغات، تصبح واجهة برمجة تطبيقات تحويل النص إلى كلام اللبنة الأساسية لكل من التعليقات الصوتية أحادية اللغة والمحتوى المدبلج المحلي بالكامل. يوضح نظرتنا العامة حول كيف يعمل التوطين بالذكاء الاصطناعي كيف تتلاءم هذه القطع معًا من البداية إلى النهاية.
معايير القرار الرئيسية عند دمج واجهة برمجة تطبيقات TTS الخاصة بنا
دمج "أي" واجهة برمجة تطبيقات TTS ليس كافيًا؛ فالخيارات المتعلقة بالتنفيذ تحدد مدى ملاءمتها لإنتاجك وعلامتك التجارية وبنيتك التقنية.
احتياجات النطاق والأتمتة. إذا كان حجم المحتوى منخفضًا ومتقطعًا، فقد تكفي الأداة المستندة إلى المتصفح. بمجرد إنشاء النصوص بانتظام أو ربطها بتقويمات المحتوى أو أنظمة إدارة التعلم أو أتمتة التسويق، تصبح واجهة برمجة التطبيقات هي الطبقة الصحيحة لأنه يمكن تشغيلها برمجيًا وتوسيع نطاقها مع الواجهة الخلفية الخاصة بك.
استراتيجية الصوت واللغة. تدعم منصتنا الدبلجة من أكثر من 60 لغة مصدر إلى 33 لغة مستهدفة، مدعومة بمحرك الصوت نفسه الذي تستخدمه واجهة برمجة تطبيقات TTS. إذا كانت علامتك التجارية تحتاج إلى صوت متحدث رسمي مميز، فإن اقتران واجهة برمجة تطبيقات استنساخ الصوت مع TTS يحافظ على اتساق هذا الصوت عبر اللغات والقنوات. إذا كنت تعطي الأولوية للسرعة على التخصيص، فإن الأصوات المدمجة تبقي التنفيذ أبسط.
نقطة الدمج في بنيتك. بالنسبة لقنوات يوتيوب، تكون النقطة الطبيعية هي خط أنابيب الفيديو: نصوص مخزّنة في أداة تخطيط، تُرسل إلى واجهة برمجة تطبيقات TTS عند اكتمالها، وتُعاد كصوت جاهز للمحررين. قد تدمج منصات التعليم الإلكتروني على مستوى الدرس أو الشريحة، حيث تتوافق كل كتلة محتوى مع مقطع وتمثل المشاريع دورات كاملة. غالبًا ما تدمج فرق التسويق على مستوى نظام إدارة المحتوى بحيث يمكن لكل مقال أو صفحة منتج طلب نسخة صوتية لأغراض إمكانية الوصول.
الحوكمة والامتثال والمخاطر. ولأن استنساخ الصوت يمكن أن يحاكي أصواتًا معروفة، فإن الموافقة والترخيص وسياسات الاستخدام مهمة. تُحدَّد الأصوات المستنسخة بواسطة معرّفات ويمكن وسمها ببيانات وصفية، مما يسهّل فرض القواعد الداخلية حول أين يجوز استخدام أصوات معينة. قرر مسبقًا أي البيئات يجوز لها تشغيل الأصوات المستنسخة مقابل الأصوات العامة، وأضِف التسجيل في أنظمتك الخاصة.
توقعات زمن الاستجابة وتجربة المستخدم. توفر المعالجة غير المتزامنة مرونة لكنها تضيف اعتبارًا للتوقيت. بالنسبة لسير العمل الذي يتوقع فيه المستخدمون تشغيلًا فوريًا—مثل محرر نصوص بمعاينة فورية—أنشئ مشاريع أو مقاطع أصغر واعرض مؤشرات التقدم أثناء إنتاج الصوت. بالنسبة للتوطين الدفعي عبر مكتبات كاملة، يكون زمن الاستجابة أقل أهمية، ويمكن تشغيل المهام وفق جداول زمنية مع إرفاق الصوت المكتمل بسجلات المحتوى لاحقًا.
| مجال القرار | النموذج الدُفعي | النموذج المعاملاتي |
|---|---|---|
| المُشغِّل | مهام مجدولة | لكل عنصر محتوى أو إجراء من المستخدم |
| تحمّل زمن الاستجابة | عالٍ | منخفض |
| الأنسب لـ | كتالوجات الدورات، مكتبات الفيديو | محررو النصوص، المعاينات المباشرة |
| استراتيجية الصوت | صوت معتمد لكل لغة | صوت معتمد لكل لغة |
المخاطر والضمانات العملية
يجلب دمج واجهة برمجة تطبيقات تحويل النص إلى كلام بعض المخاطر المتوقعة التي يمكن للتصميم المدروس التخفيف منها.
يمكن أن يؤدي اختيار الأصوات دون اختبار إلى إنتاج كلام يبدو غير متناسق مع طابع العلامة التجارية أو المقدم. جرّب الأصوات في الواجهة التفاعلية أولاً، واحتفظ بكتالوج أصوات معتمد داخل أنظمتك الخاصة، منظّم حسب اللغة ونوع المحتوى، قبل تدوين معرّفات الأصوات في استدعاءات API.
الإفراط في أتمتة المحتوى الحساس فخ آخر. قد لا يكون إنشاء الكلام تلقائيًا لمواد الامتثال أو الطبية أو القانونية مناسبًا. ولأن واجهة برمجة التطبيقات الخاصة بنا تعمل على مشاريع ومقاطع منفصلة، يمكنك الحفاظ على قواعد توجيه ترسل فقط الفئات المعتمدة إلى TTS مع إبقاء المحتوى الحساس في سير عمل مسجّل بشريًا.
تحدث الأخطاء التشغيلية—مشاريع فاشلة أو تنزيلات مفقودة—عندما تقاطع مشكلات الشبكة أو الحمولات غير الصالحة المعالجة. تتيح لك نقاط نهاية حالة المشروع والاستجابات المنظمة التأكد من اكتمال المشروع وتوفر مخرجاته قبل النشر. اربط كل معرّف مشروع TTS بمعرّف المحتوى الخاص بك، ونفّذ عمليات إعادة المحاولة أو البدائل عندما تبلّغ فحوصات الحالة عن أخطاء.
يستحق سوء استخدام الأصوات المستنسخة ضوابط صريحة. يجب إنشاء الأصوات المخصصة عبر نقاط نهاية مخصصة ثم الإشارة إليها بالمعرّف في مشاريع TTS، مما يمنحك حدًا تقنيًا واضحًا للمراقبة. قيّد من يمكنه إنشاء أو تعيين معرّفات الأصوات المستنسخة، وسجّل أين تُستخدم.
المسار العملي للبدء هو دمج TTS للتعليقات الصوتية القياسية أولاً، والتحقق من الأصوات ومعالجة الأخطاء في الإنتاج، ثم إضافة استنساخ الصوت والدبلجة بالذكاء الاصطناعي بمجرد استقرار الدمج الأساسي. أخبرنا بحجم المحتوى الخاص بك، واللغات المستهدفة، وأين يجب أن تقع واجهة برمجة التطبيقات في بنيتك، ويمكننا توجيهك إلى نقاط النهاية الصحيحة والتخطيط لسير عملك.
الأسئلة الشائعة
كيف تختلف واجهة برمجة تطبيقات تحويل النص إلى كلام عن أداة المتصفح؟
أداة المتصفح هي واجهة مرئية تلصق فيها النص، وتختار صوتًا، وتنزّل الصوت يدويًا. تعرض واجهة برمجة التطبيقات المحرك نفسه عبر نقاط نهاية REST بحيث يمكن للواجهة الخلفية الخاصة بك إنشاء الصوت واسترجاعه تلقائيًا استجابةً للنصوص أو الجداول الزمنية أو إجراءات المستخدم.
هل يمكن لواجهة برمجة التطبيقات التحدث بصوتي الخاص، وليس فقط الأصوات الجاهزة؟
نعم. من خلال دمج واجهة برمجة تطبيقات استنساخ الصوت، ترفع عينات صوتية لمتحدث، وتنشئ صوتًا مخصصًا بالذكاء الاصطناعي، ثم تشير إلى معرّف هذا الصوت في مقاطع تحويل النص إلى كلام الخاصة بك بحيث يُشغَّل كل الكلام المُنشأ بالصوت المستنسخ.
كيف يساعد هذا في قنوات يوتيوب أو البودكاست متعددة اللغات؟
تحوّل منصتنا الكلام أو النصوص من أكثر من 60 لغة مصدر إلى ناتج مدبلج عبر 33 لغة مستهدفة، مع قيام TTS بإنشاء الصوت النهائي باستخدام أكثر من 300 صوت أو صوتك المستنسخ. يتيح ربط واجهات برمجة تطبيقات TTS والدبلجة بالذكاء الاصطناعي بخط أنابيب النشر الخاص بك أن تحصل مقاطع الفيديو أو الحلقات الجديدة على تعليقات صوتية أو دبلجات كاملة بمجرد جاهزية النصوص أو الصوت المصدر.
ما صيغ الصوت التي سيتلقاها تطبيقي أو محرري؟
تسلّم واجهة برمجة تطبيقات TTS ملفات صوتية عالية الجودة، بما في ذلك MP3 بتردد 22 كيلوهرتز، مناسبة لمعظم بيئات الويب والهاتف المحمول وتحرير الفيديو دون تحويل إضافي.
هل يمكنني دمج تحويل النص إلى كلام الآن وإضافة الدبلجة بالذكاء الاصطناعي لاحقًا؟
نعم. تتشارك خدمات تحويل النص إلى كلام واستنساخ الصوت والدبلجة بالذكاء الاصطناعي منظومة API مشتركة، لذا يمكنك البدء بـ TTS للتعليقات الصوتية ثم إضافة استنساخ الصوت والدبلجة بالذكاء الاصطناعي لاحقًا لأتمتة الدبلجة متعددة اللغات دون إعادة بناء الدمج الأساسي الخاص بك.