الإجابة الصادقة عن مقدار الصوت اللازم لاستنساخ صوت ما أقصر مما يتوقعه معظم الناس: باستخدام DubSmart AI، تحتاج إلى 20 ثانية على الأقل من تسجيل نقي لمتحدث واحد. هذا الحد الأدنى يُنطلق باستنساخ قابل للاستخدام، لكنه نادرًا ما يروي القصة كاملة. الطول الذي ينبغي عليك تسجيله فعليًا يعتمد على المكان الذي سيعيش فيه الصوت—مقطع اجتماعي واحد، أو راوٍ متكرر لقناة، أو مكتبة دورات متعددة اللغات، أو متحدث رسمي لعلامة تجارية يجب أن يبدو متطابقًا عبر عشرات الفيديوهات. فيما يلي، نفصل الحد الأدنى الصارم عن الهدف العملي، ونشرح ما الذي يستمع إليه النموذج فعلًا، ونمنحك قاعدة قرار يمكنك تطبيقها قبل أن تضغط على زر التسجيل.
جدول المحتويات
الحد الأدنى مقابل الهدف العملي
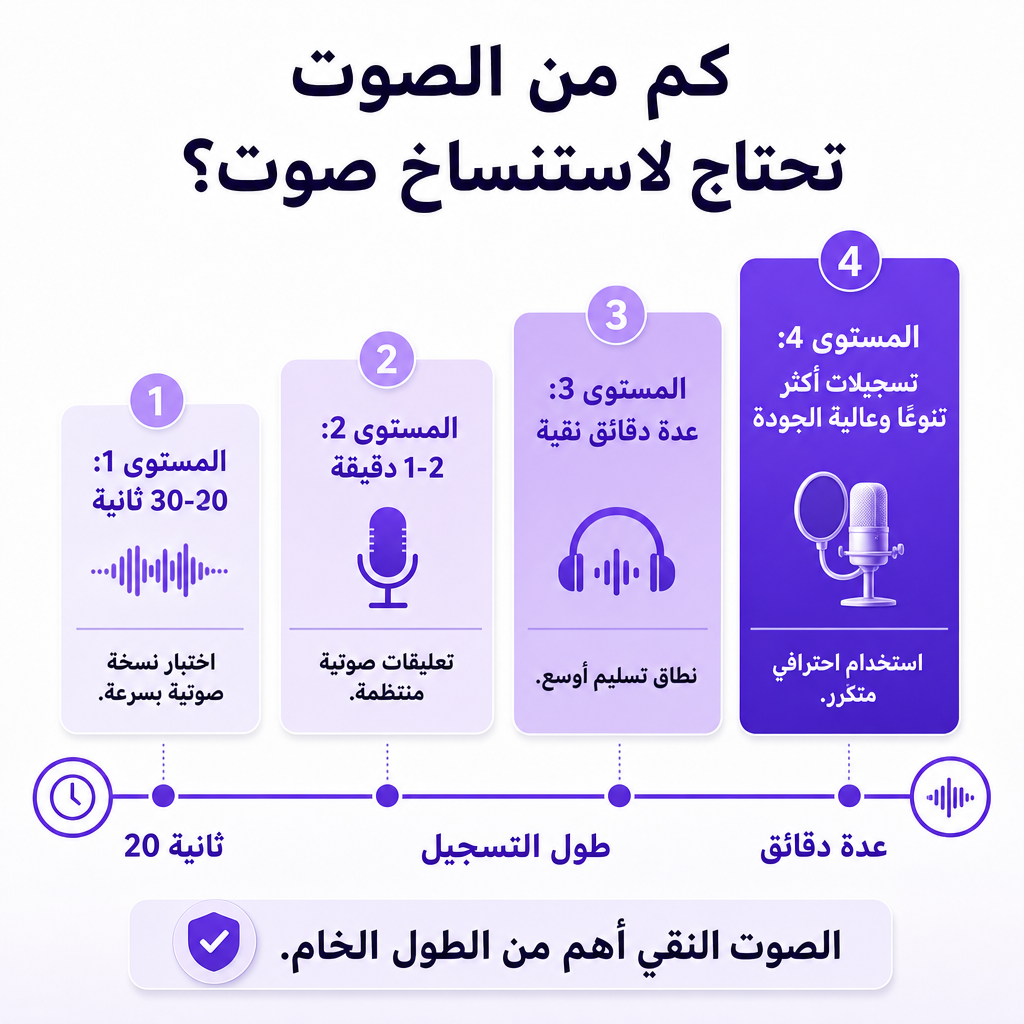
عشرون ثانية هي الأرضية، وليست خط النهاية. العينة ذات الطول الأدنى تلتقط الهوية الأساسية للمتحدث، وهو ما يكفي غالبًا لاختبار سريع أو مقطع لمرة واحدة. لكن كمية المادة التي تمنحها للنموذج تشكّل مباشرة مدى جودة تعامل الاستنساخ مع النصوص المتنوعة. والهدف الصحيح يتناسب مع مدى صعوبة المخرجات وتكرارها.
| هدفك | هدف الصوت العملي |
|---|---|
| اختبار استنساخ بسرعة | 20–30 ثانية |
| إنشاء تعليقات صوتية منتظمة | 1–2 دقيقة |
| التقاط نطاق أداء أوسع | عدة دقائق نقية |
| بناء صوت للاستخدام المهني المتكرر | تسجيلات أكثر تنوعًا وعالية الجودة |
المبدأ الكامن وراء الجدول بأكمله صريح: الصوت النقي والمتسق عادةً ما يكون أثمن من تسجيل أطول مليء بالضوضاء أو الصدى أو الموسيقى أو عدة متحدثين. مقطع نظيف مدته 30 ثانية يمكن أن يتفوق على مقطع فوضوي مدته 10 دقائق. إذا أردت فهم الآليات الأوسع لكيفية تحوّل العينة إلى صوت قابل لإعادة الاستخدام، فإن شرحنا حول كيف يعيد استنساخ الصوت إنشاء صوت ما يغطي المسار الكامل.
ما الذي يعنيه "الصوت الكافي" فعلًا
"الكافي" ليس رقمًا على ساعة إيقاف فعلًا—إنه مسألة ما إذا كان لدى النموذج ما يكفي من الكلام المفيد لإعادة بناء الصوت الذي تريده. عندما تستنسخ صوتًا، يحلل الذكاء الاصطناعي التسجيل لتحديد مجموعة من الخصائص، ثم يستخدمها لإنشاء كلام جديد من نص أو حوار مترجم.
تشمل هذه الخصائص:
- نبرة الصوت وجرسه
- طبقة الصوت وإيقاع التحدث
- النطق واللكنة
- التوقفات والإيقاع
- الطاقة والتشديد والأداء العاطفي
العينة القصيرة تثبّت الهوية الأساسية للمتحدث. أما العينة الأطول والأكثر تنوعًا فتضيف معلومات عن كيفية بدو هذا الشخص عندما يشرح أو يسأل أو يشدد أو يتوقف أو يغير نبرته العاطفية. لذا فإن الهدف الحقيقي هو صوت تمثيلي: مادة تُظهر للنموذج الصوت وهو يقوم بأنواع الأشياء التي سيُطلب منه القيام بها لاحقًا.
متى تسجّل أكثر من 20 ثانية
تجاوز الحد الأدنى كلما كان الصوت المستنسخ سيظهر بشكل متكرر، أو يمثّل علامة تجارية، أو يحمل محتوى أطول. لتلك الحالات، تكون نقطة البداية العملية من دقيقة إلى دقيقتين من الكلام النقي، مع إضافة المزيد إذا احتجت أن يعيد الصوت إنتاج نطاق أوسع من أساليب الأداء.
العينات الأطول تؤتي ثمارها في الأعمال الكثيفة بالسرد: فيديوهات يوتيوب، والبودكاست، والدورات عبر الإنترنت، والتدريب المؤسسي، والمحتوى بأسلوب الكتب الصوتية، وشروحات المنتجات، والدبلجة متعددة اللغات، وحوارات الشخصيات، والحملات التسويقية المتكررة. صانع المحتوى الذي يسجل مقدمة هادئة فقط يميل إلى الحصول على استنساخ يؤدي أفضل ما لديه في تلك النبرة الهادئة الواحدة. أما صانع المحتوى الذي يسجل الشروحات والأسئلة والتشديد والتوقفات الطبيعية فيمنح النموذج أمثلة أكثر بكثير عن الصوت أثناء العمل. الهدف ليس أبدًا إغراق النموذج بأكبر عدد من الدقائق—بل توفير صوت يمثّل كيف يتصرف الصوت فعلًا.
لماذا يتفوق الصوت النقي على الصوت الطويل
الصوت الأكثر يساعد فقط عندما تكون المادة الإضافية عالية الجودة وذات صلة. تسجيل مدته 10 دقائق يحتوي على صدى الغرفة أو نقر لوحة المفاتيح أو موسيقى خلفية أو ميكروفونات متغيرة أو عدة متحدثين يمكن أن يكون أقل فائدة من مقطع قصير نقي. الضوضاء الأعلى تبقى ضوضاء، لذا فإن رفع مستوى الكسب لا ينقذ أبدًا عينة سيئة.
الصوت الإضافي يستحق مكانه عندما يكون:
- منطوقًا بوضوح من قبل شخص واحد
- متسقًا في مستوى الصوت ومسافة الميكروفون
- خاليًا من الموسيقى والمؤثرات الصوتية والأصوات المتداخلة
- مسجّلًا في بيئة هادئة قليلة الصدى
- بإيقاع طبيعي
- ممثّلًا للأسلوب الذي تريد توليده
بعض عادات التسجيل تحمي الجودة أكثر من أي هدف للطول. حافظ على متحدث واحد في المقطع؛ فالأصوات الأخرى تُربك التحليل. فضّل غرفة صغيرة مفروشة على غرفة كبيرة فارغة لتقليل الانعكاسات، وحافظ على مسافة ثابتة من الميكروفون طوال الوقت. لا تسجّل قسمًا عن قرب وآخر من الجهة الأخرى للغرفة، وتجنّب حشو الملف بصمت طويل أو صوت غير ذي صلة. إذا كان مصدرك الوحيد فيديو مشوشًا، فنظّفه أولًا بدلًا من أن تأمل أن يعوّض الطول عن ذلك—يشرح دليلنا حول إزالة الموسيقى الخلفية من الصوت عملية التنظيف هذه.
ما الذي ينبغي أن تقوله عينتك فعلًا
المحتوى لا يقل أهمية عن الحالة. ينبغي أن يحتوي التسجيل على كلام واضح وطبيعي بدلًا من أصوات معزولة أو عبارات مقطّعة بشدة. العينة القوية تمزج بين الجمل القصيرة والطويلة، ومجموعة من أصوات الحروف المتحركة والساكنة، والأرقام والتواريخ، والأسماء والمصطلحات الشائعة، والأسئلة، والعبارات التأكيدية، والتوقفات الطبيعية—ويُفضّل أن يكون بنفس نوع اللغة التي سيستخدمها المحتوى النهائي.
ما يبدو عليه ذلك عمليًا يختلف حسب صانع المحتوى. قد يسجل صانع محتوى على يوتيوب مقدمة قصيرة، وشرحًا، ودعوة لاتخاذ إجراء، وبضعة أسطر بمستويات تشديد مختلفة. يمكن لمنتج التعليم الإلكتروني أن يشمل صياغة تعليمية، وتعريفات، وقوائم، وانتقالات. يستفيد المتحدث الرسمي للأعمال من دمج مصطلحات العلامة التجارية والأسلوب الحواري المستخدم في المحتوى الموجّه للعملاء. وما إذا كنت بحاجة إلى استنساخ هنا هو سؤال عادل؛ يساعدك تحليلنا حول الصوت المستنسخ مقابل صوت تحويل النص إلى كلام الجاهز عندما يؤدي صوت من المكتبة المهمة بشكل أسرع.
الاستنساخ متعدد اللغات والصوت المصدري المشوش
للمشاريع متعددة اللغات، يظل المطلب الأساسي هو جودة عينة الصوت الأصلية. ترجمة الكلام المولّد إلى لغات أخرى لا تلغي الحاجة إلى تسجيل مصدري واضح—فالمقطع الإنجليزي غير الواضح ينتج استنساخًا غير واضح في كل لغة مستهدفة.
عندما تخطط للترجمة المحلية، انتبه إلى وضوح الصوت الأصلي، ونطق الأسماء ومصطلحات العلامة التجارية، والنبرة المقصودة في كل لغة، وما إذا كان ينبغي أن يبقى أسلوب المتحدث رسميًا أو وديًا أو نشيطًا أو حواريًا، وما إذا كانت النصوص المترجمة قد روجعت قبل الدبلجة. في مشروع ترجمة محلية أكبر، اختبر قسمًا قصيرًا في كل لغة مستهدفة قبل معالجة الفيديو الكامل؛ فهذا يكشف مبكرًا عن مشكلات النطق والإيقاع والتكيّف الثقافي. يمكن لسير عمل الدبلجة بالذكاء الاصطناعي في DubSmart استخدام صوت مستنسخ للمحتوى المترجم، ويمكن استخدام الأصوات المستنسخة في كل من تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي.
جودة المصدر هي النصف الآخر من هذه المشكلة. يمكنك في الغالب استخراج الكلام من فيديو، لكن الموسيقى الخلفية، والمؤثرات الصوتية، وأجواء الغرفة، والرياح، وضوضاء الجمهور، والكلام المتداخل، وتشوهات الضغط—كلها تجعل المقطع نقطة بداية سيئة. إذا كان المصدر قيّمًا لكنه مشوش، فاعزل الكلام أولًا. أداتنا فاصل الكلام تسحب مسار الصوت بعيدًا عن عناصر الصوت الأخرى، وكلما كان ذلك المسار أنقى، كان الاستنساخ أكثر موثوقية.
الموافقة والحق في استنساخ صوت
لا يمكنك استنساخ صوت شخص آخر إلا عندما يكون لديك الإذن والحقوق المناسبة. يحمل استنساخ الصوت مخاطر قانونية وأخلاقية ومتعلقة بالخصوصية وانتحال الشخصية حقيقية، لذا قبل تحميل تسجيل شخص آخر، احصل على موافقته المستنيرة وأكّد كيف يمكن استخدام الصوت وتوزيعه والاحتفاظ به. تطلبت قواعد تحدي استنساخ الصوت الخاصة بلجنة التجارة الفيدرالية الأمريكية من المشاركين استنساخ الأصوات فقط بموافقة الشخص الذي استُنسخ صوته.
للأعمال التجارية، وثّق من يملك الصوت أو يتحكم فيه، وأي تسجيلات يمكن استخدامها، وأي أنواع محتوى ولغات مسموح بها، وما إذا كان الاستخدام التجاري مسموحًا، وكم تدوم مدة الإذن، وما إذا كان بإمكان الشخص سحبه، وكيف سيُفصح عن المحتوى الاصطناعي عند الاقتضاء. لا تستنسخ شخصية عامة أو موظفًا أو عميلًا أو ممثلًا أو أحد أفراد العائلة لمجرد أنه بإمكانك الوصول إلى تسجيل له. الوصول ليس إذنًا.
كم تسجّل حسب نوع صانع المحتوى
ينطبق الحد الأدنى نفسه على الجميع، لكن الهدف العملي يتغير مع مخاطر الإنتاج. استخدم الحد الأدنى عندما تكون السرعة مهمة—الاختبار الإبداعي المبكر، والمقاطع القصيرة، والنماذج الأولية الداخلية، والإعلانات البسيطة—وسجّل المزيد كلما وجب أن يبقى الصوت متسقًا عبر العديد من الفيديوهات أو اللغات.
| صانع المحتوى | العينة الموصى بها |
|---|---|
| صانعو محتوى يوتيوب | 20 ثانية للاختبار؛ من دقيقة إلى دقيقتين نقية ومعبّرة لراوٍ متكرر |
| الأعمال الصغيرة / التسويق | مقطع متحدث رسمي متسق بمصطلحات الحملة وطاقتها؛ اختبر تعليقًا صوتيًا قصيرًا أولًا |
| التعليم الإلكتروني / التدريب | عينة أطول ومتنوعة تغطي التعريفات والتعليمات والأسئلة والانتقالات |
| صانعو البودكاست | عينة تعكس الإيقاع الطبيعي للمقدّم؛ تحقق من نطق الأسماء والرعاة |
| صانعو الأفلام | عينة تطابق توجيه الشخصية، بما في ذلك الهمس أو الحدة أو غيرها من الصفات الدرامية |
| المطورون / الوكالات | معيار صوتي قابل للتكرار يُطبّق قبل قبول عينات العملاء |
تكمن وراء ذلك الجدول ملاحظتان عمليتان. العينة المحايدة لن تعيد إنتاج أداء يعتمد على الهمس أو السخرية أو الخوف، لذا ينبغي لصانعي الأفلام التقاط الشخصية، وليس الصوت فحسب. وبالنسبة للمسارات المدفوعة بواجهة برمجة التطبيقات، يمنع معيار استلام ثابت النتائج غير المتسقة عبر العملاء؛ تنشئ واجهة برمجة تطبيقات استنساخ الصوت لدينا أصواتًا مخصصة من عينات صوتية وتجعلها متاحة لتحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي.
فحص قصير قبل التحميل يُبقي النتائج قابلة للتنبؤ. تأكّد من أن العينة تستمر 20 ثانية على الأقل، وتتضمن متحدثًا واحدًا، ولا تحمل موسيقى أو أصواتًا متداخلة، وبها حد أدنى من الصدى وضوضاء الخلفية، وتحافظ على موضع ومستوى ثابت للميكروفون، وتحتوي على كلام طبيعي بدلًا من صمت طويل، وتطابق الأسلوب المقصود، وتأتي من متحدث وافق على الاستخدام المقصود.
استخدم 20 ثانية لاختبار الفكرة، ومن دقيقة إلى دقيقتين للسرد اليومي الموثوق، وصوتًا نقيًا أكثر تنوعًا عندما يجب أن يؤدي الصوت بشكل متسق عبر محتوى طويل أو متعدد اللغات.
الحد الأدنى يُنطلق بك. أما جودة التسجيل، واتساق المتحدث، والنطاق التعبيري، والإذن فهي التي تقرر ما إذا كانت النتيجة جاهزة للنشر.
الأسئلة الشائعة
كم من الصوت تحتاج لاستنساخ صوت؟
مع DubSmart تحتاج إلى 20 ثانية من الصوت على الأقل. لتغطية أفضل لأداء المتحدث، استهدف من دقيقة إلى دقيقتين من الكلام النقي الطبيعي.
هل 10 ثوانٍ كافية لاستنساخ صوت؟
قد تكفي لبعض الأنظمة، لكنها تقع دون الحد الأدنى المعلن من DubSmart. قم بتحميل 20 ثانية على الأقل لاستنساخ DubSmart.
هل تكفي دقيقة واحدة لاستنساخ الصوت؟
غالبًا نعم، للسرد اليومي، بشرط أن يكون نقيًا ومتسقًا ومنطوقًا بشكل طبيعي. عينة أكبر وأكثر تنوعًا تساعد في الاستخدام التعبيري أو المهني.
هل يجعل التسجيل الأطول الاستنساخ أكثر دقة؟
ليس تلقائيًا. الطول الإضافي يساعد فقط عندما يضيف أمثلة نقية وذات صلة عن الصوت. الضوضاء والصدى والموسيقى وتعدد المتحدثين تقلل من قيمة الصوت المضاف.
هل أحتاج إلى إذن لاستنساخ صوت؟
نعم. احصل على الموافقة وأكّد الحقوق المعمول بها قبل استنساخ صوت شخص آخر، بما يشمل الاستخدام المقصود والتوزيع والنشاط التجاري. كما تطلبت قواعد تحدي استنساخ الصوت الخاصة بلجنة التجارة الفيدرالية الموافقة من الشخص الذي استُنسخ صوته.
هل يمكنني استخدام استنساخ صوتي للدبلجة بالذكاء الاصطناعي؟
نعم. يمكن استخدام الأصوات المُنشأة في كل من تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي.