عندما تسأل عن كيفية إنشاء التعليقات الصوتية بالذكاء الاصطناعي، فأنت في الحقيقة تسأل كيف يتحول نص مكتوب إلى كلام دون أن يدخل أحد إلى استوديو التسجيل. الإجابة المختصرة: نموذج عصبي لتحويل النص إلى كلام يحوّل نصك إلى صوت اصطناعي، وصوت مستنسخ اختياري يجعل ذلك الصوت يبدو مثل شخص بعينه، وطبقة الدبلجة تُنسّق كل شيء مع الفيديو الخاص بك عبر اللغات المختلفة. في DubSmart AI، نُشغّل تلك السلسلة الكاملة داخل مساحة عمل واحدة، لذا يمكنك الانتقال من فقرة نصية إلى تعليق صوتي نهائي متعدد اللغات دون تبديل الأدوات أو حجز وقت في الاستوديو.
يعتمد شكل تلك العملية بالنسبة لك على قرار واحد، وتشرح بقية هذا الدليل الآليات والخيارات وكيفية الاختيار.
جدول المحتويات
القرار وراء كيفية إنشاء التعليقات الصوتية بالذكاء الاصطناعي
قبل إنشاء أي صوت، تتخذ قرارين يشكّلان كل شيء لاحقًا. الأول هو ما إذا كنت تريد صوتًا جاهزًا من مكتبة أم نسخة مستنسخة من صوتك الخاص. والثاني هو ما إذا كنت تحتاج تعليقًا صوتيًا بلغة واحدة أم نسخة محلية بالكامل عبر لغات عديدة.
بالنسبة لمنشئ محتوى على يوتيوب أو نشاط تجاري صغير، غالبًا ما يُحسم الأمر بسرعة: اختر صوتًا جاهزًا للسرعة، واستنسخ صوتًا عندما يكون اتساق العلامة التجارية مهمًا، ولجأ إلى الدبلجة فقط عندما تتجه نحو تعدد اللغات. أما بالنسبة للمطورين والوكالات، فيصبح نفس التفرع مسألة معمارية — هل تستدعي نقطة نهاية لتحويل النص إلى كلام للحصول على صوت لمرة واحدة، أم تربط استنساخ الصوت والدبلجة معًا في خط إنتاج يعمل من تلقاء نفسه؟
لقد بنينا DubSmart حول هذه التفرعات بالضبط. تحويل النص إلى كلام، واستنساخ الصوت، وتحويل الكلام إلى نص، وفاصل الكلام، وتحويل النص إلى صورة، وتحويل الصورة إلى فيديو، والدبلجة بالذكاء الاصطناعي، كلها موجودة في منصة واحدة، لذا يمكنك رفع أو خفض مستوى الأتمتة والتخصيص دون دمج مورّدين منفصلين معًا.
الآليات: كيف يتم إنشاء التعليقات الصوتية بالذكاء الاصطناعي فعليًا
تحويل النص إلى كلام: تحويل النص المكتوب إلى صوت
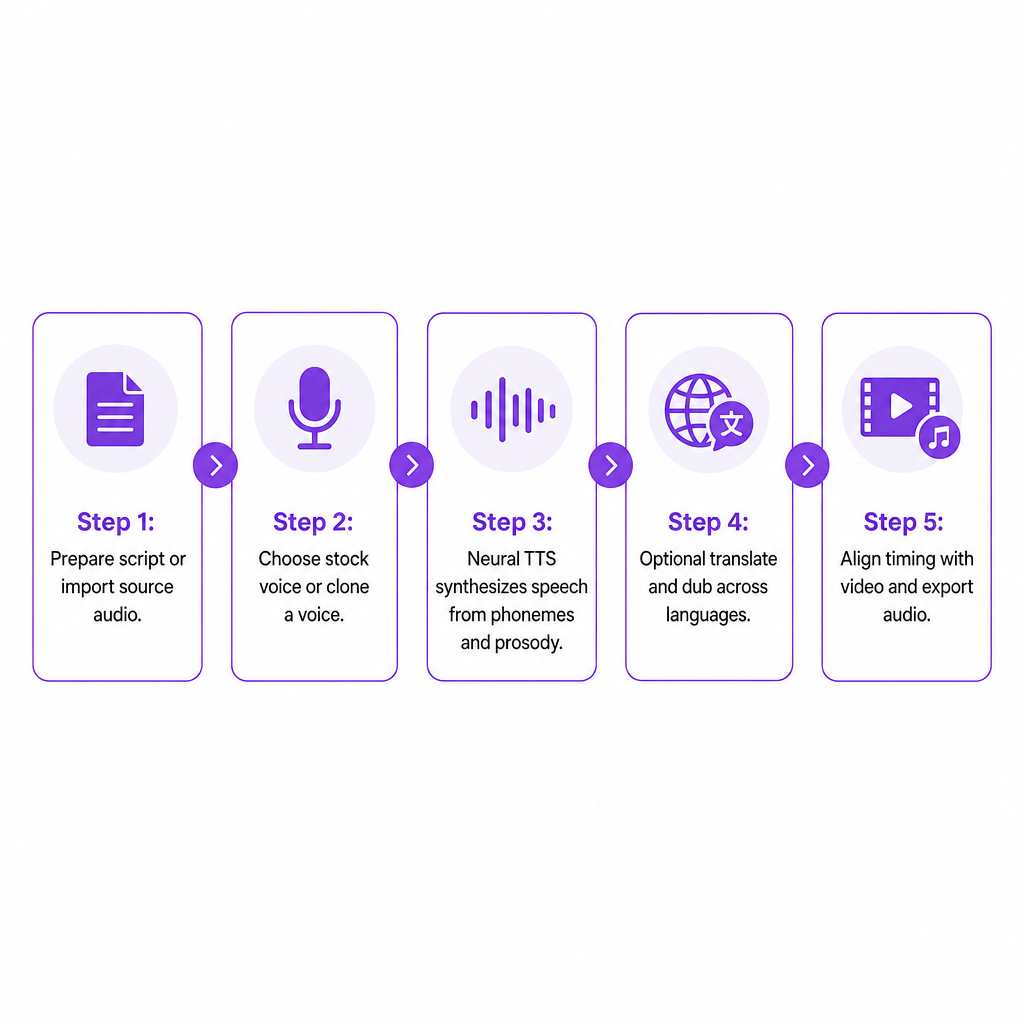
يقع تحويل النص إلى كلام (TTS) في قلب كل تعليق صوتي بالذكاء الاصطناعي. يحلل المحرك أولًا نصك — مقسّمًا النص إلى وحدات صوتية، وقارئًا علامات الترقيم والبنية، ومستنتجًا التنغيم، وهو الإيقاع والتشديد والنبرة التي تمنع الكلام من أن يبدو مسطحًا. ثم تُركّب النماذج العصبية تلك الوحدات الصوتية إلى صوت وتطبّق أنماط التنغيم التي تجعل الأداء يبدو سلسًا بدلًا من كونه آليًا.
يتيح لك محرك تحويل النص إلى كلام الخاص بنا لصق نص بأي لغة، واختيار صوت من مكتبة تضم أكثر من 300 صوت، وتوليد كلام واقعي في ثوانٍ. الأصوات طبيعية وشبيهة بالبشر، وهي مصنّفة حسب اللغة والجنس والأسلوب حتى يمكنك مطابقة نبرة ما تنتجه. بالنسبة للمطورين، يُتاح نفس المحرك من خلال واجهة برمجة تطبيقات تحويل النص إلى كلام بنمط RESTful: أرسل طلب POST مع نصك ومعلمات الصوت، واستلم ملفات صوتية جاهزة للاستخدام. نص منظّم يدخل، وصوت واقعي يخرج، بلا تسجيل يدوي.
نماذج الصوت ومكتبات الأصوات
تعتمد التعليقات الصوتية بالذكاء الاصطناعي على نماذج صوتية مُدرَّبة — شبكات عصبية تتعلم كيف ينبغي أن يبدو صوت معين عبر كلمات ولغات ومشاعر مختلفة. مكتبة الأصوات هي ببساطة فهرس لتلك النماذج. نحن نحتفظ بمكتبة تضم أكثر من 300 صوت طبيعي تغطي أجناسًا ولهجات وأساليب كلام متعددة عبر لغات عديدة، وهي متاحة سواء في تطبيق الويب أو عبر واجهة برمجة التطبيقات حتى تتمكن الأدوات الداخلية من توليد الكلام عند الطلب.
استنساخ الصوت: جعل الذكاء الاصطناعي يبدو مثلك
الاستنساخ هو الآلية التي تجعل التعليق الصوتي يبدو مثل شخص بعينه بدلًا من راوٍ عام. يحلل النظام تسجيلًا نموذجيًا، ويتعلم نبرة المتحدث ونطاق طبقة صوته وأنماط نطقه، ثم يطبّق تلك الخصائص على كلام اصطناعي جديد.
عمليًا، ترفع ملفًا صوتيًا لا تقل مدته عن 20 ثانية إلى استنساخ الصوت — يُفضّل أن يكون نظيفًا وخاليًا من الضوضاء الخلفية. نقوم بمعالجة تلك العينة إلى ملف تعريف صوتي مخصص يمكنك تسميته وإعادة استخدامه، مع استغراق الاستنساخ عادةً بضع ثوانٍ فقط. بمجرد إنشائه، يصبح الصوت المستنسخ متاحًا داخل تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي، حتى يمكنك توليد نصوص أو نسخ مدبلجة بصوتك الخاص. برمجيًا، تعكس واجهة برمجة تطبيقات استنساخ الصوت ذلك: احصل على عنوان URL للرفع، وأرسل صوتك بصيغة مدعومة، وأنشئ صوتًا مخصصًا من مفتاح الملف الناتج، ثم استخدمه في مشاريع تحويل النص إلى كلام أو الدبلجة.
الدبلجة والتعليقات الصوتية متعددة اللغات
الانتقال من تعليق صوتي بلغة واحدة إلى محتوى متعدد اللغات يضيف طبقة توطين فوق تحويل النص إلى كلام الأساسي. النمط العام ثابت:
- التقاط الكلام الأصلي أو استيراده.
- تفريغه إلى نص.
- ترجمة ذلك النص.
- توليد كلام جديد باللغة المستهدفة.
- محاذاة التوقيت مع الفيديو أو الصوت الأصلي.
يتبع سير عمل الدبلجة بالذكاء الاصطناعي الخاص بنا هذا النمط بالضبط، جامعًا بين تحويل الكلام إلى نص والترجمة الآلية وتحويل النص إلى كلام، مع إعادة استخدام صوت مستنسخ اختياريًا بحيث يطابق المسار المدبلج المتحدث الأصلي. يحوّل المحتوى المنطوق من أكثر من 60 لغة مصدر إلى نسخ مدبلجة عبر 33 لغة مستهدفة. تهدف الدبلجة من كلام إلى كلام إلى الحفاظ على النبرة والتوقيت قريبين من الأداء الأصلي، وهو الأمر الأهم بالنسبة للتعليم الإلكتروني والتدريب والمحتوى السينمائي حيث تحمل مزامنة الشفاه والإيقاع التجربة.
واجهات برمجة التطبيقات وسير العمل المؤتمت
بالنسبة للفرق التي تنتج التعليقات الصوتية على نطاق واسع، فإن واجهات برمجة التطبيقات هي ما يدمج إنشاء الصوت في الأنظمة القائمة. تتعامل واجهة برمجة تطبيقات TTS مع إدخال النص وإخراج الصوت؛ وتضيف واجهة برمجة تطبيقات استنساخ الصوت الإنشاء البرمجي للأصوات المخصصة وإدارتها؛ وتوسّع واجهة برمجة تطبيقات الدبلجة بالذكاء الاصطناعي كليهما إلى الترجمة والدبلجة التلقائية عبر أكثر من 33 لغة مع الوصول إلى الأصوات المستنسخة. معًا، تتيح لك بناء خطوط إنتاج تتحول فيها النصوص أو الترجمات أو التفريغات المسحوبة من نظام محتوى إلى تعليقات صوتية أو مسارات مدبلجة تلقائيًا، بلا معالجة يدوية للملفات.
طرقك الثلاث لإنشاء التعليقات الصوتية بالذكاء الاصطناعي في DubSmart
داخل منصتنا، يتحول السؤال إلى ثلاث نقاط انطلاق عملية.
ابدأ من نص باستخدام تحويل النص إلى كلام. الصق نصك، واختر صوتًا جاهزًا أو مستنسخًا، واضبط اللغة والضوابط الأساسية، ووَلّد كلامًا يمكنك تنزيله بصيغ قياسية. هذا يناسب فيديوهات التدريب والمحتوى التوضيحي والإعلانات التسويقية ومقدمات البودكاست حيث تملك النص من البداية.
ابدأ من وسائط موجودة باستخدام الدبلجة بالذكاء الاصطناعي. ارفع ملف فيديو أو صوت مصدر، ودع النظام يفرّغ ويترجم، ثم وَلّد مسارات مدبلجة باللغات التي تختارها — مع إعادة استخدام الأصوات المستنسخة للحفاظ على اتساق الصوت. هذا هو المسار للقنوات التي تتوسع نحو جماهير متعددة اللغات وللشركات التي تعيد استخدام الندوات عبر الإنترنت أو عروض المنتجات.
ابدأ من أنظمتك الخاصة باستخدام التوليد المعتمد على واجهة برمجة التطبيقات. يرسل تطبيقك النص ومعلمات الصوت إلى واجهة برمجة تطبيقات TTS، ويربط المحتوى اختياريًا بصوت معين من خلال واجهة برمجة تطبيقات استنساخ الصوت، ويستعيد صوتًا جاهزًا لإرفاقه بالفيديوهات أو التعليقات الصوتية للتعليم الإلكتروني لوحدات التدريب. هذا يناسب المطورين والوكالات ومزودي أنظمة إدارة التعلم الذين يحتاجون مخرجات برمجية متسقة.
معايير القرار: اختيار إعداد التعليق الصوتي بالذكاء الاصطناعي
الطبيعية وجودة الصوت
الطبيعية غير قابلة للتفاوض. تُنمذج المحركات القوية التنغيم والنطق بحيث يتدفق الكلام مع الوقفات والتشديد المناسبين. ولأن التوليد سريع، يمكنك تكرار النص وإعادة توليد الصوت حتى يبدو الأداء صحيحًا بدلًا من الاكتفاء بأول محاولة.
تغطية اللغات وعمق التوطين
إذا كانت القنوات متعددة اللغات أو التدريب الدولي على خارطة طريقك، فإن التغطية تحدد مدى الوصول الذي يمكنك تحقيقه. تحويل المحتوى من أكثر من 60 لغة مصدر إلى 33 لغة مستهدفة من سير عمل واحد يحدد الأسواق التي يمكنك خدمتها، وتساعد الدبلجة من كلام إلى كلام في الحفاظ على اتساق النبرة والتوقيت عبر كل نسخة.
العلامة التجارية الصوتية وإمكانية الاستنساخ
الصوت المميز مهم للشركات ومنشئي المحتوى والبودكاست. يتيح لك الاستنساخ حمل نفس الصوت عبر اللغات والقنوات. القدرة على الاستنساخ من نحو 20 ثانية من الصوت النظيف وإعادة استخدام ذلك الملف داخل تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي تجعل تأسيس صوت مميز والحفاظ عليه أمرًا عمليًا.
بساطة سير العمل مقابل التكامل التقني
غالبًا ما يريد منشئو المحتوى معالجة الرفع والتحرير والتنزيل في مكان واحد. وغالبًا ما تحتاج الفرق التقنية واجهات برمجة تطبيقات. نحن نوفر كليهما: أدوات موجهة للمستخدم في تطبيق موحد، وواجهات برمجة تطبيقات للمطورين تكشف نفس المحركات. يعتمد الاختيار على ما إذا كان فريقك يعمل غالبًا في متصفح أم يبني على أنظمة داخلية.
السرعة وقابلية التوسع والاتساق
ينبغي لأداة التعليق الصوتي أن تختصر الإنتاج وتتوسع دون تراجع الجودة. يتيح توليد TTS شبه الفوري والاستنساخ الذي يكتمل في ثوانٍ التكرار السريع والإخراج بالجملة، بينما تتيح واجهات برمجة التطبيقات معالجة آلاف النصوص أو المقاطع تلقائيًا بأصوات وإعدادات متسقة.
هيكل الميزانية والتحكم
بدلًا من رسوم الاستوديو لكل جلسة، تستخدم أدوات التعليق الصوتي بالذكاء الاصطناعي عمومًا التسعير القائم على الاستخدام. يمنحك نموذجنا القائم على الرصيد إمكانية الوصول إلى الدبلجة بالذكاء الاصطناعي، وتحويل النص إلى كلام، واستنساخ الصوت، وتحويل الكلام إلى نص، وفاصل الكلام، وتحويل النص إلى صورة، وتحويل الصورة إلى فيديو تحت حساب واحد، مع فئة مجانية وخطط للمؤسسات. توفر الأرصدة حدود استخدام يمكن التنبؤ بها بينما يبقى الترحيل والتوسع متاحين عندما يرتفع الحجم. إذا أردت تحديد حجم الأرصدة مقابل مدة التشغيل، فإن تفصيلنا لتكلفة الدبلجة بالذكاء الاصطناعي لكل دقيقة يشرح الحساب.
الامتثال والموافقة والتعامل مع البيانات
يحمل الاستنساخ والكلام الاصطناعي ثقلًا أخلاقيًا وقانونيًا. نطالب بأن ترفع صوتًا تملك حقوقه، ونوصي بتسجيلات نظيفة للحصول على أفضل النتائج، مما يبقي الموافقة والتحكم في القلب. تستخدم وثائق واجهة برمجة التطبيقات الخاصة بنا عناوين URL آمنة موقّعة مسبقًا للرفع وصيغًا صوتية قياسية، مما يمنح المطورين نمطًا واضحًا للاستخدام المتوافق داخل التطبيقات.
مخاطر تستحق التخطيط لها
حتى مع الأدوات القادرة، هناك بعض أنماط الفشل التي تستحق التوقع.
عادةً ما يعود الصوت غير الطبيعي أو الآلي إلى نصوص سيئة علامات الترقيم أو صوت غير متطابق مع المحتوى. الاختيار من مكتبة أصوات طبيعية وإعادة التوليد حتى يناسب الأداء هو الحل العملي، والتوليد السريع يجعل تلك التجربة رخيصة.
يميل النطق الخاطئ إلى الظهور مع الأسماء والمصطلحات التقنية والمحتوى المحلي. خط إنتاج يُشغّل التفريغ والترجمة والمراجعة — بدلًا من تحويل أعمى من صوت إلى صوت — يلتقط المزيد من هذه الأخطاء قبل نشرها.
تضر عدم مطابقة التوقيت بين الكلام المُركَّب والعناصر المرئية على الشاشة بتجربة المشاهد. الدبلجة من كلام إلى كلام التي تبقى قريبة من النبرة والتوقيت الأصليين، مقترنة بالتحرير داخل بيئة المشروع، تمنحك تحكمًا أفضل في المحاذاة.
أخلاقيًا، استنساخ صوت دون حقوق مناسبة يستدعي مشكلات جسيمة. اشتراط عينة نظيفة تحت سيطرتك، وتأطير الاستنساخ كأداة لمنشئي المحتوى والشركات بدلًا من انتحال شخصية مجهول، هو ما يبقي هذه الممارسة مسؤولة. عندما تقوم بتوطين لقطات موجودة، يوضح دليلنا حول كيفية تغيير لغة الصوت في فيديو المسار الملائم للمراجعة.
كيف يطبّق منشئو المحتوى المختلفون هذا عمليًا
يمكن لمنشئ محتوى على يوتيوب يتوسع في الخارج تحويل فيديو إنجليزي واحد إلى نسخ إسبانية وبرتغالية وألمانية باستخدام الدبلجة بالذكاء الاصطناعي وصوت مستنسخ، بحيث يبقى المضيف معروفًا عبر كل سوق — كل ذلك داخل خط إنتاج يضم أكثر من 60 لغة مصدر و33 لغة مستهدفة.
يمكن لنشاط تجاري صغير أو فريق تسويق صياغة نص توضيحي لمنتج أو نص إعلان في مستند، وتحويله إلى صوت باستخدام تحويل النص إلى كلام، واختيار صوت يطابق نبرة العلامة التجارية — نشيط أو رسمي أو حواري. يمكن توطين نفس تلك النصوص لاحقًا من خلال الدبلجة بالذكاء الاصطناعي باستخدام صوت علامة تجارية مستنسخ.
يمكن لمنتج تعليم إلكتروني أو تدريب مؤسسي أتمتة السرد للعروض التقديمية وحزم SCORM من خلال إرسال نص الدرس عبر واجهة برمجة تطبيقات TTS وإرفاق الصوت المُرجَع بكل وحدة، مع حفاظ الاستنساخ على اتساق صوت المدرّب حتى عبر النسخ الإقليمية.
يمكن لصانع أفلام مستقل أو منشئ بودكاست إنتاج مقاطع دعائية أو ترويجية أو حوارات مترجمة دون حجز استوديو بكل لغة، مع الجمع بين تحويل الكلام إلى نص والدبلجة بالذكاء الاصطناعي والأصوات المستنسخة للحفاظ على ثبات هوية الشخصية.
يمكن للمطورين والوكالات دمج واجهات برمجة تطبيقات TTS واستنساخ الصوت والدبلجة بالذكاء الاصطناعي في الأدوات الداخلية أو منصات العملاء، وأتمتة كل شيء من التعليقات الصوتية القصيرة لوسائل التواصل الاجتماعي إلى وكلاء الصوت التفاعليين.
الأسئلة الشائعة
كيف تختلف التعليقات الصوتية بالذكاء الاصطناعي عن التعليقات الصوتية المسجلة التقليدية؟
تحتاج التعليقات الصوتية التقليدية إلى ممثل صوتي بشري ووقت في الاستوديو وجلسات متعددة. أما التعليقات الصوتية بالذكاء الاصطناعي فتُولَّد بواسطة محركات تحويل النص إلى كلام واستنساخ الصوت التي تحوّل النصوص مباشرةً إلى صوت باستخدام نماذج عصبية مُدرَّبة بدلًا من أداء حي.
هل يمكن أن يبدو تعليق صوتي بالذكاء الاصطناعي مثل شخص بعينه؟
نعم. يحلل استنساخ الصوت عينة قصيرة من صوت شخص ما ويبني نموذجًا مخصصًا يمكنه نطق أي نص بذلك الصوت، ومتاح في أداة استنساخ الصوت وواجهة برمجة التطبيقات الخاصة بنا.
كم من الصوت يلزم لاستنساخ صوت؟
نطلب ما لا يقل عن 20 ثانية من الصوت النظيف، الخالي من الضوضاء الخلفية، لإنشاء ملف تعريف صوتي مستنسخ موثوق، مع اكتمال الاستنساخ عادةً في ثوانٍ.
هل يمكنني إنشاء تعليقات صوتية بلغات متعددة من فيديو مصدر واحد؟
نعم. نجمع بين تحويل الكلام إلى نص والترجمة وتحويل النص إلى كلام لتحويل المحتوى من أكثر من 60 لغة مصدر إلى مخرجات مدبلجة عبر 33 لغة مستهدفة، بحيث يمكن لفيديو أصلي واحد أن ينتج العديد من التعليقات الصوتية المحلية.
هل هناك طريقة لأتمتة إنشاء التعليقات الصوتية بدلًا من استخدام الواجهة؟
تتيح واجهة برمجة تطبيقات TTS وواجهة برمجة تطبيقات استنساخ الصوت الخاصة بنا للتطبيقات والأدوات الداخلية إرسال النصوص وعينات الصوت، وإنشاء أصوات مخصصة، واستلام كلام اصطناعي برمجيًا، بحيث يمكن توليد التعليقات الصوتية تلقائيًا على نطاق واسع.