فصل الكلام بالذكاء الاصطناعي هو عملية تعلّم عميق تستخرج صوت الإنسان من مزيج صاخب وتعيد مسارًا صوتيًا نظيفًا للكلام، جاهزًا للنسخ النصي أو الدبلجة أو استنساخ الصوت. هذه القدرة الوحيدة تجيب على السؤال الذي يشغل معظم صنّاع المحتوى فعليًا: هل يمكنني إنقاذ هذا التسجيل دون إعادة تصويره؟ فهم كيفية عمل فصل الكلام بالذكاء الاصطناعي يساعدك على تحديد متى تعتمد عليه، ومتى تسجّل بجودة أنظف من البداية، وكيف يحسّن المسار الصوتي النظيف كل شيء لاحقًا بهدوء. يستعرض هذا الدليل الآلية، والفرق بين تحسين متحدث واحد وفصل عدة متحدثين، وأين تندرج العملية ضمن خط أنابيب الترجمة والتوطين، وما الذي لا يزال عاجزًا عن إصلاحه.
جدول المحتويات
القرار الكامن وراء فصل الكلام
يلتقط أي تسجيل حقيقي أكثر بكثير من صوت المتحدث. تلتقط المدونات المصورة والندوات عبر الإنترنت وفيديوهات التدريب والبودكاست ضوضاء الشارع وأجواء الغرفة والموسيقى الخلفية ونقرات لوحة المفاتيح والثرثرة المتداخلة التي قد تدفن الكلمات المهمة. يوجد فاصل الكلام لفكّ تشابك هذا المزيج: فهو يأخذ ملفًا مختلطًا واحدًا ويعيد مسارًا يحتوي في الغالب على كلام بشري، بالإضافة إلى مسار اختياري يحمل الصوت الخلفي المتبقي.
يصبح ذلك المسار الصوتي النظيف الأساس لكل ما يأتي بعده: تحويل الكلام إلى نص بدقة، والدبلجة متعددة اللغات، واستنساخ الصوت عالي الدقة، أو ببساطة نسخة أصلية بصوت أفضل. لذا فإن القرار الحقيقي ليس تقنيًا، بل عمليًا. هل تثق في جودة الصوت الحالية بما يكفي لبناء محتوى متعدد اللغات فوقه، أم تريد أن ينظّف الذكاء الاصطناعي الكلام ويفصله أولًا؟ وهل تريد أداة تنظيف مستقلة، أم فاصلًا مدمجًا ضمن منصة إنشاء وتوطين أوسع كي لا تضطر إلى التنقل بين عدة تطبيقات؟
لقد صمّمنا فاصل الكلام ليكون البوابة الأولى للذكاء الاصطناعي ضمن سير عمل موحّد. فهو يأتي قبل تحويل الكلام إلى نص، وتحويل النص إلى كلام، واستنساخ الصوت، والدبلجة، بحيث يرى كل نظام لاحق أوضح إشارة صوتية ممكنة بدلًا من أن يرث أي ضوضاء كانت في الغرفة.
الآلية: من الموجة الصوتية إلى الصوت النظيف
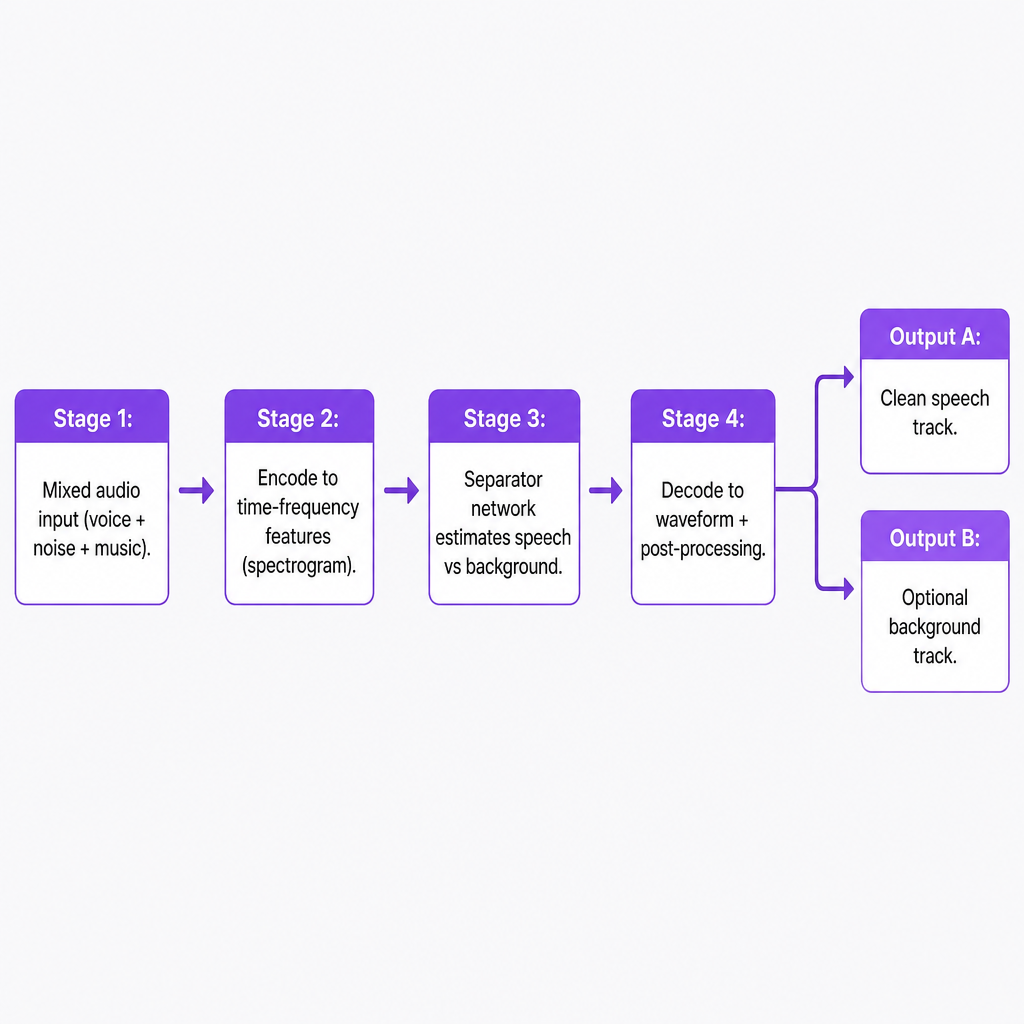
يتّبع فصل الكلام الحديث بالذكاء الاصطناعي خط أنابيب من أربع مراحل: ترميز الإشارة، وفصل المصادر في فضاء ميزات متعلّم، وتقدير الكلام النظيف، وفكّ ترميزه ليعود صوتًا.
من الموجة الصوتية إلى الميزات
تحوّل معظم الأنظمة أولًا الموجة الصوتية الخام من الميكروفون إلى تمثيل زمني-ترددي مثل الطيف الترددي، الذي يُظهر كيف تتغير الطاقة في نطاقات ترددية مختلفة عبر الزمن. يجعل هذا العرض من الأسهل على الشبكة العصبية رؤية الأنماط المقابلة للكلام البشري مقابل الضوضاء أو الموسيقى. ثم تعيّن شبكة الترميز المدخلات إلى فضاء ميزات عالي الأبعاد تصبح فيه مصادر الصوت المختلفة أكثر قابلية للتمييز، مبرزةً سمات الكلام مثل التشكيلات الصوتية (formants) والتوافقيات والبنية الزمنية بينما تكبت المحتوى الخلفي غير ذي الصلة.
شبكات الفصل والأقنعة
لبّ العملية هو شبكة الفصل، وهي نموذج عميق مدرّب للحكم على ما ينتمي إلى الصوت وما لا ينتمي عند كل نقطة زمنية-ترددية. تهيمن استراتيجيتان. يتنبأ الفصل القائم على الأقنعة بقناع للطيف الترددي يحتفظ بطاقة الكلام ويخفّض كل ما عداها؛ وعند تطبيقه على الطيف الأصلي، تنخفض ضوضاء الخلفية والموسيقى بشدة بينما يبقى الكلام. أما تقدير المصدر المباشر فيتنبأ بدلًا من ذلك بطيف الكلام النظيف نفسه، وأحيانًا بخلفية متبقية، ثم يُفكّ ترميزه ليعود صوتًا.
توجد مقاربات أكثر تخصصًا للحالات الأصعب. يتعلّم التجميع العميق تضمينًا لكل خانة زمنية-ترددية بحيث تتجمّع الخانات من المصدر نفسه معًا، وبعد ذلك يفصل التجميع القياسي الكلام عن المصادر الأخرى. تستخدم نماذج أخرى التدريب الثابت للتبديل (permutation-invariant training) كي تتمكن من فصل عدة متحدثين دون افتراض أي متحدث يمثّل المخرج الأول مقابل المخرج الثاني.
التدريب باستخدام أمثلة خاضعة للإشراف
تتعلم هذه النماذج من مزائج نموذجية مقترنة بكلام نظيف مرجعي، فتعدّل نفسها لتقليص الفجوة بين مخرجاتها والمرجع. يمكن أن تكون أهداف التدريب أقنعة أو أطياف نظيفة أو موجات صوتية معاد بناؤها، وغالبًا ما ترتبط دوال الخسارة بمقاييس الجودة الإدراكية مثل نسبة الإشارة إلى التشويه. وحين تُغذّى بعينات متنوعة كثيرة عبر لهجات وميكروفونات وبيئات مختلفة، تستوعب الشبكة إشارات قوية تفصل الكلام البشري عن المحتوى الخلفي وتعمّم على تسجيلات لم ترها من قبل.
فكّ الترميز والعودة إلى الصوت
أخيرًا يعيّن النظام تمثيل الكلام المفصول إلى موجة صوتية في المجال الزمني عبر تحويل عكسي، تليه معالجة لاحقة مثل إزالة الضوضاء وتطبيع مستوى الصوت. والنتيجة مسار يهيمن عليه الكلام يمكن أن يقف وحده أو يُعاد دمجه بكمية متحكم بها من الخلفية لأجل الطبيعية. يتّبع فاصل الكلام لدينا هذا النمط تمامًا: فهو يستوعب الصوت أو الفيديو الذي رفعته، ويشغّل خط أنابيب الفصل، ويعيد مسارًا يركّز على الكلام بالإضافة إلى خلفية اختيارية بحيث تقرر أنت مدى جفاف أو محيطية المزيج النهائي.
تحسين متحدث واحد مقابل فصل عدة متحدثين
هناك حدّ مهم بين تحسين متحدث واحد مهيمن والفصل الحقيقي لعدة أصوات متداخلة، وهو ما يحدّد ما يمكنك توقعه واقعيًا.
يعزل تحسين المتحدث الواحد صوتًا رئيسيًا واحدًا عن ضوضاء الخلفية والصدى والأصوات غير الكلامية بحيث تقفز الوضوحية. يعمل هذا بشكل جيد بوجه خاص مع المدونات المصورة والندوات عبر الإنترنت والمحاضرات ومحتوى المتحدث الظاهر، حيث تكون المشكلة ضوضاء محيطة أو موسيقى خلفية لا تداخلًا كلاميًا. فاصل الكلام لدينا محسّن لهذه الحالة: فهو يعامل الكلام البشري كمصدر أساسي وكل ما عداه كخلفية، مقدّمًا مسار صوت منظّف ومسار خلفية اختياري.
فصل عدة متحدثين مهمة مختلفة: تقسيم مزيج من عدة أشخاص يتحدثون في آنٍ واحد إلى تدفقات فردية، واحد لكل صوت. لقد فصلت النماذج البحثية ما يصل إلى خمسة أصوات من ميكروفون واحد عبر تدريب شبكات مختلفة لأعداد مختلفة من المتحدثين واختيار الأنسب لكل عينة. تدفع تقنيات مثل التجميع العميق وتشكيل الحزمة العصبي متعدد الميكروفونات الأداء أبعد في الإعدادات بعيدة المجال ومتعددة القنوات، لكنها أكثر تعقيدًا وأثقل حسابيًا. عمليًا لا تزال هذه الأنظمة تستهدف سيناريوهات متخصصة مثل نسخ الاجتماعات ومراكز الاتصال والأجهزة الذكية بدلًا من سير عمل صنّاع المحتوى اليومي. بالنسبة لمعظم مستخدمينا الذين يديرون قنوات يوتيوب أو فرق تسويق أو مكتبات دورات تدريبية، يأتي أكبر مكسب عملي من تحسين قوي للمتحدث الواحد وفصل الكلام عن الخلفية، لا من الفصل الكامل لعدة أصوات.
أين يندرج الفصل ضمن سير عمل التوطين
الفصل هو الجسر بين التسجيلات الواقعية الصاخبة وأعمال الصوت عالية الجودة بالذكاء الاصطناعي. يسير المسار النموذجي بسلاسة عبر عدة أدوات.
يرفع صانع المحتوى ملف صوت أو فيديو، فيعزل الفاصل مسار الكلام واختياريًا الخلفية. يغذّي ذلك الكلام النظيف عملية تحويل الكلام إلى نص، بحيث يعمل النسخ النصي والترجمة على إشارة واضحة، مما يحسّن الدقة ويقلل الكلمات المهلوسة الناتجة عن موسيقى أو ضوضاء ثقيلة. ثم ينتقل النص الناتج والترجمات إلى تحويل النص إلى كلام والدبلجة بالذكاء الاصطناعي، اللذين يولّدان نسخًا بلغات جديدة باستخدام أصوات مستنسخة أو اصطناعية؛ ولأن الكلام المصدر كان نظيفًا، تكون المحاذاة الزمنية أدق وتقلّ عيوب المزج مثل النبض (pumping).
يعتمد استنساخ الصوت على المدخل النظيف نفسه. تحتاج النماذج إلى أمثلة خالية نسبيًا من الضوضاء لتتعلّم نبرة المتحدث وإيقاعه ونطقه بشكل موثوق، ويقلل الفصل التلوث الخلفي الذي قد يشوّه الصوت المستنسخ. يلتقط دليلنا باللغة الإسبانية عن الفصل التجربة اليومية جيدًا: ارفع ملفًا، ودع الذكاء الاصطناعي يفصل الصوت عن الخلفية، ثم نزّل إما مسار الصوت النظيف أو الخلفية المعزولة لمزيد من التحرير أو الدبلجة أو السرد، كل ذلك داخل سير عمل واحد. هذا الدمج هو المقصود بالنسبة للفرق الصغيرة التي تضطر خلاف ذلك إلى التنقل بين إضافات منفصلة لتقليل الضوضاء وأدوات النسخ النصي وخدمات الدبلجة ومنصات الاستنساخ.
اختيار واستخدام فصل الكلام بالذكاء الاصطناعي
عندما تقرر كيفية تبنّي الفصل، تقوم حفنة من المعايير العملية بمعظم العمل.
ظروف الصوت ونوع المحتوى. مع متحدث رئيسي واحد وضوضاء أو موسيقى خلفية معتدلة، يكون الفصل فعّالًا للغاية ومنخفض المخاطر. أما مع التداخل الشديد أو الميكروفونات بعيدة المجال أو المدخلات منخفضة الجودة جدًا، فتوقّع عوائد متناقصة واقرن الذكاء الاصطناعي بتسجيل أفضل بدلًا من الاعتماد عليه لإنقاذ كل شيء.
التكامل مع الأدوات اللاحقة. الفاصل الذي يتدفق مباشرةً إلى النسخ النصي وتحويل النص إلى كلام والدبلجة يقلل الاحتكاك والعيوب التراكمية مقارنةً بالتصدير وإعادة الاستيراد بين التطبيقات. نحن نربط فاصل الكلام ببقية أدوات التوطين لدينا لهذا السبب بالذات، وهو ما يهم أكثر حين يكون هدفك النشر متعدد اللغات لا مجرد تقليل ضوضاء لمرة واحدة.
التحكم في الصوت الخلفي. في سرد قصص العلامة التجارية تريد غالبًا الاحتفاظ ببعض الأجواء أو الموسيقى لأجل التأثير العاطفي. الأنظمة التي تُخرج كلا من مسار كلام نظيف وخلفية معزولة تمنح المحررين مجالًا أوسع من الأدوات التي تنتج مزيجًا واحدًا مزال الضوضاء فقط. يدعم فاصلنا نموذج «الكلام مع خلفية اختيارية» هذا كي تتمكن من إعادة المزج بشكل متعمّد.
السرعة والبساطة والقدرة على التوسّع. بالنسبة لصنّاع المحتوى والفرق الصغيرة، تنافس سهولة الاستخدام الأداء الخام. الفصل بنقرة واحدة عبر المتصفح أو واجهة برمجة التطبيقات، مع معالجة تلقائية للتنسيقات الشائعة، يتفوق على سلاسل الإضافات المعقدة التي تفترض خبرة في هندسة الصوت. وبمجرد أن تدير مئات الفيديوهات أو وحدات الدورات، تتوقف المعالجة الدُفعية والأتمتة عن كونها رفاهية.
الموثوقية والعيوب. النموذج القوي يحسّن الوضوحية دون إضافة تشويه واضح أو رنين معدني أو عيوب في التنفّس. قد تجمّل العروض التوضيحية النظام، لذا اختبره بتسجيلاتك التمثيلية الخاصة قبل أن تجعل أي فاصل جزءًا ثابتًا من خط أنابيبك.
الخصوصية والامتثال. يعمل الفصل مباشرةً على بيانات صوتية قد تتضمن معلومات حساسة. ينبغي لفرق المؤسسات التأكد من كيفية تخزين الصوت، وما إذا كان يُستخدم لتدريب النماذج، وما هي الضوابط الموجودة للاحتفاظ والوصول، خاصةً في الصناعات المنظّمة والمحتوى التدريبي الداخلي.
وزنُ هذه المعايير مقابل حالات استخدامك الفعلية، سواء أكانت توسيع القنوات أم التدريب أم التسويق أم العمل السردي أم منتج واجهة برمجة تطبيقات، يخبرك ما إذا كان فاصل متكامل مع أدوات صوتية لاحقة يناسب طريقة عملك.
المخاطر والحدود وما لا يمكن إصلاحه
حتى النماذج القوية لها حواف صعبة تستحق المعرفة قبل أن تلتزم بها.
- الضوضاء الشديدة أو نسبة إشارة إلى ضوضاء منخفضة جدًا. عندما يكون الكلام مدفونًا تحت ضوضاء أو موسيقى عالية، قد يفشل النموذج في استعادة كل كلمة، منتجًا انقطاعات أو مخرجات مكتومة.
- التداخل الشديد بين المتحدثين. الأشخاص الذين يتحدثون في التوقيت نفسه بالضبط يتحدّون حتى أنظمة تعدد المتحدثين المتقدمة وقد يسببون تسرّب الكلام بين التدفقات المفصولة.
- عيوب الإفراط في الفصل. يمكن أن يُدخل الإخفاء العدواني ضوضاء موسيقية أو نبرة آلية، وهو ما يُلاحظ أكثر على الأصوات المستمرة والحروف الصفيرية.
- عدم التطابق بين التدريب والواقع. النماذج المضبوطة على ميكروفونات أو لغات أو بيئات معينة قد تؤدي أداءً ضعيفًا على تسجيلات مختلفة جدًا، مما يخفض بدوره دقة النسخ النصي والدبلجة.
- الأخلاقيات والحقوق. الكلام المفصول بنظافة أسهل في النسخ والتحليل وإعادة المزج، لذا يجب على الفرق احترام الموافقة والحقوق عند إعادة استخدام الأصوات في لغات أو سياقات جديدة.
الخلاصة الصادقة أن الفصل تحسين قوي، لا بديل عن عادات تسجيل معقولة. لا تزال الميكروفونات الجيدة والمستويات المعقولة والاختيارات الواعية للموقع تؤتي ثمارها، ثم يضاعف الذكاء الاصطناعي تلك الاختيارات بجعل المحتوى أكثر مرونة بكثير للتوطين وإعادة الاستخدام. إذا كنت تستكشف كيفية دمج هذا في إعداد نشر أوسع، فإن شرحنا لما هو فاصل الكلام يغطي الأساسيات بعمق أكبر.
الأسئلة الشائعة
ما هو فصل الكلام بالذكاء الاصطناعي ببساطة؟
هو عملية بالذكاء الاصطناعي تأخذ تسجيلًا مختلطًا وتعزل الكلام البشري، مانحةً إياك مسار صوت نظيفًا و، اختياريًا، مسار خلفية منفصلًا يمكنك الاحتفاظ به أو التخلص منه.
كيف يختلف فاصل الكلام لدينا عن تقليل الضوضاء الأساسي؟
يخفّض تقليل الضوضاء التقليدي بشكل رئيسي الضوضاء ثابتة الحالة. أما فاصلنا فيستخدم التعلّم العميق للتعرّف على أنماط الكلام واستخراجها من نطاق واسع من الأصوات الخلفية والموسيقى، مما يؤدي عادةً إلى حوار أنظف وأكثر طبيعية.
هل يمكنه التعامل مع عدة متحدثين؟
فاصل الكلام لدينا محسّن لعزل الكلام البشري عن الخلفيات غير الكلامية، وهو ما يعمل بشكل أفضل مع متحدث رئيسي في المزيج. تقسيم عدة أصوات متداخلة مجال بحث نشط، وتوجد نماذج متخصصة، لكنها تستهدف عادةً الاجتماعات أو مراكز الاتصال بدلًا من سير عمل صنّاع المحتوى العام.
لماذا يهم فصل الكلام للدبلجة متعددة اللغات؟
يعتمد التوطين على نسخ نصي دقيق وتوقيت دقيق. المسار الصوتي النظيف يقلل أخطاء التعرّف ويساعد التعليقات الصوتية المترجمة على المحاذاة مع الفيديو الأصلي، مقلّصًا العيوب المسموعة عند مزج أصوات جديدة مع موسيقى ومؤثرات محتفظ بها.
كم من المعرفة التقنية أحتاج لاستخدامه؟
القليل جدًا. ترفع ملف صوت أو فيديو، وتدع الذكاء الاصطناعي يعالجه، وتنزّل مسارات الكلام والخلفية المفصولة للتحرير أو الدبلجة أو الأتمتة، دون الحاجة إلى ضبط يدوي للمعاملات.