Voice cloning API là một giao diện dành cho nhà phát triển, biến một mẫu âm thanh được cấp phép thành một giọng nói tổng hợp có thể tái sử dụng, để ứng dụng có thể gửi văn bản—hoặc chạy một tác vụ lồng tiếng tự động—và nhận lại giọng nói mới giống với người nói gốc. Thay vì chọn một giọng cố định từ danh mục, mã của bạn tạo ra một danh tính giọng nói gắn với một ID duy nhất, rồi tái sử dụng nó qua các kịch bản, sản phẩm và ngôn ngữ. Chính sự thay đổi đó—từ việc chọn một giọng sang việc sở hữu một giọng theo lập trình—là điều khiến công nghệ này trở nên thú vị đối với những người sáng tạo, thương hiệu và nhà phát triển xây dựng ở quy mô lớn.
Câu trả lời ngắn gọn cho voice cloning api là gì là thế này: nó phơi bày ba khả năng liên kết với nhau—tải lên âm thanh, tạo giọng nói và tạo giọng nói—dưới dạng các endpoint mà phần mềm của bạn có thể gọi. Hiểu cách những phần này khớp với nhau là điều phân biệt một quy trình sản xuất mượt mà với một quy trình gây bực bội, nên phần còn lại của bài giải thích này sẽ đi qua cơ chế, các đánh đổi, và các câu hỏi về quyền mà bạn cần giải quyết trước khi một tệp duy nhất được đưa vào hoạt động.
Mục lục
Voice cloning API thực sự làm gì
Voice cloning API phơi bày việc nhân bản như một dịch vụ có thể lập trình thay vì một tính năng thủ công bị chôn vùi trong một trình chỉnh sửa âm thanh hoặc một bảng điều khiển web. Ứng dụng của bạn tải lên một mẫu, nhà cung cấp chuyển đổi nó thành một giọng tùy chỉnh với ID riêng, và từ đó trở đi ID đó trở thành cái "tay cầm" mà bạn truyền vào các yêu cầu chuyển văn bản thành giọng nói hoặc lồng tiếng.
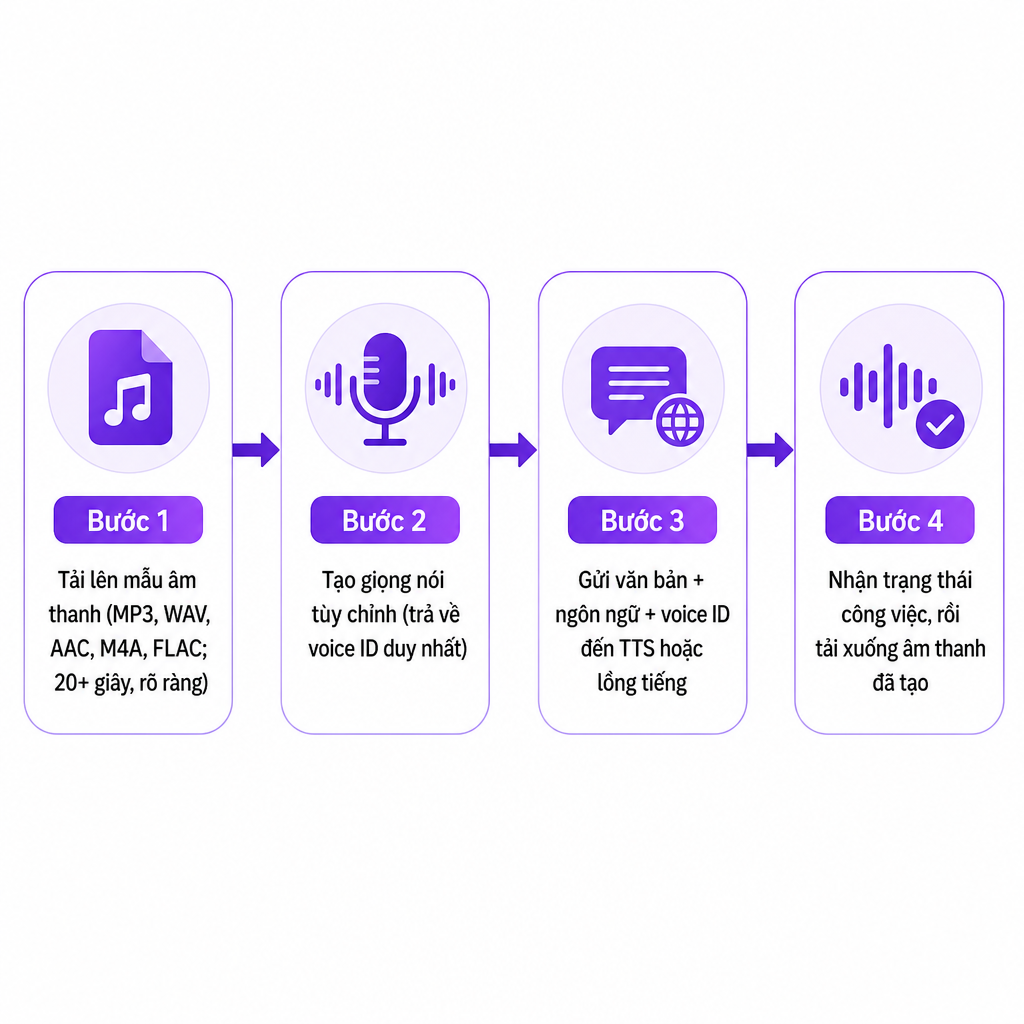
Mẫu hình này nhất quán giữa các nhà cung cấp: mẫu âm thanh trở thành ID giọng tùy chỉnh, rồi trở thành giọng nói mới từ văn bản hoặc một kịch bản đã dịch, rồi trở thành một tệp âm thanh hoàn chỉnh. Công việc học máy—phân tích tông giọng, mẫu phát âm, dải cao độ, nhịp điệu và âm sắc—diễn ra phía sau endpoint, và mô hình giọng kết quả có thể nói một kịch bản hoàn toàn mới trong khi vẫn giữ những phẩm chất dễ nhận ra của người nói tham chiếu.
Một điểm khác biệt quan trọng hơn bất kỳ điểm nào khác. API không phát lại bản ghi gốc; nó tổng hợp giọng nói mới. Một giọng nhân bản có thể nói những từ chưa từng có trong mẫu nguồn, đó chính xác là lý do nó mạnh mẽ và lý do nó đi kèm trách nhiệm.
Cách nhân bản giọng nói hoạt động phía sau API
Các nhà cung cấp triển khai mô hình khác nhau, nhưng hầu hết hệ thống đều chia sẻ những giai đoạn tổng quát giống nhau, và việc biết chúng giúp bạn thiết kế một tích hợp đáng tin cậy.
Đầu tiên, hệ thống nhận một mẫu giọng nói. Các nhà phát triển thường tải lên qua một URL tải lên được ký trước (presigned upload URL), cho phép ứng dụng gửi tệp trực tiếp đến kho lưu trữ thay vì nhồi nhét một payload âm thanh lớn vào trong yêu cầu tạo giọng nói. Âm thanh nguồn sạch rất quan trọng ở đây vì mô hình có thể học những âm thanh không mong muốn cùng với người nói: nhạc, tiếng vang phòng, nhiều người nói chồng lấn, méo tiếng và giảm nhiễu mạnh tay đều làm giảm tính nhất quán của bản nhân bản. Voice Cloning API của chúng tôi tài liệu hóa hỗ trợ MP3, WAV, AAC, M4A và FLAC, và khuyến nghị ít nhất 20 giây âm thanh không có tiếng ồn nền để có kết quả tốt nhất.
Thứ hai, nhà cung cấp tạo một giọng tùy chỉnh. Sau khi tải lên, ứng dụng gửi vị trí tệp đã lưu và một tên, và dịch vụ trả về một đối tượng giọng nói với một định danh. Định danh đó là chìa khóa cho mọi thứ tiếp theo—ứng dụng của bạn lưu trữ nó cùng với một bản ghi người dùng, dự án, nhân vật hoặc thương hiệu trong cơ sở dữ liệu riêng của mình. Tài liệu của chúng tôi tuân theo mẫu hình này với một endpoint tạo, cộng với các endpoint để liệt kê giọng tùy chỉnh có phân trang và để xóa một giọng tùy chỉnh theo ID.
Thứ ba, ứng dụng tạo giọng nói mới. Một khi giọng tùy chỉnh đã tồn tại, mã của bạn gửi văn bản, một ngôn ngữ và ID giọng tùy chỉnh đến một endpoint chuyển văn bản thành giọng nói. Dịch vụ trả về một định danh dự án hoặc tác vụ; ứng dụng sau đó thăm dò trạng thái tác vụ cho đến khi xử lý hoàn tất và lấy URL âm thanh kết quả. TTS API của chúng tôi tài liệu hóa việc tạo dựa trên dự án với các trạng thái đang chờ, đang xử lý, hoàn thành và thất bại, và phơi bày các giá trị giọng nói, ngôn ngữ, tốc độ và cao độ ở cấp độ từng đoạn riêng lẻ.
Nếu bạn muốn tìm hiểu sâu hơn về cơ chế của phần tạo, bài giải thích của chúng tôi về text to speech API là gì và cách nó hoạt động phân tích quy trình tổng hợp mà một giọng nhân bản cuối cùng điều khiển.
Voice cloning API so với API chuyển văn bản thành giọng nói và API lồng tiếng
Ba API này có liên quan nhưng giải quyết các vấn đề khác nhau, và việc nhầm lẫn chúng dẫn đến kiến trúc sai.
| Loại API | Đầu vào chính | Đầu ra chính | Phù hợp nhất với |
|---|---|---|---|
| API chuyển văn bản thành giọng nói | Văn bản cộng một giọng đã chọn | Giọng nói tổng hợp | Thuyết minh, cảnh báo, trợ lý, âm thanh theo kịch bản |
| Voice cloning API | Mẫu âm thanh | ID giọng tùy chỉnh | Tạo một danh tính giọng nói có thể tái sử dụng |
| API lồng tiếng AI | Video hoặc âm thanh cộng cài đặt ngôn ngữ | Media đã dịch, đã lồng tiếng | Bản địa hóa video và âm thanh đa ngôn ngữ |
Trên thực tế, một voice cloning API hiếm khi hoạt động một mình. Endpoint nhân bản tạo ra giọng nói; một endpoint chuyển văn bản thành giọng nói sử dụng ID giọng đó để nói văn bản mới. Cùng ID giọng đó cũng có thể chảy vào một quy trình lồng tiếng, nơi hệ thống dịch đối thoại gốc và tạo ra phần trình diễn đã dịch bằng giọng tùy chỉnh đã chọn. Chúng tôi mô tả các giọng tùy chỉnh của mình là có thể sử dụng trong cả dự án TTS và Lồng tiếng AI, đó là điều cho phép một mẫu 20 giây phục vụ cả thuyết minh và bản địa hóa từ cùng một danh tính. Về kiến trúc cụ thể cho lồng tiếng, xem bài giải thích đồng hành của chúng tôi về API lồng tiếng AI là gì, và về họ rộng hơn của các endpoint giọng nói, hướng dẫn của chúng tôi về voice AI API là gì.
Bạn có thể xây dựng gì với nó
Một voice cloning API xứng đáng có vị trí của nó khi cùng một giọng phải được tạo ra lặp đi lặp lại, qua nhiều kịch bản, sản phẩm hoặc ngôn ngữ. Một vài mẫu hình cụ thể cho thấy nó phù hợp ở đâu.
Một người sáng tạo YouTube có thể ghi một mẫu giọng nói và tái sử dụng giọng kết quả cho các phiên bản video được bản địa hóa, tạo thuyết minh cho các thị trường ngôn ngữ khác nhau mà không cần ghi lại mọi kịch bản. Bản nhân bản không loại bỏ nhu cầu rà soát bản dịch—tên, thành ngữ, câu đùa và các tham chiếu văn hóa vẫn cần được con người kiểm tra—nhưng nó loại bỏ nút thắt cổ chai trong việc ghi âm.
Một công ty có thể tạo một người thuyết minh nhất quán cho các video giải thích sản phẩm, video giới thiệu, quảng cáo và nội dung trợ giúp, thay vì gán một giọng khác nhau cho mỗi chiến dịch. Bước thực tế trước khi sản xuất là một chính sách sử dụng giọng nói: phòng ban nào có thể sử dụng giọng nói, nội dung nào cần phê duyệt, và liệu thuyết minh tổng hợp có phải được công bố hay không.
Các nhóm đào tạo có được khả năng cập nhật bài học nhanh chóng khi một chính sách, chi tiết sản phẩm hoặc quy trình thay đổi, giữ sự liền mạch qua một thư viện khóa học lớn. Đối với các chủ đề nhạy cảm, việc rà soát của con người vẫn là thiết yếu, vì một giọng được tạo ra nghe tự tin ngay cả khi kịch bản sai. Các nhà sản xuất podcast có thể giữ một giọng dẫn chương trình hoặc nhân vật nhất quán cho phần mở đầu, đính chính, tóm tắt hoặc các phiên bản ngôn ngữ thay thế, điều này hữu ích khi một chỉnh sửa nhỏ nếu không sẽ cần cả một buổi ghi âm mới. Và các nhà phát triển xây dựng trò chơi, ứng dụng giáo dục, công cụ trợ năng hoặc trải nghiệm có hướng dẫn có thể biến giọng nói thành một phần của quy trình hiện có thay vì xuất âm thanh thủ công cho mỗi phản hồi.
Cách đánh giá một voice cloning API
Nhà cung cấp phù hợp phụ thuộc vào yêu cầu sản xuất của bạn, chứ không phải vào việc một bản demo đơn lẻ nghe bóng bẩy ra sao. Hãy làm qua các khía cạnh dưới đây trước khi bạn cam kết.
Yêu cầu đầu vào âm thanh. Xác nhận các định dạng tệp được hỗ trợ, độ dài mẫu tối thiểu hoặc được khuyến nghị, liệu nhiều người nói có bị từ chối không, cách xử lý tiếng ồn nền, liệu các tải lên có được chấp nhận trực tiếp không, và liệu các tệp tham chiếu có thể bị xóa sau khi nhân bản không. Chúng tôi liệt kê MP3, WAV, AAC, M4A và FLAC là các định dạng được hỗ trợ và khuyến nghị một mẫu sạch ít nhất 20 giây.
Chất lượng và tính nhất quán của giọng nói. Kiểm tra giọng nói với nhiều hơn một câu. Bao gồm các câu ngắn và dài, số và ngày tháng, danh từ riêng, câu hỏi và câu cảm thán, từ vựng kỹ thuật, và những từ khó phát âm. Một bản nhân bản mê hoặc trong một bản demo ngắn có thể đi lạc trong thuyết minh dài hoặc một ngôn ngữ xa lạ.
Hỗ trợ ngôn ngữ và bản địa hóa. Nếu đầu ra đa ngôn ngữ là mục tiêu, hãy xác minh các ngôn ngữ nguồn và đích được hỗ trợ, liệu giọng tùy chỉnh có thể nói từng ngôn ngữ không, hành vi về giọng điệu và phát âm, và liệu giọng nói có giữ được tính dễ nhận ra qua các ngôn ngữ không. TTS API của chúng tôi công khai nêu rõ hơn 300 giọng AI qua hơn 33 ngôn ngữ và phương ngữ, bao gồm tiếng Anh, Bồ Đào Nha, Tây Ban Nha, Pháp, Đức, Trung và Nhật. Chúng tôi không công bố một danh mục ngôn ngữ đầy đủ trên trang đó, vì vậy hãy xác nhận sự kết hợp giọng-và-ngôn ngữ chính xác trước khi bạn khóa một quy trình sản xuất.
Kiến trúc API. Một API sẵn sàng cho sản xuất nên cung cấp cách xử lý có thể dự đoán được cho xác thực, tải lên, tạo giọng nói, liệt kê, xóa, trạng thái dự án, thử lại, lỗi xác thực, phân trang, lấy âm thanh và giám sát sử dụng. Chúng tôi trình bày xác thực bằng Bearer-token trong các ví dụ của mình và tài liệu hóa cả các endpoint quản lý giọng nói lẫn xử lý TTS dựa trên dự án.
Tạo đồng bộ so với không đồng bộ. Các yêu cầu ngắn có thể trả về nhanh, nhưng nội dung dài hơn được xử lý tốt hơn như một tác vụ: gửi yêu cầu, nhận một ID tác vụ, thăm dò hoặc nhận trạng thái, rồi tải xuống âm thanh. Một thiết kế không đồng bộ ngăn một yêu cầu web khỏi hết thời gian chờ trong khi một thuyết minh dài hoặc một lô lớn các đoạn được dựng. Tài liệu TTS của chúng tôi sử dụng trạng thái dự án và các giá trị tiến độ, và dự án đã hoàn thành trả về một URL âm thanh cùng với các URL âm thanh cho từng đoạn.
Kiểm soát đầu ra và chỉnh sửa. Kiểm tra định dạng và chất lượng đầu ra, liệu tốc độ lấy mẫu có thể cấu hình không, liệu tốc độ và cao độ có điều chỉnh được không, liệu các đoạn riêng lẻ có thể tải xuống không, liệu một đoạn thất bại có thể được tạo lại mà không cần chạy lại toàn bộ dự án không, và liệu các URL âm thanh là tạm thời hay vĩnh viễn. Chúng tôi tài liệu hóa đầu ra MP3 ở 22 kHz cho TTS API và phơi bày các điều khiển tốc độ và cao độ ở cấp độ đoạn.
Kiểm soát xóa và dữ liệu. Một nhà cung cấp nên cho phép bạn xóa âm thanh tham chiếu đã tải lên, giọng tùy chỉnh đã tạo, các tệp âm thanh đã tạo và dữ liệu dự án liên quan. Voice Cloning API của chúng tôi bao gồm một endpoint xóa cho các giọng tùy chỉnh và nêu rõ rằng người dùng có thể xóa các giọng tùy chỉnh và âm thanh liên quan. Hãy xem lại các điều khoản về quyền riêng tư hiện hành và các cam kết lưu giữ trước khi tải lên các bản ghi bí mật hoặc nhạy cảm về mặt thương mại.
Quyền, mạo danh và sử dụng có trách nhiệm
Nhân bản một giọng nói là một quyết định về quyền, quyền riêng tư và mạo danh cũng nhiều như là một quyết định kỹ thuật, và việc coi nó chỉ như là mã là cách các nhóm gặp rắc rối.
Bắt đầu với sự cho phép. Chỉ sử dụng một bản ghi khi bạn có quyền nhân bản và sử dụng giọng của người nói đó. Đối với một quy trình kinh doanh, sự đồng ý bằng văn bản nên đề cập đến việc tạo một giọng tổng hợp, sử dụng thương mại, các ngôn ngữ và lãnh thổ, thời hạn giấy phép, nội dung quảng cáo và chính trị, các mục đích đào tạo và dịch vụ khách hàng, liệu giọng nói có thể được cấp phép lại không, và cách nó sẽ được xóa hoặc ngừng sử dụng. Việc tìm thấy một bản ghi trực tuyến không cấp cho bạn quyền nhân bản nó.
Đề phòng mạo danh, vì một giọng tổng hợp có thể làm cho một yêu cầu gian lận nghe có vẻ đáng tin. FTC đã cảnh báo rằng những kẻ lừa đảo có thể nhân bản giọng của một người thân hoặc một giám đốc điều hành để gây áp lực buộc mọi người gửi tiền hoặc chia sẻ thông tin. Các biện pháp bảo vệ hợp lý bao gồm hạn chế ai có thể tạo hoặc truy cập một giọng tùy chỉnh, yêu cầu phê duyệt trước khi công bố âm thanh đã tạo, ghi nhật ký hoạt động tạo, tách biệt thông tin xác thực phát triển và sản xuất, áp dụng giới hạn tần suất, chặn các danh mục nội dung rủi ro cao, và yêu cầu một kênh xác minh thứ hai cho các yêu cầu tài chính.
Đối với khán giả ở Mỹ, việc gọi điện ra ngoài tăng thêm sức nặng pháp lý. FCC nêu rõ rằng các giọng nói do AI tạo ra thuộc phạm vi các hạn chế của Đạo luật Bảo vệ Người tiêu dùng Qua Điện thoại đối với giọng nói nhân tạo hoặc được ghi âm trước, và các cuộc gọi như vậy nhìn chung yêu cầu sự đồng ý rõ ràng trước đó trừ khi có ngoại lệ áp dụng. Một voice cloning API không phải là giấy phép để tự động hóa tiếp thị qua điện thoại, thu hồi nợ, các cuộc gọi chính trị, hoặc các giao tiếp nhạy cảm về danh tính. Bạn có thể đọc phán quyết của FCC về các giọng robocall do AI tạo ra và cảnh báo cho người tiêu dùng của FTC về nhân bản giọng nói trực tiếp.
Cuối cùng, nhân bản thay đổi cách truyền đạt, không phải sự thật. Một giọng nói chân thực làm cho một tuyên bố không chính xác nghe có thẩm quyền, vì vậy hãy rà soát tên và số, bản dịch, bất kỳ tuyên bố y tế, tài chính hoặc pháp lý nào, hướng dẫn sản phẩm, phát âm, thời gian, và văn bản trên màn hình trước khi phát hành. Đối với video đa ngôn ngữ, hãy kiểm tra cả kịch bản đã dịch lẫn âm thanh cuối cùng—một bản nhân bản tốt không thể cứu vãn một bản dịch sai.
Voice cloning API có phù hợp với dự án của bạn không?
Một voice cloning API là lựa chọn mạnh mẽ khi bạn cần cùng một giọng qua nhiều tệp, bạn đã có một quy trình văn bản, dịch thuật hoặc media đáng tin cậy, bạn muốn tạo theo lập trình thay vì xuất thủ công thỉnh thoảng, bạn nắm giữ sự cho phép có tài liệu để sử dụng giọng tham chiếu, bạn sản xuất nội dung được bản địa hóa hoặc cá nhân hóa ở quy mô lớn, và bạn có thể kiểm tra và rà soát âm thanh đã tạo trước khi phát hành.
Một giọng TTS định sẵn có thể phục vụ bạn tốt hơn khi tốc độ, tính đơn giản và rủi ro pháp lý thấp quan trọng hơn tính liền mạch thương hiệu. Một diễn viên lồng tiếng chuyên nghiệp thường là lựa chọn đúng đắn cho các chiến dịch chủ lực, các màn trình diễn tinh tế, các chủ đề nhạy cảm, hoặc công việc cần sự chỉ đạo đầy đủ của con người. Đối với các nhóm cần cả giọng tùy chỉnh lẫn bản địa hóa ở một nơi, chúng tôi trình bày nhân bản, TTS và lồng tiếng AI như các khả năng API được liên kết: Voice Cloning API của chúng tôi xây dựng một giọng tùy chỉnh từ một mẫu, và TTS API của chúng tôi sử dụng các ID giọng để tạo giọng nói bên trong một quy trình dự án. Khi bạn đã sẵn sàng để kết nối nó, hướng dẫn chi tiết của chúng tôi về cách tích hợp một voice cloning API bao gồm chi tiết các bước tải lên-tạo-sinh.
Đánh giá hữu ích nhất là một bài kiểm tra có kiểm soát: sử dụng một mẫu sạch, được cấp phép, tạo cùng một kịch bản trong các ngôn ngữ dự định của bạn, kiểm tra chất lượng và độ trễ, xác minh các điều khiển vòng đời và xóa của API, và yêu cầu phê duyệt của con người trước khi bất cứ thứ gì được công bố.
Câu hỏi thường gặp
Voice cloning API có giống với trình tạo giọng nói AI không?
Không. Một trình tạo giọng nói AI thường cho phép bạn chọn một giọng tổng hợp hiện có và tạo giọng nói từ văn bản. Một voice cloning API tạo ra một giọng tùy chỉnh từ một mẫu âm thanh, sau đó bạn có thể tái sử dụng để tạo giọng nói.
Cần bao nhiêu âm thanh để nhân bản một giọng nói?
Yêu cầu khác nhau tùy theo nhà cung cấp và mô hình. Chúng tôi khuyến nghị ít nhất 20 giây âm thanh sạch và hỗ trợ các định dạng đầu vào MP3, WAV, AAC, M4A và FLAC.
Một giọng nhân bản có thể nói một ngôn ngữ khác không?
Đôi khi. Nó phụ thuộc vào mô hình của nhà cung cấp, các ngôn ngữ nó hỗ trợ, và khả năng của giọng nói chuyển đổi qua các ngôn ngữ. Hãy xác minh sự kết hợp giọng-ngôn ngữ chính xác thay vì cho rằng mọi bản nhân bản đều hoạt động tốt như nhau ở mọi nơi.
Tôi có thể sử dụng một giọng nhân bản cho lồng tiếng AI không?
Có, khi nhà cung cấp kết nối nhân bản với lồng tiếng. Chúng tôi cho phép các giọng tùy chỉnh được sử dụng trong các dự án Lồng tiếng AI bằng cách tham chiếu ID giọng.
Nhân bản giọng nói có hợp pháp không?
Bản thân công nghệ không tự động là bất hợp pháp, nhưng việc sử dụng giọng của ai đó mà không được phép có thể tạo ra các vấn đề về quyền riêng tư, quyền công khai, hợp đồng, gian lận và bảo vệ người tiêu dùng. Hãy xin phép, tuân thủ các luật áp dụng, và tránh mạo danh lừa dối.