Một voice AI API là kết nối có thể lập trình cho phép ứng dụng của bạn tạo ra, hiểu, chuyển đổi hoặc bản địa hóa âm thanh giọng nói bằng các mô hình AI mà bạn không cần phải tự xây dựng. Bạn gửi văn bản, âm thanh hoặc video đến một endpoint và nhận lại một thứ hữu ích: lời thuyết minh tổng hợp, một bản chép lời, một giọng nói tùy chỉnh, hoặc một video đã được lồng tiếng hoàn chỉnh. Câu hỏi thực sự khi bạn bắt đầu không phải là liệu bạn có cần "giọng nói AI" hay không—mà là khả năng giọng nói nào sản phẩm của bạn thực sự cần, bởi vì tạo giọng nói, nhận diện giọng nói, nhân bản giọng nói và lồng tiếng là những sản phẩm khác biệt tình cờ chia sẻ cùng một tên danh mục.
Hướng dẫn này đi qua ý nghĩa của thuật ngữ, các loại API chính và cách chúng khác nhau, cách một yêu cầu di chuyển qua pipeline, các tiêu chí quyết định phân biệt một lựa chọn phù hợp với một sai lầm tốn kém, và những rủi ro đáng quản lý trước khi bạn triển khai. Đây là trung tâm cho loạt bài về nhà phát triển và API của chúng tôi, vì vậy bạn sẽ tìm thấy các liên kết đến các hướng dẫn tích hợp chuyên sâu hơn ở nơi chúng hữu ích.
Mục lục
"Voice AI API" thực sự có nghĩa là gì
Cụm từ này gộp ba ý tưởng. Voice AI là trí tuệ nhân tạo làm việc với giọng nói con người hoặc tạo ra giọng nói tổng hợp. API là một giao diện lập trình ứng dụng—một cách xác định để hai hệ thống phần mềm trao đổi các yêu cầu và phản hồi. Sự kết hợp này có nghĩa là quá trình xử lý mô hình nặng diễn ra ở phía nhà cung cấp, trong khi ứng dụng của bạn xử lý trải nghiệm người dùng, các quy tắc kinh doanh của bạn, và nội dung cuối cùng.
Một yêu cầu có thể đơn giản như một payload JSON ngắn với văn bản bạn muốn được đọc, một mã định danh giọng nói, và một mã ngôn ngữ. Phản hồi thường trả về một mã định danh dự án, một trạng thái xử lý, và một URL đến âm thanh được tạo ra khi nó sẵn sàng. Đối với bản địa hóa video, yêu cầu thay vào đó tham chiếu đến một tệp đã tải lên và một danh sách các ngôn ngữ đích.
Cấu trúc đó là điều phân biệt một API với một trình tạo giọng nói dựa trên trình duyệt. Một ứng dụng web được xây dựng để một người vận hành bằng tay, từng công việc một. Một API được xây dựng để phần mềm gọi lặp đi lặp lại, tự động, và ở quy mô lớn. Nếu bạn đang tạo một lời thuyết minh thỉnh thoảng, công cụ web thường nhanh hơn. Nếu bạn đang bản địa hóa mọi video bạn xuất bản, API là điểm mấu chốt.
Năm loại voice AI API chính
"Voice AI API" là một danh mục, không phải một công nghệ. Năm loại phổ biến nhận các đầu vào khác nhau và trả về các đầu ra khác nhau, và việc chọn sai loại sẽ lãng phí thời gian tích hợp. Bảng dưới đây ánh xạ chúng để bạn có thể khớp nguyên liệu khởi đầu của mình với kết quả bạn muốn.
| Loại API | Đầu vào | Đầu ra | Công dụng điển hình |
|---|---|---|---|
| Chuyển văn bản thành giọng nói | Văn bản viết | Âm thanh giọng nói tổng hợp | Thuyết minh, trợ năng, lời nhắc ứng dụng, đào tạo |
| Chuyển giọng nói thành văn bản | Giọng nói hoặc video | Bản chép lời | Phụ đề, tìm kiếm, ghi chú cuộc họp, tái sử dụng |
| Nhân bản giọng nói | Mẫu giọng nói được ủy quyền | Giọng nói tổng hợp tùy chỉnh | Giọng thương hiệu, người dẫn chương trình định kỳ, thuyết minh đa ngôn ngữ |
| Lồng tiếng AI | Video hoặc âm thanh | Phương tiện được dịch và lồng tiếng | Bản địa hóa YouTube, khóa học, phim, podcast |
| Chuyển giọng nói thành giọng nói | Giọng nói được ghi lại | Giọng nói được chuyển đổi hoặc dịch | Chuyển đổi giọng nói, sản xuất đa ngôn ngữ |
Quy tắc lựa chọn khá đơn giản. Nếu bạn đã có một kịch bản, chuyển văn bản thành giọng nói thường là con đường đơn giản nhất. Nếu bạn có một bản ghi âm cần một bản chép lời, bạn cần chuyển giọng nói thành văn bản. Nếu bạn muốn cùng một người dẫn chương trình trên nhiều ngôn ngữ, nhân bản giọng nói hoặc lồng tiếng phù hợp hơn. Để có một bài giải thích tập trung chỉ về khía cạnh TTS, hướng dẫn đồng hành của chúng tôi về một text to speech API là gì đi sâu hơn vào pipeline tổng hợp.
Một sự khác biệt đáng chú ý: nhân bản giọng nói không phải là bộ biến đổi giọng nói. Một bộ biến đổi giọng nói chuyển đổi một màn trình diễn hiện có tại chỗ, trong khi nhân bản tạo ra một mô hình giọng nói có thể tái sử dụng để tạo ra giọng nói mới từ văn bản hoặc một đầu vào được kiểm soát khác.
Cách một yêu cầu di chuyển qua pipeline
Các triển khai khác nhau, nhưng hầu hết các voice API đều tuân theo cùng bốn giai đoạn. Hiểu hình dạng của luồng này tiết kiệm hàng giờ phỏng đoán khi một thứ gì đó trả về một trạng thái bất ngờ.
Đầu tiên, ứng dụng của bạn xác thực. Nó gửi một khóa API hoặc bearer token trong header của yêu cầu. Ví dụ, TTS API của DubSmart sử dụng một REST endpoint với xác thực bearer-token và các yêu cầu JSON đối với URL cơ sở https://dubsmart.ai/api/v1. Một quy tắc quan trọng hơn nghe có vẻ: không bao giờ đặt một khóa riêng tư trong JavaScript phía trình duyệt hoặc trong một ứng dụng di động được phân phối. Lưu trữ nó trên một máy chủ bảo mật và để client của bạn gọi máy chủ đó.
Thứ hai, ứng dụng của bạn gửi nội dung và cài đặt. Một yêu cầu thường mang một số kết hợp giữa văn bản hoặc tham chiếu tệp, ngôn ngữ nguồn và đích, một voice ID, tốc độ hoặc cao độ, thông tin người nói, tùy chọn đầu ra, và metadata dự án. Đối với TTS đơn giản, nội dung là văn bản. Đối với lồng tiếng, API thường yêu cầu tải lên video trước, sau đó một yêu cầu riêng để tạo dự án.
Thứ ba, dịch vụ xử lý nội dung. Tùy thuộc vào nhiệm vụ, điều đó có thể có nghĩa là chuẩn hóa và diễn giải văn bản, dự đoán cách phát âm và ngữ điệu, dịch nội dung được nói, tách người nói hoặc cô lập giọng nói khỏi âm thanh nền, tạo âm thanh với một giọng nói tiêu chuẩn hoặc tùy chỉnh, và đồng bộ hóa kết quả với một dòng thời gian video. Các công việc dài hơn chạy bất đồng bộ: thay vì trả về một tệp hoàn chỉnh, API trả về một project ID.
Thứ tư, ứng dụng của bạn truy xuất kết quả—một URL âm thanh hoặc video, các URL phân đoạn riêng lẻ, một bản chép lời, văn bản được dịch, dữ liệu thời gian, và các trường trạng thái hoặc lỗi. TTS API của DubSmart ghi lại các trạng thái dự án như pending, processing, completed, và failed, và các dự án đã hoàn thành có thể trả về các URL MP3 ở cấp độ dự án hoặc phân đoạn.
Đồng bộ và bất đồng bộ: sự khác biệt định hình việc xây dựng của bạn
Cách một API trả về kết quả quyết định cách bạn kiến trúc xung quanh nó, vì vậy hãy quyết định điều này trước khi bạn viết mã tích hợp.
Một API đồng bộ giữ yêu cầu mở cho đến khi quá trình xử lý kết thúc, sau đó trả về kết quả. Điều đó hoạt động tốt cho văn bản ngắn, lời nhắc giọng nói ngắn, các đoạn âm thanh nhỏ, và các tính năng tương tác, độ trễ thấp. Điểm yếu của nó là các công việc dài có thể vượt quá thời gian chờ của yêu cầu.
Một API bất đồng bộ trả về một project hoặc job ID ngay lập tức. Sau đó, ứng dụng của bạn thăm dò một status endpoint hoặc nhận một webhook khi công việc hoàn thành. Mô hình này phù hợp với thuyết minh dài, lồng tiếng video, nhiều ngôn ngữ đích, tạo hàng loạt, và các tệp lớn. Các quy trình TTS và lồng tiếng được ghi lại của DubSmart sử dụng các trạng thái dự án và truy xuất kết quả, đó là một mô hình bất đồng bộ được xây dựng cho các công việc phương tiện.
Khi bạn đánh giá một lựa chọn, hãy kiểm tra xem nó có hỗ trợ webhook hay không. Thăm dò mỗi vài giây thì dễ triển khai, nhưng webhook cắt giảm các yêu cầu không cần thiết và mở rộng tốt hơn khi bạn chạy nhiều công việc cùng một lúc.
Những điều cần đánh giá trước khi cam kết
API phù hợp phụ thuộc vào công việc, nhưng một số ít tiêu chí áp dụng cho hầu hết mọi dự án. Hãy xem xét chúng một cách có chủ đích thay vì tin tưởng vào một bản demo ngắn.
Sự phù hợp về khả năng. Xác nhận API hỗ trợ chính xác nhiệm vụ—chuyển văn bản thành giọng nói, chuyển giọng nói thành văn bản, nhân bản giọng nói, lồng tiếng, nhiều người nói, đầu ra chỉ âm thanh hoặc video, thời gian thực hoặc hàng loạt. Đừng cho rằng bất cứ thứ gì được tiếp thị là "voice AI" đều bao gồm tất cả những điều này.
Phạm vi ngôn ngữ. Kiểm tra ngôn ngữ nguồn và đích. "Hỗ trợ 30 ngôn ngữ" có thể có nghĩa là 30 giọng nói TTS, 30 mục tiêu dịch, hoặc một hỗn hợp các ngôn ngữ và phương ngữ. Đối với một kênh đa ngôn ngữ, cũng cần cân nhắc chất lượng giọng điệu, cách phát âm tên và địa danh, từ vựng vùng miền, khả năng có giọng nói theo từng ngôn ngữ, và liệu một giọng nói được nhân bản có mang được qua các ngôn ngữ hay không.
Hỗ trợ đầu ra và phương tiện. Xác minh các định dạng âm thanh, container video, tần số lấy mẫu và bitrate, tải xuống theo cấp độ phân đoạn, video được render đầy đủ, khả năng có bản chép lời hoặc phụ đề, và kích thước tệp tối đa. Những điều này định hình quy trình chỉnh sửa và chi phí lưu trữ của bạn.
Chất lượng và khả năng kiểm soát. Lắng nghe các khoảng dừng tự nhiên, cách phát âm chính xác, âm lượng ổn định, nhận diện người nói nhất quán, nhấn mạnh phù hợp, và thời gian chính xác. Một giọng nói có thể nghe hoàn hảo trong một mẫu mười giây và vấp phải các thuật ngữ kỹ thuật, các đoạn văn dài, số, hoặc các tên bất thường. Hãy kiểm tra nội dung đại diện, không phải đoạn clip được chọn lựa kỹ càng của nhà cung cấp.
Độ trễ và thông lượng. Đo thời gian so với khối lượng công việc thực tế của bạn. Một lời thuyết minh ngắn và hàng trăm video được bản địa hóa là những vấn đề khác nhau. Hãy hỏi liệu quá trình xử lý là thời gian thực hay bất đồng bộ, giới hạn tốc độ là gì, liệu các công việc có chạy song song hay không, liệu có xử lý ưu tiên hay không, và các lỗi được thử lại như thế nào. DubSmart cho biết một video năm phút điển hình mất khoảng một phút để xử lý, lưu ý rằng thời gian phụ thuộc vào độ dài và kích thước tệp.
Mô hình định giá. Các voice API có thể tính phí theo ký tự, từ, thời lượng âm thanh hoặc video, tín dụng, yêu cầu, lưu trữ, hoặc các công việc đồng thời. Đối với lồng tiếng, số lượng ngôn ngữ đích nhân lên chi phí hiệu quả. Hãy tính toán một quy trình làm việc hoàn chỉnh—thử lại, các phân đoạn được tạo lại, xem xét dịch, lưu trữ—không chỉ cuộc gọi đầu tiên. Phân tích của chúng tôi về giá voice AI API đi qua phép toán tín dụng một cách chi tiết.
Những rủi ro đáng quản lý sớm
Voice AI giới thiệu các chế độ lỗi không tồn tại trong công cụ phương tiện thông thường. Giải quyết chúng trong quá trình thiết kế rẻ hơn nhiều so với sau một sai lầm công khai.
Sử dụng giọng nói trái phép. Nhân bản giọng nói của một người mà không có sự cho phép tạo ra rủi ro pháp lý, đạo đức, và uy tín. Hãy sử dụng một quy trình đồng ý bằng văn bản nêu rõ ai sở hữu bản ghi âm, những gì có thể được tạo ra, nơi giọng nói có thể được sử dụng, liệu có cho phép sử dụng thương mại hay không, cách giọng nói được xóa, và điều gì xảy ra khi thỏa thuận kết thúc.
Dịch hoặc phát âm không chính xác. Giọng nói được tạo ra có thể xử lý sai tên, từ viết tắt, địa chỉ, và thuật ngữ ngành. Hãy giữ sự xem xét của con người trong quy trình đối với nội dung hướng đến công chúng: một lần đọc kịch bản được dịch, một lần nghe của người bản ngữ, kiểm tra ngẫu nhiên cách phát âm, một lần kiểm tra thời gian và chuyển động môi, và một lần xem xét cuối cùng của phương tiện được xuất.
Giả mạo và lừa đảo. Giọng nói tổng hợp có thể bị lạm dụng cho các vụ lừa đảo hoặc chứng thực giả. Tránh tạo ra bất cứ thứ gì có thể khiến một người nghe hợp lý tin rằng một người thật đã nói điều gì đó mà họ không nói. Đối với các giao tiếp nhạy cảm, hãy thêm công khai, kiểm soát phê duyệt, và nhật ký kiểm tra.
Quyền riêng tư về giọng nói và dữ liệu. Các mẫu có thể chứa dữ liệu cá nhân. Trước khi tải lên, hãy giải quyết sự đồng ý, các quy tắc lưu giữ, các hạn chế truy cập, các thủ tục xóa, các điều khoản xử lý dữ liệu của nhà cung cấp, và bất kỳ chính sách sử dụng thứ cấp nào. DubSmart cho biết các tệp nhân bản được tải lên được mã hóa và rằng người dùng có thể xóa các giọng nói tùy chỉnh và dữ liệu âm thanh liên quan, mặc dù các nhóm vẫn nên xác nhận các điều khoản và kiểm soát hiện tại cho gói cụ thể của họ.
Thay đổi của nhà cung cấp và mô hình. Voice ID, hỗ trợ ngôn ngữ, định dạng đầu ra, và giới hạn tốc độ có thể thay đổi. Hãy coi API như một phụ thuộc bên ngoài: cố định cấu hình ở nơi bạn có thể, lưu trữ các kịch bản nguồn, lưu âm thanh đã được phê duyệt, giám sát tỷ lệ lỗi, giữ một quy trình dự phòng, và kiểm tra lại sau các cập nhật lớn của nhà cung cấp. Đối với các nhóm muốn ít phần động hơn, tổng quan của chúng tôi về các công cụ video AI tất cả trong một giải thích các đánh đổi của việc hợp nhất các khả năng này.
Khi nào một API vượt trội hơn quy trình thủ công
Một voice AI API xứng đáng với chi phí tích hợp của nó khi bạn cần sản xuất có thể lặp lại, theo lập trình. Nó phù hợp mạnh mẽ khi một nhà sáng tạo xuất bản các phiên bản được bản địa hóa của mọi video, một doanh nghiệp nhỏ tạo ra thuyết minh sản phẩm trên nhiều ngôn ngữ, một công ty e-learning cập nhật hàng trăm bài học, một podcast phát hành các phiên bản được dịch, một sản phẩm phần mềm thêm trợ năng bằng giọng nói, hoặc một agency kết nối việc tạo giọng nói vào hệ thống quản lý nội dung của nó.
Một quy trình studio thủ công vẫn có thể thắng trong các trường hợp cụ thể: khi một dự án phụ thuộc vào một màn trình diễn của con người cực kỳ tinh tế, khi phê duyệt pháp lý yêu cầu một diễn viên chuyên nghiệp, khi nội dung mang các tuyên bố nhạy cảm, khi một bản ghi âm một lần nhanh hơn việc xây dựng một tích hợp, hoặc khi kết quả cần sự chỉ đạo nghệ thuật nhiều. Vấn đề không phải là thay thế mọi giọng nói con người. Mà là tự động hóa các phần mà sự nhất quán, tốc độ, quy mô, hoặc đầu ra đa ngôn ngữ quan trọng nhất.
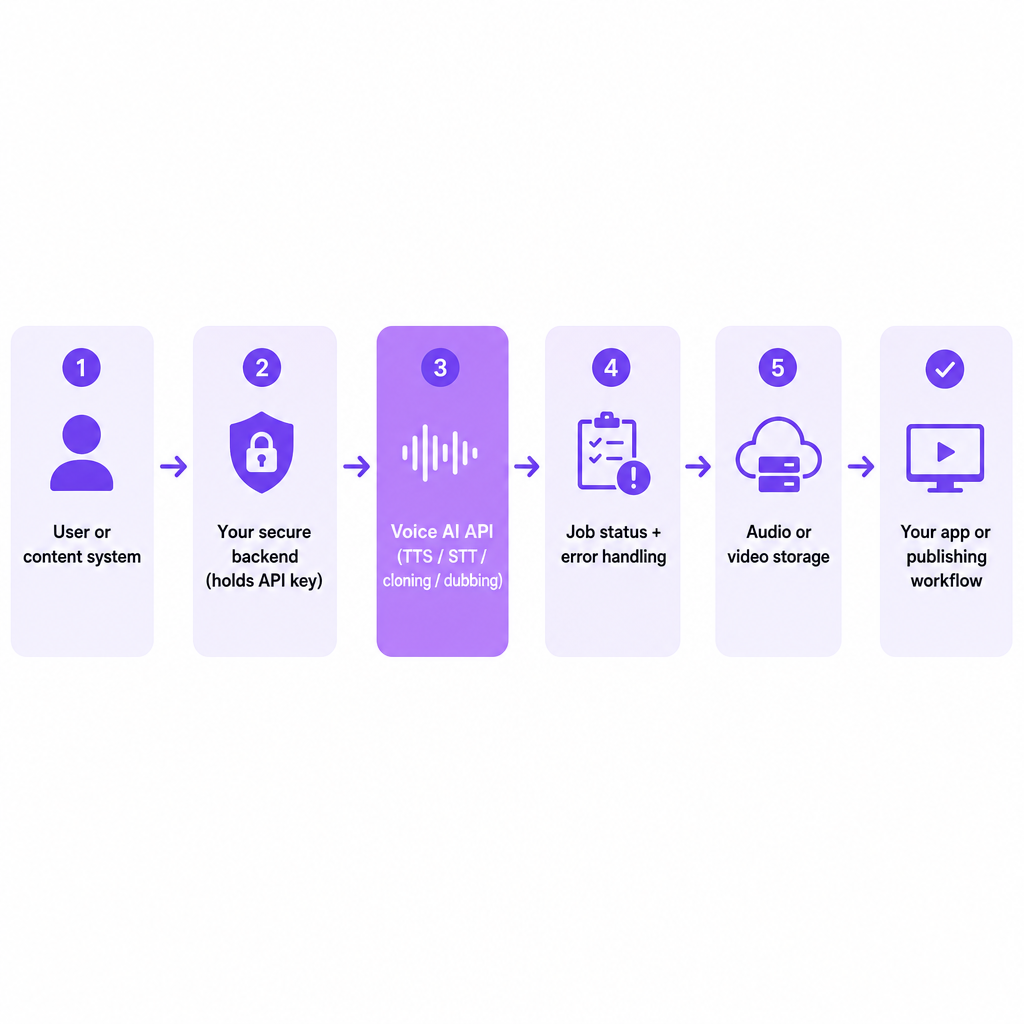
Đối với một bản xây dựng nhỏ, hãy giữ kiến trúc đơn giản. Một backend bảo mật nằm giữa người dùng hoặc hệ thống nội dung của bạn và voice API. Backend đó giữ thông tin xác thực riêng tư, xác thực đầu vào, tạo dự án, lưu trữ job ID, thăm dò trạng thái hoặc nhận webhook, thử lại các lỗi tạm thời, lưu các URL kết quả và metadata, áp dụng giới hạn sử dụng, và ghi lại sự đồng ý cho bất kỳ giọng nói được nhân bản nào. Một phiên bản hướng đến nhà sáng tạo có thể chấp nhận một video tiếng Anh đã hoàn thành, gửi nó đến một dubbing endpoint cho các ngôn ngữ đã chọn, chờ hoàn thành, định tuyến các kết quả đến một thư mục xem xét, và chỉ xuất bản sau khi được phê duyệt.
Vị trí của DubSmart
Chúng tôi xây dựng một số khả năng API liên quan đến giọng nói vào một nền tảng phương tiện AI, điều này quan trọng nhất khi bạn muốn kết nối việc tạo ra và bản địa hóa với một quy trình làm việc hiện có thay vì chạy từng công việc bằng tay.
Text to Speech API của chúng tôi cung cấp việc tạo giọng nói theo lập trình với các giọng nói neural, nhân bản giọng nói, hỗ trợ đa ngôn ngữ, theo dõi trạng thái dự án, và kết quả MP3—yêu cầu ví dụ của nó sử dụng các phân đoạn văn bản với một voice ID, ngôn ngữ, tốc độ, và cao độ. Voice Cloning API của chúng tôi tuân theo một mô hình ba bước: yêu cầu một URL tải lên được ký trước, tải lên một mẫu âm thanh, sau đó tạo một giọng nói tùy chỉnh từ khóa tệp đã tải lên; nó chấp nhận MP3, WAV, AAC, M4A, và FLAC, và chúng tôi khuyến nghị ít nhất 20 giây âm thanh sạch để có kết quả tốt hơn. AI Dubbing API của chúng tôi xử lý bản địa hóa video với việc tạo dự án đa ngôn ngữ, cài đặt người nói, các phân đoạn được dịch, và đầu ra lồng tiếng có thể tải xuống, chấp nhận các đầu vào như MP4, MOV, AVI, MKV, và WebM lên đến 5GB.
Nếu bạn đang cân nhắc nên bắt đầu với endpoint nào, hãy khớp nó với nội dung của bạn: thuyết minh có kịch bản hướng đến TTS, một giọng nói định kỳ được ủy quyền hướng đến nhân bản, và video đa ngôn ngữ hướng đến lồng tiếng.
Câu hỏi thường gặp
Một voice AI API là gì theo cách đơn giản?
Đó là một kết nối cho phép phần mềm tạo ra, nhận diện, nhân bản, dịch, hoặc chuyển đổi giọng nói mà không cần xây dựng hệ thống giọng nói AI của riêng nó. Ứng dụng của bạn gửi một yêu cầu và nhận âm thanh, văn bản, hoặc video đã được xử lý.
Một voice AI API có giống với chuyển văn bản thành giọng nói không?
Không. Chuyển văn bản thành giọng nói là một loại voice AI API. Danh mục này cũng bao gồm nhận diện giọng nói, nhân bản giọng nói, lồng tiếng, và các chức năng chuyển giọng nói thành giọng nói.
Tôi có cần kinh nghiệm lập trình để sử dụng một cái không?
Thường là có một chút, bởi vì các API liên quan đến xác thực, các yêu cầu HTTP, JSON, tải lên tệp, và xử lý trạng thái. Đối với các công việc thủ công thỉnh thoảng, một ứng dụng web không cần mã thường dễ dàng hơn.
Một voice AI API có thể dịch một video YouTube không?
Một dubbing API có thể dịch và tạo âm thanh mới cho một video khi nó hỗ trợ các ngôn ngữ nguồn và đích cần thiết, định dạng tệp, và quy trình đầu ra. Hãy xem xét kết quả trước khi xuất bản.
Tôi có thể nhân bản giọng nói của bất kỳ ai không?
Về mặt kỹ thuật là có thể không giống với được phép về mặt pháp lý hoặc đạo đức. Chỉ nhân bản một giọng nói khi có sự cho phép phù hợp, và tuân theo các quy tắc của nhà cung cấp, các hợp đồng của bạn, và các yêu cầu về quyền riêng tư và công khai hiện hành.