Nếu bạn đã tìm đến comfyui text to speech với kỳ vọng về một nút bấm duy nhất biến kịch bản thành âm thanh, điều đầu tiên đáng biết là ComfyUI hoàn toàn không phải một công cụ tạo giọng nói. Nó là một không gian làm việc dựa trên node, nơi bạn kết nối văn bản, giọng nói, mô hình, ngôn ngữ và đầu ra âm thanh lại với nhau thành một đồ thị có thể tái sử dụng. Bản thân giọng nói đến từ bất kỳ node TTS nào bạn kết nối: một nhà cung cấp lưu trữ, một tích hợp đối tác chính thức, hoặc một mô hình cục bộ do bạn tự cài đặt. Vậy câu hỏi thực sự quan trọng không phải là liệu ComfyUI có đọc được kịch bản của bạn hay không, vì nó làm được, mà là liệu một đồ thị trực quan có phải là nơi phù hợp cho công việc bạn cần lặp lại hay không.
Sự phân biệt đó định hình mọi quyết định khác trên trang này. ComfyUI tưởng thưởng cho sự thử nghiệm và các pipeline đa phương thức, nơi phần thuyết minh đứng cạnh việc tạo hình ảnh, video và âm thanh. Một công cụ chuyên về giọng nói tưởng thưởng cho việc sản xuất lặp lại được, khi bạn chỉ đơn giản cần những bản lồng tiếng sạch sẽ lặp đi lặp lại. Dưới đây, chúng tôi phân tích cách quy trình hoạt động, những loại tùy chọn nào tồn tại, cách đánh giá chúng, và khi nào một đồ thị không còn đáng để bảo trì.
Mục lục
ComfyUI text to speech thực sự là gì
ComfyUI text to speech là việc sử dụng một đồ thị ComfyUI để chuyển đổi văn bản viết thành đầu ra AUDIO. Tài liệu chính thức mô tả ComfyUI là một ứng dụng mã nguồn mở, dựa trên node để xây dựng các quy trình trong việc tạo hình ảnh, video, âm thanh và 3D, và các node âm thanh của nó kết nối các dịch vụ hoặc mô hình giọng nói bên ngoài vào chính khung làm việc trực quan đó.
Một đồ thị giọng nói hoạt động thì nhỏ gọn. Nó cần một đầu vào văn bản hoặc prompt, một node TTS, một đầu vào giọng nói hoặc âm thanh tham chiếu, các cài đặt ngôn ngữ và cách truyền tải tùy chọn, và một node xem trước hoặc lưu âm thanh. Node TTS đẩy kịch bản của bạn qua một mô hình giọng nói và trả về âm thanh được tạo ra mà các node sau có thể sử dụng.
Hệ quả thực tế là ComfyUI là lớp quy trình, không phải mô hình. Giọng nói thực tế có thể được tạo bởi một nhà cung cấp lưu trữ, một mô hình âm thanh đối tác, một node tùy chỉnh của bên thứ ba, hoặc một hệ thống cài đặt cục bộ. Hiểu được sự phân chia đó là điều giúp kỳ vọng của bạn chính xác: bạn đang lắp ráp một pipeline, và bạn vẫn chọn công cụ bên trong nó.
Quy trình bốn giai đoạn hoạt động như thế nào
Bỏ qua tên các node, mọi đồ thị giọng nói ComfyUI đều thực hiện cùng bốn việc theo trình tự.
Đầu tiên, kịch bản đến dưới dạng văn bản. Node TTS có thể nhận trực tiếp văn bản thuần túy, hoặc văn bản có thể đến từ một node khác tải, dịch, hoặc phân đoạn một kịch bản dài hơn. Việc chia một bài thuyết minh dài thành các phần logic cho phép bạn tạo lại một đoạn văn mà không cần xây dựng lại toàn bộ bản lồng tiếng, và nó giúp bạn nằm trong giới hạn đầu vào của nhà cung cấp.
Thứ hai, quy trình chọn một giọng nói và một mô hình. Tùy thuộc vào nhà cung cấp, đó có thể là một người nói định sẵn, một giọng nhân bản, một ID giọng nói, hoặc một bản ghi tham chiếu. Lựa chọn mô hình cũng quyết định tốc độ, chất lượng, phạm vi biểu cảm và chi phí. Ví dụ, node HeyGen của ComfyUI cung cấp cả heygen-voice-1 và một bản heygen-voice-1-turbo nhanh hơn, chi phí thấp hơn, trong khi node ElevenLabs hiển thị các tùy chỉnh như độ ổn định, tốc độ và phong cách.
Thứ ba, mô hình giọng nói tổng hợp âm thanh. Các hệ thống thần kinh hiện đại ước tính cách phát âm, nhịp điệu, khoảng ngắt và biến chuyển cao độ thay vì ghép nối các từ đã được ghi sẵn, và chúng trả về một dạng sóng mà bạn có thể định tuyến đi tiếp: lưu vào tệp, trộn với nhạc, đưa vào một đồ thị video, hoặc ghép với một avatar.
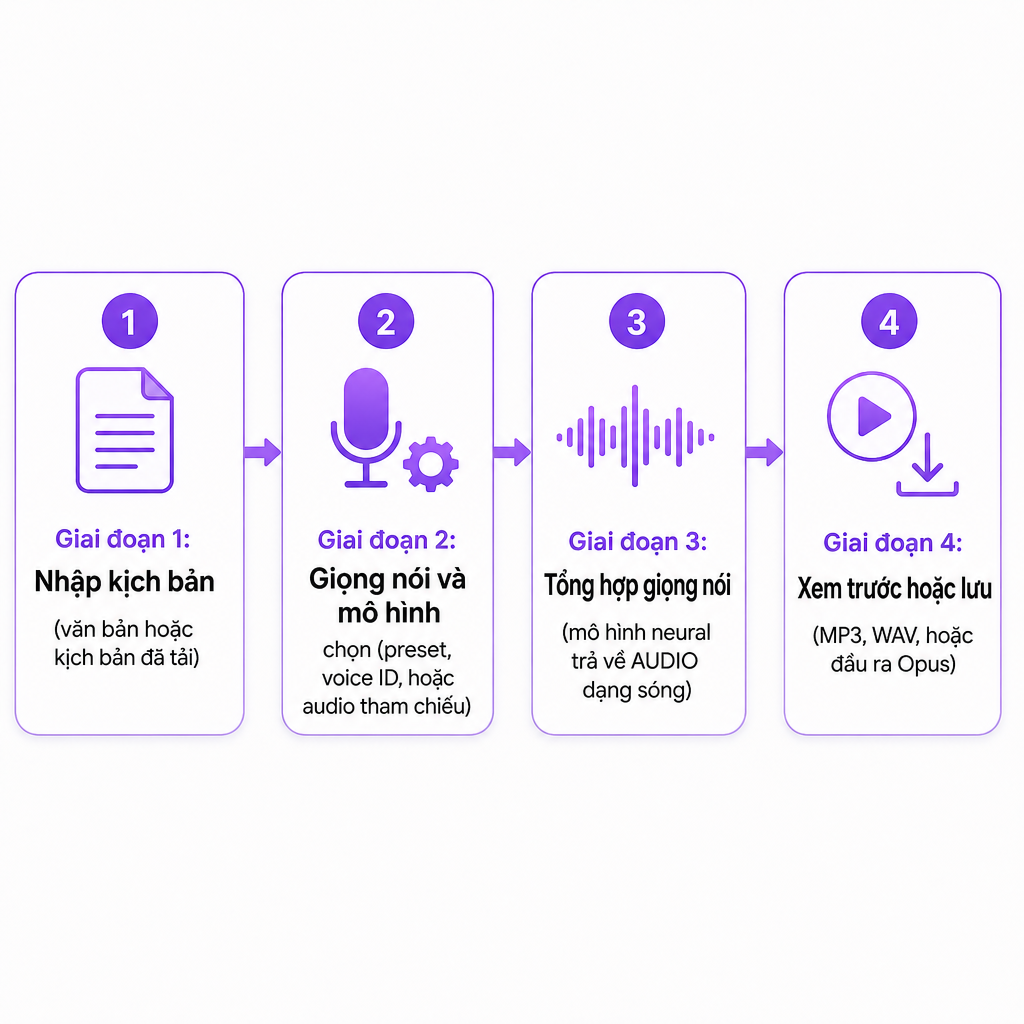
Thứ tư, âm thanh được xem trước hoặc lưu lại. Các node TTS thường phát ra một đối tượng AUDIO kết nối tới một node xem trước hoặc lưu, với định dạng tệp được thiết lập bởi node và nhà cung cấp; ví dụ, tài liệu node ElevenLabs liệt kê các định dạng có thể chọn bao gồm các biến thể MP3 và Opus. Vì đồ thị là trực quan, vòng lặp dễ dàng chạy lại: thay đổi kịch bản, giọng nói, ngôn ngữ, hoặc mô hình, rồi đưa vào hàng đợi lần nữa.
Ba cách chạy TTS trong ComfyUI
Không có một phương pháp giọng nói ComfyUI duy nhất, và sự khác biệt nằm ở thiết lập, khả năng kiểm soát, quyền riêng tư, và mức độ bảo trì mà bạn sẵn sàng đảm nhận.
Các node nhà cung cấp lưu trữ gửi văn bản và cài đặt giọng nói của bạn đến một dịch vụ bên ngoài và trả về âm thanh hoàn chỉnh. Đây thường là con đường nhanh nhất đến giọng nói chất lượng cao vì mô hình chạy trên hạ tầng của nhà cung cấp. Node HeyGen Voice 1.0 minh họa cho mô thức này: nó yêu cầu một ID giọng nhân bản hợp lệ, gửi văn bản và ID đến HeyGen, và trả về giọng nói. Các đánh đổi cũng có thể đoán trước, vì có thể cần tài khoản hoặc kết nối API, việc sử dụng có thể tiêu tốn tín dụng của nhà cung cấp, văn bản và âm thanh của bạn được xử lý bởi bên thứ ba, và giới hạn hoặc giá cả của nhà cung cấp có thể thay đổi.
Các node âm thanh đối tác chính thức mở rộng cùng ý tưởng đó trên nhiều phần hơn của không gian âm thanh. Tài liệu âm thanh của ComfyUI phân tách việc tạo text-to-audio khỏi các trường hợp sử dụng giọng nói và lời nói, bao gồm giọng nói từ văn bản và từ âm thanh tham chiếu. Những tích hợp này tỏa sáng khi đồ thị của bạn đã dựa vào các mô hình truyền thông lưu trữ khác, vì chúng giảm bớt việc di chuyển tệp giữa các ứng dụng riêng biệt.
Các node TTS cộng đồng và cục bộ kết nối ComfyUI với các hệ thống như Edge TTS, Kokoro, Index-TTS, và các mô hình khác có thể chạy cục bộ. Các quy trình cục bộ có thể cho bạn nhiều quyền kiểm soát hơn đối với dữ liệu và lựa chọn mô hình, nhưng chúng đòi hỏi nhiều hơn để đổi lại: cài đặt, phần cứng tương thích, tải mô hình, và khắc phục sự cố. Một node cục bộ không tự động tốt hơn một node lưu trữ. Lợi thế thực sự của nó phụ thuộc vào việc máy của bạn có thể chạy mô hình hiệu quả hay không, chất lượng giọng nói có giữ vững hay không, ngôn ngữ của bạn có được hỗ trợ hay không, giấy phép có cho phép sử dụng thương mại hay không, và liệu bạn có thể giữ cho quy trình hoạt động theo thời gian hay không.
Nhân bản giọng nói và các tùy chỉnh bạn có thể mong đợi
Nhân bản giọng nói thêm một danh tính tham chiếu vào đồ thị thay vì một người nói có sẵn. Cấu trúc thường gồm hai phần được kết nối: một node nhân bản tạo ra hoặc trả về một danh tính giọng nói, và một node TTS sử dụng danh tính đó để đọc văn bản mới. Tài liệu HeyGen mô tả điều này một cách trực tiếp, nơi một node Instant Clone tạo ra một voice_id đưa vào node Voice 1.0 Text to Speech; quy trình nhân bản đó yêu cầu ít nhất 10 giây giọng nói rõ ràng, và node TTS chấp nhận tối đa 5.000 ký tự mỗi yêu cầu.
Chỉ nhân bản khi có sự cho phép. Đừng sao chép giọng nói của một người thật chỉ vì bạn có thể tiếp cận một bản ghi âm. Hãy xin phép, giữ bằng chứng về điều đó, và công bố giọng nói tổng hợp hoặc nhân bản ở bất cứ đâu mà ngữ cảnh có thể gây hiểu lầm cho khán giả.
Ngoài bản thân giọng nói, các tùy chỉnh bạn sẽ gặp thay đổi theo node và mô hình, nhưng một tập hợp quen thuộc lặp lại ở hầu hết chúng.
- Giọng nói: danh tính người nói hoặc giọng định sẵn
- Ngôn ngữ: ngôn ngữ được dùng để diễn giải kịch bản
- Tốc độ: phần thuyết minh được truyền tải nhanh đến mức nào
- Cao độ: mức độ cao hay thấp cảm nhận được của giọng nói
- Phong cách và tính biểu cảm: đặc tính truyền tải và mức độ cảm xúc được áp dụng mạnh đến đâu
- Độ ổn định: giọng nói giữ các đặc tính của nó nhất quán đến mức nào
- Định dạng đầu ra: chẳng hạn như MP3, WAV, hoặc Opus
- Âm thanh tham chiếu: một bản ghi được dùng để nhân bản hoặc biến đổi giọng nói
Một số mô hình đi xa hơn với các gợi ý nội tuyến. Tài liệu node Fish Audio hỗ trợ các gợi ý cảm xúc và thẻ hội thoại đa người nói trong các mô hình được hỗ trợ. Một lưu ý áp dụng cho tất cả: các tùy chỉnh này không thể hoán đổi giữa các nhà cung cấp, và một cài đặt gọi là phong cách trong một node có thể hoạt động hoàn toàn khác với phong cách trong một node khác.
ComfyUI so với một nền tảng TTS chuyên dụng
ComfyUI xứng đáng với vị trí của nó khi giọng nói là một phần của một pipeline truyền thông lớn hơn. Một nền tảng chuyên dụng thường chiến thắng khi công việc thực sự duy nhất là biến kịch bản thành bản thuyết minh trau chuốt mà không cần lắp ráp một đồ thị.
| Yếu tố quyết định | ComfyUI | Nền tảng TTS chuyên dụng |
|---|---|---|
| Tính linh hoạt của quy trình | Cao; kết nối TTS với các node truyền thông khác | Thường tập trung vào sản xuất giọng nói |
| Thiết lập | Có thể cần node, liên kết nhà cung cấp, hoặc cài đặt mô hình | Thường nhanh hơn cho lần tạo đầu tiên |
| Lựa chọn giọng nói | Phụ thuộc vào các node đã cài hoặc kết nối | Thường là một thư viện giọng nói được tổ chức |
| Tự động hóa | Mạnh cho các đồ thị trực quan tái sử dụng được | Thường qua API hoặc công cụ hàng loạt |
| Xử lý cục bộ | Có thể với các node và mô hình cục bộ | Thường dựa trên đám mây |
| Trường hợp sử dụng tốt nhất | Các pipeline thử nghiệm hoặc đa phương thức | Thuyết minh và sản xuất lặp lại được |
Đối với những người sáng tạo đang xây dựng một pipeline trực quan kết hợp giọng nói với xử lý hình ảnh, video, hoặc âm thanh, đồ thị xứng đáng với công sức bỏ ra. Đối với thuyết minh YouTube, lồng tiếng học trực tuyến, podcast, hoặc các nhóm bản địa hóa cần một giao diện dự đoán được, một dịch vụ chuyên biệt thường loại bỏ gánh nặng kỹ thuật. Quy trình Text to Speech của chúng tôi được xây dựng xoay quanh việc tạo trực tiếp từ kịch bản thành âm thanh, với hơn 300 giọng AI, nhân bản giọng nói trên 33 ngôn ngữ, tốc độ nói điều chỉnh được, gợi ý hội thoại cảm xúc, và các dự án có thể tải xuống. Khi việc tạo phải nằm bên trong một ứng dụng hoặc một pipeline nội dung tự động, Text to Speech API của chúng tôi xử lý phần tích hợp, và AI Dubbing API của chúng tôi mở rộng cùng ý tưởng đó sang video được dịch, khớp giọng nói.
Cách lựa chọn và khắc phục sự cố cho thiết lập của bạn
Trước khi cam kết với một node hoặc mô hình, hãy thực hiện một vài kiểm tra có chủ đích thay vì tin tưởng một bản demo ngắn.
Đánh giá chất lượng giọng nói trên một mẫu khó, không phải một mẫu dễ. Hãy tạo một đoạn văn bao gồm tên, con số, từ viết tắt, câu dài, câu hỏi, thuật ngữ thương hiệu, và ít nhất một câu cảm xúc bằng ngôn ngữ và giọng điệu mục tiêu của bạn. Một giọng nói quyến rũ bạn trong một câu ngắn có thể làm hỏng tên sản phẩm hoặc mất nhịp điệu qua một đoạn văn.
Kiểm tra hỗ trợ ngôn ngữ và giọng điệu theo từng ngôn ngữ, không phải tổng thể. Một số hệ thống phát hiện ngôn ngữ tự động trong khi những hệ thống khác cần bạn thiết lập, và tài liệu node HeyGen khuyến nghị thiết lập ngôn ngữ thủ công cho các ngôn ngữ có quan hệ gần gũi nơi việc phát hiện tự động có thể không đáng tin cậy. Hãy nhớ rằng một giọng nói trôi chảy không thể cứu vãn một bản dịch thiếu chính xác; chất lượng giọng nói và chất lượng dịch là những vấn đề riêng biệt.
Đo lường khả năng kiểm soát phát âm cho những từ thực sự khiến các công cụ vấp ngã: tên sản phẩm, danh từ riêng, chữ viết tắt, ngày tháng, tiền tệ, và từ vựng kỹ thuật. Nếu một node không cung cấp từ điển phát âm hoặc các tùy chỉnh kiểu SSML, hãy dự định viết lại văn bản theo phiên âm hoặc viết số ra thành chữ. Đối với một chuỗi hoặc kênh có thương hiệu, cũng hãy kiểm tra tính nhất quán bằng cách chạy cùng một giọng nói qua nhiều lần tạo, tông giọng, và các phần được tạo lại, vì các lần chạy ComfyUI riêng biệt cho các cảnh khác nhau có thể bị lệch.
Cân nhắc độ trễ, chi phí, quyền riêng tư và quyền hạn cùng nhau. Các node lưu trữ bắt đầu nhanh nhưng phụ thuộc vào tốc độ mạng, khả năng sẵn sàng của nhà cung cấp, giới hạn tài khoản, và giá cả theo mỗi lần sử dụng, trong khi các mô hình cục bộ tránh được phí theo mỗi yêu cầu nhưng đòi hỏi phần cứng và bảo trì; hãy so sánh tổng chi phí sản xuất, không phải mức giá được quảng cáo. Về quyền riêng tư, hãy xác nhận cách đầu vào được lưu trữ, liệu nội dung có huấn luyện mô hình hay không, liệu dữ liệu giọng nói có thể bị xóa hay không, liệu sử dụng thương mại có được phép hay không, ai sở hữu đầu ra, và giọng nhân bản yêu cầu sự đồng ý nào.
Khi một đồ thị trục trặc, các lỗi tụ lại thành một danh sách ngắn. Một node giọng nhân bản trả về lỗi thường có voice_id rỗng hoặc không hợp lệ; node HeyGen dừng lại chính vì lý do đó. Các kịch bản quá dài chạm giới hạn, và node HeyGen Voice 1.0 được ghi trong tài liệu chấp nhận tối đa 5.000 ký tự đồng thời cảnh báo rằng giọng nói rất dài có thể thất bại, đặc biệt với văn bản tiếng Trung hoặc tiếng Nhật kéo dài, vì vậy hãy chia thuyết minh thành các phần logic. Phát âm sai thường đáp ứng với việc viết lại số thành chữ, thêm dấu câu, hoặc đánh vần từ viết tắt. Đầu ra quá biểu cảm đòi hỏi giảm tính biểu cảm, phong cách, hoặc biến thiên cao độ. Và khi âm thanh không kết nối được xuống hạ nguồn, hãy kiểm tra kiểu, vì một đầu ra AUDIO không thể đưa vào một node mong đợi hình ảnh, video, hoặc văn bản mà không có bước chuyển đổi. Cuối cùng, hãy lưu một đồ thị sạch sẽ với các node được đặt tên và các cài đặt được ghi lại, vì nhà cung cấp, voice ID, ngôn ngữ, và định dạng đầu ra bạn đã dùng là những chi tiết mà bạn-trong-tương-lai sẽ cần.
Các câu hỏi thường gặp
ComfyUI có phải là một công cụ text-to-speech không?
ComfyUI là một ứng dụng quy trình dựa trên node chứ không phải một công cụ TTS duy nhất. Nó có thể tạo giọng nói thông qua các node tích hợp sẵn, các tích hợp đối tác, và các node TTS cộng đồng hoặc cục bộ.
ComfyUI có thể nhân bản một giọng nói không?
Có, nếu tích hợp hoặc node tùy chỉnh được chọn hỗ trợ nhân bản. Các yêu cầu ghi âm cụ thể, quy trình voice-ID, giới hạn, và điều khoản thương mại phụ thuộc vào nhà cung cấp.
ComfyUI text to speech có hoạt động ngoại tuyến không?
Nó có thể khi bạn sử dụng một mô hình TTS cục bộ tương thích và các node cục bộ. Các node nhà cung cấp lưu trữ cần kết nối internet và có thể gửi dữ liệu văn bản hoặc giọng nói đến nhà cung cấp.
Node TTS ComfyUI tốt nhất là gì?
Không có node tốt nhất phổ quát. Hãy chọn dựa trên hỗ trợ ngôn ngữ, chất lượng giọng nói, nhu cầu nhân bản, quyền riêng tư, chi phí, độ trễ, và tính tương thích với phần còn lại của quy trình của bạn.
Tôi có thể dùng ComfyUI TTS cho video YouTube không?
Có. Hãy tạo bài thuyết minh, kiểm tra phát âm và quyền hạn, xuất âm thanh, và đồng bộ nó với video của bạn. Nếu bạn sử dụng một giọng nhân bản hoặc tổng hợp, hãy tuân theo các yêu cầu về sự đồng ý, công bố, và nền tảng áp dụng.