Eğer comfyui metinden sese konusuna, bir metni sese dönüştüren tek bir düğme beklentisiyle geldiyseniz, bilmeniz gereken ilk şey ComfyUI'nin aslında hiç bir ses motoru olmadığıdır. Burası, metni, bir sesi, bir modeli, dili ve bir ses çıkışını yeniden kullanılabilir bir grafikte birbirine bağladığınız düğüm tabanlı bir çalışma alanıdır. Konuşmanın kendisi, bağladığınız herhangi bir TTS düğümünden gelir: barındırılan bir sağlayıcı, resmi bir ortak entegrasyonu veya kendiniz kurduğunuz yerel bir model. O halde asıl önemli olan soru, ComfyUI'nin metninizi seslendirip seslendiremeyeceği değil, çünkü seslendirebilir, görsel bir grafiğin tekrarlamanız gereken iş için doğru yer olup olmadığıdır.
Bu ayrım, bu sayfadaki diğer her kararı şekillendirir. ComfyUI; anlatımın görüntü, video ve ses üretiminin yanında yer aldığı denemeleri ve çok modlu hatları ödüllendirir. Özel bir konuşma aracı ise, tekrar tekrar temiz seslendirmelere ihtiyaç duyduğunuz tekrarlanabilir üretimi ödüllendirir. Aşağıda, iş akışının nasıl çalıştığını, hangi seçenek türlerinin bulunduğunu, bunları nasıl değerlendireceğinizi ve bir grafiğin bakımının ne zaman değmeyeceğini açıklıyoruz.
İçindekiler
ComfyUI metinden ses aslında nedir
ComfyUI metinden ses, yazılı metni bir AUDIO çıkışına dönüştürmek için bir ComfyUI grafiği kullanma uygulamasıdır. Resmi dokümantasyon, ComfyUI'yi görüntü, video, ses ve 3D üretimi genelinde iş akışları oluşturmak için açık kaynaklı, düğüm tabanlı bir uygulama olarak tanımlar ve ses düğümleri, harici konuşma servislerini veya modellerini bu aynı görsel tuvale bağlar.
Çalışan bir konuşma grafiği küçüktür. Bir metin veya istem girişine, bir TTS düğümüne, bir ses veya referans-ses girişine, isteğe bağlı dil ve sunum ayarlarına ve bir ses önizleme veya kaydetme düğümüne ihtiyaç duyar. TTS düğümü, metninizi bir konuşma modelinden geçirir ve sonraki düğümlerin kullanabileceği üretilmiş sesi geri verir.
Pratikteki sonuç, ComfyUI'nin iş akışı katmanı olduğu, model olmadığıdır. Asıl ses, barındırılan bir sağlayıcı, bir ortak ses modeli, üçüncü taraf bir özel düğüm veya yerel olarak kurulmuş bir sistem tarafından üretilebilir. Bu ayrımı anlamak, beklentilerinizi doğru tutan şeydir: bir hat kuruyorsunuz ve içindeki motoru yine siz seçiyorsunuz.
Dört aşamalı iş akışı nasıl çalışır
Düğüm adlarını bir kenara bırakırsanız, her ComfyUI konuşma grafiği sırayla aynı dört şeyi yapar.
İlk olarak, metin olarak senaryo gelir. TTS düğümü düz metni doğrudan alabilir veya metin, daha uzun bir senaryoyu yükleyen, çeviren ya da bölümleyen başka bir düğümden akabilir. Uzun bir anlatımı mantıksal bölümlere ayırmak, tüm seslendirmeyi yeniden oluşturmadan bir paragrafı yeniden üretmenizi sağlar ve bir sağlayıcının giriş üst sınırının altında kalmanıza yardımcı olur.
İkinci olarak, iş akışı bir ses ve bir model seçer. Sağlayıcıya bağlı olarak bu; önceden ayarlanmış bir konuşmacı, klonlanmış bir ses, bir ses kimliği veya bir referans kayıt olabilir. Model seçimi ayrıca hızı, kaliteyi, ifade aralığını ve maliyeti de belirler. Örneğin ComfyUI'nin HeyGen düğümü hem heygen-voice-1 hem de daha hızlı, daha düşük maliyetli heygen-voice-1-turbo seçeneklerini sunarken, ElevenLabs düğümü kararlılık, hız ve stil gibi kontrolleri gösterir.
Üçüncü olarak, konuşma modeli sesi sentezler. Modern nöral sistemler, önceden kaydedilmiş kelimeleri birleştirmek yerine telaffuzu, ritmi, duraklamaları ve perde hareketini tahmin eder ve ileriye yönlendirebileceğiniz bir dalga formu döndürür: bir dosyaya kaydedilmiş, müzikle karıştırılmış, bir video grafiğine eklenmiş veya bir avatarla eşleştirilmiş.
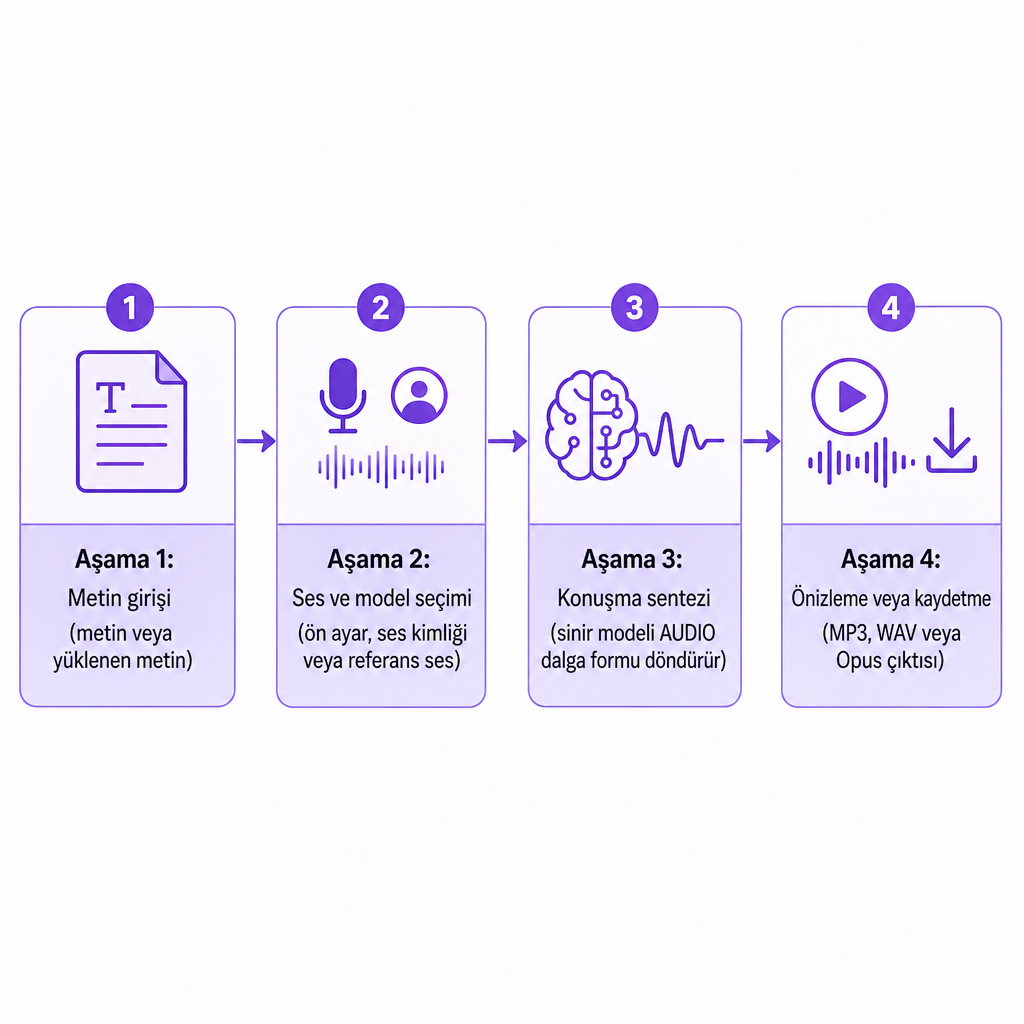
Dördüncü olarak, ses önizlenir veya kaydedilir. TTS düğümleri tipik olarak bir önizleme veya kaydetme düğümüne bağlanan bir AUDIO nesnesi yayar ve dosya formatı düğüm ve sağlayıcı tarafından belirlenir; örneğin ElevenLabs düğüm dokümantasyonu, MP3 ve Opus varyantları dahil seçilebilir formatları listeler. Grafik görsel olduğu için döngüyü yeniden çalıştırmak kolaydır: senaryoyu, sesi, dili veya modeli değiştirin, ardından tekrar kuyruğa alın.
ComfyUI'de TTS çalıştırmanın üç yolu
Tek bir ComfyUI konuşma yöntemi yoktur ve farklar; kuruluma, kontrole, gizliliğe ve ne kadar bakımı üstlenmeye istekli olduğunuza dayanır.
Barındırılan sağlayıcı düğümleri, metninizi ve ses ayarlarınızı harici bir servise gönderir ve bitmiş sesi geri döndürür. Model sağlayıcının altyapısında çalıştığı için bu genellikle yüksek kaliteli konuşmaya giden en hızlı yoldur. HeyGen Voice 1.0 düğümü bu düzeni gösterir: geçerli bir klonlanmış ses kimliği gerektirir, metni ve kimliği HeyGen'e gönderir ve konuşmayı geri döndürür. Ödünleşimler de öngörülebilirdir, çünkü bir hesap veya API bağlantısı gerekebilir, kullanım sağlayıcı kredilerini tüketebilir, metniniz ve sesiniz üçüncü bir tarafça işlenir ve sağlayıcı sınırları ya da fiyatlandırması değişebilir.
Resmi ortak ses düğümleri, aynı fikri ses alanının daha fazlasına taşır. ComfyUI'nin ses dokümantasyonu, metinden ses üretimini; metinden ve referans sesinden konuşma dahil ses-ve-konuşma kullanım durumlarından ayırır. Bu entegrasyonlar, grafiğiniz zaten diğer barındırılan medya modellerine dayandığında parlar, çünkü ayrı uygulamalar arasında dosya taşımayı azaltır.
Topluluk ve yerel TTS düğümleri, ComfyUI'yi Edge TTS, Kokoro, Index-TTS ve yerel olarak çalışabilen diğer modeller gibi sistemlere bağlar. Yerel iş akışları, verileriniz ve model seçiminiz üzerinde daha fazla kontrol sağlayabilir, ancak karşılığında daha fazlasını ister: kurulum, uyumlu donanım, model indirmeleri ve sorun giderme. Yerel bir düğüm, barındırılan bir düğümden otomatik olarak daha iyi değildir. Gerçek avantajı; makinenizin modeli verimli çalıştırıp çalıştıramadığına, ses kalitesinin yeterli olup olmadığına, dilinizin desteklenip desteklenmediğine, lisansın ticari kullanıma izin verip vermediğine ve iş akışını zaman içinde canlı tutup tutamayacağınıza bağlıdır.
Ses klonlama ve bekleyebileceğiniz kontroller
Ses klonlama, grafiğe stok bir konuşmacı yerine bir referans kimliği ekler. Yapı genellikle birbirine bağlı iki parçadır: bir ses kimliği oluşturan veya döndüren bir klonlama düğümü ve o kimliği yeni metni seslendirmek için kullanan bir TTS düğümü. HeyGen dokümantasyonu bunu doğrudan tanımlar; burada bir Instant Clone düğümü, Voice 1.0 Text to Speech düğümünü besleyen bir voice_id üretir; bu klon iş akışı en az 10 saniyelik net konuşma ister ve TTS düğümü istek başına 5.000 karaktere kadar kabul eder.
Yalnızca yetki ile klonlayın. Bir gerçek kişinin sesini, sırf bir kaydına ulaşabildiğiniz için çoğaltmayın. İzin alın, bunun kanıtını saklayın ve bağlamın bir izleyiciyi yanıltabileceği her yerde sentetik veya klonlanmış konuşmayı açıklayın.
Sesin kendisinin ötesinde, karşılaşacağınız kontroller düğüme ve modele göre değişir, ancak çoğunda tanıdık bir set tekrar tekrar ortaya çıkar.
- Ses: konuşmacı kimliği veya önceden ayarlanmış seçenek
- Dil: senaryoyu yorumlamak için kullanılan dil
- Hız: anlatımın ne kadar hızlı sunulduğu
- Perde: sesin algılanan tizliği veya pesliği
- Stil ve ifade gücü: sunum karakteri ve duygunun ne kadar güçlü uygulandığı
- Kararlılık: sesin özelliklerini ne kadar tutarlı koruduğu
- Çıkış formatı: MP3, WAV veya Opus gibi
- Referans ses: klonlama veya konuşma dönüşümü için kullanılan bir kayıt
Bazı modeller satır içi ipuçlarıyla daha da ileri gider. Fish Audio düğüm dokümantasyonu, desteklenen modellerde duygu ipuçlarını ve çok konuşmacılı diyalog etiketlerini destekler. Hepsinde geçerli olan bir uyarı vardır: bu kontroller sağlayıcılar arasında birbirinin yerine kullanılamaz ve bir düğümde stil olarak adlandırılan bir ayar, başka bir düğümdeki stilden tamamen farklı davranabilir.
ComfyUI'ye karşı özel bir TTS platformu
ComfyUI, konuşma daha büyük bir medya hattının bir parçası olduğunda yerini hak eder. Özel bir platform ise, asıl tek işin bir grafik kurmadan senaryoları cilalı anlatıma dönüştürmek olduğunda kazanma eğilimindedir.
| Karar faktörü | ComfyUI | Özel TTS platformu |
|---|---|---|
| İş akışı esnekliği | Yüksek; TTS'yi diğer medya düğümlerine bağlayın | Genellikle konuşma üretimine odaklı |
| Kurulum | Düğümler, sağlayıcı bağlantıları veya model kurulumları gerekebilir | İlk üretim için genellikle daha hızlı |
| Ses seçenekleri | Kurulu veya bağlı düğümlere bağlıdır | Genellikle tek bir düzenli ses kütüphanesi |
| Otomasyon | Yeniden kullanılabilir görsel grafikler için güçlü | Genellikle API veya toplu araçlar aracılığıyla |
| Yerel işleme | Yerel düğümler ve modellerle mümkün | Genellikle bulut tabanlı |
| En iyi kullanım durumu | Deneysel veya çok modlu hatlar | Tekrarlanabilir anlatım ve üretim |
Konuşmayı görüntüler, video veya ses işlemeyle harmanlayan görsel bir hat kuran içerik üreticileri için grafik kendini amorti eder. YouTube anlatımı, e-öğrenme seslendirmeleri, podcast'ler veya öngörülebilir bir arayüze ihtiyaç duyan yerelleştirme ekipleri için, özel bir hizmet genellikle teknik yükü ortadan kaldırır. Metinden Sese iş akışımız; 300'den fazla yapay zeka sesi, 33 dilde ses klonlama, ayarlanabilir konuşma hızı, duygusal diyalog ipuçları ve indirilebilir projelerle doğrudan senaryodan sese üretim etrafında kurulmuştur. Üretimin bir uygulama veya otomatik bir içerik hattı içinde yaşaması gerektiğinde, Metinden Sese API'miz entegrasyon tarafını halleder ve AI Dublaj API'miz aynı fikri çevrilmiş, sesi eşleştirilmiş videoya taşır.
Kurulumunuzu nasıl seçer ve sorun giderirsiniz
Bir düğüme veya modele karar vermeden önce, kısa bir demoya güvenmek yerine birkaç kasıtlı kontrol yapın.
Ses kalitesini kolay bir örnekte değil, zor bir örnekte değerlendirin. İsimler, sayılar, kısaltmalar, uzun cümleler, sorular, marka terimleri ve hedef dilinizde ve aksanınızda en az bir duygusal satır içeren bir pasaj üretin. Tek bir cümlede sizi büyüleyen bir ses, bir ürün adını bozabilir veya bir paragraf boyunca ritmi kaybedebilir.
Dil ve aksan desteğini toplamda değil, dil başına kontrol edin. Bazı sistemler dili otomatik olarak algılarken diğerleri ayarlamanızı gerektirir ve HeyGen düğüm dokümantasyonu, otomatik algılamanın güvenilmez olabileceği birbirine yakın diller için dili manuel olarak ayarlamanızı önerir. Akıcı bir sesin, yanlış bir çeviriyi kurtaramayacağını unutmayın; ses kalitesi ve çeviri kalitesi ayrı sorunlardır.
Telaffuz kontrolünü, motorları gerçekten zorlayan kelimeler için ölçün: ürün adları, özel isimler, kısaltmalar, tarihler, para birimi ve teknik terimler. Bir düğüm telaffuz sözlüğü veya SSML tarzı kontroller sunmuyorsa, metni fonetik olarak yeniden yazmayı veya sayıları harflerle yazmayı planlayın. Bir dizi veya markalı bir kanal için, aynı sesi birden fazla üretim, ton ve yeniden üretilmiş bölüm boyunca çalıştırarak tutarlılığı da test edin, çünkü farklı sahneler için ayrı ComfyUI çalıştırmaları sapabilir.
Gecikmeyi, maliyeti, gizliliği ve hakları birlikte tartın. Barındırılan düğümler hızlı başlar ancak ağ hızına, sağlayıcı kullanılabilirliğine, hesap sınırlarına ve kullanım başına fiyatlandırmaya bağlıdır; yerel modeller ise istek başına ücretlerden kaçınır ancak donanım ve bakım gerektirir; reklamı yapılan ücreti değil, toplam üretim maliyetini karşılaştırın. Gizlilik konusunda; girdinin nasıl saklandığını, içeriğin modeli eğitip eğitmediğini, ses verilerinin silinip silinemeyeceğini, ticari kullanıma izin verilip verilmediğini, çıktının sahibinin kim olduğunu ve klonlanmış seslerin hangi onayı gerektirdiğini doğrulayın.
Bir grafik yanlış davrandığında, hatalar kısa bir listede toplanır. Hata döndüren bir klonlanmış-ses düğümünün genellikle boş veya geçersiz bir voice_id değeri vardır; HeyGen düğümü tam da bu nedenle durur. Aşırı uzun senaryolar sınırlara çarpar ve belgelenmiş HeyGen Voice 1.0 düğümü 5.000 karaktere kadar kabul ederken, özellikle uzun Çince veya Japonca metin için çok uzun konuşmanın başarısız olabileceğine dair uyarır; bu yüzden anlatımı mantıksal bölümlere ayırın. Yanlış telaffuz genellikle sayıları kelimelerle yeniden yazmaya, noktalama eklemeye veya kısaltmaları açıkça yazmaya yanıt verir. Aşırı ifadeli çıktı, daha düşük ifade gücü, stil veya perde değişimi gerektirir. Ve ses aşağıya bağlanmadığında türü kontrol edin, çünkü bir AUDIO çıkışı, bir dönüştürme adımı olmadan görüntü, video veya metin bekleyen bir düğümü besleyemez. Son olarak, adlandırılmış düğümler ve kayıtlı ayarlarla temiz bir grafik kaydedin, çünkü kullandığınız sağlayıcı, ses kimliği, dil ve çıkış formatı, gelecekteki sizin ihtiyaç duyacağı ayrıntılardır.
Sıkça sorulan sorular
ComfyUI bir metinden ses aracı mı?
ComfyUI, tek bir TTS motorundan ziyade düğüm tabanlı bir iş akışı uygulamasıdır. Yerleşik düğümler, ortak entegrasyonlar ve topluluk ya da yerel TTS düğümleri aracılığıyla konuşma üretebilir.
ComfyUI bir sesi klonlayabilir mi?
Evet, eğer seçilen entegrasyon veya özel düğüm klonlamayı destekliyorsa. Kesin kayıt gereksinimleri, ses kimliği süreci, sınırlar ve ticari koşullar sağlayıcıya bağlıdır.
ComfyUI metinden ses çevrimdışı çalışır mı?
Uyumlu bir yerel TTS modeli ve yerel düğümler kullandığınızda çalışabilir. Barındırılan sağlayıcı düğümleri bir internet bağlantısı gerektirir ve sağlayıcıya metin veya ses verisi gönderebilir.
En iyi ComfyUI TTS düğümü hangisidir?
Evrensel olarak en iyi düğüm yoktur. Dil desteği, ses kalitesi, klonlama ihtiyaçları, gizlilik, maliyet, gecikme ve iş akışınızın geri kalanıyla uyumluluğa göre seçin.
ComfyUI TTS'yi YouTube videoları için kullanabilir miyim?
Evet. Anlatımı üretin, telaffuzu ve hakları gözden geçirin, sesi dışa aktarın ve videonuzla senkronize edin. Klonlanmış veya sentetik bir ses kullanıyorsanız, geçerli onay, açıklama ve platform gereksinimlerine uyun.