API โคลนเสียงคืออินเทอร์เฟซสำหรับนักพัฒนาที่เปลี่ยนตัวอย่างเสียงที่ได้รับอนุญาตให้กลายเป็นเสียงสังเคราะห์ที่นำกลับมาใช้ซ้ำได้ ทำให้แอปพลิเคชันสามารถส่งข้อความ—หรือรันงานพากย์เสียงอัตโนมัติ—แล้วได้รับเสียงพูดใหม่ที่คล้ายกับผู้พูดต้นฉบับกลับมา แทนที่จะเลือกเสียงตายตัวจากแคตตาล็อก โค้ดของคุณจะสร้างอัตลักษณ์เสียงที่ผูกกับ ID เฉพาะ แล้วนำกลับมาใช้ซ้ำในสคริปต์ ผลิตภัณฑ์ และภาษาต่าง ๆ การเปลี่ยนแปลงเพียงจุดเดียว—จากการเลือกเสียงไปสู่การเป็นเจ้าของเสียงผ่านการเขียนโปรแกรม—นี่แหละคือสิ่งที่ทำให้เทคโนโลยีนี้น่าสนใจสำหรับครีเอเตอร์ แบรนด์ และนักพัฒนาที่สร้างงานในระดับขนาดใหญ่
คำตอบสั้น ๆ ของ API โคลนเสียงคืออะไร คือ: มันเปิดเผยความสามารถที่เชื่อมโยงกันสามอย่าง—การอัปโหลดเสียง การสร้างเสียง และการสร้างเสียงพูด—ในรูปแบบ endpoint ที่ซอฟต์แวร์ของคุณเรียกใช้ได้ การเข้าใจว่าชิ้นส่วนเหล่านี้ประกอบกันอย่างไรคือสิ่งที่แยกไพป์ไลน์การผลิตที่ราบรื่นออกจากอันที่น่าหงุดหงิด ดังนั้นส่วนที่เหลือของบทอธิบายนี้จะพาไปดูกลไก การแลกเปลี่ยน และคำถามเรื่องสิทธิ์ที่คุณต้องจัดการให้เรียบร้อยก่อนที่ไฟล์แม้แต่ไฟล์เดียวจะขึ้นใช้งานจริง
สารบัญ
API โคลนเสียงทำอะไรได้จริง
API โคลนเสียงเปิดเผยการโคลนในรูปแบบบริการที่เขียนโปรแกรมได้ แทนที่จะเป็นฟีเจอร์แบบใช้มือที่ซ่อนอยู่ในโปรแกรมตัดต่อเสียงหรือแดชบอร์ดบนเว็บ แอปพลิเคชันของคุณจะอัปโหลดตัวอย่าง ผู้ให้บริการจะแปลงมันให้เป็นเสียงกำหนดเองที่มี ID ของตัวเอง และนับจากนั้น ID นั้นก็จะกลายเป็นตัวจับที่คุณส่งเข้าไปในคำขอแปลงข้อความเป็นเสียงหรือคำขอพากย์เสียง
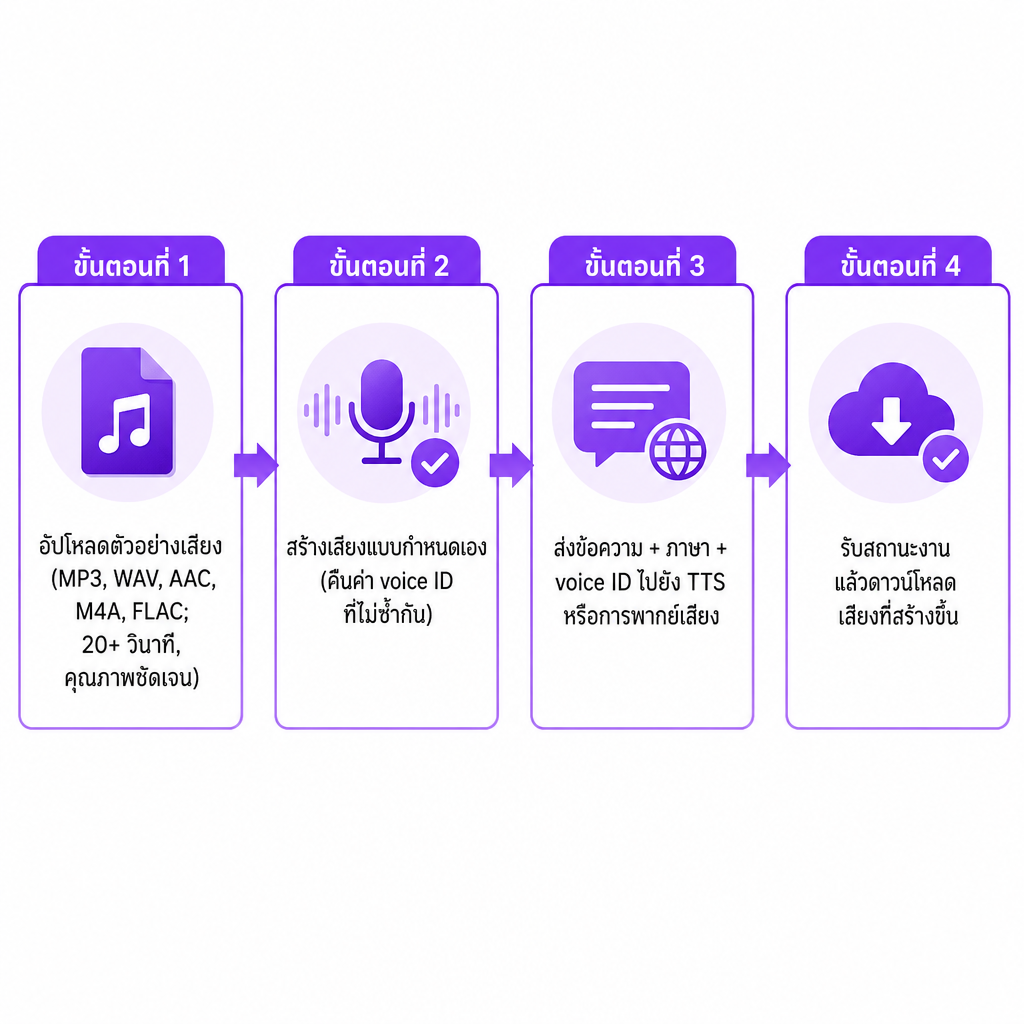
รูปแบบนี้สอดคล้องกันในทุกผู้ให้บริการ: ตัวอย่างเสียงกลายเป็น ID เสียงกำหนดเอง ซึ่งกลายเป็นเสียงพูดใหม่จากข้อความหรือสคริปต์ที่แปลแล้ว ซึ่งกลายเป็นไฟล์เสียงที่เสร็จสมบูรณ์ งานด้านแมชชีนเลิร์นนิง—การวิเคราะห์โทนเสียง รูปแบบการออกเสียง ช่วงระดับเสียง จังหวะ และน้ำเสียง—เกิดขึ้นเบื้องหลัง endpoint และโมเดลเสียงที่ได้นั้นสามารถพูดสคริปต์ใหม่เอี่ยมในขณะที่ยังคงลักษณะที่จดจำได้ของผู้พูดต้นแบบไว้
มีข้อแตกต่างหนึ่งที่สำคัญยิ่งกว่าสิ่งใด API ไม่ได้เล่นซ้ำการบันทึกต้นฉบับ แต่มันสังเคราะห์เสียงพูดขึ้นใหม่ เสียงที่โคลนมาสามารถพูดคำที่ไม่เคยอยู่ในตัวอย่างต้นฉบับได้ ซึ่งนั่นคือเหตุผลที่มันทรงพลังและเหตุผลที่มันมาพร้อมความรับผิดชอบ
การโคลนเสียงทำงานอย่างไรเบื้องหลัง API
ผู้ให้บริการแต่ละรายใช้งานโมเดลแตกต่างกัน แต่ระบบส่วนใหญ่มีขั้นตอนหลัก ๆ ร่วมกัน และการรู้จักขั้นตอนเหล่านี้ช่วยให้คุณออกแบบการเชื่อมต่อที่เชื่อถือได้
ขั้นแรก ระบบรับตัวอย่างเสียง นักพัฒนามักอัปโหลดผ่าน presigned upload URL ซึ่งให้แอปพลิเคชันส่งไฟล์ตรงไปยังที่จัดเก็บแทนที่จะยัดเพย์โหลดเสียงขนาดใหญ่เข้าไปในคำขอสร้างเสียง เสียงต้นฉบับที่สะอาดสำคัญมากตรงนี้ เพราะโมเดลอาจเรียนรู้เสียงที่ไม่พึงประสงค์ไปพร้อมกับผู้พูด: เสียงดนตรี เสียงก้องในห้อง ผู้พูดหลายคนที่ซ้อนทับกัน เสียงบิดเบือน และการลดเสียงรบกวนที่รุนแรงเกินไป ล้วนลดความสม่ำเสมอของการโคลน API โคลนเสียงของเรารองรับ MP3, WAV, AAC, M4A และ FLAC และแนะนำให้ใช้เสียงอย่างน้อย 20 วินาทีโดยไม่มีเสียงรบกวนพื้นหลังเพื่อผลลัพธ์ที่ดีที่สุด
ขั้นที่สอง ผู้ให้บริการสร้างเสียงกำหนดเอง หลังจากอัปโหลด แอปพลิเคชันจะส่งตำแหน่งไฟล์ที่จัดเก็บและชื่อ และบริการจะส่งอ็อบเจกต์เสียงพร้อมตัวระบุกลับมา ตัวระบุนั้นคือกุญแจสู่ทุกสิ่งที่ตามมา—แอปพลิเคชันของคุณจัดเก็บมันไว้ร่วมกับบันทึกของผู้ใช้ โปรเจกต์ ตัวละคร หรือแบรนด์ในฐานข้อมูลของตัวเอง เอกสารประกอบของเราใช้รูปแบบนี้ด้วย endpoint สำหรับสร้าง บวกกับ endpoint สำหรับแสดงรายการเสียงกำหนดเองพร้อมการแบ่งหน้า และสำหรับลบเสียงกำหนดเองตาม ID
ขั้นที่สาม แอปพลิเคชันสร้างเสียงพูดใหม่ เมื่อเสียงกำหนดเองมีอยู่แล้ว โค้ดของคุณจะส่งข้อความ ภาษา และ ID เสียงกำหนดเองไปยัง endpoint แปลงข้อความเป็นเสียง บริการจะส่งตัวระบุโปรเจกต์หรืองานกลับมา แอปพลิเคชันจะ poll สถานะงานจนกว่าการประมวลผลจะเสร็จสิ้นและดึง URL เสียงที่ได้ API TTS ของเราบันทึกการสร้างแบบอิงโปรเจกต์พร้อมสถานะ pending, processing, completed และ failed และเปิดเผยค่าเสียง ภาษา ความเร็ว และระดับเสียงในระดับเซกเมนต์แต่ละชิ้น
หากคุณต้องการกลไกเชิงลึกของฝั่งการสร้าง บทอธิบายของเราเรื่อง API แปลงข้อความเป็นเสียงคืออะไรและทำงานอย่างไร จะแยกย่อยไพป์ไลน์การสังเคราะห์ที่เสียงโคลนขับเคลื่อนในท้ายที่สุด
API โคลนเสียงเทียบกับ API แปลงข้อความเป็นเสียงและ API พากย์เสียง
API ทั้งสามนี้เกี่ยวข้องกันแต่แก้ปัญหาที่ต่างกัน และการสับสนระหว่างกันนำไปสู่สถาปัตยกรรมที่ผิด
| ประเภท API | อินพุตหลัก | เอาต์พุตหลัก | เหมาะสมที่สุดกับ |
|---|---|---|---|
| API แปลงข้อความเป็นเสียง | ข้อความบวกกับเสียงที่เลือก | เสียงพูดสังเคราะห์ | การบรรยาย การแจ้งเตือน ผู้ช่วย เสียงที่มีสคริปต์ |
| API โคลนเสียง | ตัวอย่างเสียง | ID เสียงกำหนดเอง | การสร้างอัตลักษณ์เสียงที่นำกลับมาใช้ซ้ำได้ |
| API พากย์เสียง AI | วิดีโอหรือเสียงบวกกับการตั้งค่าภาษา | สื่อที่แปลและพากย์แล้ว | การแปลเฉพาะถิ่นของวิดีโอและเสียงหลายภาษา |
ในทางปฏิบัติ API โคลนเสียงแทบไม่เคยทำงานโดยลำพัง endpoint การโคลนสร้างเสียง endpoint แปลงข้อความเป็นเสียงใช้ ID เสียงนั้นเพื่อพูดข้อความใหม่ ID เสียงเดียวกันยังสามารถไหลเข้าสู่เวิร์กโฟลว์การพากย์ ซึ่งระบบจะแปลบทสนทนาต้นฉบับและสร้างการแสดงที่แปลแล้วในเสียงกำหนดเองที่เลือก เราอธิบายว่าเสียงกำหนดเองของเราใช้ได้ทั้งในโปรเจกต์ TTS และ AI Dubbing ซึ่งเป็นสิ่งที่ทำให้ตัวอย่างเสียง 20 วินาทีเดียวสามารถใช้ในการบรรยายและการแปลเฉพาะถิ่นจากอัตลักษณ์เดียวกันได้ สำหรับสถาปัตยกรรมเฉพาะด้านการพากย์ ดูบทอธิบายคู่กันของเราเรื่อง API พากย์เสียง AI คืออะไร และสำหรับตระกูลที่กว้างขึ้นของ endpoint เสียง ดูคู่มือของเราเรื่อง API เสียง AI คืออะไร
สิ่งที่คุณสามารถสร้างได้ด้วยมัน
API โคลนเสียงจะพิสูจน์คุณค่าเมื่อเสียงเดียวกันต้องถูกสร้างซ้ำ ๆ ในสคริปต์ ผลิตภัณฑ์ หรือภาษาจำนวนมาก รูปแบบที่เป็นรูปธรรมสองสามอย่างแสดงให้เห็นว่ามันเหมาะกับที่ใด
ครีเอเตอร์ YouTube สามารถบันทึกตัวอย่างเสียงหนึ่งอันและนำเสียงที่ได้กลับมาใช้ซ้ำสำหรับเวอร์ชันเฉพาะถิ่นของวิดีโอ โดยสร้างการบรรยายสำหรับตลาดภาษาต่าง ๆ โดยไม่ต้องบันทึกทุกสคริปต์ใหม่ การโคลนไม่ได้ขจัดความจำเป็นในการตรวจทานการแปล—ชื่อ สำนวน มุกตลก และการอ้างอิงทางวัฒนธรรมยังคงต้องการการตรวจสอบโดยมนุษย์—แต่มันขจัดคอขวดในการบันทึก
บริษัทสามารถสร้างผู้บรรยายที่สม่ำเสมอสำหรับวิดีโออธิบายผลิตภัณฑ์ วิดีโอ onboarding โฆษณา และเนื้อหาช่วยเหลือ แทนที่จะกำหนดเสียงต่างกันให้ทุกแคมเปญ สิ่งที่ควรทำก่อนการผลิตคือนโยบายการใช้เสียง: แผนกใดที่ใช้เสียงได้ เนื้อหาใดที่ต้องขออนุมัติ และการบรรยายสังเคราะห์ต้องมีการเปิดเผยหรือไม่
ทีมฝึกอบรมจะได้ความสามารถในการอัปเดตบทเรียนอย่างรวดเร็วเมื่อนโยบาย รายละเอียดผลิตภัณฑ์ หรือขั้นตอนเปลี่ยนแปลง โดยคงความต่อเนื่องในคลังหลักสูตรขนาดใหญ่ สำหรับหัวข้อที่อ่อนไหว การตรวจสอบโดยมนุษย์ยังคงจำเป็น เพราะเสียงที่สร้างขึ้นฟังดูมั่นใจแม้เมื่อสคริปต์ผิด ผู้ผลิตพอดแคสต์สามารถคงเสียงพิธีกรหรือตัวละครที่สม่ำเสมอสำหรับอินโทร การแก้ไข บทสรุป หรือฉบับภาษาอื่น ซึ่งมีประโยชน์เมื่อการแก้ไขเล็กน้อยมิฉะนั้นจะต้องใช้เซสชันใหม่ทั้งหมด และนักพัฒนาที่สร้างเกม แอปการศึกษา เครื่องมือการเข้าถึง หรือประสบการณ์แบบมีไกด์ สามารถทำให้เสียงเป็นส่วนหนึ่งของเวิร์กโฟลว์ที่มีอยู่แทนที่จะส่งออกเสียงด้วยมือสำหรับทุกการตอบสนอง
วิธีประเมิน API โคลนเสียง
ผู้ให้บริการที่เหมาะสมขึ้นอยู่กับความต้องการในการผลิตของคุณ ไม่ใช่ว่าเดโมเดียวฟังดูขัดเกลาแค่ไหน พิจารณามิติต่าง ๆ ด้านล่างนี้ก่อนตัดสินใจ
ข้อกำหนดอินพุตเสียง ยืนยันรูปแบบไฟล์ที่รองรับ ความยาวตัวอย่างขั้นต่ำหรือที่แนะนำ ว่าผู้พูดหลายคนถูกปฏิเสธหรือไม่ จัดการเสียงรบกวนพื้นหลังอย่างไร การอัปโหลดตรงได้รับการยอมรับหรือไม่ และไฟล์อ้างอิงสามารถลบได้หลังจากการโคลนหรือไม่ เราระบุ MP3, WAV, AAC, M4A และ FLAC เป็นรูปแบบที่รองรับและแนะนำตัวอย่างที่สะอาดอย่างน้อย 20 วินาที
คุณภาพและความสม่ำเสมอของเสียง ทดสอบเสียงด้วยประโยคมากกว่าหนึ่งประโยค รวมประโยคสั้นและยาว ตัวเลขและวันที่ ชื่อเฉพาะ คำถามและคำอุทาน คำศัพท์เทคนิค และคำที่ออกเสียงยาก เสียงโคลนที่น่าหลงใหลในเดโมสั้น ๆ อาจเพี้ยนในการบรรยายยาวหรือในภาษาที่ไม่คุ้นเคย
การรองรับภาษาและการแปลเฉพาะถิ่น หากเป้าหมายคือเอาต์พุตหลายภาษา ให้ตรวจสอบภาษาต้นทางและปลายทางที่รองรับ ว่าเสียงกำหนดเองสามารถพูดแต่ละภาษาได้หรือไม่ พฤติกรรมด้านสำเนียงและการออกเสียง และว่าเสียงยังคงจดจำได้ข้ามภาษาหรือไม่ API TTS ของเราระบุต่อสาธารณะว่ามีเสียง AI มากกว่า 300 เสียงใน 33+ ภาษาและสำเนียง รวมถึงอังกฤษ โปรตุเกส สเปน ฝรั่งเศส เยอรมัน จีน และญี่ปุ่น เราไม่ได้เผยแพร่แคตตาล็อกภาษาที่สมบูรณ์ในหน้านั้น ดังนั้นให้ยืนยันการจับคู่เสียงและภาษาที่แน่นอนก่อนล็อกเวิร์กโฟลว์การผลิต
สถาปัตยกรรม API API ที่พร้อมใช้งานจริงควรให้การจัดการที่คาดเดาได้สำหรับการตรวจสอบสิทธิ์ การอัปโหลด การสร้างเสียง การแสดงรายการ การลบ สถานะโปรเจกต์ การลองใหม่ ข้อผิดพลาดในการตรวจสอบ การแบ่งหน้า การดึงเสียง และการตรวจสอบการใช้งาน เราแสดงการตรวจสอบสิทธิ์ด้วย Bearer-token ในตัวอย่างของเราและบันทึกทั้ง endpoint การจัดการเสียงและการประมวลผล TTS แบบอิงโปรเจกต์
การสร้างแบบซิงโครนัสเทียบกับอะซิงโครนัส คำขอสั้น ๆ อาจส่งกลับได้รวดเร็ว แต่เนื้อหาที่ยาวกว่าจัดการได้ดีกว่าในรูปแบบงาน: ส่งคำขอ รับ ID งาน poll หรือรับสถานะ แล้วดาวน์โหลดเสียง การออกแบบแบบอะซิงโครนัสหยุดไม่ให้คำขอเว็บหมดเวลาในขณะที่การบรรยายยาวหรือชุดเซกเมนต์ขนาดใหญ่กำลังเรนเดอร์ เอกสาร TTS ของเราใช้สถานะโปรเจกต์และค่าความคืบหน้า และโปรเจกต์ที่เสร็จสมบูรณ์จะส่ง URL เสียงพร้อม URL เสียงรายเซกเมนต์กลับมา
การควบคุมเอาต์พุตและการแก้ไข ตรวจสอบรูปแบบและคุณภาพเอาต์พุต ว่าอัตราการสุ่มตัวอย่างปรับได้หรือไม่ ว่าความเร็วและระดับเสียงปรับได้หรือไม่ ว่าเซกเมนต์แต่ละชิ้นดาวน์โหลดได้หรือไม่ ว่าเซกเมนต์ที่ล้มเหลวสามารถสร้างใหม่ได้โดยไม่ต้องรันโปรเจกต์ใหม่ทั้งหมดหรือไม่ และว่า URL เสียงเป็นแบบชั่วคราวหรือถาวร เราบันทึกเอาต์พุต MP3 ที่ 22 kHz สำหรับ API TTS และเปิดเผยการควบคุมความเร็วและระดับเสียงในระดับเซกเมนต์
การลบและการควบคุมข้อมูล ผู้ให้บริการควรให้คุณลบเสียงอ้างอิงที่อัปโหลด เสียงกำหนดเองที่สร้างขึ้น ไฟล์เสียงที่สร้างขึ้น และข้อมูลโปรเจกต์ที่เกี่ยวข้องได้ API โคลนเสียงของเรารวม endpoint การลบสำหรับเสียงกำหนดเองและระบุว่าผู้ใช้สามารถลบเสียงกำหนดเองและเสียงที่เกี่ยวข้องได้ ตรวจสอบเงื่อนไขความเป็นส่วนตัวปัจจุบันและคำมั่นด้านการเก็บรักษาก่อนอัปโหลดการบันทึกที่เป็นความลับหรือมีความอ่อนไหวทางการค้า
สิทธิ์ การแอบอ้างตัวตน และการใช้อย่างมีความรับผิดชอบ
การโคลนเสียงเป็นการตัดสินใจด้านสิทธิ์ ความเป็นส่วนตัว และการแอบอ้างตัวตนพอ ๆ กับด้านเทคนิค และการมองว่ามันเป็นแค่โค้ดคือสิ่งที่ทำให้ทีมงานเข้าสู่ปัญหา
เริ่มจากการขออนุญาต ใช้การบันทึกเฉพาะเมื่อคุณมีสิทธิ์ในการโคลนและใช้เสียงของผู้พูดนั้น สำหรับเวิร์กโฟลว์ทางธุรกิจ ความยินยอมเป็นลายลักษณ์อักษรควรครอบคลุมการสร้างเสียงสังเคราะห์ การใช้เชิงพาณิชย์ ภาษาและอาณาเขต ระยะเวลาใบอนุญาต เนื้อหาโฆษณาและการเมือง การใช้ในการฝึกอบรมและการบริการลูกค้า ว่าเสียงอาจถูกอนุญาตช่วงได้หรือไม่ และจะถูกลบหรือเลิกใช้อย่างไร การเจอการบันทึกออนไลน์ไม่ได้ให้สิทธิ์แก่คุณในการโคลนมัน
ป้องกันการแอบอ้างตัวตน เพราะเสียงสังเคราะห์สามารถทำให้คำขอฉ้อโกงฟังดูน่าเชื่อถือได้ FTC ได้เตือนว่าผู้หลอกลวงอาจโคลนเสียงของญาติหรือผู้บริหารเพื่อกดดันให้ผู้คนส่งเงินหรือแบ่งปันข้อมูล มาตรการป้องกันที่สมเหตุสมผล ได้แก่ การจำกัดว่าใครสามารถสร้างหรือเข้าถึงเสียงกำหนดเอง การกำหนดให้ขออนุมัติก่อนเผยแพร่เสียงที่สร้างขึ้น การบันทึกกิจกรรมการสร้าง การแยกข้อมูลรับรองสำหรับการพัฒนาและการผลิต การใช้การจำกัดอัตรา การบล็อกหมวดหมู่เนื้อหาที่มีความเสี่ยงสูง และการกำหนดช่องทางยืนยันที่สองสำหรับคำขอทางการเงิน
สำหรับผู้ชมในสหรัฐฯ การโทรออกเพิ่มน้ำหนักทางกฎหมาย FCC ระบุว่าเสียงที่สร้างด้วย AI อยู่ภายใต้ข้อจำกัดของ Telephone Consumer Protection Act เกี่ยวกับเสียงเทียมหรือเสียงที่บันทึกไว้ล่วงหน้า และการโทรเช่นนั้นโดยทั่วไปต้องมีความยินยอมโดยชัดแจ้งล่วงหน้าเว้นแต่มีข้อยกเว้นที่ใช้บังคับ API โคลนเสียงไม่ใช่ใบอนุญาตในการทำการตลาดทางโทรศัพท์ การทวงหนี้ การโทรทางการเมือง หรือการสื่อสารที่อ่อนไหวต่อตัวตนแบบอัตโนมัติ คุณสามารถอ่านคำวินิจฉัยของ FCC เกี่ยวกับเสียง robocall ที่สร้างด้วย AI และการแจ้งเตือนผู้บริโภคของ FTC เกี่ยวกับการโคลนเสียง ได้โดยตรง
สุดท้าย การโคลนเปลี่ยนการนำเสนอ ไม่ใช่ความจริง เสียงที่สมจริงทำให้คำกล่าวที่ไม่ถูกต้องฟังดูน่าเชื่อถือ ดังนั้นให้ตรวจสอบชื่อและตัวเลข การแปล การอ้างสิทธิ์ทางการแพทย์ การเงิน หรือกฎหมายใด ๆ คำแนะนำผลิตภัณฑ์ การออกเสียง จังหวะ และข้อความบนหน้าจอก่อนเผยแพร่ สำหรับวิดีโอหลายภาษา ตรวจสอบทั้งสคริปต์ที่แปลและเสียงสุดท้าย—การโคลนที่ดีไม่สามารถกอบกู้การแปลที่ผิดได้
API โคลนเสียงเหมาะกับโปรเจกต์ของคุณหรือไม่?
API โคลนเสียงเหมาะอย่างยิ่งเมื่อคุณต้องการเสียงเดียวกันในไฟล์จำนวนมาก คุณมีไพป์ไลน์ข้อความ การแปล หรือสื่อที่เชื่อถือได้อยู่แล้ว คุณต้องการการสร้างผ่านการเขียนโปรแกรมมากกว่าการส่งออกด้วยมือเป็นครั้งคราว คุณมีเอกสารอนุญาตให้ใช้เสียงอ้างอิง คุณผลิตเนื้อหาเฉพาะถิ่นหรือเนื้อหาส่วนบุคคลในระดับขนาดใหญ่ และคุณสามารถทดสอบและตรวจทานเสียงที่สร้างขึ้นก่อนเผยแพร่ได้
เสียง TTS แบบสำเร็จรูปอาจตอบโจทย์คุณได้ดีกว่าเมื่อความเร็ว ความเรียบง่าย และความเสี่ยงทางกฎหมายต่ำมีน้ำหนักมากกว่าความต่อเนื่องของแบรนด์ นักพากย์มืออาชีพมักเป็นทางเลือกที่ถูกต้องสำหรับแคมเปญเรือธง การแสดงที่ละเอียดอ่อน หัวข้อที่อ่อนไหว หรืองานที่ต้องการการกำกับโดยมนุษย์อย่างเต็มที่ สำหรับทีมที่ต้องการทั้งเสียงกำหนดเองและการแปลเฉพาะถิ่นในที่เดียว เรานำเสนอการโคลน TTS และการพากย์เสียง AI ในรูปแบบความสามารถ API ที่เชื่อมโยงกัน: API โคลนเสียงของเราสร้างเสียงกำหนดเองจากตัวอย่าง และ API TTS ของเราใช้ ID เสียงเพื่อสร้างเสียงพูดภายในเวิร์กโฟลว์โปรเจกต์ เมื่อคุณพร้อมที่จะเชื่อมต่อมัน คู่มือทีละขั้นตอนของเราเรื่อง วิธีเชื่อมต่อ API โคลนเสียง ครอบคลุมขั้นตอนอัปโหลด-สร้าง-สร้างเสียงอย่างละเอียด
การประเมินที่มีประโยชน์ที่สุดคือการทดสอบแบบควบคุม: ใช้ตัวอย่างที่สะอาดและได้รับอนุญาต สร้างสคริปต์เดียวกันในภาษาที่คุณตั้งใจ ตรวจสอบคุณภาพและความหน่วง ยืนยันการควบคุมวงจรชีวิตและการลบของ API และกำหนดให้มีการอนุมัติโดยมนุษย์ก่อนที่สิ่งใดจะเผยแพร่
คำถามที่พบบ่อย
API โคลนเสียงเหมือนกับเครื่องสร้างเสียง AI หรือไม่?
ไม่ เครื่องสร้างเสียง AI โดยทั่วไปให้คุณเลือกเสียงสังเคราะห์ที่มีอยู่และสร้างเสียงพูดจากข้อความ API โคลนเสียงสร้างเสียงกำหนดเองจากตัวอย่างเสียง ซึ่งคุณสามารถนำกลับมาใช้ซ้ำสำหรับการสร้างได้
ต้องใช้เสียงเท่าไรในการโคลนเสียง?
ข้อกำหนดแตกต่างกันไปตามผู้ให้บริการและโมเดล เราแนะนำเสียงที่สะอาดอย่างน้อย 20 วินาทีและรองรับรูปแบบอินพุต MP3, WAV, AAC, M4A และ FLAC
เสียงที่โคลนมาสามารถพูดภาษาอื่นได้หรือไม่?
บางครั้ง ขึ้นอยู่กับโมเดลของผู้ให้บริการ ภาษาที่รองรับ และความสามารถของเสียงในการถ่ายโอนข้ามภาษา ยืนยันการจับคู่เสียง-ภาษาที่แน่นอนแทนที่จะสมมติว่าทุกการโคลนทำงานได้ดีเท่ากันทุกที่
ฉันสามารถใช้เสียงที่โคลนมาสำหรับการพากย์เสียง AI ได้หรือไม่?
ได้ เมื่อผู้ให้บริการเชื่อมต่อการโคลนกับการพากย์เสียง เราอนุญาตให้ใช้เสียงกำหนดเองในโปรเจกต์ AI Dubbing โดยอ้างอิง ID เสียง
การโคลนเสียงถูกกฎหมายหรือไม่?
ตัวเทคโนโลยีเองไม่ได้ผิดกฎหมายโดยอัตโนมัติ แต่การใช้เสียงของใครบางคนโดยไม่ได้รับอนุญาตอาจก่อให้เกิดปัญหาด้านความเป็นส่วนตัว สิทธิ์ในการเผยแพร่ สัญญา การฉ้อโกง และการคุ้มครองผู้บริโภค ขออนุญาต ปฏิบัติตามกฎหมายที่ใช้บังคับ และหลีกเลี่ยงการแอบอ้างตัวตนที่หลอกลวง