Voice AI API คือการเชื่อมต่อแบบโปรแกรมได้ที่ช่วยให้แอปพลิเคชันของคุณสร้าง เข้าใจ แปลง หรือแปลเสียงพูดโดยใช้โมเดล AI ที่คุณไม่ต้องสร้างขึ้นเอง คุณส่งข้อความ เสียง หรือวิดีโอไปยังเอ็นด์พอยต์แล้วได้รับสิ่งที่มีประโยชน์กลับมา เช่น เสียงบรรยายที่สังเคราะห์ขึ้น คำถอดเสียง เสียงที่กำหนดเอง หรือวิดีโอที่พากย์เสียงเรียบร้อย คำถามที่แท้จริงเมื่อคุณเริ่มต้นไม่ใช่ ว่า คุณต้องการ "เสียง AI" หรือไม่ แต่เป็นความสามารถด้านเสียงแบบใดที่ผลิตภัณฑ์ของคุณต้องการจริง ๆ เพราะการสร้างเสียงพูด การรู้จำเสียงพูด การโคลนเสียง และการพากย์เสียงเป็นผลิตภัณฑ์ที่แตกต่างกันซึ่งบังเอิญใช้ชื่อหมวดหมู่เดียวกัน
คู่มือนี้จะพาคุณไปดูความหมายของคำนี้ ประเภท API หลัก ๆ และความแตกต่างของแต่ละประเภท การที่คำขอเคลื่อนผ่านไปป์ไลน์อย่างไร เกณฑ์การตัดสินใจที่แยกความเหมาะสมที่ดีออกจากความผิดพลาดที่มีราคาแพง และความเสี่ยงที่ควรจัดการก่อนที่คุณจะเปิดตัว นี่คือศูนย์กลางของซีรีส์สำหรับนักพัฒนาและ API ของเรา ดังนั้นคุณจะพบลิงก์ไปยังคู่มือการผสานรวมที่ลึกยิ่งขึ้นในจุดที่มีประโยชน์
สารบัญ
"Voice AI API" หมายความว่าอย่างไรกันแน่
วลีนี้รวมสามแนวคิดเข้าด้วยกัน Voice AI คือปัญญาประดิษฐ์ที่ทำงานกับเสียงพูดของมนุษย์หรือสร้างเสียงพูดสังเคราะห์ API คืออินเทอร์เฟซการเขียนโปรแกรมแอปพลิเคชัน—วิธีที่กำหนดไว้สำหรับระบบซอฟต์แวร์สองระบบในการแลกเปลี่ยนคำขอและการตอบสนอง การผสมผสานนี้หมายความว่าการประมวลผลโมเดลที่หนักหน่วงเกิดขึ้นที่ฝั่งผู้ให้บริการ ในขณะที่แอปพลิเคชันของคุณจัดการประสบการณ์ผู้ใช้ กฎทางธุรกิจของคุณ และเนื้อหาสุดท้าย
คำขออาจง่ายเพียงแค่เพย์โหลด JSON สั้น ๆ ที่มีข้อความที่คุณต้องการให้พูด ตัวระบุเสียง และรหัสภาษา การตอบสนองมักส่งคืนตัวระบุโปรเจกต์ สถานะการประมวลผล และ URL ไปยังเสียงที่สร้างขึ้นเมื่อพร้อมแล้ว สำหรับการแปลวิดีโอ คำขอจะอ้างอิงไฟล์ที่อัปโหลดและรายการภาษาเป้าหมายแทน
โครงสร้างนั้นเป็นสิ่งที่แยก API ออกจากเครื่องสร้างเสียงบนเบราว์เซอร์ เว็บแอปถูกสร้างขึ้นเพื่อให้คนใช้งานด้วยมือ ครั้งละงาน ส่วน API ถูกสร้างขึ้นเพื่อให้ซอฟต์แวร์เรียกใช้ซ้ำ ๆ โดยอัตโนมัติ และในระดับขนาดใหญ่ หากคุณกำลังผลิตเสียงบรรยายเพียงบางครั้งเป็นครั้งคราว เครื่องมือบนเว็บมักจะเร็วกว่า หากคุณกำลังแปลทุกวิดีโอที่คุณเผยแพร่ API คือจุดสำคัญ
ห้าประเภทหลักของ Voice AI API
"Voice AI API" เป็นหมวดหมู่ ไม่ใช่เทคโนโลยีเดียว ประเภททั่วไปทั้งห้ารับอินพุตที่แตกต่างกันและส่งคืนเอาต์พุตที่แตกต่างกัน และการเลือกผิดจะเสียเวลาในการผสานรวม ตารางด้านล่างจับคู่พวกมันเพื่อให้คุณสามารถจับคู่วัสดุเริ่มต้นของคุณกับผลลัพธ์ที่คุณต้องการ
| ประเภท API | อินพุต | เอาต์พุต | การใช้งานทั่วไป |
|---|---|---|---|
| Text-to-speech | ข้อความที่เขียน | เสียงพูดสังเคราะห์ | เสียงบรรยาย การเข้าถึง พรอมต์แอป การฝึกอบรม |
| Speech-to-text | เสียงพูดหรือวิดีโอ | คำถอดเสียงที่เขียน | คำบรรยาย การค้นหา บันทึกการประชุม การนำกลับมาใช้ใหม่ |
| Voice cloning | ตัวอย่างเสียงที่ได้รับอนุญาต | เสียงสังเคราะห์ที่กำหนดเอง | เสียงแบรนด์ ผู้นำเสนอประจำ เสียงบรรยายหลายภาษา |
| AI dubbing | วิดีโอหรือเสียง | สื่อที่แปลและพากย์เสียง | การแปล YouTube คอร์สเรียน ภาพยนตร์ พอดแคสต์ |
| Speech-to-speech | เสียงพูดที่บันทึกไว้ | เสียงพูดที่แปลงหรือแปลแล้ว | การแปลงเสียง การผลิตหลายภาษา |
กฎการเลือกนั้นตรงไปตรงมา หากคุณมีสคริปต์อยู่แล้ว text to speech มักเป็นเส้นทางที่ง่ายที่สุด หากคุณมีการบันทึกเสียงที่ต้องการคำถอดเสียง คุณต้องการ speech to text หากคุณต้องการให้ผู้นำเสนอมีเอกลักษณ์เดียวกันในหลายภาษา การโคลนเสียงหรือการพากย์เสียงเหมาะสมกว่า สำหรับคำอธิบายเฉพาะเจาะจงเกี่ยวกับด้าน TTS คู่มือประกอบของเราเกี่ยวกับ text to speech API คืออะไร จะลงลึกยิ่งขึ้นในไปป์ไลน์การสังเคราะห์
ข้อแตกต่างที่ควรค่าแก่การสังเกต: การโคลนเสียงไม่ใช่ตัวเปลี่ยนเสียง ตัวเปลี่ยนเสียงจะแปลงการแสดงที่มีอยู่ ณ ที่นั้น ในขณะที่การโคลนสร้างโมเดลเสียงที่นำกลับมาใช้ใหม่ได้ซึ่งสร้างเสียงพูดใหม่จากข้อความหรืออินพุตควบคุมอื่น
คำขอเคลื่อนผ่านไปป์ไลน์อย่างไร
การนำไปใช้งานแตกต่างกันไป แต่ voice API ส่วนใหญ่มีสี่ขั้นตอนเหมือนกัน การเข้าใจรูปแบบของการไหลช่วยประหยัดเวลาหลายชั่วโมงในการคาดเดาเมื่อมีบางอย่างส่งคืนสถานะที่ไม่คาดคิด
ประการแรก แอปพลิเคชันของคุณยืนยันตัวตน มันส่งคีย์ API หรือ bearer token ในส่วนหัวของคำขอ TTS API ของ DubSmart ตัวอย่างเช่น ใช้ REST เอ็นด์พอยต์ที่มีการยืนยันตัวตนแบบ bearer-token และคำขอ JSON กับ base URL https://dubsmart.ai/api/v1 กฎที่สำคัญกว่าที่ฟังดู: อย่าวางคีย์ส่วนตัวใน JavaScript ฝั่งเบราว์เซอร์หรือแอปมือถือที่แจกจ่าย เก็บไว้บนเซิร์ฟเวอร์ที่ปลอดภัยและให้ไคลเอนต์ของคุณเรียกเซิร์ฟเวอร์นั้น
ประการที่สอง แอปพลิเคชันของคุณส่งเนื้อหาและการตั้งค่า คำขอมักมีส่วนผสมของข้อความหรือการอ้างอิงไฟล์ ภาษาต้นทางและภาษาเป้าหมาย รหัสเสียง ความเร็วหรือระดับเสียง ข้อมูลผู้พูด การกำหนดค่าเอาต์พุต และข้อมูลเมตาของโปรเจกต์ สำหรับ TTS ธรรมดา เนื้อหาคือข้อความ สำหรับการพากย์เสียง API มักต้องอัปโหลดวิดีโอก่อน จากนั้นจึงมีคำขอแยกต่างหากเพื่อสร้างโปรเจกต์
ประการที่สาม บริการประมวลผลเนื้อหา ขึ้นอยู่กับงาน นั่นอาจหมายถึงการทำให้ข้อความเป็นมาตรฐานและตีความ การทำนายการออกเสียงและทำนองเสียง การแปลเนื้อหาที่พูด การแยกผู้พูดหรือแยกเสียงพูดออกจากเสียงพื้นหลัง การสร้างเสียงด้วยเสียงมาตรฐานหรือเสียงที่กำหนดเอง และการซิงโครไนซ์ผลลัพธ์กับไทม์ไลน์วิดีโอ งานที่ยาวกว่าทำงานแบบ asynchronous: แทนที่จะส่งคืนไฟล์ที่เสร็จแล้ว API จะส่งคืน project ID
ประการที่สี่ แอปพลิเคชันของคุณดึงผลลัพธ์—URL เสียงหรือวิดีโอ, URL ของแต่ละเซกเมนต์, คำถอดเสียง, ข้อความที่แปล, ข้อมูลจังหวะเวลา และฟิลด์สถานะหรือข้อผิดพลาด TTS API ของ DubSmart บันทึกสถานะโปรเจกต์ เช่น pending, processing, completed และ failed และโปรเจกต์ที่เสร็จสมบูรณ์สามารถส่งคืน URL MP3 ในระดับโปรเจกต์หรือเซกเมนต์
Synchronous เทียบกับ Asynchronous: ความแตกต่างที่กำหนดการสร้างของคุณ
วิธีที่ API ส่งคืนผลลัพธ์กำหนดว่าคุณจะออกแบบสถาปัตยกรรมรอบ ๆ มันอย่างไร ดังนั้นตัดสินใจเรื่องนี้ก่อนที่คุณจะเขียนโค้ดการผสานรวม
API แบบ synchronous จะเปิดคำขอค้างไว้จนกว่าการประมวลผลจะเสร็จ จากนั้นส่งคืนผลลัพธ์ นั่นทำงานได้ดีสำหรับข้อความสั้น พรอมต์เสียงสั้น ๆ คลิปเสียงขนาดเล็ก และฟีเจอร์เชิงโต้ตอบที่มีความหน่วงต่ำ จุดอ่อนของมันคืองานที่ยาวอาจเกินกว่าเวลาหมดอายุของคำขอ
API แบบ asynchronous จะส่งคืน project หรือ job ID ทันที จากนั้นแอปพลิเคชันของคุณจะทำการ poll เอ็นด์พอยต์สถานะหรือรับ webhook เมื่องานเสร็จสิ้น โมเดลนี้เหมาะกับเสียงบรรยายยาว การพากย์วิดีโอ หลายภาษาเป้าหมาย การสร้างแบบแบตช์ และไฟล์ขนาดใหญ่ เวิร์กโฟลว์ TTS และการพากย์เสียงที่บันทึกไว้ของ DubSmart ใช้สถานะโปรเจกต์และการดึงผลลัพธ์ ซึ่งเป็นรูปแบบ asynchronous ที่สร้างขึ้นสำหรับงานสื่อ
เมื่อคุณประเมินตัวเลือก ให้ตรวจสอบว่ามันรองรับ webhook หรือไม่ การ poll ทุกสองสามวินาทีนั้นง่ายต่อการนำไปใช้ แต่ webhook ช่วยลดคำขอที่ไม่จำเป็นและขยายขนาดได้ดีกว่าเมื่อคุณกำลังรันงานหลายงานพร้อมกัน
สิ่งที่ควรประเมินก่อนตัดสินใจ
API ที่เหมาะสมขึ้นอยู่กับงาน แต่มีเกณฑ์จำนวนหนึ่งที่ใช้ได้กับเกือบทุกโปรเจกต์ ดำเนินการตรวจสอบอย่างตั้งใจแทนที่จะเชื่อถือเดโมสั้น ๆ
ความเหมาะสมของความสามารถ ยืนยันว่า API รองรับงานที่แน่นอน—text to speech, speech to text, การโคลนเสียง, การพากย์เสียง, ผู้พูดหลายคน, เอาต์พุตเฉพาะเสียงหรือวิดีโอ, แบบเรียลไทม์หรือแบตช์ อย่าสันนิษฐานว่าอะไรก็ตามที่ทำการตลาดในชื่อ "voice AI" จะรวมทั้งหมดนี้
การครอบคลุมภาษา ตรวจสอบภาษาต้นทาง และ ภาษาเป้าหมาย "รองรับ 30 ภาษา" อาจหมายถึงเสียง TTS 30 เสียง เป้าหมายการแปล 30 รายการ หรือการผสมผสานภาษาและสำเนียง สำหรับช่องที่มีหลายภาษา ให้พิจารณาคุณภาพของสำเนียง การออกเสียงชื่อและสถานที่ คำศัพท์ตามภูมิภาค ความพร้อมของเสียงต่อภาษา และว่าเสียงที่โคลนหนึ่งเสียงใช้ข้ามภาษาได้หรือไม่
การรองรับเอาต์พุตและสื่อ ตรวจสอบรูปแบบเสียง คอนเทนเนอร์วิดีโอ sample rate และ bitrate การดาวน์โหลดระดับเซกเมนต์ วิดีโอที่เรนเดอร์เต็ม ความพร้อมของคำถอดเสียงหรือคำบรรยาย และขนาดไฟล์สูงสุด สิ่งเหล่านี้กำหนดเวิร์กโฟลว์การตัดต่อและค่าใช้จ่ายในการจัดเก็บของคุณ
คุณภาพและการควบคุมได้ ฟังการหยุดพักที่เป็นธรรมชาติ การออกเสียงที่ถูกต้อง ระดับเสียงที่คงที่ เอกลักษณ์ของผู้พูดที่สม่ำเสมอ การเน้นเสียงที่เหมาะสม และจังหวะเวลาที่แม่นยำ เสียงอาจฟังดูไร้ที่ติในตัวอย่างสิบวินาทีและสะดุดกับคำศัพท์เทคนิค ย่อหน้ายาว ตัวเลข หรือชื่อแปลก ๆ ทดสอบเนื้อหาที่เป็นตัวแทน ไม่ใช่คลิปที่ผู้ขายคัดเลือกมาอย่างดี
ความหน่วงและปริมาณงาน วัดเวลาเทียบกับภาระงานจริงของคุณ เสียงบรรยายสั้น ๆ หนึ่งชิ้นกับวิดีโอที่แปลแล้วหลายร้อยเรื่องเป็นปัญหาที่แตกต่างกัน ถามว่าการประมวลผลเป็นแบบเรียลไทม์หรือ async อะไรคือขีดจำกัดอัตรา งานรันแบบขนานได้หรือไม่ มีการประมวลผลแบบมีลำดับความสำคัญหรือไม่ และความล้มเหลวลองใหม่อย่างไร DubSmart ระบุว่าวิดีโอ 5 นาทีโดยทั่วไปใช้เวลาประมาณหนึ่งนาทีในการประมวลผล โดยสังเกตว่าเวลาขึ้นอยู่กับความยาวและขนาดไฟล์
โมเดลราคา voice API อาจเรียกเก็บเงินตามอักขระ คำ ระยะเวลาของเสียงหรือวิดีโอ เครดิต คำขอ การจัดเก็บ หรืองานที่ทำพร้อมกัน สำหรับการพากย์เสียง จำนวนภาษาเป้าหมายจะคูณต้นทุนที่แท้จริง คำนวณเวิร์กโฟลว์ที่สมบูรณ์—การลองใหม่ เซกเมนต์ที่สร้างใหม่ การตรวจทานการแปล การจัดเก็บ—ไม่ใช่แค่การเรียกครั้งแรก การวิเคราะห์ของเราเกี่ยวกับ ราคา voice AI API จะอธิบายการคำนวณเครดิตอย่างละเอียด
ความเสี่ยงที่ควรจัดการตั้งแต่เนิ่น ๆ
Voice AI นำเสนอรูปแบบความล้มเหลวที่ไม่มีในเครื่องมือสื่อทั่วไป การจัดการกับมันในระหว่างการออกแบบนั้นถูกกว่ามากเมื่อเทียบกับหลังจากเกิดความผิดพลาดต่อสาธารณะ
การใช้เสียงโดยไม่ได้รับอนุญาต การโคลนเสียงของบุคคลโดยไม่ได้รับอนุญาตสร้างความเสี่ยงทางกฎหมาย จริยธรรม และชื่อเสียง ใช้กระบวนการยินยอมเป็นลายลักษณ์อักษรที่ระบุว่าใครเป็นเจ้าของการบันทึก สิ่งใดอาจถูกสร้างขึ้น เสียงอาจถูกใช้ที่ไหน อนุญาตให้ใช้ในเชิงพาณิชย์หรือไม่ เสียงถูกลบอย่างไร และจะเกิดอะไรขึ้นเมื่อข้อตกลงสิ้นสุดลง
การแปลหรือการออกเสียงที่ไม่ถูกต้อง เสียงที่สร้างขึ้นอาจจัดการชื่อ ตัวย่อ ที่อยู่ และคำศัพท์ในอุตสาหกรรมได้ไม่ถูกต้อง เก็บการตรวจทานโดยมนุษย์ไว้ในกระบวนการสำหรับเนื้อหาที่เผยแพร่ต่อสาธารณะ: การอ่านสคริปต์ที่แปลแล้ว การฟังโดยเจ้าของภาษา การตรวจสอบการออกเสียงแบบสุ่ม การตรวจสอบจังหวะเวลาและการขยับปาก และการตรวจทานขั้นสุดท้ายของสื่อที่ส่งออก
การแอบอ้างและการฉ้อโกง เสียงสังเคราะห์อาจถูกนำไปใช้ในทางที่ผิดสำหรับการหลอกลวงหรือการรับรองที่เป็นเท็จ หลีกเลี่ยงการสร้างสิ่งใด ๆ ที่อาจทำให้ผู้ฟังที่มีเหตุผลเชื่อว่าบุคคลจริงพูดบางสิ่งที่พวกเขาไม่ได้พูด สำหรับการสื่อสารที่ละเอียดอ่อน ให้เพิ่มการเปิดเผย การควบคุมการอนุมัติ และบันทึกการตรวจสอบ
ความเป็นส่วนตัวของเสียงและข้อมูล ตัวอย่างอาจมีข้อมูลส่วนบุคคล ก่อนอัปโหลด ให้จัดการเรื่องการยินยอม กฎการเก็บรักษา ข้อจำกัดการเข้าถึง ขั้นตอนการลบ ข้อกำหนดการประมวลผลข้อมูลของผู้ขาย และนโยบายการใช้งานรองใด ๆ DubSmart ระบุว่าไฟล์การโคลนที่อัปโหลดถูกเข้ารหัสและผู้ใช้สามารถลบเสียงที่กำหนดเองและข้อมูลเสียงที่เกี่ยวข้องได้ แม้ว่าทีมควรยืนยันข้อกำหนดและการควบคุมปัจจุบันสำหรับแผนเฉพาะของพวกเขา
การเปลี่ยนแปลงของผู้ขายและโมเดล รหัสเสียง การรองรับภาษา รูปแบบเอาต์พุต และขีดจำกัดอัตราอาจเปลี่ยนแปลงได้ ปฏิบัติต่อ API เป็นสิ่งที่พึ่งพาจากภายนอก: ล็อกการกำหนดค่าที่คุณทำได้ เก็บสคริปต์ต้นฉบับ บันทึกเสียงที่อนุมัติแล้ว ติดตามอัตราความผิดพลาด เก็บเวิร์กโฟลว์สำรอง และทดสอบใหม่หลังจากการอัปเดตผู้ขายครั้งใหญ่ สำหรับทีมที่ต้องการชิ้นส่วนที่เคลื่อนไหวน้อยลง สรุปของเราเกี่ยวกับ เครื่องมือวิดีโอ AI แบบครบวงจร อธิบายข้อแลกเปลี่ยนของการรวมความสามารถเหล่านี้
เมื่อใดที่ API เหนือกว่าเวิร์กโฟลว์แบบทำมือ
Voice AI API คุ้มค่ากับต้นทุนการผสานรวมเมื่อคุณต้องการการผลิตแบบทำซ้ำได้และแบบโปรแกรม มันเหมาะสมอย่างยิ่งเมื่อครีเอเตอร์เผยแพร่เวอร์ชันที่แปลแล้วของทุกวิดีโอ ธุรกิจขนาดเล็กสร้างเสียงบรรยายผลิตภัณฑ์ในหลายภาษา บริษัท e-learning อัปเดตบทเรียนหลายร้อยบท พอดแคสต์ส่งมอบฉบับที่แปลแล้ว ผลิตภัณฑ์ซอฟต์แวร์เพิ่มการเข้าถึงด้วยเสียงพูด หรือเอเจนซีเชื่อมต่อการสร้างเสียงเข้ากับระบบจัดการเนื้อหา
เวิร์กโฟลว์สตูดิโอแบบทำมือยังคงชนะได้ในบางกรณี: เมื่อโปรเจกต์ขึ้นอยู่กับการแสดงของมนุษย์ที่มีความละเอียดอ่อนสูง เมื่อการอนุมัติทางกฎหมายต้องการนักแสดงมืออาชีพ เมื่อเนื้อหามีการกล่าวอ้างที่ละเอียดอ่อน เมื่อการบันทึกครั้งเดียวเร็วกว่าการสร้างการผสานรวม หรือเมื่อผลลัพธ์ต้องการการกำกับเชิงศิลปะอย่างหนัก ประเด็นไม่ใช่การแทนที่ทุกเสียงของมนุษย์ แต่เป็นการทำให้ส่วนที่ความสม่ำเสมอ ความเร็ว ขนาด หรือเอาต์พุตหลายภาษ มีความสำคัญมากที่สุดเป็นแบบอัตโนมัติ
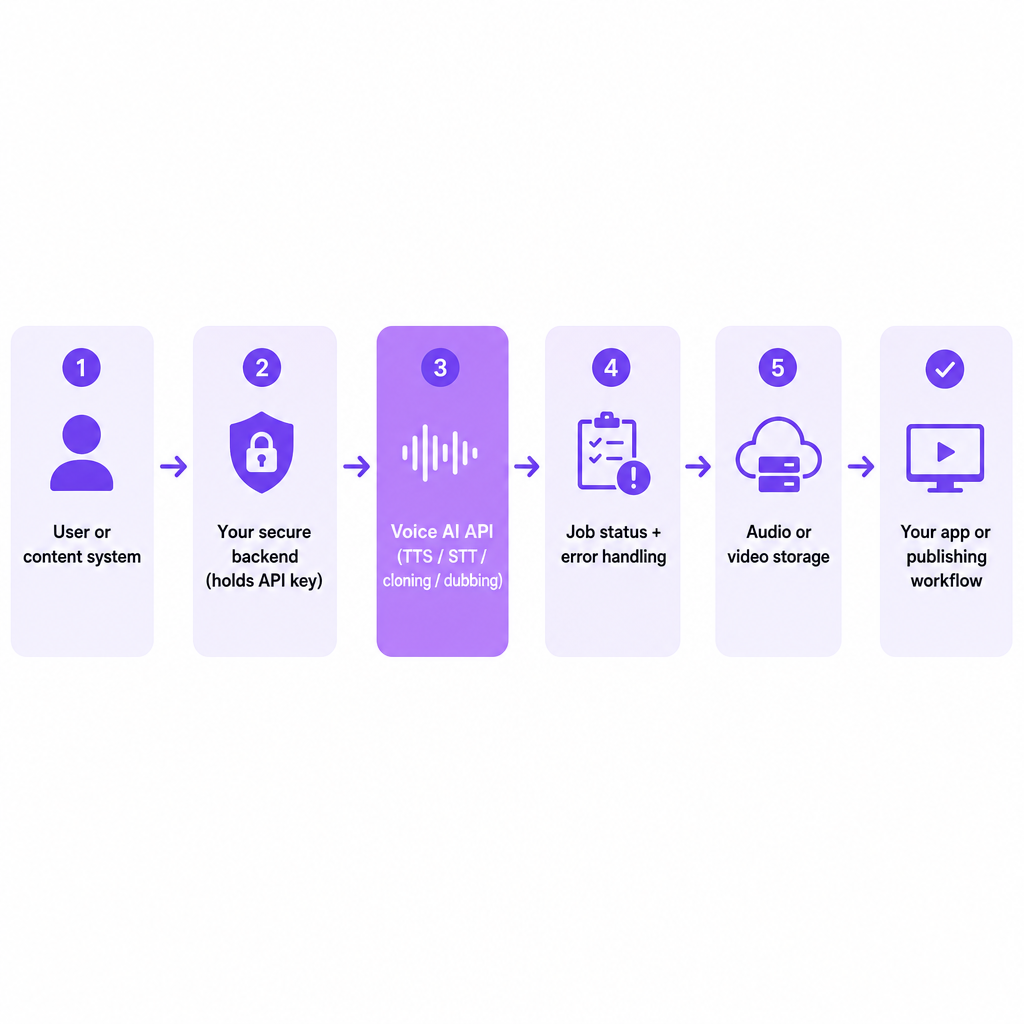
สำหรับการสร้างขนาดเล็ก ให้สถาปัตยกรรมเรียบง่าย แบ็กเอนด์ที่ปลอดภัยอยู่ระหว่างผู้ใช้หรือระบบเนื้อหาของคุณกับ voice API แบ็กเอนด์นั้นเก็บข้อมูลประจำตัวไว้เป็นส่วนตัว ตรวจสอบอินพุต สร้างโปรเจกต์ เก็บ job ID ทำการ poll สถานะหรือรับ webhook ลองใหม่สำหรับความล้มเหลวชั่วคราว บันทึก URL ผลลัพธ์และข้อมูลเมตา ใช้ขีดจำกัดการใช้งาน และบันทึกการยินยอมสำหรับเสียงที่โคลนใด ๆ เวอร์ชันที่หันหน้าเข้าหาครีเอเตอร์อาจรับวิดีโอภาษาอังกฤษที่เสร็จแล้ว ส่งไปยังเอ็นด์พอยต์การพากย์เสียงสำหรับภาษาที่เลือก รอให้เสร็จ กำหนดเส้นทางผลลัพธ์ไปยังโฟลเดอร์ตรวจทาน และเผยแพร่หลังจากการอนุมัติเท่านั้น
DubSmart เข้ามามีบทบาทตรงไหน
เราสร้างความสามารถ API ที่เกี่ยวข้องกับเสียงหลายอย่างเข้าไว้ในแพลตฟอร์มสื่อ AI เดียว ซึ่งสำคัญที่สุดเมื่อคุณต้องการเชื่อมต่อการสร้างและการแปลเข้ากับเวิร์กโฟลว์ที่มีอยู่แทนที่จะรันแต่ละงานด้วยมือ
Text to Speech API ของเราให้การสร้างเสียงพูดแบบโปรแกรมด้วยเสียง neural การโคลนเสียง การรองรับหลายภาษา การติดตามสถานะโปรเจกต์ และผลลัพธ์ MP3—คำขอตัวอย่างของมันใช้เซกเมนต์ข้อความพร้อมรหัสเสียง ภาษา ความเร็ว และระดับเสียง Voice Cloning API ของเราทำตามรูปแบบสามขั้นตอน: ขอ presigned upload URL อัปโหลดตัวอย่างเสียง จากนั้นสร้างเสียงที่กำหนดเองจากคีย์ไฟล์ที่อัปโหลด มันรับ MP3, WAV, AAC, M4A และ FLAC และเราแนะนำเสียงที่สะอาดอย่างน้อย 20 วินาทีเพื่อผลลัพธ์ที่ดีกว่า AI Dubbing API ของเราจัดการการแปลวิดีโอด้วยการสร้างโปรเจกต์หลายภาษา การตั้งค่าผู้พูด เซกเมนต์ที่แปลแล้ว และเอาต์พุตที่พากย์เสียงที่ดาวน์โหลดได้ โดยรับอินพุต เช่น MP4, MOV, AVI, MKV และ WebM สูงสุด 5GB
หากคุณกำลังชั่งน้ำหนักว่าจะเริ่มต้นกับเอ็นด์พอยต์ใด ให้จับคู่กับเนื้อหาของคุณ: เสียงบรรยายแบบมีสคริปต์ชี้ไปที่ TTS เสียงประจำที่ได้รับอนุญาตชี้ไปที่การโคลน และวิดีโอหลายภาษาชี้ไปที่การพากย์เสียง
คำถามที่พบบ่อย
Voice AI API คืออะไรในแง่ง่าย ๆ
มันคือการเชื่อมต่อที่ช่วยให้ซอฟต์แวร์สร้าง รู้จำ โคลน แปล หรือแปลงเสียงพูดโดยไม่ต้องสร้างระบบเสียง AI ของตัวเอง แอปของคุณส่งคำขอและรับเสียง ข้อความ หรือวิดีโอที่ประมวลผลแล้ว
Voice AI API เหมือนกับ text to speech หรือไม่
ไม่ Text to speech เป็นหนึ่งประเภทของ voice AI API หมวดหมู่นี้ยังรวมถึงการรู้จำเสียงพูด การโคลนเสียง การพากย์เสียง และฟังก์ชัน speech-to-speech
ฉันต้องมีประสบการณ์การเขียนโค้ดเพื่อใช้งานหรือไม่
โดยปกติต้องมีบ้าง เพราะ API เกี่ยวข้องกับการยืนยันตัวตน คำขอ HTTP, JSON, การอัปโหลดไฟล์ และการจัดการสถานะ สำหรับงานที่ทำด้วยมือเป็นครั้งคราว เว็บแอปแบบไม่ต้องเขียนโค้ดมักจะง่ายกว่า
Voice AI API สามารถแปลวิดีโอ YouTube ได้หรือไม่
Dubbing API สามารถแปลและสร้างเสียงใหม่สำหรับวิดีโอได้เมื่อมันรองรับภาษาต้นทางและภาษาเป้าหมายที่ต้องการ รูปแบบไฟล์ และเวิร์กโฟลว์เอาต์พุต ตรวจทานผลลัพธ์ก่อนเผยแพร่
ฉันสามารถโคลนเสียงของบุคคลใดก็ได้หรือไม่
ความเป็นไปได้ทางเทคนิคไม่เหมือนกับที่ได้รับอนุญาตทางกฎหมายหรือจริยธรรม โคลนเสียงเฉพาะเมื่อได้รับอนุญาตที่เหมาะสม และปฏิบัติตามกฎของผู้ให้บริการ สัญญาของคุณ และข้อกำหนดด้านความเป็นส่วนตัวและสิทธิในการเผยแพร่ที่บังคับใช้