การเลือกระหว่าง tts กับ voice cloning สำหรับการบรรยาย สรุปลงที่คำถามตรงไปตรงมาข้อเดียว: คุณต้องการเสียงที่เชื่อถือได้สำหรับเนื้อหา หรือต้องการตัวตนของผู้พูดเฉพาะคนในนั้น? Text to speech มาตรฐานให้การบรรยายที่รวดเร็วและยืดหยุ่นจากคลังเสียงสำเร็จรูป ส่วน Voice cloning สร้างเสียงที่จดจำได้ขึ้นมาใหม่ เพื่อให้คนเดียวกันดูเหมือนพูดในสคริปต์ วิดีโอ และภาษาใหม่ ๆ สำหรับครีเอเตอร์และทีมจำนวนมาก ทางเลือกที่ฉลาดคือใช้ทั้งสองอย่าง: สร้างต้นแบบด้วยเสียงสำเร็จรูปเพื่อความรวดเร็ว แล้วเปลี่ยนงานที่อนุมัติแล้วไปใช้โคลนที่ได้รับความยินยอมเมื่อตัวตนของแบรนด์หรือความต่อเนื่องของผู้พูดเริ่มมีความสำคัญ ส่วนที่เหลือของคู่มือนี้จะแสดงให้เห็นอย่างชัดเจนว่าแต่ละวิธีได้เปรียบตรงไหน
สารบัญ
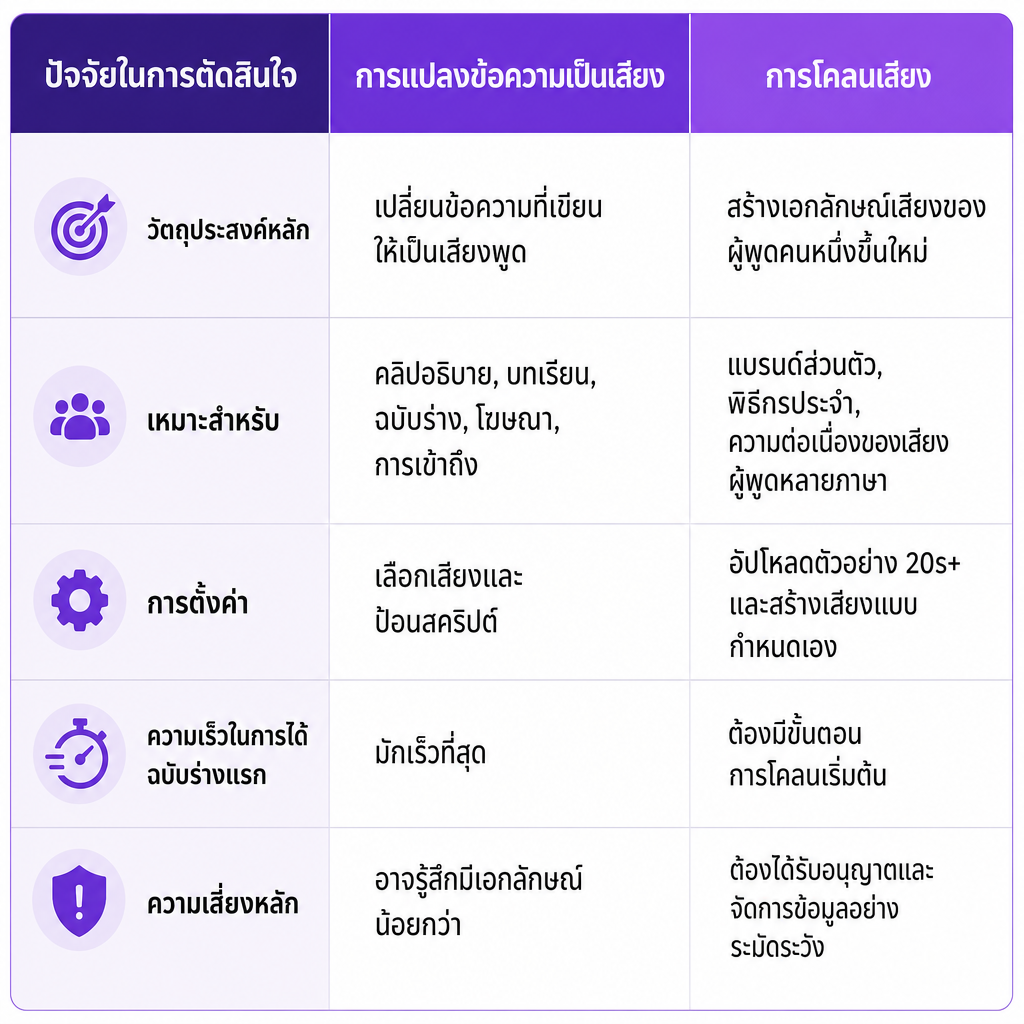
วิธีที่เร็วที่สุดที่จะหยุดวนเวียนกับทางเลือกนี้คือการแยกสองสิ่งที่ผู้คนมักปนกันอยู่เสมอ: สไตล์ ของเสียง และ ตัวตน เบื้องหลังมัน เสียง TTS มาตรฐานมอบสไตล์ที่พร้อมใช้งานให้คุณ มันอ่านได้อบอุ่น มีอำนาจ มีพลัง เป็นกันเอง หรือเป็นกลาง และคุณเลือกมันเพราะเหมาะกับสคริปต์ ส่วนเสียงโคลนมอบความต่อเนื่องกับบุคคลหนึ่ง ๆ ให้คุณ ผู้ฟังจดจำได้ว่าเป็นครีเอเตอร์ ผู้สอน ผู้ก่อตั้ง หรือผู้บรรยาย และคุณเลือกมันเพราะตัวตนนั้นเป็นส่วนหนึ่งของผลิตภัณฑ์
ความแตกต่างนั้นเปลี่ยนมากกว่าแค่เสียงของคลิป มันเปลี่ยนภาระในการดำเนินงานของคุณ สไตล์เป็นสิ่งที่คุณสลับได้อย่างอิสระ ส่วนตัวตนเป็นสิ่งที่คุณต้องปกป้อง บันทึกเป็นเอกสาร และรักษาให้สม่ำเสมอในทุกไฟล์ใหม่ จงจำการแยกแยะนี้ไว้ แล้วการตัดสินใจส่วนใหญ่ด้านล่างจะตอบตัวเองได้
การบรรยายด้วย text to speech ทำงานอย่างไรจริง ๆ
Text to speech แปลงข้อความที่เขียนขึ้นเป็นเสียงพูดสังเคราะห์ ระบบจะอ่านสคริปต์ของคุณ ตีความการออกเสียงและโครงสร้างประโยค แล้วสร้างแทร็กเสียงด้วยเสียงที่คุณเลือกจากแคตตาล็อก คุณไม่ได้บันทึกบุคคลเฉพาะคนอ่านคำพูด แต่คุณกำลังสร้างเสียงพูดใหม่ในสไตล์ของเสียงที่สร้างไว้ล่วงหน้า
ในทางปฏิบัติ คุณควบคุมตัวแปรไม่กี่อย่าง: ภาษา สำเนียง โปรไฟล์เสียง โทน ความเร็วในการพูด และสไตล์การนำเสนอ ความยืดหยุ่นนั้นคือประเด็นสำคัญทั้งหมด เมื่อราคา ชื่อผลิตภัณฑ์ สถิติ หรือบทเรียนเปลี่ยน คุณแก้ไขข้อความและสร้างใหม่เฉพาะส่วนที่ได้รับผลกระทบ แทนที่จะต้องจองสตูดิโออีกครั้ง เครื่องมือ Text to Speech ของเรา ทำงานวนลูปนั้นตั้งแต่ต้นจนจบ: ป้อนข้อความ เลือกผู้พูดจากเสียง AI กว่า 300 เสียง สร้าง แก้ไขโปรเจกต์ และดาวน์โหลด พร้อมการควบคุมความเร็วเสียงและคำบอกใบ้ข้อความสำหรับการเน้น
เลือกใช้ TTS มาตรฐานเมื่อตัวเสียงเองไม่จำเป็นต้องจดจำได้ มันเหมาะกับร่างแรกและเวอร์ชันทดสอบ ช่องที่เผยแพร่บ่อยและต้องอัปเดตอย่างรวดเร็ว เวิร์กโฟลว์ที่มีหลายคนเขียนหรือจัดการสคริปต์ และเนื้อหาที่ต้องใช้เสียงต่างกันระหว่างตัวละครหรือส่วนต่าง ๆ มันยังเป็นตัวเลือกตามธรรมชาติเมื่อคุณต้องการสำรวจหลายภาษา สำเนียง หรือสไตล์การนำเสนอ หรือเมื่อคุณกำลังผลิตเนื้อหาเชิงสั่งสอน เชิงให้ข้อมูล และเนื้อหาที่เน้นการเข้าถึง ตัวอย่างเช่น ธุรกิจขนาดเล็กที่ส่งคู่มือผลิตภัณฑ์รายสัปดาห์สามารถใช้เสียงสำเร็จรูปที่สม่ำเสมอหนึ่งเสียง และอัปเดตฟีเจอร์และคำกระตุ้นให้ดำเนินการได้โดยไม่ต้องประสานงานการบันทึกเลย
การบรรยายด้วย voice cloning ทำงานอย่างไรจริง ๆ
Voice cloning สร้างเสียงพูดสังเคราะห์ที่คล้ายกับบุคคลเฉพาะคน ระบบจะวิเคราะห์ตัวอย่างในด้านการออกเสียง ระดับเสียง จังหวะ โทน และสไตล์การพูด แล้วใช้คุณลักษณะเหล่านั้นสร้างเสียงพูดใหม่จากข้อความ นี่ไม่ใช่การตัดเสียงพากย์ที่ทำเสร็จแล้วลงในไทม์ไลน์ แต่มันสร้างโมเดลเสียงที่นำกลับมาใช้ซ้ำได้ ซึ่งสามารถพูดสคริปต์ที่ผู้พูดไม่เคยบันทึกไว้
ตัวอย่างเสียงทำหน้าที่หนักที่สุด หน้า Voice Cloning ของเรา ระบุว่าคุณสามารถสร้างเสียงที่กำหนดเองจากไฟล์เสียงที่มีความยาวอย่างน้อย 20 วินาที และการบันทึกที่สะอาดปราศจากเสียงรบกวนพื้นหลังจะให้ผลลัพธ์ที่ดีกว่า สไตล์การพูดในไฟล์ที่อัปโหลดจะส่งต่อไป: การอ้างอิงที่เสียงราบเรียบมักให้การบรรยายที่แบนราบกว่า ในขณะที่ตัวอย่างที่มีพลังและอารมณ์ที่คุณต้องการจริง ๆ จะให้เป้าหมายที่ชัดเจนกว่าแก่โมเดล เมื่อสร้างแล้ว เสียงนั้นสามารถนำกลับมาใช้ซ้ำได้ทั้งในโปรเจกต์ Text to Speech และ AI Dubbing
เลือกการโคลนเมื่อตัวตนของผู้พูดเป็นส่วนหนึ่งของแบรนด์หรือผลิตภัณฑ์ มันเหมาะกับพิธีกร YouTube ที่ต้องเผยแพร่บ่อยขึ้นโดยไม่ต้องบันทึกทุกบรรทัด พอดแคสเตอร์ที่แก้ไขส่วนเล็ก ๆ แทนที่จะบันทึกตอนใหม่ทั้งหมด บริษัทที่ต้องการเสียงผู้ก่อตั้งหรือผู้สอนที่สม่ำเสมอหนึ่งเสียง และหลักสูตรที่ต้องใช้ผู้สอนคนเดียวกันในหลายภาษา ครูออนไลน์สามารถบันทึกตัวอย่างที่สะอาดครั้งเดียว แล้วใช้โคลนที่ได้รับความยินยอมเพื่อปรับปรุงบทเรียน แก้ไขข้อเท็จจริงที่ล้าสมัย หรือสร้างเวอร์ชันสำหรับผู้เรียนต่างประเทศ หากต้องการดูรายละเอียดเพิ่มเติมเกี่ยวกับการนำตัวตนไปใช้ซ้ำในหลายรูปแบบ โปรดดูคู่มือของเราเรื่อง AI dubbing กับ voice cloning สำหรับการนำเนื้อหากลับมาใช้ใหม่
ความแตกต่างหลัก: สไตล์เสียงหรือตัวตนของเสียง
หากคุณจำอะไรไม่ได้เลย จงจำกรอบคิดนี้ไว้ เพราะมันช่วยแก้ปัญหากรณีก้ำกึ่งส่วนใหญ่ได้เร็วกว่าตารางฟีเจอร์ใด ๆ TTS มาตรฐานเป็นปัญหาของการเลือก: คุณกำลังเลือกสไตล์จากชั้นวาง และคุณสามารถเปลี่ยนใจได้สัปดาห์หน้าโดยไม่มีค่าใช้จ่าย ส่วนการโคลนเป็นพันธสัญญาเรื่องความต่อเนื่อง: คุณกำลังผูกติดกับตัวตนหนึ่งเดียว และตกลงที่จะดูแลรักษา กำกับดูแล และปกป้องมันไปตลอดเวลา
นั่นคือเหตุผลที่แบรนด์ที่นำโดยผู้ก่อตั้งทำงานต่างจากช่องอธิบายแบบไร้ใบหน้า แม้ว่าสคริปต์จะดูเหมือนกัน ช่องอธิบายต้องการเพียงเสียงที่มีความสามารถ ดังนั้น TTS จึงรับหน้าที่นั้น ส่วนแบรนด์ของผู้ก่อตั้งพึ่งพาการจดจำ ดังนั้นเสียงโคลนจึงกลายเป็นทรัพย์สินที่คุ้มค่ากับการตั้งค่าและเอกสารที่เพิ่มขึ้น เมื่อคุณรู้สึกติดขัด ลองถามว่าการสลับเสียงในเดือนหน้าจะทำร้ายความสัมพันธ์ของผู้ชมกับเนื้อหาหรือไม่ หากใช่ คุณอยู่ในเขตแดนของการโคลน สำหรับการเปรียบเทียบสองเส้นทางนี้แบบตัวต่อตัวอย่างใกล้ชิดยิ่งขึ้น บทความอธิบายของเราเรื่อง การเลือกระหว่างเสียงโคลนและเสียง TTS สำเร็จรูป แจกแจงเกณฑ์ไว้อย่างละเอียดมากขึ้น
ควรใช้แบบไหน ตามเป้าหมายการผลิต
คำตอบที่ถูกต้องเปลี่ยนไปตามสิ่งที่คุณกำลังสร้างจริง ๆ นี่คือวิธีที่ทางเลือกลงตัวสำหรับงานบรรยายที่พบบ่อยที่สุด
ครีเอเตอร์ YouTube TTS เหมาะกับช่องไร้ใบหน้า คลิปอธิบาย วิดีโอรายการ และเนื้อหาสไตล์ข่าวที่ไม่มีตัวตนของพิธีกรเข้ามาเกี่ยวข้อง ส่วนการโคลนเหมาะกับช่องที่ผู้ชมผูกติดกับผู้นำเสนอเฉพาะคน ช่วยให้คุณคงเสียงที่จดจำได้ไว้ ขณะที่ข้ามการบันทึกใหม่สำหรับการแก้ไข อินโทร และเวอร์ชันสั้น สำหรับการขยายไปยังหลายภาษา จับคู่เสียงที่กำหนดเองกับ AI Dubbing แทนที่จะคิดค้นตัวตนการบรรยายแยกต่างหากสำหรับแต่ละภาษา
ธุรกิจขนาดเล็กและทีมการตลาด พึ่งพา TTS สำหรับเวอร์ชันแคมเปญ คลิปอธิบายผลิตภัณฑ์ โฆษณาโซเชียล และการเปลี่ยนแปลงข้อความบ่อย ๆ นำการโคลนมาใช้เมื่อผู้ก่อตั้ง แบรนด์แอมบาสเดอร์ หรือโฆษกเป็นศูนย์กลางของความไว้วางใจ โคลนสามารถพากย์เสียงเวอร์ชันสคริปต์ที่อนุมัติแล้ว แต่มันไม่เคยแทนที่การตรวจสอบข้อกล่าวอ้าง การออกเสียง และโทนของแบรนด์
E-learning และการฝึกอบรมองค์กร TTS โดดเด่นเมื่อหลักสูตรครอบคลุมหลายโมดูล หลายวิชา หรือมีการอัปเดตบ่อย เพราะเสียงสำเร็จรูปทำให้ง่ายต่อการกำหนดเสียงต่างกันให้กับหลักสูตรหรือบทบาทต่าง ๆ การโคลนเหมาะกับโปรแกรมที่ผู้เรียนคาดหวังผู้สอนคนเดียวตลอด หรือที่คุณปรับปรุงหลักสูตรที่มีอยู่โดยไม่สูญเสียตัวตนของเสียงที่คุ้นเคย ไม่ว่าทางใด การตรวจสอบโดยมนุษย์เรื่องชื่อ คำศัพท์เทคนิค ตัวย่อ และตัวเลข ยังคงเป็นสิ่งจำเป็น
พอดแคสต์และภาพยนตร์อิสระ ใช้ TTS สำหรับแทร็กร่าง การทดสอบการบรรยาย และงานตัวสำรองก่อนที่ผู้พูดสุดท้ายจะถูกล็อก ใช้การโคลนสำหรับการบันทึกเสริมที่สม่ำเสมอ เวอร์ชันทางเลือก หรือการแปลเป็นภาษาท้องถิ่นที่อนุมัติแล้วของพิธีกรหรือนักแสดง โดยมีสิทธิ์และวัตถุประสงค์การใช้งานที่บันทึกเป็นเอกสารก่อนเริ่มการผลิต
นักพัฒนาและเอเจนซี TTS มักเป็นจุดเข้า API ที่ง่ายกว่า: ส่งข้อความ เลือกเสียง รับเสียงพูด การโคลนเหมาะกับแอปที่ต้องการเสียงที่กำหนดเองแบบถาวรต่อลูกค้า แบรนด์ หรือตัวละคร Voice Cloning API ของเรา รับการอัปโหลดในรูปแบบ MP3, WAV, AAC, M4A และ FLAC คืนเสียงที่กำหนดเองที่คุณสามารถอ้างอิงใน TTS หรือ AI Dubbing และเปิดให้ใช้งานการดำเนินการเพื่อแสดงรายการและลบเสียงที่กำหนดเอง
แบบไหนฟังดูเป็นธรรมชาติกว่ากัน
ไม่มีตัวเลือกใดที่เป็นธรรมชาติโดยอัตโนมัติ เสียงสำเร็จรูปคุณภาพสูงสามารถเอาชนะโคลนที่สร้างจากเสียงรบกวนได้อย่างง่ายดาย และตัวอย่างที่ไม่ดีจะจำลองข้อบกพร่องของตัวเอง: เสียงฮัมพื้นหลัง การนำเสนอที่ไม่สม่ำเสมอ โทนอารมณ์ที่ไม่ตรงกับสคริปต์ ความเป็นธรรมชาติคือผลลัพธ์ที่คุณต้องทดสอบ ไม่ใช่ฉลากที่คุณคาดเดา
ตัดสินผลลัพธ์ด้วยเกณฑ์ที่เป็นรูปธรรม ไม่ใช่ความประทับใจแรก:
- การออกเสียง: มันออกเสียงชื่อ ตัวย่อ ตัวเลข และคำศัพท์เทคนิคได้ถูกต้องหรือไม่?
- จังหวะเสียง: จังหวะเหมาะกับสคริปต์หรือไม่?
- ความสม่ำเสมอ: เสียงคงที่ในคลิปและภาษาต่าง ๆ หรือไม่?
- อารมณ์: การนำเสนอตรงกับวัตถุประสงค์ของการบรรยายหรือไม่?
- ความชัดเจน: ฟังเข้าใจได้บนโทรศัพท์ แล็ปท็อป และหูฟังหรือไม่?
- ความสามารถในการแก้ไข: คุณสามารถสร้างประโยคเดียวใหม่โดยไม่ทำให้แทร็กทั้งหมดเปลี่ยนไปหรือไม่?
- การแปลเป็นภาษาท้องถิ่น: มันยังเหมาะสมหรือไม่เมื่อปรับให้เข้ากับตลาดอื่น?
สำหรับ TTS ลองรันเสียงสำเร็จรูปหลายเสียงกับย่อหน้าเดียวกันแล้วเปรียบเทียบ สำหรับการโคลน ทดสอบสคริปต์ตัวแทนที่มีคำยาก ช่วงอารมณ์ และจังหวะของโปรเจกต์ที่เสร็จสมบูรณ์ ไม่ใช่แค่คำทักทายสั้น ๆ คำทักทายมักฟังดูดีเสมอ แต่งานจริงคือจุดที่โคลนเผยจุดอ่อนของมัน
สิทธิ์ ความยินยอม และการเปิดเผยที่คุณข้ามไม่ได้
การโคลนมีความรับผิดชอบที่ TTS ธรรมดาไม่มี เพราะมันสามารถจำลองเสียงของบุคคลที่ระบุตัวตนได้ ให้โคลนเสียงเฉพาะเมื่อคุณถือครองสิทธิ์และการอนุญาตสำหรับการใช้งานที่ตั้งใจไว้ และทำให้การอนุญาตนั้นเฉพาะเจาะจง ความยินยอมที่ดีครอบคลุมว่าใครเป็นเจ้าของการบันทึกต้นฉบับ เสียงสังเคราะห์อาจปรากฏที่ใด อนุญาตให้ใช้เชิงพาณิชย์หรือไม่ รวมภาษาและอาณาเขตใดบ้าง อนุญาตให้โฆษณาหรือพากย์เสียงหรือไม่ การอนุญาตมีอายุนานเท่าใด โมเดลและไฟล์ต้นฉบับถูกจัดเก็บอย่างไร และจะเกิดอะไรขึ้นเมื่อใบอนุญาตสิ้นสุดลง
เราถือว่าความยินยอมและการใช้งานอย่างมีจริยธรรมเป็นส่วนหนึ่งของแนวทาง voice cloning ของเรา และ API ของเรารองรับการลบเสียงที่กำหนดเองและข้อมูลเสียงที่เกี่ยวข้อง ตรวจสอบเงื่อนไขปัจจุบันที่ใช้กับบัญชีและโปรเจกต์ของคุณก่อนอัปโหลดตัวอย่าง ฉากหลังทางกฎหมายก็ยังเคลื่อนไหวอยู่เช่นกัน: สำนักงานลิขสิทธิ์ของสหรัฐฯ ได้ระบุว่าการจำลองเสียงที่สมจริงเป็นแบบจำลองดิจิทัล และแนะนำให้มีการคุ้มครองระดับรัฐบาลกลางเพิ่มเติมต่อการจำลองที่ไม่ได้รับอนุญาต ดังที่ระบุไว้ใน รายงานเรื่องลิขสิทธิ์และแบบจำลองดิจิทัล
ยังมีชั้นของการเปิดเผยอีกด้วย คำแนะนำของ YouTube เกี่ยวกับการเปิดเผยเนื้อหาที่สร้างด้วย AI ระบุว่าการสร้างเสียงของบุคคลด้วยการสังเคราะห์เพื่อบรรยายวิดีโอเป็นเนื้อหาที่ถูกดัดแปลงหรือสังเคราะห์ที่สมจริง ซึ่งครีเอเตอร์ต้องเปิดเผย ดังนั้นอย่านำเสนอเสียงโคลนเป็นการบันทึกที่ไม่ถูกดัดแปลงหากสิ่งนั้นอาจทำให้ผู้ชมเข้าใจผิด FTC ได้เตือนแยกต่างหากว่า voice cloning ทำให้การหลอกลวงด้วยการปลอมตัวน่าเชื่อถือยิ่งขึ้น ซึ่งเป็นเหตุผลว่าทำไมการอนุญาตและการใช้งานอย่างโปร่งใสจึงไม่ใช่สิ่งที่เลือกได้
กฎการตัดสินใจที่คุณนำไปใช้ได้วันนี้
หากผู้ชมต้องการเสียงที่ดี ให้เลือก TTS หากผู้ชมต้องการผู้พูดเฉพาะคนนี้ ให้เลือก voice cloning
เริ่มด้วย TTS เมื่อความรวดเร็ว ความหลากหลาย การทดลอง และการเปลี่ยนแปลงสคริปต์บ่อย ๆ เป็นหลัก มันทดสอบได้เร็วกว่า แก้ไขได้ง่ายกว่า และเปิดตัวเลือกเสียงที่หลากหลายโดยไม่ต้องใช้ตัวอย่าง ย้ายไปใช้การโคลนเมื่อการจดจำ ความต่อเนื่อง และตัวตนของผู้พูดคือประเด็นสำคัญ เช่น ช่องที่นำโดยครีเอเตอร์ หลักสูตรที่นำโดยผู้สอน แบรนด์ที่นำโดยผู้ก่อตั้ง พิธีกรพอดแคสต์ หรือโฆษกหลายภาษา ใช้เฉพาะตัวอย่างที่ได้รับอนุญาต ตรวจสอบเสียงที่สร้างขึ้นอย่างใกล้ชิด และปฏิบัติตามกฎการเปิดเผยในที่ที่เกี่ยวข้อง
หลายทีมลงเอยด้วยการใช้ทั้งสองอย่าง และทำอย่างตั้งใจ: สร้างต้นแบบด้วยเสียงสำเร็จรูป แล้วย้ายเนื้อหาที่อนุมัติแล้วและเกิดซ้ำไปใช้เสียงที่กำหนดเองเมื่อการผลิตคุ้มค่ากับการตั้งค่า แนวทางผสมผสานนั้นมีประสิทธิภาพเป็นพิเศษสำหรับช่อง YouTube หลักสูตรออนไลน์ แคมเปญที่มีแบรนด์ และคลังเนื้อหาหลายภาษา เรานำทั้งสองอย่างมาไว้ในเวิร์กโฟลว์เดียว เพื่อให้คุณเริ่มด้วยการบรรยายที่ยืดหยุ่นจากเสียงกว่า 300 เสียง สร้างเสียงที่กำหนดเองจากตัวอย่างเสียง และนำไปใช้ซ้ำใน TTS หรือ AI Dubbing เมื่อโปรเจกต์เติบโตขึ้น
คำถามที่พบบ่อย
voice cloning เหมือนกับ TTS หรือไม่?
ไม่เหมือน TTS แปลงข้อความที่เขียนขึ้นเป็นเสียงพูดโดยใช้เสียงสังเคราะห์ที่เลือกไว้ Voice cloning สร้างโมเดลเสียงที่กำหนดเองซึ่งตั้งใจให้คล้ายกับผู้พูดเฉพาะคน ซึ่งจากนั้นสามารถสร้างการบรรยายแบบ TTS ได้
TTS ดีกว่า voice cloning หรือไม่?
ไม่เสมอไป TTS มักชนะในด้านความรวดเร็ว ความหลากหลายของเสียง การทดสอบ และการอัปเดตบ่อย ส่วนการโคลนชนะเมื่อตัวตนของผู้พูดเฉพาะคนต้องคงที่ตลอดเนื้อหาใหม่
ต้องใช้เสียงมากเท่าใดในการโคลนเสียงด้วย DubSmart?
หน้า Voice Cloning ของเราระบุว่าไฟล์ที่อัปโหลดควรมีเสียงอย่างน้อย 20 วินาที แนะนำให้ใช้การบันทึกที่สะอาดปราศจากเสียงรบกวนพื้นหลังเพื่อผลลัพธ์ที่ดีกว่า
ฉันสามารถใช้เสียงโคลนสำหรับการบรรยายหลายภาษาได้หรือไม่?
ได้ เสียงโคลนสามารถนำกลับมาใช้ซ้ำใน AI Dubbing ในภาษาที่เรารองรับ ทดสอบการออกเสียงและความเหมาะสมทางวัฒนธรรมในแต่ละตลาดเป้าหมายก่อนเผยแพร่
ครีเอเตอร์ YouTube ควรเปิดเผยการบรรยายด้วย AI หรือไม่?
ตรวจสอบการควบคุมการเปิดเผยปัจจุบันของ YouTube YouTube ระบุว่าการสร้างเสียงของบุคคลด้วยการสังเคราะห์เพื่อการบรรยายเป็นเนื้อหาที่ถูกดัดแปลงหรือสังเคราะห์ที่สมจริง ซึ่งอาจต้องมีการเปิดเผย